Bu derste öğrenecekleriniz
- Az uyum ve aşırı uyumu eğitim ve doğrulama hatasından tanımak
- Beklenen hatayı indirgenemez hata, yanlılık² ve varyansa ayırmak; Monte Carlo ile ölçmek
- k-katlı çapraz doğrulamayı sıfırdan yazmak ve scikit-learn ile karşılaştırmak
- Gruplu veride
GroupKFoldkullanmak; rastgele bölmenin iyimserliğini göstermek - Öğrenme ve doğrulama eğrilerini yorumlamak
GridSearchCVile hiperparametre seçmek ve iç içe çapraz doğrulamayla dürüst hata raporlamak
1. Problem: yorulma ömrünü tahmin etmek
Bir krank mili, bir köprü bağlantısı ya da bir cephe ankrajı, akma dayanımının çok altındaki gerilmelerle de kırılabilir; yeter ki bu gerilmeler milyonlarca kez tekrarlansın. Bu olaya yorulma denir. Yorulma deneyinde numuneye sabit genlikli çevrimsel bir gerilme uygulanır ve kırılana kadar geçen çevrim sayısı $N$ kaydedilir. Farklı gerilme genliklerinde ($S_a$) yapılan deneyler, log–log eksenlerde S–N (Wöhler) eğrisini verir.
Yüksek gerilmelerde eğri yaklaşık bir doğrudur: $N \propto S_a^{-m}$ (Basquin bağıntısı). Belli bir gerilmenin altında eğri belirgin biçimde yataylaşır; birçok çelikte bu bölge yorulma sınırı olarak anılır. Geçişin olduğu yere diz noktası denir.
Yorulma ömrü doğası gereği saçılır. Aynı gerilmede denenen ve birbirinin aynısı görünen numunelerin ömrü birkaç kat farklı olabilir. Bu yüzden ömür logaritmik ölçekte incelenir: $\log_{10} N$'deki 0,2'lik bir fark, ömürde yaklaşık 1,6 katlık bir farka karşılık gelir ($10^{0{,}2} \approx 1{,}58$). Saçılmanın bir kısmı partiden gelir. Aynı döküm partisinden (heat) işlenen numuneler kimyasal bileşim, iç yapı ve yüzey durumu bakımından birbirine daha çok benzer. Bir partinin bütün numuneleri ortalamanın biraz üstünde ya da altında kalabilir.
Bu derste sentetik bir deney programı kullanıyoruz. Gizli “gerçek” eğri, diz noktasında yumuşakça kırılan iki eğimli bir Basquin doğrusudur:
$$ \begin{aligned} & \log_{10} N = \log_{10} N_d - m_1 u \\ & \qquad + (m_2 - m_1)\,\delta\,\ln\!\left(1 + e^{-u/\delta}\right) \end{aligned} $$ $$ u = \log_{10}\left(S_a / S_d\right) $$Diz noktasının çok üstünde ($u \gg \delta$) son terim sıfıra gider ve eğim $-m_1$ olur. Çok altında ($u \ll -\delta$) logaritmik terim $-u/\delta$'ya yaklaşır ve eğim $-m_2$ olur. Seçtiğimiz değerler: $S_d$ = 200 MPa, $\log_{10} N_d = 6$, $m_1 = 5$, $m_2 = 25$, $\delta = 0{,}012$. Bir partinin bütün numunelerine ortak bir kayma $b_p \sim \mathcal N(0, \tau^2)$ eklenir, $\tau = 0{,}15$; her numuneye ayrıca parti içi saçılma $\varepsilon \sim \mathcal N(0, \sigma_w^2)$ gelir, $\sigma_w = 0{,}12$:
$$ y = f(x) + b_p + \varepsilon $$Burada $x = \log_{10} S_a$ özellik, $y = \log_{10} N$ hedeftir. Yeni bir partiden gelen yeni bir numune için toplam saçılma $\sigma = \sqrt{\tau^2 + \sigma_w^2} = 0{,}192$ dekaddır. Hiçbir model bu indirgenemez hatanın (irreducible error) altına inemez.
Deney planı 170–400 MPa arasında, log ölçekte eşit aralıklı 18 gerilme düzeyinden oluşuyor. İç düzeylerin her birinde bir parti, eğrinin uçlarını sabitlemek için en düşük ve en yüksek düzeyde üçer parti deneniyor; her partiden 4 numune. Toplam 22 parti ve 88 numune geliştirme kümesini oluşturur. Rastgele gerilmelerde denenmiş 6 yeni parti (24 numune) ise test için ayrıldı. Veri sentetik olduğu için bir şey daha yapabiliyoruz: 1000 yeni partiden 4000 numunelik bir örneklem üretip her modelin gerçek genelleme hatasını ölçmek. Gerçek bir laboratuvarda bu imkân yoktur. Dersin amacı, eldeki 88 numuneden bu sayıya ne kadar dürüst yaklaşabileceğimizi görmek.
Neden log N hedef, log S özellik?
Deneyde gerilme genliğini biz seçeriz; rastgele olan ömürdür. En küçük kareler ise hatanın yalnızca hedefte olduğunu varsayar (Ders 02'deki regresyon seyrelmesi uyarısı). Ayrıca ömür saçılması logaritmik ölçekte yaklaşık simetriktir; yorulma ömrü için log-normal dağılım yaygın bir varsayımdır. Bu yüzden modeli $\log N$'yi $\log S_a$'dan tahmin edecek biçimde kuruyoruz.
Bu veri neyi temsil etmiyor?
Veri sentetiktir ve parametreler yalnızca anlatım içindir; hiçbir malzemeyi, detay sınıfını ya da standart S–N eğrisini temsil etmez. Gerçek yorulma verisinde başka konular da vardır: belli bir çevrimde kırılmadan durdurulan numuneler (sansürlü veri, runout), gerilme düzeyine göre değişen saçılma, ortalama gerilme etkisi. En uzun ömürler burada 1,4×10⁸ çevrime çıkıyor; gerçek programlarda bu kadar uzun deneyler nadirdir. Tasarımda kullanılan S–N eğrileri yönetmeliklerin tarif ettiği yöntemlerle ve karakteristik (alt sınır) değerlerle belirlenir. Bu dersteki modeller yalnızca ortalama eğriyi tahmin eder.
Sorumuzu açıkça yazalım: yeni bir partiden gelen bir numunenin, 170–400 MPa aralığındaki herhangi bir gerilmede ömrü ne olur? Doğrulama yöntemini bu soru belirleyecek.
2. Model karmaşıklığı: az uyum ve aşırı uyum
Diz noktası yüzünden ilişki bir doğru değil. Esnek bir aday olarak $\log S_a$'nın polinomlarını deneyelim. Polinomu doğrudan $x$ ile değil, deney aralığını $[-1, 1]$'e taşıyan $z$ ile kuruyoruz:
$$ z = \frac{2x - (x_{\min} + x_{\max})}{x_{\max} - x_{\min}} $$ $$ \hat y = w_0 + w_1 z + w_2 z^2 + \dots + w_d z^d $$Model parametrelerine göre hâlâ doğrusaldır: tasarım matrisinin sütunları $1, z, \dots, z^d$ olur ve çözüm, Ders 02'deki en küçük karelerin aynısıdır. Değişen tek şey derece $d$. Derece, modelin karmaşıklığını belirleyen bir hiperparametredir (hyperparameter): parametreler ($w_j$) veriden öğrenilir, hiperparametre ise öğrenmeden önce seçilir.
def z(x):
    """log S'yi deney aralığında [−1, 1]'e taşır; yüksek derecede sayısal kararlılık için gerekli."""
    return (2 * x - (LO + HI)) / (HI - LO)


def polinom_uydur(x, y, derece):
    V = np.vander(z(x), derece + 1, increasing=True)         # sütunlar: 1, z, z², …, z^d
    w, *_ = np.linalg.lstsq(V, y, rcond=None)
return wPolinomu ölçeklenmemiş girdiyle kurmayın
$\log_{10} S_a$ değerleri 2,23 ile 2,60 arasında. Bu dar aralıkta $x^{11}$ ile $x^{12}$ neredeyse aynı sütundur. 12. derece Vandermonde matrisinin koşul sayısı $[-1, 1]$ ölçeğinde $4{,}1\times10^{4}$, ham $\log S_a$ ile $10^{19}$'un üstünde. Çift duyarlıklı sayılar yaklaşık 16 basamak taşır; bu büyüklükte bir koşul sayısının kendisi bile güvenilir biçimde hesaplanamaz ve çözümün bütün basamakları kaybolur (Hazırlık 2'deki koşul sayısı tartışması). scikit-learn'de bunun karşılığı, PolynomialFeatures'tan önce bir ölçekleyici koymaktır.
Dereceyi 1'den 12'ye kadar artırıp her polinomu geliştirme kümesinin tamamına uyduralım. Eğitim hatası (aynı 88 numune üzerindeki RMSE) derece 1'de 0,386, derece 4'te 0,146, derece 12'de 0,123 dekad: dereceyle hiç artmıyor. Artamaz da, çünkü $d$. derece polinomlar $(d+1)$. derecelerin içinde yer alır ($w_{d+1} = 0$ seçmek yeter); en küçük kareler minimumu ancak aynı kalabilir ya da düşebilir. Yeni 4000 numunedeki gerçek hata ise başka bir hikâye anlatıyor: 0,357'den başlıyor, derece 3–8 arasında 0,203–0,207 düzeyine iniyor ve derece 12'de 0,233'e çıkıyor.
- Az uyum (underfitting): derece 1–2 diz noktasını temsil edemiyor. Hata hem eğitimde hem yeni veride yüksek; derece 1'de 0,386 ve 0,357.
- Aşırı uyum (overfitting): yüksek derecelerde eğitim hatası düşmeyi sürdürürken gerçek hata yeniden artıyor. Model, bu veri kümesine özgü saçılmayı ve parti kaymalarını da öğrenmiştir; ezberlenen rastlantılar yeni partilerde tekrarlanmaz.
Sık duyulan bir kural, eğitim hatası indirgenemez hatanın (0,192) belirgin biçimde altına inen modelin ezberlediğini söyler. Bu kural kabadır. Bu veri kümesinde gizli gerçek eğrinin kendi eğitim RMSE'si 0,155, en iyi model olan derece 4'ünki 0,146; ikisi de 0,192'nin altında. Elimizdeki 22 partinin saçılması şans eseri beklenenden küçük; üstelik veriye uydurulan her model, gürültünün bir kısmını kaçınılmaz olarak soğurur. Aşırı uyumu gösteren tek bir eşik değil, eğitim hatası düşerken görülmemiş partilerdeki hatanın yükselmesidir.
Derece 1'de eğitim hatasının gerçek hatadan büyük çıkması ilk bakışta tuhaf görünebilir. Nedeni deney planı: doğrunun en çok yanıldığı iki uç düzey, planda üçer partiyle, yani üç kat ağırlıkla temsil ediliyor. Gerçek hatayı ise aralığa düzgün dağılmış gerilmelerde ölçüyoruz.
3. Yanlılık–varyans ayrışımı
Gerçek hata neden önce azalıp sonra artıyor? Cevap, hatanın üç parçaya ayrılmasında. Aynı deney planını tekrar tekrar uyguladığımızı düşünelim: her seferinde yeni partiler, yeni numuneler, dolayısıyla yeni bir veri kümesi $D$ ve yeni bir model $\hat f_D$. Belli bir $x_0$ noktasındaki tahmin, veri kümesine göre değişen rastgele bir değişkendir. Ortalamasına $\bar f(x_0) = \E_D[\hat f_D(x_0)]$ diyelim.
Beklenen kare hatanın üç parçası
Yeni gözlem $y_0 = f(x_0) + e_0$ olsun; $\E[e_0] = 0$, $\mathrm{Var}(e_0) = \sigma^2$ ve $e_0$ eğitim verisinden bağımsız. Kısalık için $x_0$'ı ve $D$ alt indisini yazmayalım: $\hat f = \hat f_D(x_0)$. Beklenen değer hem $D$ hem $e_0$ üzerinden alınır:
$$ \begin{aligned} \E\big[(y_0 - \hat f)^2\big] &= \E\big[(e_0 + f - \hat f)^2\big] \\ &= \sigma^2 + \E\big[(f - \hat f)^2\big] \end{aligned} $$Çapraz terim $2\,\E[e_0]\,\E[f - \hat f]$, bağımsızlık ve $\E[e_0] = 0$ yüzünden sıfırdır. İkinci terimde $\bar f$'yi ekleyip çıkaralım:
$$ \begin{aligned} \E\big[(f - \hat f)^2\big] &= \E\big[(f - \bar f + \bar f - \hat f)^2\big] \\ &= (f - \bar f)^2 \\ &\quad + \E\big[(\hat f - \bar f)^2\big] \end{aligned} $$Yine çapraz terim sıfırdır, çünkü $\E[\bar f - \hat f] = 0$. Sonuç:
$$ \begin{aligned} \E\big[(y_0 - \hat f)^2\big] = {}& \sigma^2 + \big(\bar f - f\big)^2 \\ &+ \E\big[(\hat f - \bar f)^2\big] \end{aligned} $$Üç terimin anlamı:
- İndirgenemez hata $\sigma^2$: verideki saçılma. Yeni bir partiden yeni bir numune için $\sigma^2 = \tau^2 + \sigma_w^2$, yani $0{,}15^2 + 0{,}12^2 = 0{,}0369$ dekad².
- Yanlılık² (bias²): ortalama modelin gerçek eğriden sistematik sapması. Esnekliği yetmeyen bir model, ne kadar veri verirseniz verin bunu azaltamaz.
- Varyans (variance): modelin bir veri kümesinden ötekine ne kadar oynadığı. Esnek model verideki rastlantıları da öğrendiği için çok oynar.
Bu ifade tek bir $x_0$ içindir; aralık boyunca ortalamasını alınca beklenen test hatası elde edilir. Sentetik veride üç terimi doğrudan ölçebiliriz. Deney planını sabit tutup 200 veri kümesi ürettik, her birine 1–12. derece polinomları uydurduk ve 401 noktalı bir ızgarada ortalama modeli ve modelin dağılımını hesapladık. Tasarım matrisi bütün kümelerde aynı olduğu için 200 uydurma tek bir lstsq çağrısıyla yapılabiliyor:
# Tasarım sabit; her sütun yeni partiler ve yeni saçılmayla çekilmiş bir veri kümesi: (88, 200)
Y = (log_omur(x)[:, None] + rng.normal(0.0, TAU, (n_parti, R))[parti]
     + rng.normal(0.0, SIGMA_W, (x.size, R)))
V = np.vander(z(x), d + 1, increasing=True)
W = np.linalg.lstsq(V, Y, rcond=None)[0]              # 200 uydurma tek seferde: (d+1, 200)
F = np.vander(z(x_izgara), d + 1, increasing=True) @ W   # (401, 200) tahmin
yanlilik2.append(np.mean((F.mean(axis=1) - f_izgara) ** 2))
varyans.append(np.mean(F.var(axis=1)))| Derece | Yanlılık² | Varyans | $\sigma^2$ + yanlılık² + varyans | Monte Carlo test MSE |
|---|---|---|---|---|
| 1 | 0,0877 | 0,0019 | 0,1265 | 0,1273 |
| 2 | 0,0320 | 0,0028 | 0,0717 | 0,0722 |
| 3 | 0,0053 | 0,0040 | 0,0462 | 0,0466 |
| 4 | 0,0010 | 0,0053 | 0,0432 | 0,0434 |
| 6 | 0,0005 | 0,0087 | 0,0461 | 0,0465 |
| 8 | 0,0002 | 0,0117 | 0,0488 | 0,0492 |
| 10 | 0,0002 | 0,0169 | 0,0540 | 0,0545 |
| 12 | 0,0005 | 0,0331 | 0,0705 | 0,0708 |
Son iki sütun yüzde 1'den az farkla örtüşüyor. Ayrışım bir yaklaşıklık değil, bir özdeşliktir; küçük fark Monte Carlo örnekleme hatasıdır. Derece 1'de yanlılık² (0,0877) varyansın (0,0019) yaklaşık 46 katı: model az uyumlu. Derece 12'de tablo tersine dönüyor: yanlılık² 0,0005'e inmiş, varyans 0,0331'e çıkmış. Toplam hata en küçük değerini derece 4'te alıyor: 0,0432 dekad², yani RMSE ≈ 0,208.
Tabloda bir ayrıntı daha var: derece 4'ten sonra yanlılık² neredeyse sıfır ama toplamın büyük kısmı hâlâ $\sigma^2$ = 0,0369. Yeni bir numunenin ömrünü tahmin ederken hatanın asıl kaynağı saçılmadır; model ancak geri kalan küçük payla oynayabilir. Bu pay bir tasarım kararında yine de önemlidir: eğrinin kendisindeki hata, $\sqrt{\text{yanlılık}^2 + \text{varyans}}$, derece 4'te 0,079 dekad, derece 12'de 0,183 dekad.
Kendiniz deneyin
Aşağıdaki denemede [0, 1] aralığında gizli, yumuşak bir eğriden gürültülü eğitim noktaları üretilir; noktalar bağımsızdır, parti etkisi yoktur. Sol grafikte veri ve uydurulan polinom, sağ grafikte 1–15 arası bütün dereceler için eğitim RMSE'si (mavi) ve 200 noktalık doğrulama kümesindeki RMSE (turuncu) logaritmik eksende görünür; seçili derece dikey çizgiyle işaretlidir. Denemedeki “Ridge λ”, 6. ve 7. bölümlerde $\alpha$ dediğimiz cezanın aynısıdır.
- Derece 15'te Yeni örneklem düğmesine birkaç kez basın: eğri her seferinde başka yerde salınır. Bu varyanstır. Derece 1'de ise eğri hep aynı yanlışı yapar: yanlılık.
- Eğitim noktası sayısını 20'den 80'e çıkarın. Okuma kutusundaki “doğrulamaya göre en iyi derece” nasıl değişiyor?
- Derece 15'te Ridge λ'yı 10⁻⁶'dan 1'e doğru artırın. Doğrulama RMSE'si önce düşüp sonra yükseliyor mu? Bu, 6. bölümdeki doğrulama eğrisinin küçük bir örneği.
Bu etkileşimli deneme için tarayıcıda JavaScript açık olmalıdır.
4. Eğitim, doğrulama, test ve k-katlı çapraz doğrulama
Gerçek hayatta 4000 yeni numunemiz yok. Elimizdeki veriyi üç rol arasında paylaştırırız (Ders 01):
- Eğitim kümesi: parametreleri ($w_j$) öğrenir.
- Doğrulama kümesi: hiperparametreleri (derece, ceza) seçer.
- Test kümesi: bütün seçimler bittikten sonra, bir kez, son modelin hatasını raporlar. Test kümesine bakarak bir karar verdiğiniz anda o artık bir doğrulama kümesidir (Alıştırma 4).
Tek bir doğrulama bölmesi küçük veride iki sorun yaratır: sonuç hangi numunelerin doğrulamaya düştüğüne çok bağlıdır ve verinin bir kısmı eğitime hiç katılmaz. k-katlı çapraz doğrulama (k-fold cross-validation) ikisini birden çözer. Veri $K$ kata bölünür; her kat sırayla doğrulama, kalanlar eğitim olur:
$$ \mathrm{CV}_K = \frac{1}{K}\sum_{k=1}^{K} \mathrm{RMSE}_k $$$\mathrm{RMSE}_k$, $k$. kat dışarıda tutularak eğitilen modelin o kattaki hatasıdır. Her numune tam bir kez doğrulamada kullanılır. $K$ = 5 ya da 10 yaygın seçimlerdir. Çapraz doğrulama yalnızca seçim ve değerlendirme içindir: seçilen hiperparametrelerle son model, geliştirme verisinin tamamıyla yeniden eğitilir.
def capraz_dogrulama(x, y, derece, kat):
    """kat[i]: i. numunenin doğrulamaya ayrıldığı kat. Katların RMSE ortalamasını döndürür."""
    hatalar = []
    for k in np.unique(kat):
        egitim, dogrulama = kat != k, kat == k
        w = polinom_uydur(x[egitim], y[egitim], derece)
        hatalar.append(rmse(polinom_tahmin(w, x[dogrulama]), y[dogrulama]))
    return np.mean(hatalar)


K = 5
kat_rastgele = rng.permutation(np.arange(x.size) % K)    # numuneleri katlara rastgele dağıt
kat_grup = (np.arange(n_parti) % K)[parti]               # partileri katlara dağıt (parti bölünmez)
scikit-learn'de bölme işini bir bölücü (splitter) nesnesi yapar; cross_val_score her kat için modeli eğitir ve skoru döndürür. Model, ölçekleyicileri de içeren bir Pipeline'dır. Böylece ölçekleme her katta yalnız o katın eğitim verisinden öğrenilir:
model = Pipeline([
    ("olcek_x", MinMaxScaler(feature_range=(-1, 1))),     # z(x) ile aynı iş
    ("poly", PolynomialFeatures(derece, include_bias=False)),
    ("olcek", StandardScaler()),
    ("reg", LinearRegression()),
])
kfold = KFold(n_splits=5, shuffle=True, random_state=42)
gkfold = GroupKFold(n_splits=5)
cross_val_score(model, X, y, cv=kfold, scoring="neg_root_mean_squared_error")
cross_val_score(model, X, y, groups=parti, cv=gkfold, scoring="neg_root_mean_squared_error")
scikit-learn skorları “büyük olan iyi” kuralına göre tanımlar; bu yüzden RMSE eksi işaretle döner. Kendi fonksiyonumuz, partileri sırayla dağıtan GroupKFold(5) ile aynı katları kurar ve aynı sonucu verir: derece 4 için 0,1772 dekad. Aynı fonksiyon, numuneleri rastgele dağıtan kat_rastgele ile 0,1472 veriyor; bu farkın nedenini 5. bölümde göreceğiz.
Tekrarlı k-katlı doğrulama. CV tahmini, verinin katlara nasıl bölündüğüne de bağlıdır. RepeatedKFold(n_splits=5, n_repeats=10) bölmeyi 10 farklı rastgele karıştırmayla yapar; sonuçların ortalaması bu rastlantıyı törpüler. Derece 4 için tekrarlar 0,149 ile 0,159 arasında, ortalama 0,154. Aynı deneyi gruplu bölmeyle, GroupKFold(5, shuffle=True, random_state=s) ile yaptığımızda aralık genişliyor: 0,156–0,188, ortalama 0,176. Nedeni basit: gruplu doğrulamada bağımsız birim sayısı numune sayısı (88) değil, parti sayısıdır (22).
Başka bölme şemaları da var:
- Birini dışarıda bırak (leave-one-out, LOO): $K = n$. Eğitime neredeyse bütün veri girer, ama $n$ kez eğitim gerekir ve tahmin oynaktır. En küçük karelerde tek uydurmayla hesaplanabilir (Alıştırma 5). LOO da tek tek numune bıraktığı için gruplu veride rastgele
KFold'un tuzağına düşer; grup karşılığıLeaveOneGroupOut'tur (Alıştırma 2). - Tabakalı (stratified) k-katlı: sınıflandırmada her katta sınıf oranlarını korur (
StratifiedKFold). Az görülen bir sınıf, örneğin “hasarlı” etiketi, bazı katlarda hiç bulunmaz olmasın diye kullanılır. Ders 05'te kullanacağız. - Zaman serisi bölmesi: geçmişi tahmin etmek için gelecek kullanılamaz.
TimeSeriesSplither katta geçmişle eğitir, hemen ardından gelen dönemle doğrular. RastgeleKFoldzaman serisinde geleceği eğitime sızdırır; XGBoost zaman serisi projesinde bu yüzden zaman sırası korunuyor.
5. Gruplu veri: rastgele bölme neden fazla iyimser?
Rastgele KFold bir partinin dört numunesini katlara gelişigüzel dağıtır; çoğu zaman farklı katlara düşerler. Bir numune doğrulamadayken, aynı partiden ve aynı gerilme düzeyinde denenmiş “kardeşleri” çoğu zaman eğitimdedir. Esnek bir model o düzeydeki ortalamayı, yani partinin kaymasını da öğrenir ve doğrulama numunesini adeta tanır. Oysa sorumuz yeni bir partiyle ilgili ve yeni partinin kayması hiçbir yerde görülmedi. GroupKFold bir partinin bütün numunelerini aynı kata koyar ve bu durumu taklit eder. Kodda fark tek satırdır: cv=kfold yerine groups=parti, cv=gkfold.
| Derece | Eğitim | KFold | GroupKFold | Gerçek hata |
|---|---|---|---|---|
| 1 | 0,386 | 0,384 | 0,397 | 0,357 |
| 2 | 0,270 | 0,277 | 0,284 | 0,269 |
| 3 | 0,178 | 0,187 | 0,192 | 0,207 |
| 4 | 0,146 | 0,154 | 0,177 | 0,205 |
| 6 | 0,142 | 0,150 | 0,203 | 0,203 |
| 8 | 0,135 | 0,148 | 0,235 | 0,207 |
| 10 | 0,123 | 0,137 | 0,245 | 0,230 |
| 12 | 0,123 | 0,148 | 1,301 | 0,233 |
KFold eğrisi neredeyse eğitim eğrisinin bir kopyası. En küçük değeri derece 10'da: 0,137. Bu modelin gerçek hatası 0,230, yani KFold tahmini gerçeğin yüzde 40 altında. GroupKFold'un en küçük değeri ise derece 4'te: 0,177; bu modelin gerçek hatası 0,205.
GroupKFold tahmini de gerçek hatanın altında kaldı. Bunun nedeni elimizdeki 22 partinin kendisi: ortalama sapmalarının standart sapması 0,136, beklenen değer ise 0,162. Bu partiler, partilerin genelinden biraz daha “uslu” çıkmış. Hiçbir doğrulama yöntemi, eldeki partilerin taşıdığından fazla bilgi üretemez.
Tek veri kümesi şanslı ya da şanssız olabilir. Bu yüzden karşılaştırmayı 200 veri kümesinde tekrarladık. KFold en sık 12. ve 11. dereceleri seçiyor; seçtiği modelin CV tahmini ortalama 0,169, gerçek hatası 0,255. GroupKFold en sık 4. ve 3. dereceleri seçiyor; tahmin 0,204, gerçek hata 0,217. KFold yalnızca iyimser değil, yanlış modeli de seçtiriyor.
GroupKFold'un da bir zaafı var: yüksek derecelerde kötümserdir. 200 kümenin ortalamasında derece 12 için GroupKFold 0,898 diyor, gerçek hata 0,263. Her katta 4–5 parti, dolayısıyla 4–5 gerilme düzeyi eğitimden çıkıyor ve yüksek dereceli polinom bu boşluklarda salınıyor. Tam veriyle eğitilen son modelde bu boşluklar yok. Bu kötümserlik seçim için zararsızdır, çünkü kırılgan modeli cezalandırır. Uç düzeylere üçer parti koymamızın bir nedeni de bu: hiçbir katta en düşük ya da en yüksek düzey tamamen dışarıda kalmıyor, böylece katlardaki modeller dış değer (extrapolation) yapmak zorunda kalmıyor.
Mühendislik verisinde gruplar nerede?
Aynı kaynaktan gelen ve bu yüzden birbirine benzeyen ölçümler bir grup oluşturur: aynı döküm partisi ya da levha, aynı deney makinesi ya da deney günü, aynı yapıdan alınan karot numuneleri, aynı binadaki sensörler, aynı santralden gelen beton. Model yeni bir gruba uygulanacaksa doğrulama da grup bazında yapılmalıdır. Test kümesini ayırırken de aynı kural geçerlidir: GroupShuffleSplit grupları bölünmeden ayırır. En katı biçimi her grubu tek başına dışarıda bırakan LeaveOneGroupOut'tur.
6. Öğrenme eğrisi ve doğrulama eğrisi
Öğrenme eğrisi (learning curve), eğitim ve doğrulama hatasını eğitim verisinin miktarına göre çizer ve “daha çok deney yapmak işe yarar mı?” sorusuna cevap arar. learning_curve, her CV katında eğitim kümesinin giderek büyüyen alt kümeleriyle model eğitir. İki uç modeli karşılaştıralım (GroupKFold, 20'den 68 numuneye):
- Derece 1: eğitim hatası 0,355'ten 0,384'e çıkıyor, doğrulama hatası 0,426'dan 0,396'ya iniyor. İki eğri yüksek bir düzeyde birleşmiş. Bu, yüksek yanlılığın imzasıdır: daha çok numune eklemek bir şey değiştirmez, model esnekleşmelidir.
- Derece 8: eğitim hatası 0,087'den 0,125'e, doğrulama hatası 1,276'dan 0,236'ya. Aradaki açıklık büyük ama veri arttıkça kapanıyor. Bu, yüksek varyansın imzasıdır: daha çok veri ya da daha sade bir model yardımcı olur.
Eğitim hatasının veri arttıkça arttığına dikkat edin: az sayıda numuneyi ezberlemek kolaydır. Yatay eksen numune sayısı olsa da gruplu veride asıl belirleyici parti sayısıdır (Alıştırma 3).
Doğrulama eğrisi (validation curve) ise tek bir hiperparametreyi tarar. Dereceyi 12'de sabit tutup polinoma bir Ridge cezası ekleyelim:
$$ \min_{w_0,\,\vect w}\ \lVert \vect y - w_0 - \Phi\vect w \rVert^2 + \alpha \lVert \vect w \rVert^2 $$$\Phi$ standartlaştırılmış polinom özelliklerinin matrisidir; sabit terim $w_0$ cezalandırılmaz. Ceza katsayısı $\alpha$ büyüdükçe katsayılar küçülür ve model sadeleşir. Ayrıntılar Ders 04'te. Sonuç: $\alpha = 10^{-8}$'de doğrulama hatası 1,144 (aşırı uyum), $\alpha = 1$'de 0,191 (en iyi), $\alpha = 10^{3}$'te 0,815 (az uyum). Düzenlileştirme, karmaşıklığı derece gibi kesikli bir ayar yerine sürekli bir düğmeyle kontrol eder.
7. Hiperparametre araması ve iç içe çapraz doğrulama
İki hiperparametreyi birlikte seçmek için GridSearchCV bütün kombinasyonları çapraz doğrulamayla dener. 12 derece ile üç ceza değerinin ($\alpha$ = 10⁻⁴, 1, 100) çarpımı 36 aday eder; her biri 5 katta sınanır. Sonuç: derece 4, $\alpha$ = 1, en iyi CV RMSE 0,174.
Bu 0,174'ü modelin performansı diye raporlamak cazip ama yanlıştır. 36 adayın her birinin CV hatası gürültülü bir tahmindir. En küçüğünü seçtiğimizde şanstan da yararlanırız; kazanan adayın skoru sistematik olarak iyimserdir. Buna seçim yanlılığı (selection bias) denir.
İç içe çapraz doğrulama (nested cross-validation) bütün seçim sürecini tek bir model gibi değerlendirir. Dış döngü veriyi katlara böler. Her dış katın eğitim kısmında bütün ızgara araması (iç döngü) yeniden yapılır ve seçilen model, aramanın hiç görmediği dış katta sınanır:
izgara = {"poly__degree": list(range(1, 13)), "reg__alpha": [1e-4, 1.0, 100.0]}
for egitim, dogrulama in GroupKFold(5).split(X, y, parti):          # dış döngü: yalnız değerlendirme
    ic = GridSearchCV(model(4, alpha=1.0), izgara, cv=GroupKFold(4), scoring=RMSE_SKOR)
    ic.fit(X[egitim], y[egitim], groups=parti[egitim])                # iç döngü: yalnız seçim
    dis_hatalar.append(rmse(ic.predict(X[dogrulama]), y[dogrulama]))
Dış katların hataları 0,155, 0,187, 0,172, 0,236 ve 0,155; ortalama 0,181. İç aramalar dört katta (derece 4, $\alpha$ = 1), birinde (derece 6, $\alpha$ = 1) seçti; seçim süreci kararlı. Sayıları yan yana koyalım:
- En iyi iç CV skoru: 0,174 (iyimser)
- İç içe CV tahmini: 0,181
- Test kümesi (6 parti): 0,173
- Gerçek hata (1000 parti): 0,200
Seçim yanlılığı burada küçük (0,174'ten 0,181'e), çünkü adaylar birbirine çok benziyor ve ızgara küçük. Aday sayısı ve modelin esnekliği arttıkça bu fark büyür. Gerçek hataya kalan farkın nedeni yine elimizdeki 22 partinin şanslı olması. Altı partilik test kümesi de bu belirsizliğin dışında değil.
İç içe CV bir model seçmez; seçme yönteminin ne kadar iyi çalıştığını ölçer. Son model, GridSearchCV'nin seçilen ayarlarla geliştirme kümesinin tamamında yeniden eğittiği best_estimator_'dır. Bedeli hesaptır: burada 180 model ızgara araması, 720 model iç içe döngü için eğitildi.
8. Çalıştırılabilir kod
Kod sekiz bölümden oluşur: veri üretimi, sıfırdan polinom ve çapraz doğrulama, derece taraması, Monte Carlo yanlılık–varyans, tekrarlı CV, öğrenme ve doğrulama eğrileri, hiperparametre araması ve grafikler. Çalışma süresi bilgisayarınıza bağlı olarak 20–40 saniyedir; zamanın çoğunu iç içe çapraz doğrulama alır. Kurulum için Ders 01'deki adımları izleyin.
"""Ders 03 — Yanlılık–varyans ve çapraz doğrulama.

Sentetik bir yorulma (S–N, Wöhler) deney programının verisinde polinom derecesini seçiyoruz.
Özellik log10(S_a), hedef log10(N). Veri sentetiktir: diz noktasında yumuşakça kırılan iki eğimli
bir Basquin eğrisi, döküm partisine özgü rastgele bir kayma ve parti içi saçılmayla üretilir.
Gerçek bir deney kaydı değildir; hiçbir malzemeyi, detay sınıfını ya da standart eğriyi temsil etmez.

Çalıştır:  python d03_capraz_dogrulama.py
Gerekenler: numpy, scikit-learn, matplotlib  (Python 3.12+)
Süre:      yaklaşık 20–40 s (iç içe çapraz doğrulama yaklaşık 900 model eğitir)
Çıktılar:  terminale sayılar, aynı klasöre dört PNG grafiği
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.model_selection import (GridSearchCV, GroupKFold, KFold, RepeatedKFold, cross_val_score,
                                     learning_curve, validation_curve)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import MinMaxScaler, PolynomialFeatures, StandardScaler
from matplotlib.ticker import FixedLocator, FuncFormatter, NullLocator

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent

# %% 1. Veri: sentetik S–N deney programı
S_DIZ, LOGN_DIZ = 200.0, 6.0      # MPa ve log10 N: iki asimptotun kesiştiği diz noktası
M1, M2 = 5.0, 25.0                # diz üstü ve altı ters eğim (N ∝ S^−m)
DELTA = 0.012                     # dizin yumuşaklığı (log10 S biriminde)
TAU, SIGMA_W = 0.15, 0.12         # partiler arası ve parti içi saçılma, log10 N (dekad)
LO, HI = np.log10(170.0), np.log10(400.0)   # deney aralığı: 170–400 MPa
SIGMA2 = TAU**2 + SIGMA_W**2      # yeni bir partiden yeni bir numunenin indirgenemez hatası


def log_omur(x):
    """Gizli 'gerçek' eğri: x = log10 S_a → log10 N (yumuşak dizli iki eğimli Basquin)."""
    u = x - np.log10(S_DIZ)
    return LOGN_DIZ - M1 * u + (M2 - M1) * DELTA * np.logaddexp(0.0, -u / DELTA)


def sn_verisi(parti_duzeyi, numune, rng):
    """Her döküm partisi kendi gerilme düzeyinde `numune` adet deneniyor."""
    n_parti = len(parti_duzeyi)
    x = np.repeat(parti_duzeyi, numune)
    parti = np.repeat(np.arange(n_parti), numune)
    kayma = rng.normal(0.0, TAU, n_parti)                     # partiye özgü kayma (parti etkisi)
    y = log_omur(x) + kayma[parti] + rng.normal(0.0, SIGMA_W, x.size)
    return x, y, parti


rng = np.random.default_rng(42)
duzey = np.linspace(LO, HI, 18)                    # log ölçekte eşit aralıklı 18 gerilme düzeyi
# İç düzeylerde birer parti; eğrinin uçlarını sabitlemek için en düşük ve en yüksek düzeyde üçer parti
parti_duzeyi = np.concatenate([np.repeat(duzey[:1], 3), duzey[1:-1], np.repeat(duzey[-1:], 3)])
x, y, parti = sn_verisi(parti_duzeyi, 4, rng)                    # geliştirme kümesi: 22 parti × 4
x_test, y_test, _ = sn_verisi(rng.uniform(LO, HI, 6), 4, rng)      # test: 6 yeni parti
x_ger, y_ger, _ = sn_verisi(rng.uniform(LO, HI, 1000), 4, rng)     # "gerçek hata": 1000 yeni parti
n_parti = parti_duzeyi.size
X, X_test = x[:, None], x_test[:, None]
print("=== 1. Veri ===")
print(f"Geliştirme: {n_parti} parti, {x.size} numune, {duzey.size} gerilme düzeyi "
      f"({10**LO:.0f}–{10**HI:.0f} MPa), ömür {10**y.min():.1e}–{10**y.max():.1e} çevrim")
print(f"Test: 6 yeni parti, {x_test.size} numune | 'Gerçek hata' örneklemi: 1000 parti, {x_ger.size} numune")
print(f"Saçılma: partiler arası {TAU}, parti içi {SIGMA_W} → indirgenemez hata σ = {np.sqrt(SIGMA2):.3f} dekad")
parti_ort = np.array([y[parti == p].mean() - log_omur(x[parti == p][0]) for p in range(n_parti)])
print(f"Bu {n_parti} partinin ortalama sapmalarının std'si: {parti_ort.std(ddof=1):.3f} "
      f"(beklenen {np.sqrt(TAU**2 + SIGMA_W**2 / 4):.3f})")
rmse_gercek_egri = np.sqrt(np.mean((log_omur(x) - y) ** 2))   # gizli eğrinin kendi "eğitim hatası"
print(f"Gizli gerçek eğrinin bu {x.size} numunedeki RMSE'si: {rmse_gercek_egri:.3f} dekad "
      f"(beklenen σ = {np.sqrt(SIGMA2):.3f})")


# %% 2. Sıfırdan: polinom uydurma ve k-katlı çapraz doğrulama
def z(x):
    """log S'yi deney aralığında [−1, 1]'e taşır; yüksek derecede sayısal kararlılık için gerekli."""
    return (2 * x - (LO + HI)) / (HI - LO)


def polinom_uydur(x, y, derece):
    V = np.vander(z(x), derece + 1, increasing=True)         # sütunlar: 1, z, z², …, z^d
    w, *_ = np.linalg.lstsq(V, y, rcond=None)
    return w


def polinom_tahmin(w, x):
    return np.vander(z(x), len(w), increasing=True) @ w


def rmse(a, b):
    return float(np.sqrt(np.mean((a - b) ** 2)))


def capraz_dogrulama(x, y, derece, kat):
    """kat[i]: i. numunenin doğrulamaya ayrıldığı kat. Katların RMSE ortalamasını döndürür."""
    hatalar = []
    for k in np.unique(kat):
        egitim, dogrulama = kat != k, kat == k
        w = polinom_uydur(x[egitim], y[egitim], derece)
        hatalar.append(rmse(polinom_tahmin(w, x[dogrulama]), y[dogrulama]))
    return np.mean(hatalar)


K = 5
kat_rastgele = rng.permutation(np.arange(x.size) % K)    # numuneleri katlara rastgele dağıt
kat_grup = (np.arange(n_parti) % K)[parti]               # partileri katlara dağıt (parti bölünmez)


def model(derece, alpha=None):
    """scikit-learn karşılığı. alpha=None → sıradan en küçük kareler, aksi hâlde Ridge."""
    return Pipeline([
        ("olcek_x", MinMaxScaler(feature_range=(-1, 1))),     # z(x) ile aynı iş
        ("poly", PolynomialFeatures(derece, include_bias=False)),
        ("olcek", StandardScaler()),
        ("reg", LinearRegression() if alpha is None else Ridge(alpha=alpha)),
    ])


RMSE_SKOR = "neg_root_mean_squared_error"     # scikit-learn skorları büyük-iyi; RMSE'nin eksisi
kfold, gkfold = KFold(n_splits=K, shuffle=True, random_state=42), GroupKFold(n_splits=K)
cv_sifirdan = capraz_dogrulama(x, y, 4, kat_grup)
cv_sklearn = -cross_val_score(model(4), X, y, groups=parti, cv=gkfold, scoring=RMSE_SKOR).mean()
assert np.isclose(cv_sifirdan, cv_sklearn, rtol=1e-8)   # GroupKFold da partileri sırayla dağıtır
kosul_ham = np.linalg.cond(np.vander(x, 13, increasing=True))
kosul_olcekli = np.linalg.cond(np.vander(z(x), 13, increasing=True))
cv_rastgele = capraz_dogrulama(x, y, 4, kat_rastgele)    # aynı fonksiyon, numune bazında rastgele katlar
print("\n=== 2. Sıfırdan uygulamanın sağlaması ===")
print(f"Sıfırdan 5 katlı CV, derece 4: rastgele katlar {cv_rastgele:.4f}; gruplu katlar {cv_sifirdan:.4f} "
      f"= GroupKFold {cv_sklearn:.4f}")
print(f"Vandermonde koşul sayısı (derece 12): ham log S ile {kosul_ham:.1e}, "
      f"[−1, 1] ölçeğinde {kosul_olcekli:.1e}")

# %% 3. Derece taraması: eğitim, KFold, GroupKFold ve "gerçek" hata
dereceler = np.arange(1, 13)
egitim_h, kfold_h, grup_h, gercek_h, uydurmalar = [], [], [], [], {}
for d in dereceler:
    w = polinom_uydur(x, y, d)
    uydurmalar[d] = w
    egitim_h.append(rmse(polinom_tahmin(w, x), y))
    kfold_h.append(-cross_val_score(model(d), X, y, cv=kfold, scoring=RMSE_SKOR).mean())
    grup_h.append(-cross_val_score(model(d), X, y, groups=parti, cv=gkfold, scoring=RMSE_SKOR).mean())
    gercek_h.append(rmse(polinom_tahmin(w, x_ger), y_ger))
egitim_h, kfold_h, grup_h, gercek_h = map(np.array, (egitim_h, kfold_h, grup_h, gercek_h))
assert np.all(np.diff(egitim_h) <= 1e-12)     # eğitim hatası dereceyle asla artmaz (iç içe modeller)

# %% 4. Yanlılık–varyans: aynı deney planıyla 200 veri kümesi (Monte Carlo)
R = 200
x_izgara = np.linspace(LO, HI, 401)                      # değerlendirme: aralığa düzgün yayılmış gerilmeler
f_izgara = log_omur(x_izgara)
# Tasarım sabit; her sütun yeni partiler ve yeni saçılmayla çekilmiş bir veri kümesi: (88, 200)
Y = (log_omur(x)[:, None] + rng.normal(0.0, TAU, (n_parti, R))[parti]
     + rng.normal(0.0, SIGMA_W, (x.size, R)))
y_yeni = f_izgara[:, None] + rng.normal(0.0, np.sqrt(SIGMA2), (x_izgara.size, R))   # yeni partiler
kat_mc = rng.permutation(np.arange(x.size) % K)          # KFold katları (hız için tüm kümelerde aynı)


def toplu_cv(V, Y, kat):
    """Aynı katlarla 200 veri kümesinin CV hatası; her kat tek bir lstsq ile (sütunlar ayrı kümeler)."""
    h = []
    for k in range(K):
        e, t = kat != k, kat == k
        W = np.linalg.lstsq(V[e], Y[e], rcond=None)[0]
        h.append(np.sqrt(np.mean((V[t] @ W - Y[t]) ** 2, axis=0)))
    return np.mean(h, axis=0)


yanlilik2, varyans, mc_test = [], [], []
mc_kfold, mc_grup, mc_gercek, ornek_egriler = [], [], [], {}
for d in dereceler:
    V = np.vander(z(x), d + 1, increasing=True)
    W = np.linalg.lstsq(V, Y, rcond=None)[0]              # 200 uydurma tek seferde: (d+1, 200)
    F = np.vander(z(x_izgara), d + 1, increasing=True) @ W   # (401, 200) tahmin
    yanlilik2.append(np.mean((F.mean(axis=1) - f_izgara) ** 2))
    varyans.append(np.mean(F.var(axis=1)))
    mc_test.append(np.mean((F - y_yeni) ** 2))
    mc_gercek.append(np.sqrt(SIGMA2 + np.mean((F - f_izgara[:, None]) ** 2, axis=0)))
    mc_kfold.append(toplu_cv(V, Y, kat_mc))
    mc_grup.append(toplu_cv(V, Y, kat_grup))
    if d in (1, 12):
        ornek_egriler[d] = F[:, :15]
yanlilik2, varyans, mc_test = map(np.array, (yanlilik2, varyans, mc_test))
mc_kfold, mc_grup, mc_gercek = map(np.array, (mc_kfold, mc_grup, mc_gercek))   # (12, 200)
toplam = SIGMA2 + yanlilik2 + varyans
assert np.allclose(toplam, mc_test, rtol=0.03)            # ayrışım, Monte Carlo test hatasıyla tutarlı
secim_k, secim_g = mc_kfold.argmin(axis=0), mc_grup.argmin(axis=0)
sutun = np.arange(R)

print("\n=== 3–4. Derece taraması (RMSE, dekad) ve yanlılık–varyans (MSE, dekad², 200 veri kümesi) ===")
print("derece  eğitim  KFold  GroupKFold  gerçek | yanlılık²  varyans  σ²+y²+v  MC test")
for i, d in enumerate(dereceler):
    print(f"{d:6d}  {egitim_h[i]:6.3f}  {kfold_h[i]:5.3f}  {grup_h[i]:10.3f}  {gercek_h[i]:6.3f} | "
          f"{yanlilik2[i]:9.4f}  {varyans[i]:7.4f}  {toplam[i]:7.4f}  {mc_test[i]:7.4f}")
print("--- 200 veri kümesinde KFold ve GroupKFold ---")
for ad, cv, secim in [("KFold     ", mc_kfold, secim_k), ("GroupKFold", mc_grup, secim_g)]:
    sayim = np.bincount(secim + 1, minlength=13)[1:]
    en_sik = np.argsort(sayim)[::-1][:2] + 1
    print(f"{ad}: en sık seçilen dereceler {en_sik[0]} ve {en_sik[1]}; seçilen modelin CV tahmini "
          f"{cv[secim, sutun].mean():.3f}, gerçek hatası {mc_gercek[secim, sutun].mean():.3f}")
print(f"Ortalama eğriler, derece 4 / 12: KFold {mc_kfold[3].mean():.3f} / {mc_kfold[11].mean():.3f}, "
      f"GroupKFold {mc_grup[3].mean():.3f} / {mc_grup[11].mean():.3f}, "
      f"gerçek {mc_gercek[3].mean():.3f} / {mc_gercek[11].mean():.3f}")

# %% 5. Tekrarlı çapraz doğrulama: katlara bölmenin rastgeleliği
rkf = RepeatedKFold(n_splits=5, n_repeats=10, random_state=42)
tekrarli = -cross_val_score(model(4), X, y, scoring=RMSE_SKOR, cv=rkf).reshape(10, 5).mean(axis=1)
grup_tekrar = np.array([-cross_val_score(model(4), X, y, groups=parti, scoring=RMSE_SKOR,
                                         cv=GroupKFold(5, shuffle=True, random_state=s)).mean()
                        for s in range(10)])
print("\n=== 5. Tekrarlı çapraz doğrulama (derece 4, 10 tekrar) ===")
print(f"RepeatedKFold     : tekrarlar {tekrarli.min():.3f}–{tekrarli.max():.3f}, ortalama {tekrarli.mean():.3f}")
print(f"GroupKFold (karış.): tekrarlar {grup_tekrar.min():.3f}–{grup_tekrar.max():.3f}, "
      f"ortalama {grup_tekrar.mean():.3f}")

# %% 6. Öğrenme eğrisi ve doğrulama eğrisi
ogrenme = {}
for d in (1, 8):
    egit, dogr = [], []
    for s in range(3):                     # alt örneklem seçimini üç tekrarla ortala
        boy, e_skor, d_skor = learning_curve(model(d), X, y, groups=parti, cv=gkfold, scoring=RMSE_SKOR,
                                             train_sizes=np.linspace(0.3, 1.0, 6), shuffle=True, random_state=s)
        egit.append(-e_skor.mean(axis=1))
        dogr.append(-d_skor.mean(axis=1))
    ogrenme[d] = (boy, np.mean(egit, axis=0), np.mean(dogr, axis=0))
alfalar = np.logspace(-8, 3, 12)
e_skor, d_skor = validation_curve(model(12, alpha=1.0), X, y, groups=parti, cv=gkfold, scoring=RMSE_SKOR,
                                  param_name="reg__alpha", param_range=alfalar)
vc_egitim, vc_dogr = -e_skor.mean(axis=1), -d_skor.mean(axis=1)
i_alfa = vc_dogr.argmin()
print("\n=== 6. Öğrenme ve doğrulama eğrileri (GroupKFold) ===")
for d, (boy, eg, dg) in ogrenme.items():
    print(f"Derece {d:2d}: {boy[0]}→{boy[-1]} numune; eğitim {eg[0]:.3f}→{eg[-1]:.3f}, "
          f"doğrulama {dg[0]:.3f}→{dg[-1]:.3f}")
print(f"Doğrulama eğrisi (derece 12): α = 1e-8 → {vc_dogr[0]:.3f}, en iyi α = {alfalar[i_alfa]:.0e} → "
      f"{vc_dogr[i_alfa]:.3f}, α = 1e+3 → {vc_dogr[-1]:.3f}")

# %% 7. Hiperparametre araması ve iç içe çapraz doğrulama
izgara = {"poly__degree": list(range(1, 13)), "reg__alpha": [1e-4, 1.0, 100.0]}
arama = GridSearchCV(model(4, alpha=1.0), izgara, cv=GroupKFold(5), scoring=RMSE_SKOR)
arama.fit(X, y, groups=parti)
en_iyi = arama.best_params_
dis_hatalar, secimler = [], []
for egitim, dogrulama in GroupKFold(5).split(X, y, parti):          # dış döngü: yalnız değerlendirme
    ic = GridSearchCV(model(4, alpha=1.0), izgara, cv=GroupKFold(4), scoring=RMSE_SKOR)
    ic.fit(X[egitim], y[egitim], groups=parti[egitim])                # iç döngü: yalnız seçim
    dis_hatalar.append(rmse(ic.predict(X[dogrulama]), y[dogrulama]))
    secimler.append(f"({ic.best_params_['poly__degree']}, {ic.best_params_['reg__alpha']:g})")
son_model = arama.best_estimator_                                    # tüm geliştirme verisiyle yeniden eğitildi
test_rmse = rmse(son_model.predict(X_test), y_test)
gercek_rmse = rmse(son_model.predict(x_ger[:, None]), y_ger)
print("\n=== 7. Hiperparametre araması ve iç içe CV (GroupKFold) ===")
print(f"GridSearchCV: derece {en_iyi['poly__degree']}, α = {en_iyi['reg__alpha']:g}; "
      f"en iyi CV RMSE = {-arama.best_score_:.3f}")
print(f"İç içe CV (dış 5 × iç 4): katlar {' '.join(f'{h:.3f}' for h in dis_hatalar)} → "
      f"ortalama {np.mean(dis_hatalar):.3f}")
print(f"Dış katlarda seçilen (derece, α): {' '.join(secimler)}")
print(f"Son model: test RMSE (6 parti) = {test_rmse:.3f}, gerçek hata (1000 parti) = {gercek_rmse:.3f}")
assert np.isfinite([test_rmse, gercek_rmse, *dis_hatalar]).all()


# %% 8. Grafikler
def log_y(ax, isaretler):
    """Logaritmik y ekseni, okunaklı sabit işaretlerle (0.2, 0.3, … biçiminde)."""
    ax.set_yscale("log")
    ax.yaxis.set_major_locator(FixedLocator(isaretler))
    ax.yaxis.set_major_formatter(FuncFormatter(lambda v, _: f"{v:g}"))
    ax.yaxis.set_minor_locator(NullLocator())


def sn_ekseni(ax):
    ax.set_xscale("log")
    ax.set_yscale("log")
    ax.set_xlim(160, 420)
    ax.set_ylim(10**4.0, 10**8.6)
    ax.set_xticks([170, 200, 250, 300, 400], labels=["170", "200", "250", "300", "400"])
    ax.minorticks_off()
    ax.set(xlabel="Gerilme genliği $S_a$ (MPa)", ylabel="Kırılmaya kadar çevrim $N$")


S_izgara = 10**x_izgara
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].scatter(10**x, 10**y, s=14, color=SOLUK, alpha=.8, label="Numune (sentetik)")
for d, renk in [(1, RENK[1]), (4, RENK[0]), (12, RENK[2])]:
    ax[0].plot(S_izgara, 10**polinom_tahmin(uydurmalar[d], x_izgara), color=renk, lw=1.8, label=f"Derece {d}")
ax[0].plot(S_izgara, 10**f_izgara, color=MUREKKEP, ls="--", lw=1.2, label="Gizli gerçek eğri")
sn_ekseni(ax[0])
ax[0].set_title("Sentetik S–N verisi ve polinom uydurmaları")
ax[0].legend(loc="upper right", fontsize=9)
ax[1].plot(dereceler, egitim_h, "o-", color=RENK[0], ms=4, label="Eğitim")
ax[1].plot(dereceler, grup_h, "s-", color=RENK[1], ms=4, label="Doğrulama (GroupKFold)")
ax[1].plot(dereceler, gercek_h, color=MUREKKEP, ls="--", lw=1.4, label="Gerçek hata (1000 yeni parti)")
ax[1].axhline(np.sqrt(SIGMA2), color=SOLUK, ls=":", lw=1.4, label="İndirgenemez hata σ")
log_y(ax[1], [0.12, 0.15, 0.2, 0.3, 0.5, 1.0])
ax[1].set(xlabel="Polinom derecesi", ylabel="RMSE (dekad, log₁₀ N)", title="Az uyum ve aşırı uyum")
ax[1].set_xticks(dereceler)
ax[1].legend(loc="upper center", fontsize=9)
fig.savefig(KLASOR / "d03_capraz_dogrulama_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
for d, renk in [(1, RENK[1]), (12, RENK[2])]:
    egriler = ornek_egriler[d]
    ax[0].plot(S_izgara, 10**egriler, color=renk, lw=0.7, alpha=.45)
    ax[0].plot([], [], color=renk, lw=1.5, label=f"Derece {d}: 15 farklı veri kümesi")
ax[0].plot(S_izgara, 10**f_izgara, color=MUREKKEP, ls="--", lw=1.4, label="Gizli gerçek eğri")
sn_ekseni(ax[0])
ax[0].set_title("Aynı plan, farklı veri kümeleri")
ax[0].legend(loc="upper right", fontsize=9)
ax[1].plot(dereceler, toplam, "o-", color=RENK[0], ms=4, label="σ² + yanlılık² + varyans")
ax[1].plot(dereceler, mc_test, "x", color=MUREKKEP, ms=7, mew=1.5, label="Monte Carlo test MSE")
ax[1].plot(dereceler, yanlilik2, "s-", color=RENK[1], ms=4, label="Yanlılık²")
ax[1].plot(dereceler, varyans, "^-", color=RENK[2], ms=4, label="Varyans")
ax[1].axhline(SIGMA2, color=SOLUK, ls=":", lw=1.4, label="σ² (indirgenemez)")
ax[1].set_yscale("log")
ax[1].set(xlabel="Polinom derecesi", ylabel="MSE (dekad²)", title="Yanlılık–varyans ayrışımı (200 küme)")
ax[1].set_xticks(dereceler)
ax[1].legend(loc="lower right", bbox_to_anchor=(1.0, 0.24), fontsize=8.5)
fig.savefig(KLASOR / "d03_capraz_dogrulama_2.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].plot(dereceler, mc_kfold.mean(axis=1), "^-", color=RENK[2], ms=4, label="KFold tahmini")
ax[0].plot(dereceler, mc_grup.mean(axis=1), "s-", color=RENK[1], ms=4, label="GroupKFold tahmini")
ax[0].plot(dereceler, mc_gercek.mean(axis=1), color=MUREKKEP, ls="--", lw=1.4, label="Gerçek hata")
log_y(ax[0], [0.15, 0.2, 0.3, 0.5, 0.8])
ax[0].set(xlabel="Polinom derecesi", ylabel="RMSE (dekad), 200 küme ortalaması",
          title="Hangi doğrulama gerçeği izliyor?")
ax[0].set_xticks(dereceler)
ax[0].legend(loc="upper center", fontsize=9)
genislik = 0.4
ax[1].bar(dereceler - genislik / 2, np.bincount(secim_g + 1, minlength=13)[1:], genislik, color=RENK[1],
          label="GroupKFold")
ax[1].bar(dereceler + genislik / 2, np.bincount(secim_k + 1, minlength=13)[1:], genislik, color=RENK[2],
          label="KFold")
ax[1].set(xlabel="Seçilen polinom derecesi", ylabel="Veri kümesi sayısı (200 içinden)",
          title="Seçilen derecenin dağılımı")
ax[1].set_xticks(dereceler)
ax[1].legend(loc="upper center", fontsize=9)
fig.savefig(KLASOR / "d03_capraz_dogrulama_3.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
for d, renk in [(1, RENK[1]), (8, RENK[0])]:
    boy, eg, dg = ogrenme[d]
    ax[0].plot(boy, eg, "o-", color=renk, ms=4, label=f"Derece {d}, eğitim")
    ax[0].plot(boy, dg, "s--", color=renk, ms=4, label=f"Derece {d}, doğrulama")
log_y(ax[0], [0.1, 0.15, 0.2, 0.3, 0.5, 1.0])
ax[0].set(xlabel="Eğitimdeki numune sayısı", ylabel="RMSE (dekad)", title="Öğrenme eğrileri (GroupKFold)")
ax[0].legend(loc="upper right", fontsize=9)
ax[1].plot(alfalar, vc_egitim, "o-", color=RENK[0], ms=4, label="Eğitim")
ax[1].plot(alfalar, vc_dogr, "s-", color=RENK[1], ms=4, label="Doğrulama (GroupKFold)")
ax[1].plot(alfalar[i_alfa], vc_dogr[i_alfa], marker="*", ms=13, color=MUREKKEP, ls="none",
           label=f"En iyi α = {alfalar[i_alfa]:g}")
ax[1].set_xscale("log")
log_y(ax[1], [0.1, 0.15, 0.2, 0.3, 0.5, 1.0])
ax[1].set(xlabel="Ridge cezası α", ylabel="RMSE (dekad)", title="Doğrulama eğrisi: derece 12 + Ridge")
ax[1].legend(loc="upper center", fontsize=9)
fig.savefig(KLASOR / "d03_capraz_dogrulama_4.png", dpi=160)
plt.close(fig)
print("Grafikler kaydedildi: d03_capraz_dogrulama_1.png, _2.png, _3.png, _4.png")=== 1. Veri ===
Geliştirme: 22 parti, 88 numune, 18 gerilme düzeyi (170–400 MPa), ömür 1.5e+04–1.4e+08 çevrim
Test: 6 yeni parti, 24 numune | 'Gerçek hata' örneklemi: 1000 parti, 4000 numune
Saçılma: partiler arası 0.15, parti içi 0.12 → indirgenemez hata σ = 0.192 dekad
Bu 22 partinin ortalama sapmalarının std'si: 0.136 (beklenen 0.162)
Gizli gerçek eğrinin bu 88 numunedeki RMSE'si: 0.155 dekad (beklenen σ = 0.192)
=== 2. Sıfırdan uygulamanın sağlaması ===
Sıfırdan 5 katlı CV, derece 4: rastgele katlar 0.1472; gruplu katlar 0.1772 = GroupKFold 0.1772
Vandermonde koşul sayısı (derece 12): ham log S ile 2.5e+19, [−1, 1] ölçeğinde 4.1e+04
=== 3–4. Derece taraması (RMSE, dekad) ve yanlılık–varyans (MSE, dekad², 200 veri kümesi) ===
derece eğitim KFold GroupKFold gerçek | yanlılık² varyans σ²+y²+v MC test
1 0.386 0.384 0.397 0.357 | 0.0877 0.0019 0.1265 0.1273
2 0.270 0.277 0.284 0.269 | 0.0320 0.0028 0.0717 0.0722
3 0.178 0.187 0.192 0.207 | 0.0053 0.0040 0.0462 0.0466
4 0.146 0.154 0.177 0.205 | 0.0010 0.0053 0.0432 0.0434
5 0.146 0.155 0.184 0.205 | 0.0009 0.0069 0.0448 0.0451
6 0.142 0.150 0.203 0.203 | 0.0005 0.0087 0.0461 0.0465
7 0.140 0.148 0.207 0.203 | 0.0002 0.0103 0.0474 0.0478
8 0.135 0.148 0.235 0.207 | 0.0002 0.0117 0.0488 0.0492
9 0.128 0.143 0.248 0.217 | 0.0002 0.0137 0.0507 0.0511
10 0.123 0.137 0.245 0.230 | 0.0002 0.0169 0.0540 0.0545
11 0.123 0.141 0.677 0.233 | 0.0002 0.0220 0.0591 0.0595
12 0.123 0.148 1.301 0.233 | 0.0005 0.0331 0.0705 0.0708
--- 200 veri kümesinde KFold ve GroupKFold ---
KFold : en sık seçilen dereceler 12 ve 11; seçilen modelin CV tahmini 0.169, gerçek hatası 0.255
GroupKFold: en sık seçilen dereceler 4 ve 3; seçilen modelin CV tahmini 0.204, gerçek hatası 0.217
Ortalama eğriler, derece 4 / 12: KFold 0.190 / 0.171, GroupKFold 0.212 / 0.898, gerçek 0.208 / 0.263
=== 5. Tekrarlı çapraz doğrulama (derece 4, 10 tekrar) ===
RepeatedKFold : tekrarlar 0.149–0.159, ortalama 0.154
GroupKFold (karış.): tekrarlar 0.156–0.188, ortalama 0.176
=== 6. Öğrenme ve doğrulama eğrileri (GroupKFold) ===
Derece 1: 20→68 numune; eğitim 0.355→0.384, doğrulama 0.426→0.396
Derece 8: 20→68 numune; eğitim 0.087→0.125, doğrulama 1.276→0.236
Doğrulama eğrisi (derece 12): α = 1e-8 → 1.144, en iyi α = 1e+00 → 0.191, α = 1e+3 → 0.815
=== 7. Hiperparametre araması ve iç içe CV (GroupKFold) ===
GridSearchCV: derece 4, α = 1; en iyi CV RMSE = 0.174
İç içe CV (dış 5 × iç 4): katlar 0.155 0.187 0.172 0.236 0.155 → ortalama 0.181
Dış katlarda seçilen (derece, α): (4, 1) (4, 1) (4, 1) (6, 1) (4, 1)
Son model: test RMSE (6 parti) = 0.173, gerçek hata (1000 parti) = 0.200
Grafikler kaydedildi: d03_capraz_dogrulama_1.png, _2.png, _3.png, _4.png9. Sonuçları yorumlayın
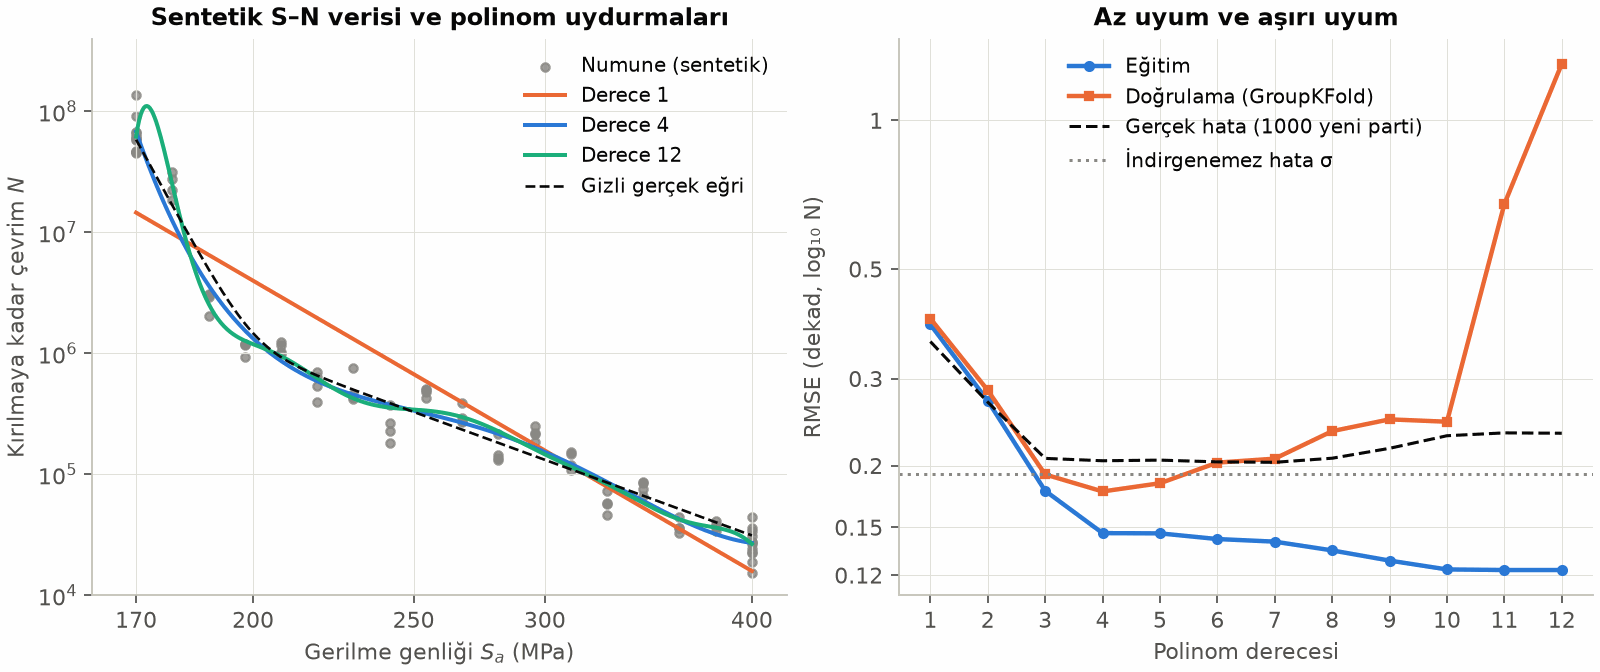
Soldaki grafik, Wöhler diyagramının eksenleri yer değiştirmiş hâlidir: model, ömrü gerilmenin fonksiyonu olarak öğreniyor. Derece 1 doğrusu en düşük gerilmelerde ömrü küçük, diz civarında ise büyük tahmin ediyor. Derece 4 gerçek eğriyi izliyor. Derece 12 veriye daha yakın geçiyor ama 170 MPa civarında, iki gerilme düzeyi arasında gerçek eğrinin üstüne fırlıyor. Bu çıkıntının arkasında veri yok; yalnızca polinomun esnekliği var.
Sağdaki grafikte eğitim eğrisi (mavi) dereceyle sürekli iniyor ve indirgenemez hata çizgisinin altında kalıyor. Bu tek başına aşırı uyumun kanıtı değil; gizli gerçek eğri de bu numunelerde 0,155'lik bir eğitim hatası verir. Belirleyici olan, eğitim hatası inerken gruplu doğrulamanın (turuncu) ve gerçek hatanın yükselmeye başlaması. İkisi de U biçimli; gruplu doğrulama en küçük değerini derece 4'te alıyor.
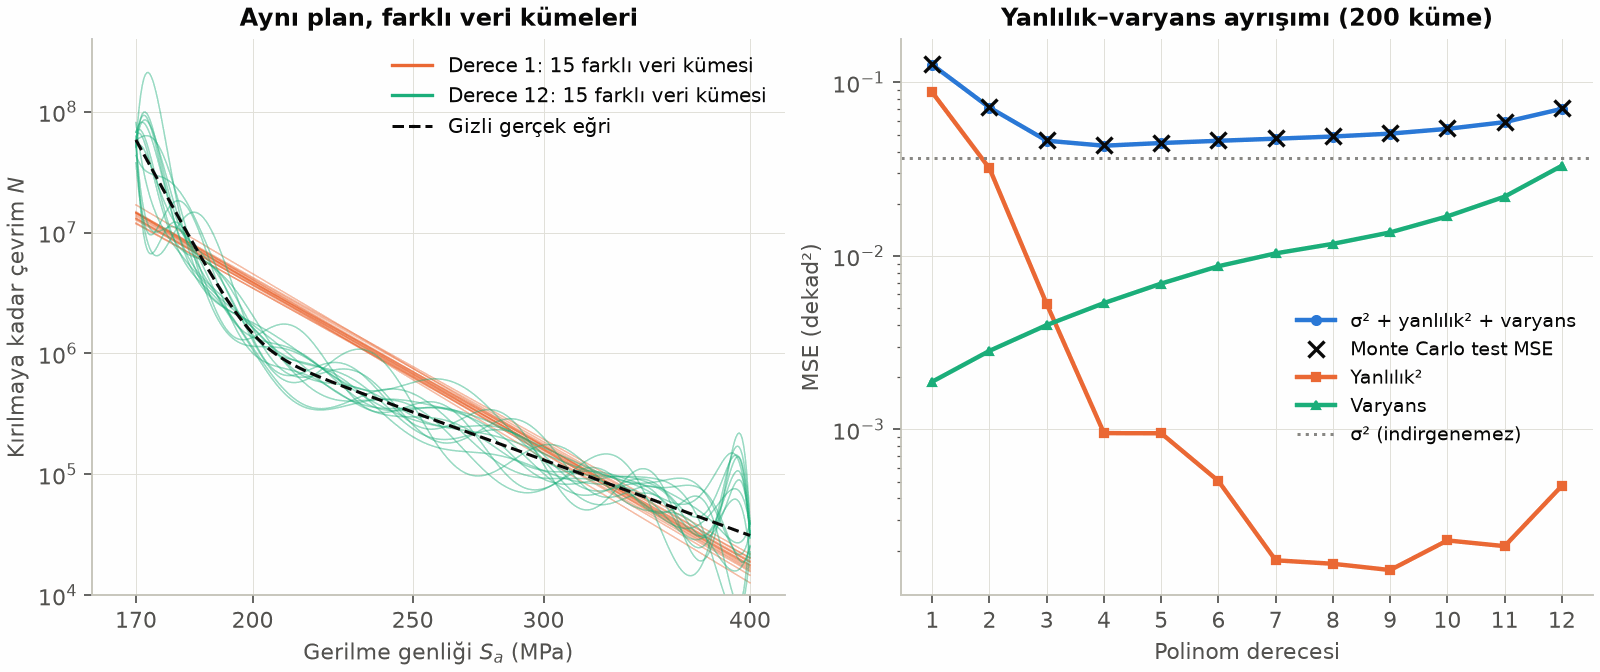
Soldaki grafik yanlılık ve varyansı gözle görülür kılıyor. Derece 1 doğruları birbirine çok yakın, yani varyans küçük; ama hepsi diz noktasını aynı biçimde kaçırıyor, yani yanlılık büyük. Derece 12 eğrilerinin ortalaması gerçek eğriyle çakışıyor, yani yanlılık küçük; ama her veri kümesinde başka yerde salınıyorlar, özellikle uçlarda. Sağdaki grafikte yanlılık² ile varyans ters yönlerde ilerliyor. Toplamın en düşük olduğu yer, ikisinin dengelendiği orta derecedir.
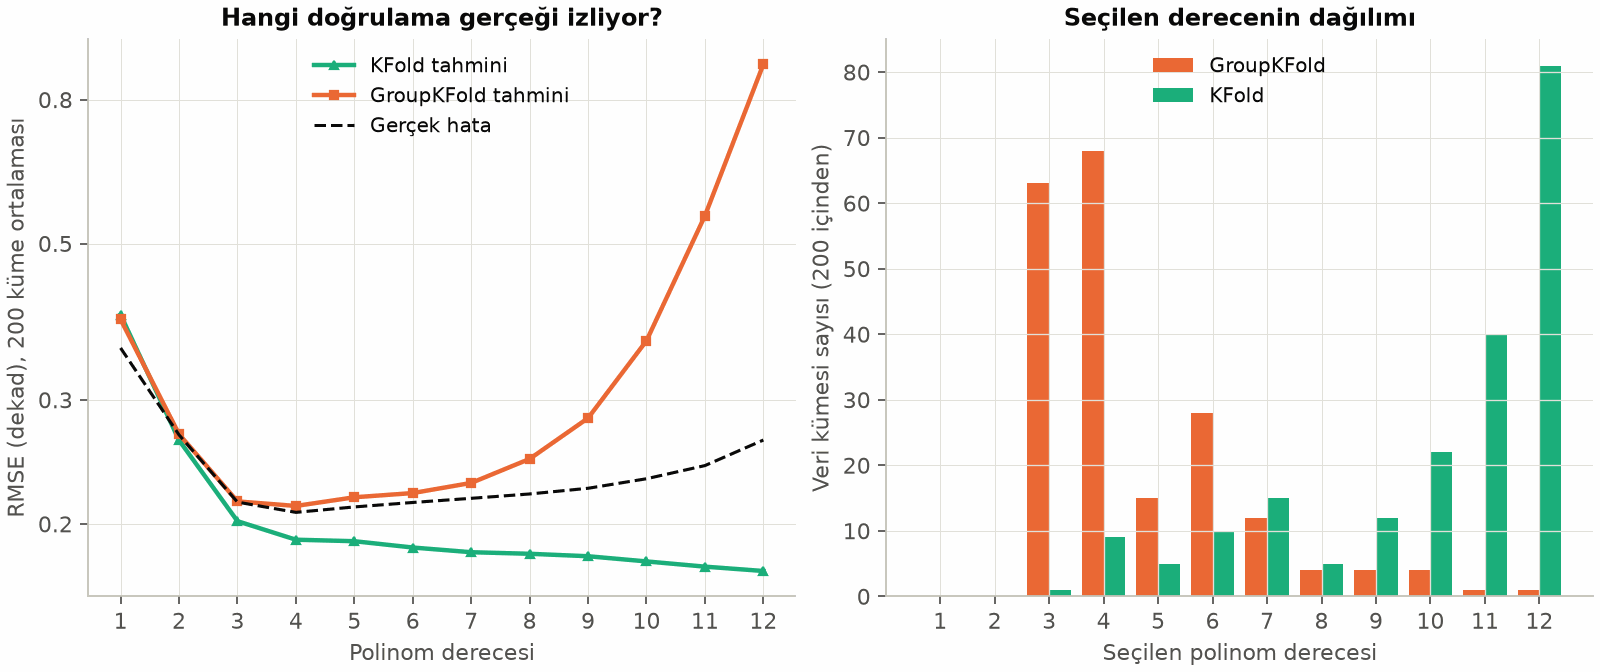
Bu grafik dersin ana mesajıdır. KFold eğrisi (yeşil) aşırı uyumu hiç görmüyor: derece arttıkça daha da iyimserleşiyor ve 200 kümenin çoğunda 11. ya da 12. dereceyi seçiyor. GroupKFold (turuncu) ise derece 4 civarında gerçek hatayı yakından izliyor ve seçimlerini 3–4. derecelerde topluyor. Hangi doğrulamanın doğru olduğu bir istatistik sorusu değil, bir mühendislik sorusudur: modeli nerede kullanacaksınız?
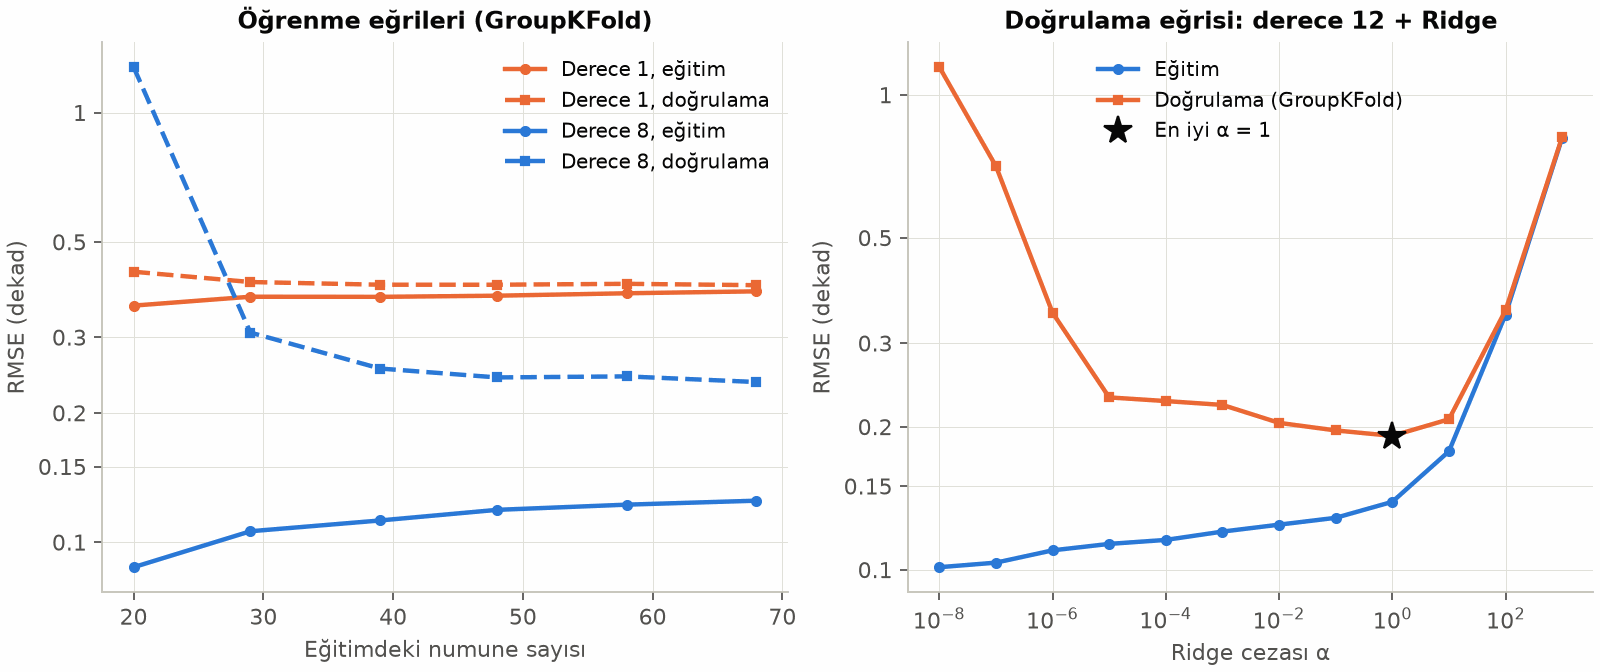
Öğrenme eğrileri iki farklı reçete yazıyor. Derece 1 için daha çok deney israftır; model değişmelidir. Derece 8 için ise daha çok veri yardımcı olur ama aynı etkiyi düzenlileştirmeyle bugünkü veriden de alabiliriz. Sağdaki doğrulama eğrisi tam bunu gösteriyor: 12. derece polinom, doğru cezayla 0,191'e iniyor.
10. Sık yapılan hatalar
- Gruplu veride rastgele bölmek. Aynı partiden, aynı numuneden, aynı yapıdan gelen ölçümler hem eğitimde hem doğrulamada olursa tahmin iyimser çıkar ve aşırı esnek model seçilir. Bu dersteki fark: 0,137'ye karşı gerçek 0,230.
- Test kümesiyle seçim yapmak. Test hatasına bakarak derece seçerseniz test hatası artık bir doğrulama hatasıdır ve iyimserdir (Alıştırma 4).
- Ön işlemeyi çapraz doğrulamanın dışında yapmak. Ölçekleyiciyi, özellik seçimini ya da eksik değer doldurmayı bütün veriye uyguladıktan sonra CV yaparsanız doğrulama katlarının bilgisi eğitime sızar. Bütün adımları bir
Pipeline'a koyun;cross_val_scoreveGridSearchCVpipeline'ı her katta yeniden eğitir. best_score_'u son performans diye raporlamak. Seçimin iyimserliğini içerir. İç içe CV ya da hiç dokunulmamış bir test kümesi kullanın.- CV tahminlerinin belirsizliğini unutmak. Gruplu tahmin, karıştırmaya göre 0,156 ile 0,188 arasında oynadı. Bu oynamadan küçük farklarla iki model arasında karar vermeyin.
- Verinin olmadığı yerde modele güvenmek. Derece 12 polinom, iki gerilme düzeyi arasında hiçbir veriye dayanmayan bir çıkıntı yaptı. Hiçbir doğrulama, verinin olmadığı yerdeki davranışı tam olarak ölçemez; aralık dışında ise hiç ölçemez.
11. Alıştırmalar
Alıştırma 1KolayParti etkisi olmasaydı
Betikte TAU, SIGMA_W = 0.0, 0.192 yapın (toplam saçılma aynı kalsın, parti etkisi kalksın) ve çalıştırın. Çıktının 3–4. bölümündeki “200 veri kümesinde KFold ve GroupKFold” satırlarında iki yöntem arasındaki fark ne oluyor? Neden?
Çözümü göster
Fark neredeyse kayboluyor. KFold en sık 4. ve 7. dereceleri seçiyor; seçilen modelin CV tahmini 0,197, gerçek hatası 0,203. GroupKFold en sık 4. ve 6. dereceleri seçiyor; tahmin 0,197, gerçek hata 0,202. Derece 4'te ortalama eğriler: KFold 0,199, GroupKFold 0,201, gerçek hata 0,199.
Numuneler artık birbirinden bağımsız. Bir numunenin kardeşlerini eğitimde görmek, ona dair bir şey söylemiyor. Gruplu doğrulama polinom yüzünden değil, verinin grup yapısı yüzünden gerekliydi. GroupKFold'un yüksek derecedeki kötümserliği ise sürüyor (derece 12'de 0,557'ye karşı gerçek 0,219); çünkü katlardaki gerilme düzeyi boşlukları hâlâ orada.
Alıştırma 2KolayHer parti ayrı bir kat
GroupKFold(5) yerine LeaveOneGroupOut() kullanarak 1–12. dereceler için çapraz doğrulama hatasını hesaplayın. Hangi derece seçilir? Tahmin, GroupKFold'unkinden neden farklı?
Çözümü göster
from sklearn.model_selection import LeaveOneGroupOut
logo = [-cross_val_score(model(d), X, y, groups=parti, cv=LeaveOneGroupOut(),
                         scoring=RMSE_SKOR).mean() for d in dereceler]
En küçük değer yine derece 4'te: 0,161 (GroupKFold(5): 0,177, gerçek hata: 0,205). Her katta 22 partiden 21'i eğitimde kaldığı için boşluklar küçük ve tahmin daha az kötümser; derece 12'de 0,744 (GroupKFold: 1,301). Bedeli, her derece için 22 kez eğitim ve tek partilik katlardan gelen daha oynak bir tahmindir. İki yöntem de aynı dereceyi seçiyor.
Alıştırma 3OrtaDaha çok numune mi, daha çok parti mi?
Numune sayısını iki katına çıkarmanın iki yolunu deneyin: (a) her partiden 8 numune (sn_verisi(parti_duzeyi, 8, rng)), (b) her düzeyde iki kat parti (parti_duzeyi'yi np.repeat(..., 2) ile çoğaltın). İkisinde de 176 numune olur. Derece 4 için eğrinin kendisindeki hatayı, $\sqrt{\text{yanlılık}^2 + \text{varyans}}$, tablodan hesaplayıp karşılaştırın.
Çözümü göster
Derece 4 için yanlılık² üç durumda da 0,0010. Varyans ise asıl planda 0,0053, (a)'da 0,0050, (b)'de 0,0025. Eğrinin hatası sırasıyla 0,079, 0,077 ve 0,059 dekad. Numuneleri ikiye katlamak neredeyse hiçbir şey kazandırmıyor; partileri ikiye katlamak varyansı yarıya indiriyor.
Nedeni, bir gerilme düzeyindeki ortalamanın gürültüsü. $h$ parti ve partide $s$ numune varsa bu gürültünün varyansı $\tau^2/h + \sigma_w^2/(hs)$ olur. Asıl planda $0{,}0225 + 0{,}0036 = 0{,}0261$; (a)'da $0{,}0225 + 0{,}0018 = 0{,}0243$ (yüzde 7 az), (b)'de $0{,}01125 + 0{,}0018 = 0{,}0131$ (yüzde 50 az). Parti kayması aynı partinin numuneleri arasında ortalamayla yok olmaz. Yeni bir numunenin toplam hatası ise üç durumda da yakın: $\sqrt{0{,}0432}$, $\sqrt{0{,}0428}$ ve $\sqrt{0{,}0404}$, yani 0,208, 0,207 ve 0,201. Baskın olan saçılmadır. Deney planlarken ders: eğrinin kendisini daha iyi bilmek istiyorsanız tekrar sayısından çok parti sayısını artırın.
Alıştırma 4OrtaTest kümesiyle derece seçmek
Kodun 3. hücresinde (# %% 3) oluşturulan uydurmalar sözlüğündeki polinomların (en küçük kareler, derece 1–12) test kümesi RMSE'sini hesaplayın ve en küçük test hatasını veren dereceyi seçin. Seçtiğiniz modelin test hatası ile gerçek hatasını karşılaştırın.
Çözümü göster
test_h = [rmse(polinom_tahmin(uydurmalar[d], x_test), y_test) for d in dereceler]Test hatası en küçük derece 2'de: 0,171. Ama derece 2'nin gerçek hatası 0,269; GroupKFold'un seçtiği derece 4'ün ise 0,205 (test hatası 0,182). Altı partilik test kümesi hem küçük hem şans eseri derece 2'ye uygun düşmüş. Seçim için kullanılınca test hatası iyimser bir doğrulama hatasına dönüşüyor: 0,171'e karşı 0,269. Test kümesi seçimden sonra, bir kez kullanılır.
Alıştırma 5ZorBirini dışarıda bırakmanın kısayolu
En küçük karelerde $\vect w = (V^\top V)^{-1}V^\top \vect y$ ve şapka matrisi $H = V(V^\top V)^{-1}V^\top$'dir. $i$. numune dışarıda bırakılarak eğitilen modelin o numunedeki hatasının $e_{(i)} = e_i/(1 - h_{ii})$ olduğunu gösterin ($e_i$ tam veriyle bulunan artık, $h_{ii}$ şapka matrisinin köşegeni). Sonra derece 4 için 88 ayrı uydurmayla bu formülü sayısal olarak karşılaştırın ve LOO RMSE'sini, $\sqrt{\tfrac1n\sum_i e_{(i)}^2}$, GroupKFold ile kıyaslayın.
Çözümü göster
$A = V^\top V$, $\vect b = V^\top \vect y$ ve $i$. satır $\vect v$ olsun; $h = \vect v^\top A^{-1}\vect v$. Satırı çıkarınca $A \to A - \vect v\vect v^\top$ ve $\vect b \to \vect b - \vect v y_i$ olur. Sherman–Morrison özdeşliği:
$$ (A - \vect v\vect v^\top)^{-1} = A^{-1} + \frac{A^{-1}\vect v\vect v^\top A^{-1}}{1 - h} $$Bunu kullanıp $\hat y_i = \vect v^\top A^{-1}\vect b$ yazarsak, dışarıda bırakılan modelin tahmini:
$$ \begin{aligned} \vect v^\top \vect w_{(i)} &= \hat y_i - h\,y_i + \frac{h\,(\hat y_i - h\,y_i)}{1 - h} \\ &= \frac{\hat y_i - h\,y_i}{1 - h} \end{aligned} $$Dolayısıyla $y_i - \vect v^\top \vect w_{(i)} = (y_i - \hat y_i)/(1 - h)$.
V = np.vander(z(x), 5, increasing=True)
H = V @ np.linalg.solve(V.T @ V, V.T)
e = y - V @ polinom_uydur(x, y, 4)
e_loo = e / (1 - np.diag(H))
88 ayrı uydurmayla bulunan hatalar formülle en fazla $1{,}3\times10^{-14}$ farklı: aynı sayılar. LOO RMSE 0,1544; $h_{ii}$ değerleri 0,041 ile 0,075 arasında ve toplamları 5, yani parametre sayısı. LOO, GroupKFold'un 0,177'sinden ve gerçek hatanın 0,205'inden belirgin biçimde küçük; KFold'un 0,154'üyle neredeyse aynı. Tek numune bıraktığı için o numunenin üç kardeşi hep eğitimde kalır. Kısayol hız kazandırır ama gruplu veride yanlış soruyu çok hızlı cevaplar.
Özet
- Eğitim hatası karmaşıklıkla hep azalır; görülmemiş verideki hata ise önce azalır, sonra artar. Doğru karmaşıklık doğrulamayla seçilir.
- Beklenen hata = indirgenemez hata + yanlılık² + varyans. Az uyumlu modelde yanlılık, aşırı uyumlu modelde varyans baskındır.
- k-katlı çapraz doğrulama küçük veriyi verimli kullanır. Bölme şeması ise sorunuza uymalıdır: gruplu veride
GroupKFold, zaman serisindeTimeSeriesSplit. - Rastgele bölme, gruplu veride hem iyimser bir hata verir hem de aşırı esnek modeli seçtirir.
- En iyi CV skoru seçim yüzünden iyimserdir; dürüst bir sayı için iç içe CV ya da hiç dokunulmamış bir test kümesi kullanın.
Sonraki derste karmaşıklığı kontrol etmenin ikinci yolunu, düzenlileştirmeyi göreceğiz: Ridge ve Lasso cezaları, ölçeklemenin önemi ve beton dayanımı verisinde su/bağlayıcı oranı gibi anlamlı özelliklerin gücü.
Kaynaklar
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 7 (model değerlendirme ve seçimi; yanlılık–varyans, çapraz doğrulama).
- C. M. Bishop — Pattern Recognition and Machine Learning, Bölüm 3.2 (yanlılık–varyans ayrışımı).
- G. C. Cawley, N. L. C. Talbot (2010) — On over-fitting in model selection and subsequent selection bias in performance evaluation, Journal of Machine Learning Research 11, 2079–2107.
- scikit-learn — Cross-validation ve Tuning the hyper-parameters of an estimator belgeleri.