Bu derste öğrenecekleriniz
- k-means amaç fonksiyonunu ve Lloyd algoritmasını sıfırdan yazmak, yerel minimum sorununu göstermek
- k-means++ başlatmasının ve ölçeklemenin sonuca etkisini açıklamak
- Küme sayısını dirsek, siluet ve BIC ölçütleriyle seçmek ve bu ölçütlerin sınırlarını tartışmak
- Gauss karışımını EM algoritmasıyla kurmak ve yumuşak atamaları yorumlamak
- DBSCAN ile yoğunluğa dayalı kümeler bulmak ve aykırı okumaları ayıklamak
- Kümeleri ayarlanmış Rand indeksiyle gerçek tabakalarla karşılaştırmak
1. Problem: CPT okumalarından zemin tabakaları
Koni penetrasyon deneyinde (CPT) ucu 60° açılı bir koni, zemine sabit hızla (2 cm/s) itilir. Cihaz her birkaç santimetrede iki büyüklük kaydeder: koninin ucundaki direnç $q_c$ (MPa) ve koninin arkasındaki manşonda oluşan sürtünme $f_s$. İkisinin oranı, yüzde olarak sürtünme oranıdır: $R_f = 100\,f_s/q_c$. Kabaca söylersek kumlarda uç direnci yüksek, sürtünme oranı düşüktür. Killerde ise tersi geçerlidir. 20 metrelik bir sondaj, binden fazla okuma ve bu okumaların arkasında birkaç tabaka demektir.
Tabakaları ayırmak için bu derste kümeleme (clustering) kullanacağız. Kümeleme, denetimsiz öğrenmenin en tanıdık örneğidir: elimizde hedef yok, yalnızca özellikler var. Algoritma, birbirine benzeyen okumaları aynı gruba koymaya çalışır. Grupların ne anlama geldiğine biz karar veririz. Bu bölümden sonra hep bu soruyu soracağız: algoritmanın bulduğu kümeler, zeminin gerçek tabakalarına karşılık geliyor mu?
Mühendislik standardı CPT abaklarıdır
CPT verisinden zemin sınıfı tahmin etmenin yerleşik yolu, zemin davranış türü (SBT) abaklarıdır. Örneğin Robertson'ın abakları, gerilmeye göre normalleştirilmiş uç direnci ve sürtünme oranını kullanır ve geniş bir saha deneyimine dayanır. Bu derste o abakları yeniden üretmiyoruz. Kümeleme burada keşif amaçlıdır: “bu sondajda kaç farklı davranış var, sınırlar nerede?” sorusuna ilk bir cevap verir. Sonucu yorumlamak, abaklar, sondaj kuyusu ve laboratuvar deneyleriyle karşılaştırmak geoteknik mühendisinin işidir.
Veri sentetiktir. 0–20 m arasında 2 cm aralıkla 1001 okuma ürettik. Dört tabaka var: yumuşak kil (0,0–4,6 m), siltli kum (4,6–9,2 m), katı kil (9,2–13,8 m) ve sıkı kum (13,8–20,0 m). Her tabakada $\log_{10} q_c$ normal dağılır ve derinlikle hafifçe artar. $R_f$ de normal dağılır ve uç direnciyle hafifçe ters yönde ilişkilidir. Dalgalanmalar bağımsız değildir: derinlik boyunca yaklaşık 15 cm ölçekli bir ilişki taşırlar, tıpkı gerçek zemindeki gibi. Tabaka sınırlarında okumalar birkaç santimetrelik bir geçişle değişir. Ayrıca 14 okumayı sıçrama olarak bozduk: çakıl tanesi ya da kayıt hatası gibi nedenlerle iki kanalda birden ani, tek okumalık sıçramalar. Ortaya çıkan tabakaların ortalama değerleri şöyle:
| Tabaka | Derinlik (m) | $q_c$ medyanı (MPa) | $R_f$ ortalaması (%) |
|---|---|---|---|
| Yumuşak kil | 0,0–4,6 | 0,61 | 4,61 |
| Siltli kum | 4,6–9,2 | 4,31 | 1,70 |
| Katı kil | 9,2–13,8 | 2,04 | 5,36 |
| Sıkı kum | 13,8–20,0 | 14,61 | 0,82 |
Kümelemede iki özellik kullanacağız: $\log_{10} q_c$ ve $R_f$. Uç direncinin logaritmasını alıyoruz, çünkü $q_c$ 0,39 ile 74,8 MPa arasında, iki mertebeden fazla değişiyor. Ardından iki özelliği de standartlaştırıyoruz (ortalama 0, standart sapma 1). Gerçek tabaka etiketleri kümeleme sırasında hiç kullanılmıyor; yalnızca sonunda karşılaştırma için devreye giriyor.
İki bölünmeyi karşılaştırmak: ayarlanmış Rand indeksi
Kümelemenin çıktısı küme numaralarıdır ve bu numaraların bir anlamı yoktur: “küme 2” sıkı kum da olabilir, yumuşak kil de. Bu yüzden doğruluk gibi bir ölçüt kullanamayız. Rand indeksi (RI), bütün okuma çiftlerine bakar: iki bölünmenin de aynı kümeye koyduğu ya da ikisinin de ayırdığı çiftlerin oranıdır. Ayarlanmış Rand indeksi (ARI, Hubert ve Arabie, 1985) bunu şansa göre düzeltir:
$$ \text{ARI} = \frac{\text{RI} - \E[\text{RI}]}{\max(\text{RI}) - \E[\text{RI}]} $$ARI = 1, iki bölünmenin numaralandırma dışında aynı olduğu anlamına gelir. Rastgele bir bölünmede ARI 0 civarındadır. scikit-learn'de karşılığı adjusted_rand_score fonksiyonudur.
2. k-means ve Lloyd algoritması
k-means, her kümeyi bir merkezle temsil eder ve her noktayı en yakın merkeze atar. Amacı, noktaların kendi merkezlerine olan kare uzaklıklarının toplamını küçültmektir. Bu toplama küme içi kareler toplamı ya da scikit-learn'deki adıyla inertia denir:
$$ J = \sum_{i=1}^{n} \big\lVert \vect x_i - \vect\mu_{c_i} \big\rVert^2 $$Burada $c_i$, $i$'inci noktanın kümesi, $\vect\mu_j$ ise $j$'inci kümenin merkezidir. $J$'yi hem atamalara hem merkezlere göre aynı anda en küçük yapmak zor bir problemdir. Lloyd algoritması işi ikiye böler ve iki adımı sırayla tekrarlar:
- Atama: merkezler sabitken her noktayı en yakın merkeze ata: $c_i = \argmin_j \lVert \vect x_i - \vect\mu_j\rVert^2$.
- Güncelleme: atamalar sabitken her merkezi kendi noktalarının ortalamasına taşı.
Atamalar değişmeyince algoritma durur.
Neden ortalama, neden monoton azalma?
Atamalar sabitken $J$, her kümenin katkısının toplamıdır: $J = \sum_j J_j$, $J_j = \sum_{i:\,c_i=j}\lVert \vect x_i - \vect\mu_j\rVert^2$. $J_j$'nin $\vect\mu_j$'ye göre gradyanını sıfıra eşitleyelim:
$$ \frac{\partial J_j}{\partial \vect\mu_j} = -2\sum_{i:\,c_i=j}\big(\vect x_i - \vect\mu_j\big) = \vect 0 $$Buradan $\vect\mu_j$, kümedeki noktaların ortalaması çıkar. Atama adımı da merkezler sabitken $J$'yi her nokta için ayrı ayrı en küçük yapar. İki adımın hiçbiri $J$'yi artıramaz. Olası bölünme sayısı sonlu olduğu için algoritma sonlu adımda durur. Ama durduğu yer bir yerel minimumdur: başka bir başlangıç noktası, daha iyi bir bölünmeye götürebilir.
def lloyd(X, merkez, en_cok=100):
    """k-means için Lloyd algoritması: atama ve güncelleme adımlarını sırayla tekrarlar."""
    inertia = []
    for _ in range(en_cok):
        d2 = ((X[:, None, :] - merkez[None, :, :]) ** 2).sum(axis=2)   # (n, k) kare uzaklıklar
        etiket = d2.argmin(axis=1)                                     # atama: en yakın merkez
        inertia.append(d2[np.arange(len(X)), etiket].sum())
        yeni = np.array([X[etiket == j].mean(axis=0) if np.any(etiket == j) else merkez[j]
                         for j in range(len(merkez))])                 # güncelleme: küme ortalaması
        if np.allclose(yeni, merkez):
            break
        merkez = yeni
    return etiket, merkez, np.array(inertia)
Kod, her denemede inertianın hiçbir adımda artmadığını bir assert ile denetliyor. NumPy'nin yayınlama (broadcasting) özelliği sayesinde bütün nokta–merkez uzaklıkları tek satırda, $(n, k)$ boyutlu bir dizi olarak hesaplanıyor.
Başlatma: rastgele ve k-means++
En basit başlatma, $k$ veri noktasını rastgele seçip merkez yapmaktır. İki merkez aynı kümeye düşerse algoritma bu hatayı çoğu zaman düzeltemez ve kötü bir yerel minimumda kalır. k-means++ (Arthur ve Vassilvitskii, 2007) merkezleri birbirinden uzak seçmeye çalışır. İlk merkez rastgele seçilir. Sonraki her merkez için her noktanın seçilme olasılığı, o noktanın en yakın mevcut merkeze kare uzaklığıyla orantılıdır. Uzaktaki ve henüz temsil edilmeyen bölgeler böylece daha olası hâle gelir.
def kmeanspp(X, k, rng):
    """k-means++: her yeni merkez, en yakın merkeze kare uzaklıkla orantılı olasılıkla seçilir."""
    merkez = [X[rng.integers(len(X))]]
    for _ in range(k - 1):
        d2 = ((X[:, None, :] - np.array(merkez)[None]) ** 2).sum(axis=2).min(axis=1)
        merkez.append(X[rng.choice(len(X), p=d2 / d2.sum())])
    return np.array(merkez)
k-means++ bile en iyi çözümü garanti etmez. scikit-learn'deki KMeans, algoritmayı n_init kez farklı başlangıçlarla çalıştırıp en düşük inertiayı veren çözümü saklayabilir. Ama varsayılan n_init='auto', k-means++ ile tek bir başlatma demektir; kodda bu yüzden n_init=10 yazıyoruz.
k-means neyi varsayar?
Her nokta en yakın merkeze gittiği için kümeler arasındaki sınırlar doğrusaldır; düzlem, merkezlerin Voronoi bölgelerine ayrılır. Bu yapı, birbirine benzer büyüklükte, yaklaşık yuvarlak kümelerde iyi çalışır. Uzamış, iç içe geçmiş ya da yoğunluğu çok farklı kümelerde zorlanır. Uzaklık ölçüsü Öklid uzaklığıdır, bu yüzden ölçek belirleyicidir. $q_c$'yi MPa olarak bırakırsak sıkı kumdaki 10–30 MPa'lık değişim her şeyi belirler. $R_f$ ise neredeyse hiç sayılmaz. Ölçeklemenin bu derste ne kadar fark yarattığını sonuçlarda göreceğiz (Ders 06'daki uzaklık tartışmasını hatırlayın).
Kendiniz deneyin
Aşağıdaki denemede Lloyd algoritmasını adım adım izleyebilirsiniz. “Adım” düğmesi her basışta sıradaki işlemi yapar (atama ya da güncelleme); düğmenin yazısı hangisinin geleceğini söyler. Sol grafikte noktalar küme rengiyle, merkezler büyük işaretle, her merkezin Voronoi bölgesi hafif gölgeyle görünür. Sağ grafik inertianın iterasyonla değişimini çizer.
- Yuvarlak kümeler veri kümesinde Başlatma: Rastgele ile birkaç kez Yeniden başlat deyin. Aynı veride farklı sonuçlara ulaştığınız oluyor mu? Sağdaki eğri hiç yükseliyor mu?
- Aynı denemeyi k-means++ ile tekrarlayın ve Sonuna kadar düğmesiyle kaç iterasyonda yakınsadığına bakın.
- Uzamış kümeler ve Farklı boyut ve yoğunluk veri kümelerinde doğru $k$ ile bile Voronoi sınırlarının kümeleri nasıl kestiğini gözleyin.
Bu etkileşimli deneme için tarayıcıda JavaScript açık olmalıdır.
3. Küme sayısını seçmek: dirsek ve siluet
$k$ arttıkça inertia her zaman azalır; $k = n$ olunca sıfıra iner. Bu yüzden inertiayı en küçük yapan $k$'yi seçemeyiz. Dirsek yöntemi inertiayı $k$'ye karşı çizer ve azalmanın belirgin biçimde yavaşladığı noktayı arar. Okuması kişiden kişiye değişebilen, öznel bir ölçüttür.
Siluet katsayısı her nokta için iki ortalama uzaklığı karşılaştırır. $a(i)$, noktanın kendi kümesindeki diğer noktalara ortalama uzaklığıdır. $b(i)$ ise en yakın başka kümenin noktalarına ortalama uzaklığıdır:
$$ s(i) = \frac{b(i) - a(i)}{\max\{a(i),\ b(i)\}} $$$s(i)$, $-1$ ile $1$ arasındadır. 1'e yakın değer, noktanın kendi kümesine iyi oturduğunu, 0 civarı iki kümenin sınırında olduğunu, negatif değer ise yanlış kümede olduğunu gösterir. Bütün noktaların ortalaması, $k$'yi seçmek için kullanılır: ortalama siluet katsayısı en büyük olan $k$ tercih edilir.
4. Gauss karışımı ve EM algoritması
k-means her noktayı kesin olarak bir kümeye atar ve kümelerin yuvarlak olduğunu örtük olarak varsayar. Gauss karışım modeli (GMM) veriyi $K$ tane çok değişkenli normal dağılımın ağırlıklı toplamı olarak modeller:
$$ p(\vect x) = \sum_{k=1}^{K} \pi_k\,\mathcal N\big(\vect x \mid \vect\mu_k, \Sigma_k\big) $$$\pi_k$, bileşenin ağırlığıdır (toplamları 1), $\vect\mu_k$ ortalaması, $\Sigma_k$ ise kovaryans matrisidir. Kovaryans matrisi bileşene eğik ve uzamış bir elips biçimi verebilir. Parametreler en çok olabilirlikle bulunur; bunun için kullanılan yöntem EM (expectation–maximization) algoritmasıdır. EM, k-means'teki iki adımın yumuşak bir sürümüdür.
E-adımı: mevcut parametrelerle her noktanın her bileşene ait olma olasılığı, yani sorumluluk hesaplanır:
$$ \gamma_{ik} = \frac{\pi_k\,\mathcal N(\vect x_i \mid \vect\mu_k, \Sigma_k)}{\sum_{j}\pi_j\,\mathcal N(\vect x_i \mid \vect\mu_j, \Sigma_j)} $$M-adımı: sorumluluklar ağırlık olarak kullanılıp parametreler yeniden hesaplanır. $N_k = \sum_i \gamma_{ik}$, $k$'inci bileşenin “etkin nokta sayısıdır”:
$$ \pi_k = \frac{N_k}{n} $$ $$ \vect\mu_k = \frac{1}{N_k}\sum_{i}\gamma_{ik}\,\vect x_i $$ $$ \Sigma_k = \frac{1}{N_k}\sum_{i}\gamma_{ik}\,(\vect x_i - \vect\mu_k)(\vect x_i - \vect\mu_k)^\top $$Her EM turu log-olabilirliği artırır ya da değiştirmez; k-means'teki inertia gibi monotondur ve yine yerel bir optimumda durabilir. Bütün bileşenlerin kovaryansı $\varepsilon I$ alınıp $\varepsilon \to 0$ götürülürse sorumluluklar 0 ya da 1'e iner ve EM, k-means'e dönüşür. Kodda E-adımını SciPy ile elle hesaplayıp scikit-learn'ün predict_proba sonucuyla karşılaştırıyoruz.
Sorumluluklar k-means'in veremediği bir bilgi taşır: yumuşak atama. En büyük olasılığı 0,9'un altında kalan bir okuma, model açısından iki tabaka arasında belirsizdir. Mühendislik açısından bu, “bu okumaya ayrıca bakın” demektir.
Kovaryans türleri ve BIC
scikit-learn'deki covariance_type, modelin esnekliğini belirler. İki özellikli verimizde bileşen başına parametre sayıları şöyledir: full, her bileşene ayrı ve eğik bir elips verir (3 kovaryans parametresi). tied, bütün bileşenlere aynı elipsi verir. diag, eksenlere paralel elipslere izin verir (2 parametre). spherical ise yalnız daireye izin verir (1 parametre). Esneklik arttıkça olabilirlik artar ama aşırı uyum riski de büyür. Bileşen sayısını ve türünü seçmek için Bayes bilgi ölçütü (BIC) kullanılır:
$\hat L$ en büyük olabilirlik, $p$ parametre sayısı, $n$ gözlem sayısıdır. İlk terim uyumu ödüllendirir, ikincisi karmaşıklığı cezalandırır. BIC'i en küçük yapan model seçilir. Bir uyarı: BIC'in cezası, gözlemlerin birbirinden bağımsız olduğu varsayımıyla türetilmiştir.
5. DBSCAN: yoğunluğa dayalı kümeler
k-means ve Gauss karışımı her noktayı bir kümeye koyar; tek okumalık bir sıçrama da bir kümenin parçası olur ve o kümenin merkezini ya da kovaryansını çarpıtır. DBSCAN (Ester, Kriegel, Sander ve Xu, 1996) kümeyi “yoğun bölge” olarak tanımlar. İki parametresi vardır: komşuluk yarıçapı eps ve en az komşu sayısı min_samples. Noktalar üç türe ayrılır:
- Çekirdek nokta:
epsyarıçaplı komşuluğunda (kendisi dahil) en azmin_samplesnokta var. - Sınır noktası: kendisi çekirdek değil ama bir çekirdek noktanın komşuluğunda.
- Gürültü: ikisi de değil. DBSCAN bu noktaları hiçbir kümeye koymaz; scikit-learn onlara $-1$ etiketini verir.
Birbirinin komşuluğunda olan çekirdek noktalar zincirleme bağlanır ve aynı kümeyi oluşturur. Küme sayısını önceden vermek gerekmez; kümeler her biçimde olabilir. Bedeli, tek bir eps değerinin bütün kümelere uyması gerekmesidir. Yoğunlukları çok farklı kümelerde ya da kümeleri birbirine bağlayan seyrek “köprüler” varsa DBSCAN zorlanır. eps'yi seçmek için k-uzaklık eğrisi kullanılır: her noktanın min_samples'ıncı komşusuna uzaklığı (nokta kendisi dahil sayıldığında) küçükten büyüğe sıralanır. Eğrinin dik yükselmeye başladığı “diz” noktası, yoğun bölgelerle seyrek noktaları ayıran bir eşik önerir.
Hiyerarşik kümeleme
Bir de tek bir bölünme yerine iç içe bölünmeler üreten yöntemler vardır. Toplayıcı (agglomerative) hiyerarşik kümeleme her noktayı ayrı bir küme olarak başlatır ve her adımda en yakın iki kümeyi birleştirir. “En yakın” tanımı bağlantı ölçütüyle belirlenir. Ward bağlantısı, küme içi toplam varyansı en az artıran birleştirmeyi seçer, yani k-means'in amacına en yakın olanıdır. Birleştirme geçmişi bir ağaç diyagramıyla (dendrogram) çizilir ve ağaç istenen yükseklikten kesilerek $k$ küme elde edilir. Bellek ihtiyacı $n^2$ ile büyüdüğü için birkaç on bin noktanın ötesinde pahalıdır. Kodda Ward bağlantısını AgglomerativeClustering ile karşılaştırma için çalıştırıyoruz.
6. Çalıştırılabilir kod
Kod yedi bölümden oluşur: sentetik sondaj, sıfırdan k-means, $k$ seçimi, Gauss karışımı ve BIC, DBSCAN, karşılaştırma ve grafikler. Betik birkaç saniye ile yarım dakika arasında çalışır. Gauss karışımında tol=1e-6 kullandığımıza dikkat edin; nedenini Bölüm 8'de göreceğiz.
"""Ders 09 — Kümeleme: k-means, Gauss karışımı ve DBSCAN.

Sentetik bir koni penetrasyon deneyi (CPT) sondajındaki okumaları, etiket kullanmadan gruplara
ayırıyor ve bulunan kümeleri derinliğe geri taşıyıp gerçek tabakalarla karşılaştırıyoruz:
  * k-means'i Lloyd algoritmasıyla sıfırdan yazıp scikit-learn ile karşılaştırıyoruz,
  * rastgele ve k-means++ başlatmayı, yerel minimumları ve ölçeklemenin etkisini ölçüyoruz,
  * k'yi dirsek ve siluet ölçütleriyle, Gauss karışımında BIC ile seçiyoruz,
  * DBSCAN ile tek okumalık sıçramaları gürültü olarak ayıklıyoruz.

Veri sentetiktir: 0–20 m arasında 2 cm aralıkla 1001 okuma, dört tabaka (yumuşak kil, siltli kum,
katı kil, sıkı kum). Her tabakada uç direnci q_c log-normal, sürtünme oranı R_f normal dağılır;
derinlik boyunca ilişkili dalgalanma, tabaka sınırlarında geçiş ve 14 tek okumalık sıçrama eklenir.
Gerçek bir saha kaydı değildir. Zemin sınıflandırması için mühendislik standardı CPT abaklarıdır.

Çalıştır:  python d09_kumeleme.py
Gerekenler: numpy, scipy, scikit-learn, matplotlib  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre dört PNG grafiği
"""
import os
os.environ.setdefault("OMP_NUM_THREADS", "1")  # küçük veride tek iş parçacığı: hızlı ve tekrarlanabilir

from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D
from matplotlib.patches import Patch
from matplotlib.ticker import NullFormatter
from scipy.optimize import linear_sum_assignment
from scipy.stats import multivariate_normal
from sklearn.cluster import DBSCAN, AgglomerativeClustering, KMeans
from sklearn.metrics import adjusted_rand_score, silhouette_score
from sklearn.mixture import GaussianMixture
from sklearn.neighbors import NearestNeighbors
from sklearn.preprocessing import StandardScaler

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent

# %% 1. Veri: sentetik CPT sondajı
rng = np.random.default_rng(42)
DZ = 0.02                                        # okuma aralığı (m)
z = np.round(np.arange(0, 20 + DZ / 2, DZ), 2)   # derinlik (m)
n = len(z)
# (ad, üst, alt, log10 q_c üstte, log10 q_c altta, log10 q_c std, R_f ort. %, R_f std %, korelasyon)
TABAKA = [("Yumuşak kil", 0.0, 4.6, -0.35, -0.10, 0.06, 4.6, 0.60, -0.3),
          ("Siltli kum", 4.6, 9.2, 0.62, 0.75, 0.12, 1.7, 0.35, -0.5),
          ("Katı kil", 9.2, 13.8, 0.28, 0.36, 0.07, 5.2, 0.60, -0.3),
          ("Sıkı kum", 13.8, 20.0, 1.15, 1.30, 0.10, 0.8, 0.18, -0.5)]
ADLAR = [t[0] for t in TABAKA]
gercek = np.zeros(n, dtype=int)
mu_q, mu_r, sd_q, sd_r, kor = (np.zeros(n) for _ in range(5))
for k, (ad, ust, alt, q_ust, q_alt, sq, rf, sr, rh) in enumerate(TABAKA):
    m = (z >= ust) & ((z < alt) if k < len(TABAKA) - 1 else (z <= alt))
    gercek[m] = k
    mu_q[m] = q_ust + (q_alt - q_ust) * (z[m] - ust) / (alt - ust)   # q_c derinlikle artar
    mu_r[m], sd_q[m], sd_r[m], kor[m] = rf, sq, sr, rh


def yumusat(a, s=0.04):
    """Tabaka sınırında geçiş: ortalama profili Gauss çekirdeğiyle (σ = 4 cm) yumuşat."""
    u = np.arange(-10, 11) * DZ
    w = np.exp(-0.5 * (u / s) ** 2)
    return np.convolve(np.pad(a, 10, mode="edge"), w / w.sum(), mode="valid")


mu_q, mu_r = yumusat(mu_q), yumusat(mu_r)
phi = np.exp(-DZ / 0.15)                      # derinlikte ilişkili dalgalanma, ölçek 15 cm (AR(1))
e = np.zeros((n, 2))
for i in range(n):
    yeni = rng.normal(size=2)
    e[i] = yeni if i == 0 else phi * e[i - 1] + np.sqrt(1 - phi**2) * yeni
log_qc = mu_q + sd_q * e[:, 0]
Rf = mu_r + sd_r * (kor * e[:, 0] + np.sqrt(1 - kor**2) * e[:, 1])
sicrama = np.sort(rng.choice(np.arange(25, n - 25), size=14, replace=False))  # tek okumalık sıçramalar
log_qc[sicrama] += np.log10(rng.uniform(2.5, 5.0, sicrama.size))
Rf[sicrama] *= rng.uniform(1.6, 2.4, sicrama.size)
qc = 10.0**log_qc                             # uç direnci (MPa)
X_ham = np.column_stack([log_qc, Rf])
olcek = StandardScaler().fit(X_ham)
X = olcek.transform(X_ham)                    # standartlaştırılmış (log10 q_c, R_f)
assert np.all(np.isfinite(X)) and X.shape == (n, 2)

print("=== 1. Veri: sentetik CPT sondajı ===")
print(f"Okuma: {n} (0–20 m, {DZ*100:.0f} cm aralık), {len(TABAKA)} tabaka, "
      f"{sicrama.size} tek okumalık sıçrama; q_c {qc.min():.2f}–{qc.max():.1f} MPa")
for k, (ad, ust, alt, *_) in enumerate(TABAKA):
    m = gercek == k
    print(f"  {ad:12s} {ust:4.1f}–{alt:4.1f} m: q_c medyan {np.median(qc[m]):5.2f} MPa, "
          f"R_f ort. {Rf[m].mean():.2f} %")
print(f"Özellikler: log10 q_c (std {olcek.scale_[0]:.2f}) ve R_f (std {olcek.scale_[1]:.2f} %), "
      "ikisi de standartlaştırıldı")


# %% 2. k-means: Lloyd algoritması, sıfırdan
def lloyd(X, merkez, en_cok=100):
    """k-means için Lloyd algoritması: atama ve güncelleme adımlarını sırayla tekrarlar."""
    inertia = []
    for _ in range(en_cok):
        d2 = ((X[:, None, :] - merkez[None, :, :]) ** 2).sum(axis=2)   # (n, k) kare uzaklıklar
        etiket = d2.argmin(axis=1)                                     # atama: en yakın merkez
        inertia.append(d2[np.arange(len(X)), etiket].sum())
        yeni = np.array([X[etiket == j].mean(axis=0) if np.any(etiket == j) else merkez[j]
                         for j in range(len(merkez))])                 # güncelleme: küme ortalaması
        if np.allclose(yeni, merkez):
            break
        merkez = yeni
    return etiket, merkez, np.array(inertia)


def kmeanspp(X, k, rng):
    """k-means++: her yeni merkez, en yakın merkeze kare uzaklıkla orantılı olasılıkla seçilir."""
    merkez = [X[rng.integers(len(X))]]
    for _ in range(k - 1):
        d2 = ((X[:, None, :] - np.array(merkez)[None]) ** 2).sum(axis=2).min(axis=1)
        merkez.append(X[rng.choice(len(X), p=d2 / d2.sum())])
    return np.array(merkez)


K = 4
deneme = {"rastgele": [], "k-means++": []}
for _ in range(50):
    baslangiclar = [("rastgele", X[rng.choice(n, K, replace=False)]), ("k-means++", kmeanspp(X, K, rng))]
    for ad, baslangic in baslangiclar:
        etiket, merkez, inertia = lloyd(X, baslangic)
        assert np.all(np.diff(inertia) <= 1e-9)          # inertia hiçbir adımda artmaz
        deneme[ad].append((inertia, etiket, merkez))
en_iyi = min(d[0][-1] for liste in deneme.values() for d in liste)
km = KMeans(K, n_init=10, random_state=42).fit(X)
_, et_biz, mz_biz = min(deneme["k-means++"], key=lambda d: d[0][-1])
print("\n=== 2. k-means: Lloyd algoritması (sıfırdan) ===")
for ad, liste in deneme.items():
    son = np.array([d[0][-1] for d in liste])
    print(f"{ad:10s}: en iyi inertiaya ({en_iyi:.2f}) ulaşan {np.sum(son < en_iyi * (1 + 1e-4))}/50 deneme; "
          f"en kötü {son.max():.2f}, ortalama iterasyon {np.mean([len(d[0]) for d in liste]):.1f}")
yerel = np.unique(np.round([d[0][-1] for liste in deneme.values() for d in liste], 2))
print(f"100 denemede iki ondalıkta {yerel.size} farklı sonuç (yerel minimum): "
      f"{yerel.min():.2f} – {yerel.max():.2f}")
print(f"scikit-learn KMeans (n_init=10): inertia {km.inertia_:.2f}; bizim çözümle ARI "
      f"{adjusted_rand_score(km.labels_, et_biz):.3f}")
assert np.isclose(km.inertia_, en_iyi)
ari_km = adjusted_rand_score(gercek, km.labels_)
print(f"k-means (k = 4) ile gerçek tabakalar: ARI = {ari_km:.3f}")
ari_olcek = {ad: adjusted_rand_score(gercek, KMeans(K, n_init=10, random_state=42).fit(A).labels_)
             for ad, A in [("ham q_c (MPa), R_f", np.column_stack([qc, Rf])), ("log10 q_c, R_f", X_ham)]}
print("Ölçeklemenin etkisi (ARI): " + " | ".join(f"{a} {v:.3f}" for a, v in ari_olcek.items())
      + f" | standartlaştırılmış {ari_km:.3f}")

# %% 3. k seçimi: dirsek ve siluet
K_LISTE = list(range(1, 9))
inertia_k = [KMeans(k, n_init=10, random_state=42).fit(X).inertia_ for k in K_LISTE]
siluet_k = [silhouette_score(X, KMeans(k, n_init=10, random_state=42).fit_predict(X)) for k in K_LISTE[1:]]
print("\n=== 3. k seçimi ===")
print("k        " + "".join(f"{k:8d}" for k in K_LISTE))
print("inertia  " + "".join(f"{v:8.1f}" for v in inertia_k))
print("siluet   " + " " * 8 + "".join(f"{v:8.3f}" for v in siluet_k))

# %% 4. Gauss karışımı (EM) ve BIC
TURLER = ["full", "tied", "diag", "spherical"]


def karisim(k, tur="full", tol=1e-6):
    """EM ile Gauss karışımı. Varsayılan tol=1e-3 bu veride EM'i yakınsamadan durduruyor."""
    return GaussianMixture(k, covariance_type=tur, n_init=3, tol=tol, max_iter=1000, random_state=42).fit(X)


bic = {t: [karisim(k, t).bic(X) for k in K_LISTE] for t in TURLER}
gmm = karisim(K)
gmm_gevsek = karisim(K, tol=1e-3)
olas = gmm.predict_proba(X)
# E-adımını elle yapıp kütüphaneyle karşılaştır: γ_ik = π_k N(x_i | μ_k, Σ_k) / Σ_j π_j N(x_i | μ_j, Σ_j)
pay = np.column_stack([gmm.weights_[k] * multivariate_normal(gmm.means_[k], gmm.covariances_[k]).pdf(X)
                       for k in range(K)])
assert np.allclose(pay / pay.sum(axis=1, keepdims=True), olas)
et_gmm = olas.argmax(axis=1)
ari_gmm = adjusted_rand_score(gercek, et_gmm)
belirsiz = olas.max(axis=1) < 0.9
sinirlar = np.array([t[2] for t in TABAKA[:-1]])
sinira_uzaklik = np.abs(z[:, None] - sinirlar[None]).min(axis=1)
k_bic = int(np.argmin(bic["full"])) + 1
gmm_bic = karisim(k_bic)
agirlik = np.sort(gmm_bic.weights_)[::-1] * n
print("\n=== 4. Gauss karışımı (EM) ===")
print("BIC, k =        " + "".join(f"{k:8d}" for k in K_LISTE) + "   en iyi k")
for t, b in bic.items():
    print(f"  {t:13s}" + "".join(f"{v:8.0f}" for v in b) + f"{int(np.argmin(b)) + 1:8d}")
print(f"Komşu okumalar arası korelasyon φ = {phi:.3f}; ortalama için etkin örnek sayısı "
      f"n(1 − φ)/(1 + φ) ≈ {n * (1 - phi) / (1 + phi):.0f}")
print(f"k = 4, tam kovaryans: ARI {ari_gmm:.3f}; elle yapılan E-adımı predict_proba ile aynı")
print(f"Log-olabilirlik: tol=1e-6 ile {gmm.score(X) * n:.2f} ({gmm.n_iter_} iterasyon); "
      f"varsayılan tol=1e-3 ile {gmm_gevsek.score(X) * n:.2f} ({gmm_gevsek.n_iter_} iterasyon, "
      f"ARI {adjusted_rand_score(gercek, gmm_gevsek.predict(X)):.3f})")
sicrama_belirsiz = np.isin(np.flatnonzero(belirsiz), sicrama).sum()
print(f"Belirsiz okuma (en büyük olasılık < 0.9): {belirsiz.sum()} (sınıra 20 cm'den yakın "
      f"{np.sum(belirsiz & (sinira_uzaklik <= 0.2))}, sıçrama {sicrama_belirsiz})")
parca = []
for k, ad in enumerate(ADLAR):
    zk = z[belirsiz & (gercek == k)]
    if zk.size:
        parca.append(f"{ad} {zk.size} ({zk[0]:.2f} m)" if zk.size == 1 else
                     f"{ad} {zk.size} ({zk[0]:.2f}–{zk[-1]:.2f} m)")
print("  tabakalara göre: " + ", ".join(parca))
et_bic = gmm_bic.predict(X)
kucuk = np.flatnonzero(et_bic == np.argmin(gmm_bic.weights_))     # en küçük bileşenin okumaları
print(f"k = {k_bic} (BIC seçimi): ARI {adjusted_rand_score(gercek, et_bic):.3f}; bileşenlerin beklenen okuma "
      f"sayıları {', '.join(f'{a:.0f}' for a in agirlik)}")
print(f"  en küçük bileşene atanan {kucuk.size} okuma: sıçrama {np.isin(kucuk, sicrama).sum()}, "
      f"sınıra 20 cm'den yakın {np.sum(sinira_uzaklik[kucuk] <= 0.2)}")

# %% 5. DBSCAN: yoğunluk tabanlı kümeler ve gürültü
MIN_ORNEK, EPS = 30, 0.20
k_uzaklik = np.sort(NearestNeighbors(n_neighbors=MIN_ORNEK).fit(X).kneighbors(X)[0][:, -1])
db = DBSCAN(eps=EPS, min_samples=MIN_ORNEK).fit(X)
et_db = db.labels_
gurultu = et_db == -1
print("\n=== 5. DBSCAN ===")
print(f"{MIN_ORNEK}. komşuya uzaklık (nokta kendisi dahil): medyan {np.median(k_uzaklik):.3f}, "
      f"%90'lık {np.quantile(k_uzaklik, 0.9):.3f}, %95'lik {np.quantile(k_uzaklik, 0.95):.3f}")
print(f"min_samples = {MIN_ORNEK}, eps = {EPS:.2f}: {et_db.max() + 1} küme, {gurultu.sum()} gürültü okuması "
      f"(14 sıçramanın {gurultu[sicrama].sum()}'ü, {gurultu.sum() - gurultu[sicrama].sum()} diğer okuma)")
print(f"ARI: gürültü hariç {adjusted_rand_score(gercek[~gurultu], et_db[~gurultu]):.3f}, "
      f"gürültü ayrı küme sayılırsa {adjusted_rand_score(gercek, et_db):.3f}")
et_db2 = DBSCAN(eps=0.25, min_samples=MIN_ORNEK).fit(X).labels_
print(f"eps = 0.25 ile: {et_db2.max() + 1} küme, {np.sum(et_db2 == -1)} gürültü okuması")
assert gurultu[sicrama].sum() >= 12


def tabakaya_esle(etiket):
    """Küme numaralarını en çok örtüştükleri tabakaya eşle (renkler sütunlar arasında tutarlı olsun)."""
    kumeler = [c for c in np.unique(etiket) if c >= 0]
    tablo = np.array([[np.sum((etiket == c) & (gercek == t)) for t in range(len(TABAKA))] for c in kumeler])
    sat, sut = linear_sum_assignment(-tablo)
    esle = {kumeler[i]: j for i, j in zip(sat, sut)}
    return np.array([esle.get(c, -1) for c in etiket])


# %% 6. Hiyerarşik kümeleme (Ward) ve özet
et_ward = AgglomerativeClustering(K, linkage="ward").fit_predict(X)
print("\n=== 6. Karşılaştırma (bütün okumalarla, gerçek tabakalara göre ARI) ===")
print(f"k-means {ari_km:.3f} | Gauss karışımı {ari_gmm:.3f} | DBSCAN, gürültü ayrı küme "
      f"{adjusted_rand_score(gercek, et_db):.3f} | Ward {adjusted_rand_score(gercek, et_ward):.3f}")
esle_km, esle_gmm = tabakaya_esle(km.labels_), tabakaya_esle(et_gmm)
sic = np.isin(np.arange(n), sicrama)
km_kar, gmm_kar = (gercek == 1) & (esle_km == 3), (gercek == 3) & (esle_gmm == 1)
print(f"Karışan okumalar: k-means'te siltli kumdan sıkı kuma {km_kar.sum()} ({np.sum(km_kar & sic)} sıçrama), "
      f"Gauss karışımında sıkı kumdan siltli kuma {gmm_kar.sum()} ({np.sum(gmm_kar & sic)} sıçrama; "
      f"sıkı kumdaki sıçrama sayısı {np.sum(sic & (gercek == 3))})")


# %% 7. Grafikler
renk_km, renk_gmm, renk_db = tabakaya_esle(km.labels_), tabakaya_esle(et_gmm), tabakaya_esle(et_db)
TR = np.array(RENK[:4])
merkez_ham = olcek.inverse_transform(km.cluster_centers_)


def ozellik_ekseni(a, baslik):
    a.set_xscale("log")
    a.set_xticks([0.3, 1, 3, 10, 30, 100], ["0.3", "1", "3", "10", "30", "100"])
    a.set(xlabel="Uç direnci $q_c$ (MPa, log ölçek)", ylabel="Sürtünme oranı $R_f$ (%)", title=baslik)


# Şekil 1: özellik uzayında dört görünüm
fig, ax = plt.subplots(2, 2, figsize=(10, 7.5), layout="constrained", sharex=True, sharey=True)
ax = ax.ravel()
ax[0].scatter(qc, Rf, s=6, c=TR[gercek], lw=0, antialiased=False)
ax[0].scatter(qc[sicrama], Rf[sicrama], s=40, marker="x", color=MUREKKEP, label="sıçrama")
ax[0].legend(handles=[Patch(color=RENK[k], label=a) for k, a in enumerate(ADLAR)]
             + [Line2D([], [], marker="x", ls="none", color=MUREKKEP, label="sıçrama")], loc="upper right")
ozellik_ekseni(ax[0], "Gerçek tabakalar (etiketler kümelemede kullanılmaz)")
ax[1].scatter(qc, Rf, s=6, c=TR[renk_km], lw=0, antialiased=False)
ax[1].scatter(10 ** merkez_ham[:, 0], merkez_ham[:, 1], s=160, marker="X", color=MUREKKEP, edgecolor="white",
              label="küme merkezi")
ax[1].legend(loc="center right")
ozellik_ekseni(ax[1], f"k-means, k = 4 (ARI = {ari_km:.3f})")
ax[2].scatter(qc[~belirsiz], Rf[~belirsiz], s=6, c=TR[renk_gmm[~belirsiz]], lw=0, antialiased=False)
ax[2].scatter(qc[belirsiz], Rf[belirsiz], s=22, c=TR[renk_gmm[belirsiz]], edgecolor=MUREKKEP, lw=0.8,
              label="en büyük olasılık < 0.9")
aci = np.linspace(0, 2 * np.pi, 100)
S = np.diag(olcek.scale_)
for k in range(K):
    C = S @ gmm.covariances_[k] @ S                       # kovaryansı asıl birimlere çevir
    deger, vektor = np.linalg.eigh(C)
    elips = (vektor @ np.diag(2 * np.sqrt(deger)) @ np.vstack([np.cos(aci), np.sin(aci)])).T
    elips += olcek.inverse_transform(gmm.means_[k:k + 1])
    ax[2].plot(10 ** elips[:, 0], elips[:, 1], color=MUREKKEP, lw=1.2)
ax[2].legend(loc="center right")
ozellik_ekseni(ax[2], f"Gauss karışımı, 2σ elipsleri (ARI = {ari_gmm:.3f})")
ax[3].scatter(qc[~gurultu], Rf[~gurultu], s=6, c=TR[renk_db[~gurultu]], lw=0, antialiased=False)
ax[3].scatter(qc[gurultu], Rf[gurultu], s=30, marker="x", color=MUREKKEP,
              label=f"gürültü ({gurultu.sum()} okuma)")
ax[3].legend(loc="center right")
ozellik_ekseni(ax[3], f"DBSCAN, eps = {EPS}, min_samples = {MIN_ORNEK}")
for a in ax:
    a.label_outer()
fig.savefig(KLASOR / "d09_kumeleme_1.png", dpi=160)
plt.close(fig)

# Şekil 2: Lloyd iterasyonları, dirsek ve siluet
fig, ax = plt.subplots(1, 3, figsize=(10, 4.2), layout="constrained")
for inertia, *_ in deneme["rastgele"][:12]:
    ax[0].plot(np.arange(1, len(inertia) + 1), inertia, color=SOLUK, lw=1, alpha=0.8)
for inertia, *_ in deneme["k-means++"][:12]:
    ax[0].plot(np.arange(1, len(inertia) + 1), inertia, color=RENK[0], lw=1.2, alpha=0.8)
ax[0].axhline(en_iyi, color=MUREKKEP, ls=":", lw=1.2)
ax[0].legend(handles=[Line2D([], [], color=SOLUK, label="rastgele başlatma"),
                      Line2D([], [], color=RENK[0], label="k-means++"),
                      Line2D([], [], color=MUREKKEP, ls=":", label="en iyi inertia")], loc="upper right")
ax[0].set_yscale("log")
ax[0].set_yticks([150, 200, 300, 500, 1000, 2000], ["150", "200", "300", "500", "1000", "2000"])
ax[0].yaxis.set_minor_formatter(NullFormatter())
ax[0].set(xlabel="İterasyon", ylabel="Inertia (standart birim²)",
          title="Lloyd: monoton azalma, yerel minimum")
ax[1].plot(K_LISTE, inertia_k, "o-", color=RENK[0])
ax[1].axvline(4, color=MUREKKEP, ls=":", lw=1.2)
ax[1].set(xlabel="Küme sayısı k", ylabel="Inertia (standart birim²)", title="Dirsek yöntemi")
ax[2].plot(K_LISTE[1:], siluet_k, "o-", color=RENK[1])
ax[2].axvline(4, color=MUREKKEP, ls=":", lw=1.2)
ax[2].set(xlabel="Küme sayısı k", ylabel="Ortalama siluet katsayısı", title="Siluet ölçütü")
fig.savefig(KLASOR / "d09_kumeleme_2.png", dpi=160)
plt.close(fig)

# Şekil 3: BIC ve k-uzaklık eğrisi
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
for j, t in enumerate(TURLER):
    ax[0].plot(K_LISTE, bic[t], "o-", color=RENK[j], ms=4, label=t)
ax[0].axvline(4, color=MUREKKEP, ls=":", lw=1.2)
ax[0].set(xlabel="Bileşen sayısı k", ylabel="BIC (küçük daha iyi)", title="Gauss karışımı: BIC")
ax[0].legend(title="covariance_type", loc="upper right")
ax[1].plot(np.arange(1, n + 1), k_uzaklik, color=RENK[0])
ax[1].axhline(EPS, color=MUREKKEP, ls=":", lw=1.2, label=f"seçilen eps = {EPS}")
ax[1].axhline(0.25, color=RENK[1], ls="--", lw=1.2, label="eps = 0.25: iki kum birleşir")
ax[1].set(xlabel="Okumalar (uzaklığa göre sıralı)", ylabel=f"{MIN_ORNEK}. komşuya uzaklık (standart birim)",
          title="DBSCAN için k-uzaklık eğrisi", ylim=(0, 1.0))
ax[1].legend(loc="upper left")
fig.savefig(KLASOR / "d09_kumeleme_3.png", dpi=160)
plt.close(fig)

# Şekil 4: zemin kolonu — ölçümler ve kümelerin derinliğe dönüşü
fig, ax = plt.subplots(1, 6, figsize=(10, 7.5), layout="constrained", sharey=True,
                       gridspec_kw={"width_ratios": [2.2, 2.2, 1, 1, 1, 1]})
ax[0].plot(qc, z, color=MUREKKEP, lw=0.8)
ax[0].plot(qc[sicrama], z[sicrama], "x", color=RENK[7], ms=6)
ax[0].set_xscale("log")
ax[0].set_xticks([0.3, 1, 3, 10, 30, 100], ["0.3", "1", "3", "10", "30", "100"])
ax[0].set(xlabel="$q_c$ (MPa)", ylabel="Derinlik (m)", title="Uç direnci")
ax[1].plot(Rf, z, color=MUREKKEP, lw=0.8)
ax[1].plot(Rf[sicrama], z[sicrama], "x", color=RENK[7], ms=6)
ax[1].set(xlabel="$R_f$ (%)", title="Sürtünme oranı")
for a, et, baslik in [(ax[2], gercek, "Gerçek"), (ax[3], renk_km, "k-means"),
                      (ax[4], renk_gmm, "Gauss\nkarışımı"), (ax[5], renk_db, "DBSCAN")]:
    renkler = np.array([TR[e] if e >= 0 else MUREKKEP for e in et])
    a.barh(z, np.ones(n), height=DZ, color=renkler, linewidth=0)
    a.set(xlim=(0, 1), xticks=[], title=baslik)
    a.grid(False)
ax[4].plot(np.full(belirsiz.sum(), 0.85), z[belirsiz], "<", color=MUREKKEP, ms=4)   # belirsiz okumalar
ax[0].invert_yaxis()
for a in ax[2:]:
    for s_ in sinirlar:
        a.axhline(s_, color=MUREKKEP, lw=0.6, ls=":")
fig.legend(handles=[Patch(color=RENK[k], label=a) for k, a in enumerate(ADLAR)]
           + [Patch(color=MUREKKEP, label="DBSCAN gürültüsü"),
              Line2D([], [], marker="<", ls="none", color=MUREKKEP, label="olasılık < 0.9")],
           loc="outside lower center", ncol=3)
fig.savefig(KLASOR / "d09_kumeleme_4.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d09_kumeleme_1.png, _2.png, _3.png, _4.png")=== 1. Veri: sentetik CPT sondajı ===
Okuma: 1001 (0–20 m, 2 cm aralık), 4 tabaka, 14 tek okumalık sıçrama; q_c 0.39–74.8 MPa
Yumuşak kil 0.0– 4.6 m: q_c medyan 0.61 MPa, R_f ort. 4.61 %
Siltli kum 4.6– 9.2 m: q_c medyan 4.31 MPa, R_f ort. 1.70 %
Katı kil 9.2–13.8 m: q_c medyan 2.04 MPa, R_f ort. 5.36 %
Sıkı kum 13.8–20.0 m: q_c medyan 14.61 MPa, R_f ort. 0.82 %
Özellikler: log10 q_c (std 0.53) ve R_f (std 2.03 %), ikisi de standartlaştırıldı
=== 2. k-means: Lloyd algoritması (sıfırdan) ===
rastgele : en iyi inertiaya (127.37) ulaşan 23/50 deneme; en kötü 274.29, ortalama iterasyon 9.2
k-means++ : en iyi inertiaya (127.37) ulaşan 33/50 deneme; en kötü 274.29, ortalama iterasyon 5.3
100 denemede iki ondalıkta 12 farklı sonuç (yerel minimum): 127.37 – 274.29
scikit-learn KMeans (n_init=10): inertia 127.37; bizim çözümle ARI 1.000
k-means (k = 4) ile gerçek tabakalar: ARI = 0.948
Ölçeklemenin etkisi (ARI): ham q_c (MPa), R_f 0.694 | log10 q_c, R_f 0.753 | standartlaştırılmış 0.948
=== 3. k seçimi ===
k 1 2 3 4 5 6 7 8
inertia 2002.0 426.6 271.4 127.4 90.0 75.6 65.0 57.0
siluet 0.701 0.655 0.677 0.685 0.630 0.524 0.466
=== 4. Gauss karışımı (EM) ===
BIC, k = 1 2 3 4 5 6 7 8 en iyi k
full 4749 2927 2453 2020 1595 1610 1635 1656 5
tied 4749 3878 3569 2868 2341 2215 2224 2140 8
diag 5709 3698 2734 2138 1748 1678 1701 1704 6
spherical 5702 3978 2951 2528 2058 1928 1929 1867 8
Komşu okumalar arası korelasyon φ = 0.875; ortalama için etkin örnek sayısı n(1 − φ)/(1 + φ) ≈ 67
k = 4, tam kovaryans: ARI 0.934; elle yapılan E-adımı predict_proba ile aynı
Log-olabilirlik: tol=1e-6 ile -930.68 (23 iterasyon); varsayılan tol=1e-3 ile -984.45 (3 iterasyon, ARI 0.953)
Belirsiz okuma (en büyük olasılık < 0.9): 28 (sınıra 20 cm'den yakın 3, sıçrama 0)
tabakalara göre: Yumuşak kil 1 (4.54 m), Siltli kum 6 (6.52–8.46 m), Sıkı kum 21 (13.84–17.84 m)
k = 5 (BIC seçimi): ARI 0.957; bileşenlerin beklenen okuma sayıları 308, 227, 224, 222, 20
en küçük bileşene atanan 18 okuma: sıçrama 13, sınıra 20 cm'den yakın 6
=== 5. DBSCAN ===
30. komşuya uzaklık (nokta kendisi dahil): medyan 0.124, %90'lık 0.230, %95'lik 0.297
min_samples = 30, eps = 0.20: 4 küme, 41 gürültü okuması (14 sıçramanın 14'ü, 27 diğer okuma)
ARI: gürültü hariç 0.967, gürültü ayrı küme sayılırsa 0.916
eps = 0.25 ile: 3 küme, 28 gürültü okuması
=== 6. Karşılaştırma (bütün okumalarla, gerçek tabakalara göre ARI) ===
k-means 0.948 | Gauss karışımı 0.934 | DBSCAN, gürültü ayrı küme 0.916 | Ward 0.911
Karışan okumalar: k-means'te siltli kumdan sıkı kuma 11 (1 sıçrama), Gauss karışımında sıkı kumdan siltli kuma 17 (4 sıçrama; sıkı kumdaki sıçrama sayısı 4)
Grafikler kaydedildi: d09_kumeleme_1.png, _2.png, _3.png, _4.png7. Sonuçlar: k-means, başlatma ve ölçek
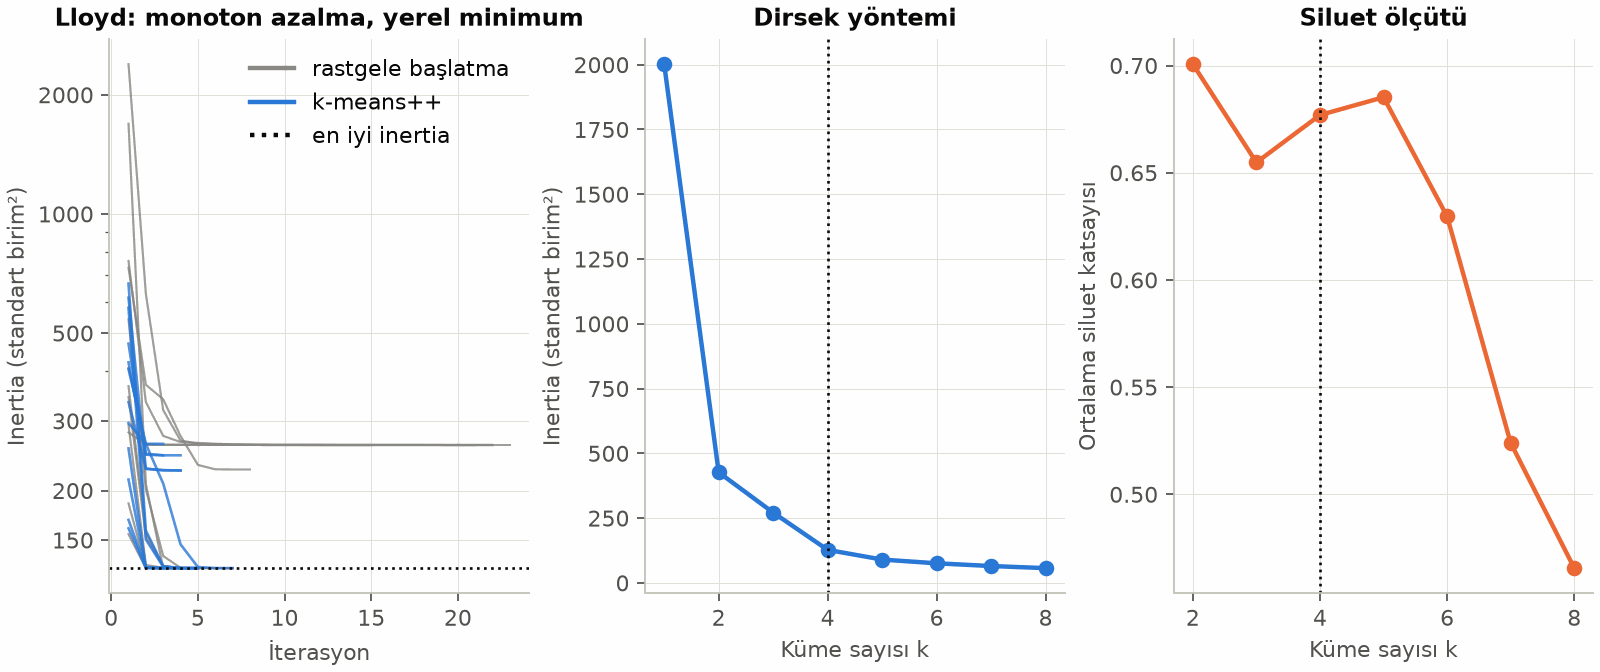
Sıfırdan yazdığımız Lloyd algoritmasını iki başlatmayla 50'şer kez çalıştırdık. En iyi inertia 127,37 çıktı. Rastgele başlatmada denemelerin 23'ü, k-means++'ta 33'ü bu değere ulaştı. (127,37'ye yuvarlanan iki çözüm var; birbirlerinden yalnızca bir okumanın kümesiyle ayrılıyorlar.) İki yöntemin en kötü sonucu da 274,29: en iyinin iki katından fazla. 100 denemede, iki ondalık basamağa yuvarlanınca 12 farklı yerel minimum bulundu. k-means++ ayrıca daha hızlı yakınsıyor: ortalama 9,2 yerine 5,3 iterasyon. scikit-learn'ün KMeans'i (n_init=10) aynı en iyi inertiayı (127,37) buldu ve bizim çözümümüzle ARI = 1,000. Yani iki çözüm, küme numaraları dışında aynı.
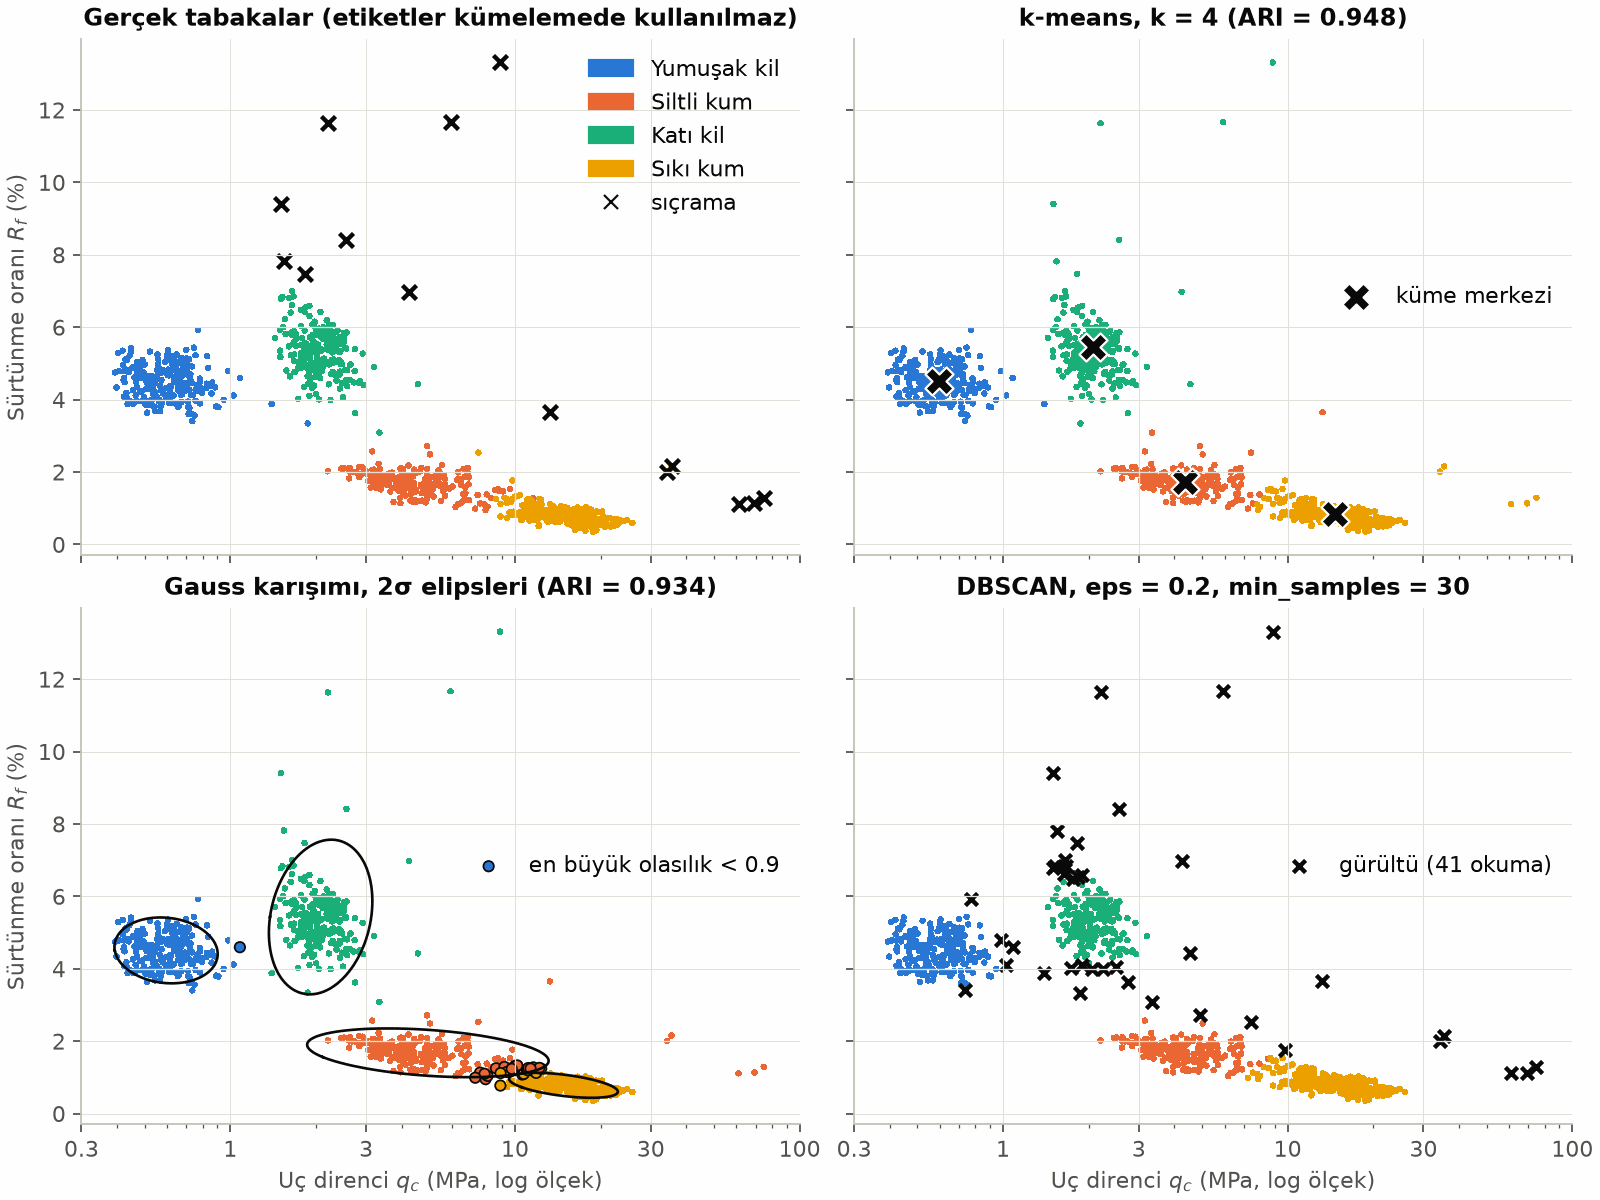
Dört kümeli k-means ile gerçek tabakalar arasındaki ARI 0,948. Ölçeklemenin etkisi çarpıcı. Ham $q_c$ (MPa) ve $R_f$ ile ARI 0,694'e düşüyor: sıkı kumdaki geniş $q_c$ aralığı uzaklıkları domine ediyor. $\log_{10} q_c$ ve $R_f$'yi standartlaştırmadan kullanınca ARI 0,753. Bu kez $R_f$'nin standart sapması (2,03), $\log_{10} q_c$'ninkinin (0,53) yaklaşık dört katı olduğu için $R_f$ ağır basıyor. İki özelliği standartlaştırınca 0,948'e çıkıyor. Ölçek seçimi, aslında hangi farkın önemli olduğuna dair bir karardır. Standartlaştırma bu kararı “iki özellik eşit ağırlıkta” diye verir.
$k$ seçimi daha az net. Dirsek grafiğinde inertia $k$ = 1'den 4'e 2002,0 → 426,6 → 271,4 → 127,4 diye hızla düşüyor, sonra 90,0, 75,6, 65,0 diye yavaşlıyor. Dirsek $k$ = 4'te. Siluet ölçütü ise $k$ = 2'yi seçiyor (0,701); $k$ = 5 (0,685) ve $k$ = 4 (0,677) biraz geride. $k$ = 2'de k-means, killeri kumlardan ayırıyor. Bu da yanlış sayılmaz: verideki en büyük ayrım budur. Siluet ölçütü en belirgin ayrımı ödüllendirir; her zaman bizim aradığımız ayrıntı düzeyini değil. Küme sayısı, sonuçta problemin amacına ve mühendislik yargısına bağlı bir karardır.
8. Sonuçlar: Gauss karışımı, BIC ve DBSCAN
Dört bileşenli, tam kovaryanslı Gauss karışımının ARI'si 0,934, yani k-means'ten (0,948) biraz düşük. Daha esnek model daha iyi sonuç vermedi. Şekil 1'deki elipsler nedenini gösteriyor. Siltli kum bileşeni, yüksek $q_c$'li sıçramaları da açıklamaya çalışırken $q_c$ yönünde uzamış ve sıkı kumun bölgesine taşmış. Esneklik, aykırı okumaları da “modellemeye” izin verir.
Belirsiz okumalar bu taşmanın olduğu yerde toplanıyor. En büyük olasılığı 0,9'un altında kalan 28 okumanın 21'i sıkı kumda (13,84–17,84 m), 6'sı siltli kumda (6,52–8,46 m), biri yumuşak kilde (4,54 m). Yumuşak kildeki tek okuma dışında hepsi Şekil 1'deki iki kum kümesinin arasındaki bölgede: siltli kumun en sıkı ve sıkı kumun en gevşek okumaları birbirine benziyor. Bu belirsizliğin mühendislik karşılığı açık: bu derinliklerdeki okumalar iki kum türünün arasında kalıyor ve hangi tabakaya ait oldukları ölçümden kesin olarak söylenemiyor. Sondaj kuyusuyla ayrıca bakılması gereken yerler bunlardır.
EM'in durma ölçütünü kontrol edin
scikit-learn'deki GaussianMixture, varsayılan olarak tol=1e-3 ile çalışır: ortalama log-olabilirlikteki artış bu değerin altına inince durur. Bu veride varsayılan tol EM'i 3 iterasyonda durdurdu; toplam log-olabilirlik −984,45'te kaldı. tol=1e-6 ile 23 iterasyonda −930,68'e ulaştı. Yarım kalan modelin ARI'si (0,953) tesadüfen daha yüksek çıktı. Ama karşılaştırmalar, özellikle BIC, yakınsamış modellerle yapılmalıdır. Yakınsamayı her zaman n_iter_ ve converged_ ile kontrol edin.
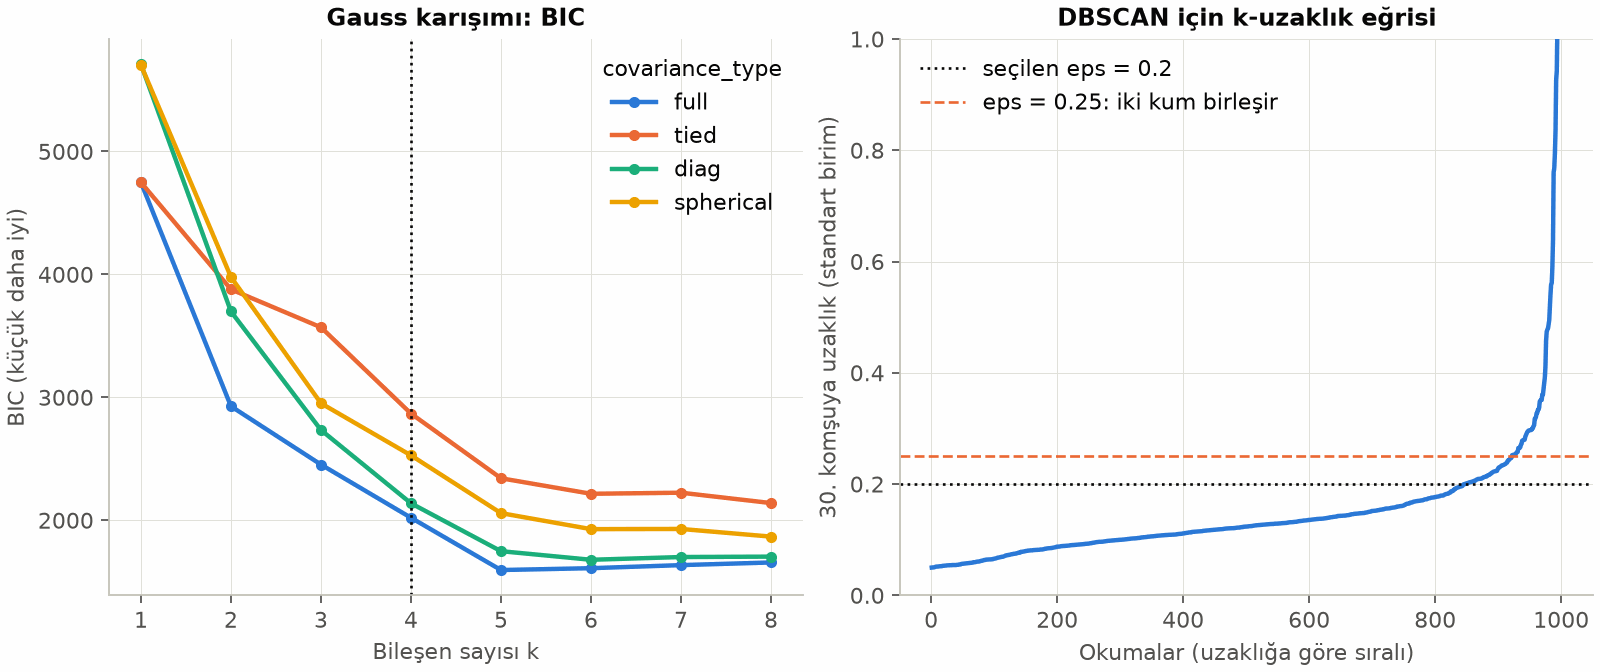
BIC'in seçimleri öğretici. Tam kovaryansta en küçük BIC $k$ = 5'te (1595); diag 6 bileşen seçiyor. tied ve spherical'da ise BIC, denenen en büyük değer olan 8'de hâlâ azalıyor (2224 → 2140 ve 1929 → 1867); bu türler daha fazla bileşen istiyor. Beş bileşenli modelin bileşenleri yaklaşık 308, 227, 224, 222 ve 20 okumalık. Büyüklüklerinden ve ARI'den anlaşıldığı gibi dört büyük bileşen dört tabakaya karşılık geliyor. Beşincisine atanan 18 okumanın 13'ü sıçrama, 6'sı bir tabaka sınırına 20 cm'den yakın (biri ikisi birden). BIC, sıçramalar için ayrı ve geniş bir “çöp” bileşeni eklemeyi kârlı bulmuş. Bu bileşenle ARI 0,957'ye çıkıyor. Ama BIC'in cevapladığı soru “veriyi en iyi hangi karışım temsil eder?” sorusudur, “kaç tabaka var?” değil. Esnekliği kısıtlı türler (tied, spherical), farklı biçimli ve uzamış kümeleri birkaç benzer elipsle ya da daireyle döşemek zorunda kaldığı için daha çok bileşen istiyor. Bir neden daha var: komşu okumalar derinlikte ilişkili, yani 1001 okuma 1001 bağımsız gözlem değil. Olabilirlik terimi her okumayı bağımsız bir kanıt sayıp $n$ ile büyürken ceza yalnızca $\ln n$ ile büyür. Üreticide komşu iki okuma arasındaki korelasyon $\varphi$ = 0,875; böyle bir dizide ortalama tahmini için etkin örnek sayısı yaklaşık $n(1-\varphi)/(1+\varphi) \approx 67$'dir. İlişkili okumalarda gerçek bilgi çok daha az olduğu için ek bileşenlerin kazancı olduğundan büyük görünür ve karmaşıklık yeterince cezalandırılmaz.
DBSCAN için min_samples = 30 seçtik; bu, yoğun bir bölgenin en az 30 okuma, yani yaklaşık 60 cm'lik bir tabaka parçası içermesini istemek demektir. 30. komşuya uzaklık eğrisinin (nokta kendisi dahil) medyanı 0,124. Eğri %90'lık dilimde 0,230'a, %95'lik dilimde 0,297'ye çıkıyor ve sonrasında dikleşiyor. Diz noktasının hemen altında eps = 0,20 seçtik. Sonuç: 4 küme ve 41 gürültü okuması. 14 sıçramanın 14'ü de gürültü olarak işaretlendi. Kalan 27 gürültü okuması, kümelerin seyrek kenarlarındaki ve geçişlerdeki okumalar. Gürültü dışarıda bırakılınca ARI 0,967. Ama bu değer en zor 41 okuma atılarak hesaplandığı için diğer ARI'lerle doğrudan karşılaştırılamaz; gürültü ayrı bir küme sayılırsa 0,916. DBSCAN'in zayıf yanı da görünüyor: eps = 0,25'te iki kum tabakası seyrek ara okumalar üzerinden birbirine bağlanıyor ve 3 küme kalıyor. Küçük bir parametre değişikliği, bir tabakayı haritadan siliyor.
9. Kümeleri derinliğe geri taşımak
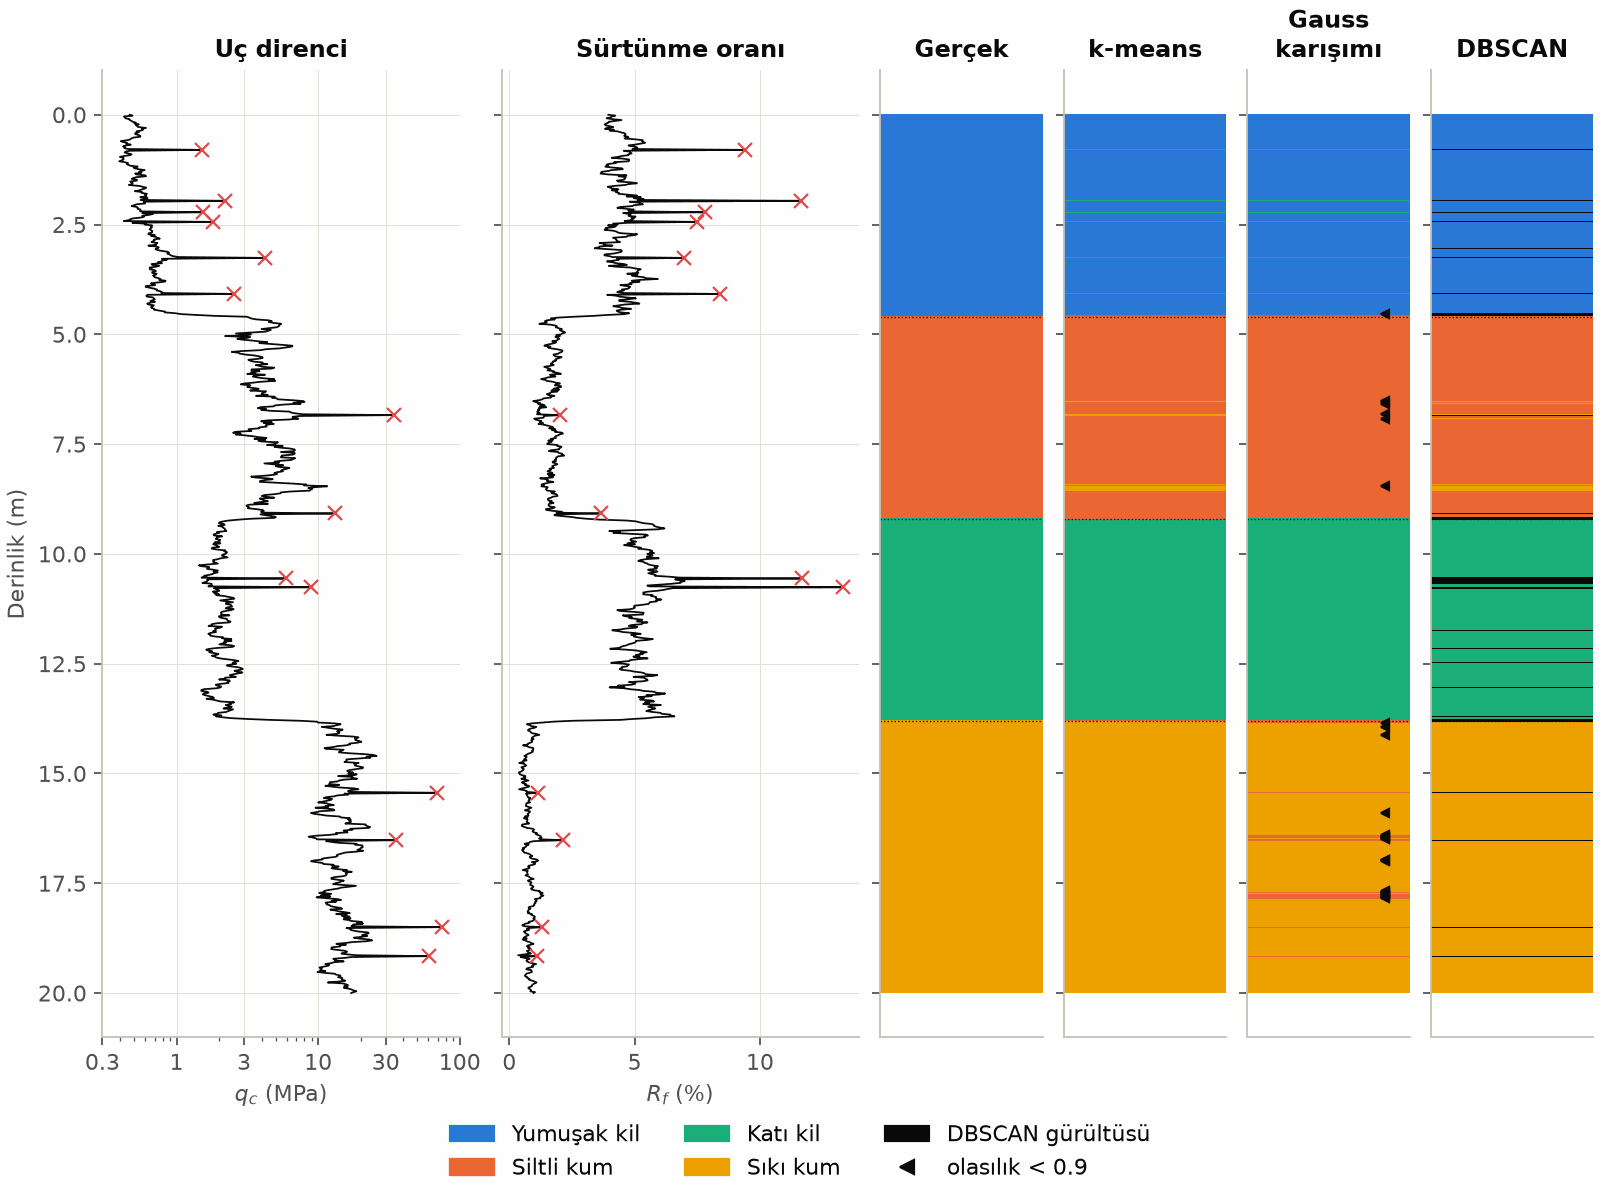
Kümeleme sırasında derinlik hiç kullanılmadı; algoritmalar yalnızca $(\log_{10} q_c, R_f)$ çiftlerini gördü. Buna rağmen her yöntem dört ana bandı doğru derinliklerde buluyor. Sınırlar 4,6, 9,2 ve 13,8 m'de keskin biçimde ortaya çıkıyor. Hatalar iki türde. Tek okumalık sıçramalar k-means ve Gauss karışımında başka bir tabakanın rengini alıyor; yumuşak kil içindeki yeşil çizgiler bunlar. Ayrıca k-means'te siltli kumun en yüksek $q_c$'li okumalarından 11'i (biri sıçrama) sıkı kum rengine boyanıyor. Gauss karışımında hata ters yönde: sıkı kumdan 17 okuma siltli kum rengine geçiyor. Bunların 4'ü sıçrama (sıkı kumdaki sıçramaların hepsi); geri kalanı düşük $q_c$'li ve yüksek $R_f$'li, yani siltli kuma benzeyen okumalar. DBSCAN sıçramaları gürültüye ayırıyor ama katı kilin seyrek kenarlarını da gürültü sayıyor.
Bütün okumalar üzerinden gerçek tabakalarla ARI'ler: k-means 0,948, Gauss karışımı 0,934, DBSCAN (gürültü ayrı küme sayılarak) 0,916, Ward bağlantılı hiyerarşik kümeleme 0,911. DBSCAN'in gürültü hariç 0,967'si, atılan 41 okuma yüzünden bu sıralamaya girmez. Bu sentetik sondajda dört yöntem de tabakaları büyük ölçüde geri kazanıyor. Asıl farkı ayrıntılar yapıyor: belirsiz okumaları işaretlemek (Gauss karışımı) ve aykırı okumaları ayıklamak (DBSCAN). Gerçek sondajlarda tabakalar bu kadar belirgin olmayabilir ve aynı zemin türü farklı derinliklerde tekrar edebilir. Derinlik sürekliliğini kullanmak, kümelemeden sonra yapılacak ayrı bir adımdır (Alıştırma 2).
10. Sık yapılan hatalar
- Ölçeklemeden kümelemek. Uzaklığa dayalı her yöntem ölçeğe duyarlıdır. Ham $q_c$ ile ARI 0,948'den 0,694'e düştü. Anlamlı bir dönüşüm (burada logaritma) ve standartlaştırma çoğu zaman şarttır.
- k-means'i tek bir başlatmayla çalıştırmak. Bu veride rastgele başlatmaların 50'de 27'si yerel minimumda kaldı. scikit-learn'ün varsayılanı (
n_init='auto') tek bir k-means++ başlatmasıdır;n_initdeğerini birden büyük verin ve inertiayı karşılaştırın. - Küme sayısını tek bir ölçüte bırakmak. Dirsek 4, siluet 2, BIC 5 dedi. Ölçütler farklı sorular sorar; problem bilgisiyle birlikte okunmalıdır.
- Küme numaralarını etiket sanmak. “Küme 0” hiçbir şey ifade etmez. Kümeleri karşılaştırmak için ARI gibi numaralandırmadan bağımsız ölçütler kullanın; anlamı, mühendis kümelerin özelliklerine bakarak verir.
- EM'in yakınsadığını varsaymak. Varsayılan
tol, bu veride EM'i 3 iterasyonda durdurdu.n_iter_veconverged_değerlerine bakın. - Kümelemeyi sınıflandırma yerine koymak. Kümeleme keşif aracıdır. Zemin sınıfı, abaklar ve kuyu verileriyle doğrulanmadan tasarıma girmemelidir.
11. Alıştırmalar
Alıştırma 1KolayÜç küme seçseydik
k-means'i $k$ = 3 ve $k$ = 2 ile çalıştırın ve küme etiketlerini gerçek tabakalarla çapraz tabloya dökün (pd.crosstab). Hangi tabakalar birleşiyor? ARI kaç olur?
Çözümü göster
$k$ = 3'te iki kil tabakası birleşiyor: yumuşak kilin 230 okumasının hepsi ve katı kilin 229 okuması aynı kümede. Kumlar ayrı kalıyor; yalnız siltli kumun 11 okuması sıkı kum kümesine gidiyor. ARI 0,725. $k$ = 2'de ayrım kil–kum ayrımıdır: katı kilin tek bir okuması dışında iki kil bir kümede, iki kum diğerinde; ARI 0,502. Siluet ölçütünün $k$ = 2'yi seçmesinin nedeni de budur: verideki en büyük ayrım kil ile kum arasındadır. Daha ince ayrımlar ($k$ = 4) ancak problem bilgisiyle savunulabilir.
Alıştırma 2OrtaDerinlik sürekliliğiyle temizleme
k-means etiketlerine derinlik boyunca bir çoğunluk filtresi uygulayın: her okumanın etiketini, kendisinin ve üstündeki ve altındaki $h$ okumanın en sık etiketiyle değiştirin. $h$ = 5, 10 ve 25 için ARI'yi ve değişen etiket sayısını bulun. Bu filtrenin mühendislik açısından riski nedir?
Çözümü göster
def cogunluk(etiket, h=10):
    sonuc = etiket.copy()
    for i in range(len(etiket)):
        pencere = etiket[max(0, i - h): i + h + 1]
        sonuc[i] = np.bincount(pencere).argmax()
    return sonuc
$h$ = 5 (±10 cm) ile ARI 0,948'den 0,978'e çıkıyor ve 14 etiket değişiyor. $h$ = 10 (±20 cm) ile ARI 0,998, 19 etiket değişiyor. $h$ = 25 (±50 cm) ile 0,995. Filtre, tek okumalık sıçramaları ve kısa sapmaları komşularının etiketine çeviriyor. Risk, ince ama gerçek tabakaların da silinmesidir. Örneğin kum içindeki 10 cm'lik yumuşak bir kil bandı, şev stabilitesi ya da sıvılaşma açısından belirleyici olabilir. Pencere, aranan en ince tabakadan dar seçilmeli ve filtrelenen her değişiklik ham profille karşılaştırılmalıdır.
Alıştırma 3OrtaDerinliği özellik olarak eklemek
Standartlaştırılmış derinliği üçüncü bir özellik olarak ekleyip k-means'i ($k$ = 4) yeniden çalıştırın. Derinlik sütununu 0,5 ile çarpıp tekrarlayın. ARI nasıl değişir? Bu yaklaşımın hangi durumda yanıltıcı olacağını açıklayın.
Çözümü göster
Derinlik tam ağırlıkla eklenince ARI 0,948'den 0,988'e, 0,5 ağırlıkla 0,972'ye çıkıyor. Derinlik, birbirine yakın okumaları aynı kümeye çektiği için sıçramalar ve geçişler komşularının kümesine kayıyor. Ama bu, tabakaların derinlikte sürekli ve yatay olduğunu modele baştan söylemek demektir. Aynı zemin türü iki farklı derinlikte tekrar ederse (örneğin iki ayrı kil tabakası) derinlik onları farklı kümelere zorlar. Kalın ve homojen bir tabaka ise derinlik ekseni boyunca dilimlere bölünebilir. Sonuç, keyfi seçilen ağırlığa da bağlıdır. Daha güvenli yol, kümelemeyi zemin özellikleriyle yapıp derinlik bağlamını sonradan kullanmaktır (Alıştırma 2).
Alıştırma 4OrtaDBSCAN parametre duyarlılığı
DBSCAN'i min_samples = 10 ve 30, eps = 0,15; 0,20; 0,25 ve 0,30 ile çalıştırın. Küme sayısını, gürültü sayısını, yakalanan sıçrama sayısını ve gürültü hariç ARI'yi tablo hâlinde karşılaştırın.
Çözümü göster
| min_samples | eps | Küme | Gürültü | Sıçrama | ARI |
|---|---|---|---|---|---|
| 10 | 0,15 | 4 | 31 | 14 | 0,670 |
| 10 | 0,20 | 3 | 22 | 14 | 0,678 |
| 10 | 0,25 | 3 | 18 | 14 | 0,677 |
| 10 | 0,30 | 3 | 15 | 13 | 0,674 |
| 30 | 0,15 | 4 | 109 | 14 | 0,997 |
| 30 | 0,20 | 4 | 41 | 14 | 0,967 |
| 30 | 0,25 | 3 | 28 | 14 | 0,675 |
| 30 | 0,30 | 3 | 19 | 14 | 0,678 |
Sıçramaları yakalamak kolay: hemen her ayar 14 sıçramanın 13 ya da 14'ünü gürültü sayıyor. Kümeleri doğru ayırmak ise zor. min_samples = 10 ile iki kum tabakası seyrek ara okumalar üzerinden her eps değerinde birleşiyor. eps = 0,15'teki “4 küme” bile yanıltıcı: kumlar birleşmiş, dördüncü küme ise katı kildeki 5 okumalık yüksek $R_f$'li bir grup. min_samples = 30 köprüleri koparıyor. eps = 0,15 en yüksek ARI'yi (0,997) veriyor ama 109 okumayı, yani verinin %11'ini gürültüye atıyor. Seçtiğimiz 0,20, ARI ile atılan veri arasında bir uzlaşmadır. Küme sayısının tek başına başarı ölçütü olmadığını bu tablo açıkça gösteriyor.
Alıştırma 5ZorEM algoritmasını sıfırdan yazın
Tam kovaryanslı Gauss karışımı için EM'i NumPy ve SciPy ile yazın. Başlangıç değerlerini k-means'ten alın ($\pi_k$: küme oranları, $\vect\mu_k$: merkezler, $\Sigma_k$: küme kovaryansları). Log-olabilirlik artışı $10^{-10}$'un altına inene kadar iterasyon yapın. Sonucu scikit-learn'ün tol=1e-6 ile kurduğu modelle karşılaştırın; log-olabilirliğin her turda artığını da denetleyin.
Çözümü göster
def em(X, k, en_cok=500, tol=1e-10):
    km = KMeans(k, n_init=10, random_state=42).fit(X)
    pi = np.bincount(km.labels_, minlength=k) / len(X)
    mu = km.cluster_centers_.copy()
    Sig = np.array([np.cov(X[km.labels_ == j].T) for j in range(k)])
    ll_eski = -np.inf
    for it in range(en_cok):
        p = np.column_stack([pi[j] * multivariate_normal(mu[j], Sig[j]).pdf(X) for j in range(k)])
        ll = np.log(p.sum(axis=1)).sum()                 # log-olabilirlik
        g = p / p.sum(axis=1, keepdims=True)            # E-adımı: sorumluluklar
        Nk = g.sum(axis=0)                              # M-adımı
        pi, mu = Nk / len(X), (g.T @ X) / Nk[:, None]
        Sig = np.array([(g[:, j, None] * (X - mu[j])).T @ (X - mu[j]) / Nk[j] for j in range(k)])
        assert ll >= ll_eski - 1e-8                     # EM log-olabilirliği azaltmaz
        if ll - ll_eski < tol:
            break
        ll_eski = ll
    return pi, mu, Sig, ll, it + 1
Bu uygulama 42 iterasyonda −930,679 log-olabilirliğe ulaşıyor. scikit-learn'ün modeli (tol=1e-6) 23 iterasyonda aynı değeri veriyor. İki modelin atamaları arasındaki ARI 1,0, bileşen ortalamaları arasındaki en büyük fark ise $3\times10^{-4}$'ün altında (standart birimde); bu fark yalnızca durma ölçütlerinin farklı olmasından geliyor. Pratikte dikkat edilecek iki nokta: bir bileşen tek bir noktaya çökerse $\Sigma_k$ tekilleşir ve olabilirlik sonsuza gider. scikit-learn bunu önlemek için kovaryansın köşegenine küçük bir reg_covar ekler. Büyük boyutlarda ise yoğunluklar çok küçük çıkabileceği için hesap log-uzayında yapılır.
Özet
- k-means küme içi kareler toplamını küçültür. Lloyd algoritması atama ve güncelleme adımlarıyla bu toplamı monoton azaltır ama yerel minimumda durabilir; k-means++ ve birden çok başlatma bu riski azaltır.
- Ölçek, uzaklığa dayalı her yöntemin sonucunu belirler: ARI, ham birimlerde 0,694, standartlaştırılmış log ölçekte 0,948 çıktı.
- Gauss karışımı EM ile kurulur ve yumuşak atama verir; belirsiz okumalar mühendisin bakması gereken yerleri gösterir. BIC bir yoğunluk modeli seçer, tabaka sayısını değil.
- DBSCAN küme sayısı istemez ve aykırı okumaları gürültü olarak ayıklar; 14 sıçramanın 14'ünü yakaladı. Ama
epsvemin_samplesseçimine çok duyarlıdır. - Kümeleme keşif aracıdır; zemin sınıflandırmasında CPT abaklarının ve sondaj verilerinin yerine geçmez.
Sonraki derste denetimsiz öğrenmenin ikinci büyük konusuna geçiyoruz: boyut indirgeme. Temel bileşenler analizi ile bir kirişin titreşim ölçümlerinden mod şekillerini geri kazanacağız (Ders 10).
Kaynaklar
- C. M. Bishop — Pattern Recognition and Machine Learning, Bölüm 9 (k-means, Gauss karışımları ve EM).
- D. Arthur, S. Vassilvitskii (2007), “k-means++: The advantages of careful seeding”, Proceedings of the 18th ACM-SIAM Symposium on Discrete Algorithms (SODA).
- M. Ester, H.-P. Kriegel, J. Sander, X. Xu (1996), “A density-based algorithm for discovering clusters in large spatial databases with noise”, KDD-96.
- P. K. Robertson (1990), “Soil classification using the cone penetration test”, Canadian Geotechnical Journal 27(1).
- scikit-learn — Clustering ve Gaussian mixture models belgeleri.