Bu derste öğrenecekleriniz
- NumPy dizisi oluşturmak;
dtype,shapevereshapeile çalışmak - Dilimleme, boolean maske ve indeks dizileriyle veri seçmek; görünüm ile kopyayı ayırt etmek
- Döngüyü vektörleştirmek ve yayınlama kurallarını uygulamak
(n,)ile(n, 1)şekil hatasını tanımak veassertile yakalamak- pandas ile tabloyu incelemek, eksik değeri doldurmak, gruplamak ve NumPy'a aktarmak
- Matplotlib ile birimli, lejantlı grafik çizip dosyaya kaydetmek
1. Neden NumPy?
Makine öğrenmesinde veri neredeyse her zaman bir sayı tablosudur. Her satır bir gözlemdir: bir beton küpü, bir çekme numunesi, bir sensör kaydı. Her sütun bir özelliktir: su miktarı, numune yaşı, sıcaklık. Modeli eğitmek de, değerlendirmek de bu tablolar üzerinde binlerce kez tekrarlanan aritmetik işlemlerden oluşur.
Python listeleri esnektir ama sayısal iş için yavaştır. Listedeki her sayı ayrı bir Python nesnesidir ve bir döngünün her adımında yorumlayıcı “bu nesnenin tipi ne, toplama nasıl yapılır” sorularını yeniden sorar. NumPy ise aynı tipteki sayıları bellekte tek, kesintisiz bir blok olarak tutar ve işlemi bütün blok üzerinde derlenmiş (C ile yazılmış) kodla yapar. Bu yaklaşıma vektörleştirme (vectorization) denir. scikit-learn, pandas ve SciPy NumPy dizileriyle çalışır; PyTorch'un tensörleri de aynı mantığı izler.
Bu ders kursun geri kalanında gerçekten kullanacağımız araçları kapsar: dizi ve şekil, indeksleme ve maske, vektörleştirme, yayınlama (broadcasting) ve onun yol açtığı sessiz hata, eksen boyunca işlemler, rastgelelik, doğrusal sistem çözümü, pandas ile tablo ve Matplotlib ile grafik. Metindeki sayılar h1_python_numpy.py betiğinin çıktısından alındı; kısa kod parçalarının yanındaki yorumlar da o satırların gerçek sonuçlarıdır (kodun tamamı 9. bölümde).
Örnek veriler sentetiktir. Altı küp numunesinin değerlerini Abrams yasasına yakın düşecek biçimde elle yazdık. 200.000 düzlem gerilme durumu ve 300 satırlık beton tablosu sabit tohumlu rastgele sayılarla üretildi; tablo, kursun ortak beton_verisi fonksiyonundan geliyor ve Ders 01 ile Ders 04'te yeniden karşımıza çıkacak. Hiçbiri gerçek deney kaydı değildir.
NumPy'ı biliyorsanız
Doğrudan 5. bölüme geçin. Oradaki (n,) − (n, 1) hatası hata mesajı vermez, yanlış bir sayı üretir ve deneyimli kullanıcıları da yakalar.
2. Diziler: oluşturma, veri tipi ve şekil
Bir NumPy dizisi (ndarray) üç bilgiyle tanımlanır: elemanların veri tipi (dtype), her boyuttaki eleman sayısını veren şekil (shape) ve boyut sayısı (ndim). Altı küpün basınç dayanımını bir listeden diziye çevirelim:
f = np.array([32.4, 41.0, 23.6, 47.1, 38.1, 33.2])   # altı küpün basınç dayanımı (MPa)
f.dtype, f.shape, f.ndim                              # float64, (6,), 1
Diziyi elle yazmak yerine çoğu zaman bir kuralla üretiriz:
np.arange(0, 10, 2)        # [0 2 4 6 8]          — bitiş değeri dahil değil
np.linspace(0, 1, 5)       # [0. 0.25 0.5 0.75 1.] — iki uç dahil, 5 eşit aralıklı nokta
np.zeros((2, 3))           # 2×3 sıfır matrisi (float64)
np.ones(4)                 # [1. 1. 1. 1.]
np.full(3, 28)             # [28 28 28]
Makine öğrenmesinin şekil sözleşmesi
Kursun tamamında aynı düzeni kullanacağız: özellik matrisi X'in her satırı bir örnek, her sütunu bir özelliktir; hedef y ise her örnek için tek bir sayı içeren tek boyutlu bir dizidir. scikit-learn bu düzeni bekler.
| Nesne | Şekil | Anlamı |
|---|---|---|
X | (n, p) | özellik matrisi: satır = örnek, sütun = özellik |
y | (n,) | hedef vektörü |
w | (p,) | doğrusal modelin ağırlıkları |
X @ w | (n,) | bütün örnekler için tahmin |
y.reshape(-1, 1) | (n, 1) | sütun vektörü: çoğu zaman istemediğiniz şey (5. bölüm) |
Altı küp için iki özellik (su/bağlayıcı oranı ve yaş) seçip X'i sütunları yan yana koyarak kuruyoruz:
sb = np.array([0.55, 0.45, 0.60, 0.40, 0.48, 0.50])   # su/bağlayıcı oranı
yas = np.array([28, 28, 7, 56, 28, 14])               # yaş (gün), tam sayı dizisi
X = np.column_stack([sb, yas])                        # (6, 2)
y = f                                                 # (6,)
Çıktıda X.shape = (6, 2) ve y.shape = (6,) görüyoruz. Bir ayrıntıya dikkat edin: yas tam sayı dizisiydi, ama çıktıda X[:, 1] sütunu [28. 28. 7. 56. 28. 14.] diye ondalıklı yazılıyor. Bir dizinin bütün elemanları aynı tipte olmak zorundadır; column_stack ortak tip olarak float64'ü seçti.
reshape veriyi değiştirmeden şekli değiştirir. -1 “bu boyutu sen hesapla” demektir: f.reshape(-1, 1) altı satırlı tek bir sütun, yani (6, 1) verir. scikit-learn tek özellikli bir problemde bile iki boyutlu X beklediği için bu kalıbı sık göreceksiniz (Ders 02'de eps.reshape(-1, 1)).
Tam sayı dizisi ondalığı sessizce keser
yas dizisinin tipi int64'tür. Betikte bir kopyasına yas2[0] = 7.9 yazdığımızda değer 7 olarak saklandı; uyarı da gelmedi. Ondalık değer saklayacağınız bir diziyi baştan float oluşturun ya da yas.astype(float) ile çevirin.
3. İndeksleme, dilimleme ve maskeler
İndeksler sıfırdan başlar; negatif indeks sondan sayar. Dilim bas:son biçimindedir ve son dahil değildir. İki boyutlu dizide virgülle ayrılmış iki indeks kullanılır: X[i, j] tek eleman, X[i] bir satır (örnek), X[:, j] bir sütun (özellik). Çıktıda f[0] = 32.4, f[-1] = 33.2 ve f[1:4] = [41. 23.6 47.1] görüyoruz; son dilim 1, 2 ve 3 numaralı elemanları içeriyor.
Boolean maskeler
Bir karşılaştırma, her eleman için True/False içeren aynı şekilde bir dizi üretir. Bu diziyi indeks olarak kullanınca yalnız True olan elemanlar seçilir. “Dayanımı 35 MPa'yı aşan küpler” sorusu tek satırdır:
maske = f > 35                          # [False  True False  True  True False]
f[maske]                                # [41.  47.1 38.1]
maske.sum()                             # 3  (True = 1 sayılır)
iki_kosul = (f > 35) & (yas == 28)      # 've' için &, 'veya' için |, 'değil' için ~
f[iki_kosul]                            # [41.  38.1]
sb[iki_kosul].mean()                    # 0.465
Koşulları birleştirirken iki kurala uyun. Birincisi, Python'un and/or sözcükleri tek bir doğruluk değeri bekler; diziyle kullanılınca “truth value of an array is ambiguous” hatası verir. Bunların yerine &, | ve ~ kullanılır. İkincisi, bu işleçler karşılaştırmadan önce işlenir. Parantezleri unutursanız Python f > 35 & yas == 28 ifadesini f > (35 & yas) == 28 diye, yani zincirleme bir karşılaştırma olarak okur ve aynı “truth value … ambiguous” hatasını verir.
İndeks dizileri
Bir tam sayı dizisini indeks olarak verirseniz elemanlar o sırayla seçilir (fancy indexing). np.argsort küçükten büyüğe sıralayan indeksleri döndürür; tersine çevirip ilk üçünü alınca en yüksek üç dayanımın yeri bulunur: çıktıda [3 1 4] indeksleri ve [47.1 41. 38.1] MPa. Aynı teknikle veriyi karıştırırız: rng.permutation(n) rastgele sıralı indeksler verir; ilk yüzde 75'i eğitim, kalanı test için kullanmak bir veri ayrımıdır (Ders 01).
Dilim bir görünümdür, kopya değil
dilim = f[1:4] yeni bir dizi oluşturmaz; aynı belleğe bakan bir görünümdür (view). Betikte dilim[0] = 0 yazdığımızda asıl dizide f[1] de 0,0 oldu. Maske ve indeks dizisiyle yapılan seçimler ise kopya döndürür. Bağımsız bir kopya istiyorsanız açıkça f[1:4].copy() yazın. Benzer biçimde y = f de kopya oluşturmaz; aynı nesneye ikinci bir ad verir.
4. Vektörleştirme: döngü yerine dizi işlemleri
Bir sonlu eleman modelinin 200.000 integrasyon noktasında düzlem gerilme bileşenlerinin ($\sigma_x$, $\sigma_y$, $\tau_{xy}$) elimizde olduğunu düşünelim. Değerler sentetiktir: her bileşen sıfır ortalamalı normal dağılımdan, 90, 60 ve 40 MPa standart sapmayla üretildi. Her noktada von Mises eşdeğer gerilmesini hesaplamak istiyoruz:
$$ \sigma_{vm} = \sqrt{\sigma_x^2 - \sigma_x\sigma_y + \sigma_y^2 + 3\,\tau_{xy}^2} $$Aynı formülü iki biçimde yazdık. İlki her satırı Python döngüsüyle tek tek işler, ikincisi sütunlar üzerinde tek seferde çalışır:
def von_mises_dongu(S):
    sonuc = np.empty(len(S))
    for i in range(len(S)):
        sx, sy, txy = S[i]
        sonuc[i] = math.sqrt(sx * sx - sx * sy + sy * sy + 3 * txy * txy)
    return sonuc

def von_mises_vektor(S):
    sx, sy, txy = S[:, 0], S[:, 1], S[:, 2]
    return np.sqrt(sx**2 - sx * sy + sy**2 + 3 * txy**2)
İki sonuç aynıdır (np.allclose → True). Fark hızdadır: çıktıdaki oran, bu çalıştırmada döngünün vektörleştirilmiş sürümden kabaca iki basamak (yüz kat mertebesinde) yavaş olduğunu gösteriyor. Oranın kendisi işlemciye, bilgisayarın o anki yüküne ve NumPy sürümüne bağlıdır; aynı bilgisayarda bile çalıştırmadan çalıştırmaya iki kat değişebilir. Mertebesi ise genellikle aynı kalır. Betik bu yüzden süre yerine yalnız oranı yazdırır.
Vektörleştirilmiş sonuç doğrudan maskeyle de kullanılabilir. S235 çeliğinin akma dayanımı olan 235 MPa'yı aşan nokta sayısı (vm > 235).sum() ile bulunur: 5879 nokta, yani yüzde 2,94. Koşula göre değer atamak için np.where(vm > 235, "akma", "elastik") kullanılır.
Neyi vektörleştirebiliriz?
Örnekler birbirinden bağımsız işleniyorsa (her satır için aynı formül) işlem vektörleştirilebilir. Bir adımın sonucu bir öncekine bağlıysa döngü kaçınılmazdır. Gradyan inişi buna iyi bir örnektir: adımlar sırayla atılır, ama her adımın içindeki gradyan bütün örnekler üzerinde tek seferde hesaplanır (Ders 02).
5. Yayınlama ve sessiz şekil hatası
Şekilleri farklı iki dizi arasında işlem yapılınca NumPy küçük olanı, kopyalamadan, büyüğün şekline “yayar”. Buna yayınlama (broadcasting) denir. Kurallar şunlardır:
- Şekiller sağdan (son boyuttan) başlayarak karşılaştırılır. Eksik boyutlar 1 sayılır.
- Karşılıklı iki boyut ya eşit olmalı ya da biri 1 olmalıdır. Aksi hâlde hata verilir.
- Boyutu 1 olan taraf, diğerinin boyutuna yayılır.
| İşlem | Sonuç şekli | Yorum |
|---|---|---|
(6, 2) − (2,) | (6, 2) | her satırdan aynı vektör çıkar: sütun ortalaması |
(6, 2) − (6, 1) | (6, 2) | her sütundan aynı vektör çıkar: satır ortalaması |
(5, 3) − (5,) | hata | sağdaki boyutlar 3 ve 5: uyumsuz |
(6,) − (6, 1) | (6, 6) | hata vermez ama neredeyse her zaman yanlıştır |
Yararlı kullanım: sütunları standartlaştırmak
Makine öğrenmesinde en sık yapılan işlemlerden biri, her özellikten ortalamasını çıkarıp standart sapmasına bölmektir:
$$ z_{ij} = \frac{x_{ij} - \bar x_j}{s_j} $$Döngüye gerek yoktur. X.mean(axis=0) şekli (2,) olan sütun ortalamalarını verir (çıktıda [0.497 26.833]); (6, 2) − (2,) işlemi bu vektörü her satırdan çıkarır:
Z = (X - X.mean(axis=0)) / X.std(axis=0)    # (6, 2) − (2,) → (6, 2)
Z.mean(axis=0), Z.std(axis=0)               # [0. 0.], [1. 1.]
Ders 02'de gradyan inişini hızlandıracak işlem budur. Gerçek bir projede ortalama ve standart sapma yalnız eğitim verisinden hesaplanır ve test verisine aynen uygulanır (Ders 01, veri sızıntısı).
Sessiz hata: (n,) − (n, 1)
Hedefi bir yerde (n,), başka bir yerde (n, 1) biçiminde tutmak çok kolaydır. pandas'ta df["dayanim_mpa"] tek boyutlu, df[["dayanim_mpa"]] iki boyutlu bir nesne verir. Bir modeli (n, 1) hedefle eğitirseniz tahmin de (n, 1) döner. Betikte tam olarak bunu yaptık: altı küpe [s/b, yaş, 1] sütunlarıyla bir doğru uydurduk, ama hedefi sütun vektörü olarak verdik.
y_sutun = f.reshape(-1, 1)                         # df[["dayanim_mpa"]].to_numpy() de böyle döner
A = np.column_stack([X, np.ones(len(f))])          # [s/b, yaş, 1]
w, *_ = np.linalg.lstsq(A, y_sutun, rcond=None)    # w.shape = (3, 1)
tahmin = A @ w                                     # (6, 1)
fark = f - tahmin                                  # (6,) − (6, 1) → (6, 6) !
np.mean(fark**2)                                   # 108.34  — yanlış
np.mean((f - tahmin[:, 0])**2)                     # 0.70    — doğru
Kurallara göre (6,) önce (1, 6) sayılır; (6, 1) ile karşılaşınca ikisi de (6, 6)'ya yayılır. Sonuç matrisinin [i, j] elemanı f[j] − tahmin[i]'dir, yani bir küpün ölçümünden başka bir küpün tahmini çıkarılır. Yalnız köşegendeki altı eleman anlamlıdır. Ortalama bütün 36 eleman üzerinden alındığı için MSE 0,70 MPa² yerine 108,34 MPa² çıkar. NumPy açısından ortada hata yoktur; hesap kurallara uygundur.
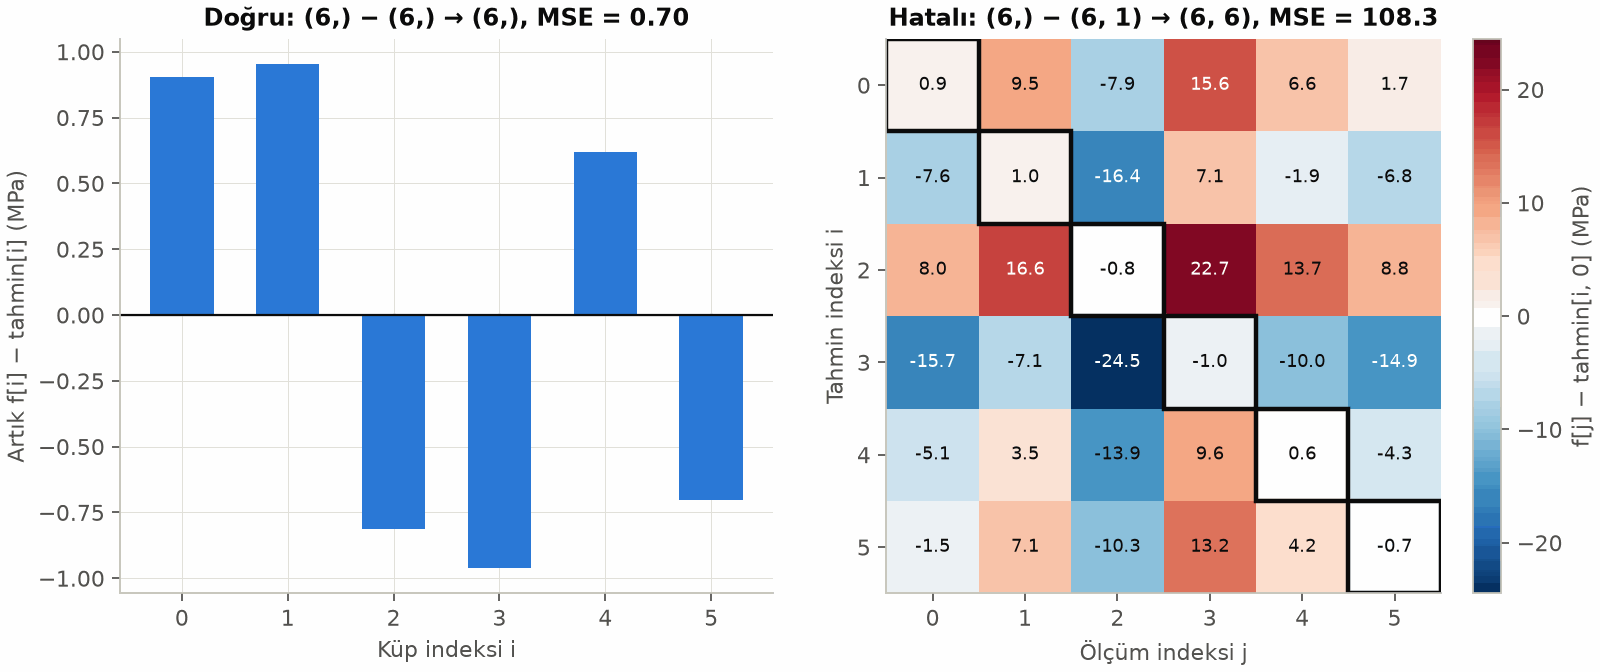
(6,) − (6, 1) işleminin ürettiği 6×6 matris. Çerçeveli köşegen soldaki artıkların aynısıdır; geri kalan 30 hücre farklı küplerin karşılaştırmasıdır ve MSE'yi 108,3 MPa²'ye şişirir.Çare, şekilleri kontrol etmeyi alışkanlık hâline getirmektir. Hata ölçen her fonksiyonun başına bir satır yetişir:
assert y.shape == tahmin.shape, f"şekiller farklı: {y.shape} ve {tahmin.shape}"Betikte bu satır hatayı “şekiller farklı: (6,) ve (6, 1)” mesajıyla yakaladı. Düzeltme için tahmini tahmin.ravel() ya da tahmin[:, 0] ile tek boyuta indirin; daha iyisi, hedefi baştan tek boyutlu tutun. Aynı tuzak PyTorch'ta da vardır: ağın çıktısı çoğunlukla (n, 1)'dir (Ders 12).
6. Eksenler, rastgelelik ve doğrusal sistemler
Eksen boyunca işlemler
sum, mean, std, max, argmax gibi özetleme işlemleri bir axis değeri alır. Kural kısadır: hangi ekseni verirseniz o boyut ortadan kalkar. Satırları karışım, sütunları yaş (7, 28 ve 56 gün) olan 3×3'lük bir dayanım tablosu D üzerinde:
D.mean(axis=0)satırları yok eder ve her sütun (yaş) için bir değer verir:[23.97 34.47 37.13]MPa.D.max(axis=1)sütunları yok eder ve her satır (karışım) için bir değer verir:[35.7 43.3 32.4]MPa.
Makine öğrenmesinde axis=0 “örnekler boyunca”, yani özellik başına bir istatistik demektir. Sonucu yayınlamada kullanacaksanız keepdims=True boyutu korur: X.mean(axis=1, keepdims=True) şekli (n, 1) olan bir sütun verir.
Standart sapmanın paydası: n mi, n − 1 mi?
np.std ve np.var varsayılan olarak $n$'ye böler (ddof=0); pandas'ın .std() ve .var() yöntemleri ise $n-1$'e (ddof=1). Aynı veriden iki farklı sayı görürseniz önce buna bakın. Farkın istatistiksel anlamı Hazırlık 2'de.
Rastgelelik ve tekrarlanabilirlik
Veri bölme, ağırlık başlatma, sentetik veri üretme gibi işlerin hepsi rastgele sayı kullanır. Bilgisayarın ürettiği sayılar aslında belirlenimlidir: aynı tohumla (seed) başlayan bir üreteç her seferinde aynı diziyi verir. Önerilen kullanım, bir Generator nesnesi oluşturup bütün çekilişleri ondan yapmaktır:
np.random.default_rng(42).normal(30.0, 4.0, 3)   # [31.219 25.84  33.002]
np.random.default_rng(42).normal(30.0, 4.0, 3)   # [31.219 25.84  33.002]  — aynı
np.random.default_rng(7).normal(30.0, 4.0, 3)    # [30.005 31.195 28.903]  — farklı tohum
Kurstaki her betik rng = np.random.default_rng(42) ile başlar; scikit-learn'de random_state=42, PyTorch'ta torch.manual_seed(42) kullanılır. Böylece sayfadaki sayıları siz de birebir elde edersiniz. Eski np.random.seed() arayüzü bütün programın paylaştığı tek bir gizli durumu değiştirir; yeni kodda kullanmayın. Aynı üreteçten çekilen sayıların, çekiliş sırasına bağlı olduğunu da unutmayın: betiğin başına yeni bir çekiliş eklemek sonraki bütün sayıları değiştirir.
Matris çarpımı ve doğrusal sistem
@ işleci matris çarpımıdır: (n, p) @ (p,) → (n,). X @ w doğrusal bir modeli bütün örneklere tek satırda uygular. Doğrusal denklem sistemi $K\vect u = \vect F$ ise np.linalg.solve(K, F) ile çözülür. Betikteki örnek, sol ucu ankastre, seri bağlı üç yaydır ($k_1 = 20$, $k_2 = 15$, $k_3 = 10$ kN/mm); serbest uca 6 kN etkiyor. Rijitlik matrisi:
Çözüm $\vect u = [0{,}3;\ 0{,}7;\ 1{,}3]$ mm çıkıyor. Elle kontrol: seri yaylarda her yay aynı 6 kN'u taşır, uç yer değiştirmesi $6/20 + 6/15 + 6/10 = 1{,}3$ mm'dir. Sistemi np.linalg.inv(K) @ F diye ters matrisle de çözebilirdik; ama bu hem daha pahalı hem de sayısal olarak daha az güvenilirdir. Nedenini koşul sayısıyla birlikte Hazırlık 2'de göreceğiz.
7. pandas ile tablo verisi
NumPy dizisinin sütunlarının adı yoktur ve bütün elemanları aynı tiptedir. Gerçek veri tablolarında ise sütunların adları, birimleri ve farklı tipleri vardır: sayılar, tarihler, “CEM I 42,5 R” gibi metinler. pandas'ın DataFrame nesnesi bu tablolar içindir; her sütunu bir Series'tir.
Betikte beton_verisi(300, …) ile 300 satırlık bir karışım tablosu üretip bir sütun ekledik: su/bağlayıcı oranı, yani suyun çimento, cüruf ve uçucu kül toplamına oranı. Sütunlar arası aritmetik de vektörleştirilmiştir:
df = beton_verisi(300, np.random.default_rng(42), eksik_oran=0.05)
df["su_baglayici"] = df["su"] / (df["cimento"] + df["curuf"] + df["ucucu_kul"])
df.shape                     # (300, 13)
df.head(3)                   # ilk üç satır
df.describe()                # sayısal sütunların özeti
Tabloda 13 sütun var: 10 tanesi float64, 2 tanesi int64 (yaş ve kalıp numarası), 1 tanesi metin (str). pandas 3'te metin sütunları varsayılan olarak str tipindedir; eski sürümlerde aynı sütunu object olarak görürsünüz. describe() çıktısına göre su/bağlayıcı oranı 0,22–0,77 arasında; dayanımın ortalaması 36,10 MPa, standart sapması 10,63 MPa, en küçük ve en büyük değerleri 14,67 ve 61,19 MPa.
Eksik değerler
Gerçek tablolarda boş hücre neredeyse kaçınılmazdır; pandas bunları NaN olarak tutar. Çoğu model NaN kabul etmez, bu yüzden önce saymak gerekir. df.isna().sum() her sütundaki eksik sayısını verir: süperakışkanlaştırıcı sütununda 17 satır boş. Bunları sütunun medyanıyla (3,81 kg/m³) doldurduk:
medyan = df["super_akiskan"].median()
df["super_akiskan"] = df["super_akiskan"].fillna(medyan)
Bu bir teknik karardır, doğal bir gerçek değil. Değer “ölçülmedi” diye mi eksik, yoksa “kullanılmadı, yani sıfır” diye mi? İkisi farklı doldurma ister. Bir makine öğrenmesi projesinde medyan da yalnız eğitim verisinden hesaplanmalıdır; bunu ileride scikit-learn'ün SimpleImputer'ı ile bir Pipeline içinde yapacağız.
pandas 3: zincirleme atama tabloyu değiştirmez
df["super_akiskan"][maske] = 0 gibi iki adımlı (zincirleme) bir atama, pandas 3'ün yazarken-kopyala (copy-on-write) kuralı yüzünden tabloyu değiştirmez ve bir ChainedAssignmentError uyarısı verir. Satır ve sütunu tek adımda seçin: df.loc[maske, "super_akiskan"] = 0.
Gruplama ve maskeler
groupby tabloyu bir sütunun değerlerine göre gruplara ayırır ve her gruba aynı özet işlemini uygular. Yaşa göre dayanım:
df.groupby("yas_gun")["dayanim_mpa"].agg(["count", "mean", "std"]).round(1)Çıktıdaki tabloda ortalama dayanım 3 günde 24,0 MPa'dan 28 günde 38,7 MPa'ya, 90 günde 47,5 MPa'ya çıkıyor. Her yaş grubunun içinde standart sapma 7,1 ile 8,4 MPa arasında; bu saçılmanın büyük kısmı karışımların farklı olmasından gelir. std sütununun pandas'ta $n-1$ paydasıyla hesaplandığını hatırlayın.
Maskeler pandas'ta da aynı biçimde çalışır: df[df["dayanim_mpa"] > 40] 106 satırlık bir alt tablo verir; bunların 38'i 28 günlük. Satır ve sütunu birlikte seçmek için df.loc[satır_koşulu, ["sütun1", "sütun2"]] kullanılır.
NumPy'a aktarma ve dosya
Modeller sonunda NumPy dizisiyle çalışır. to_numpy() bu köprüdür; köşeli parantez sayısı şekli belirler:
X_tablo = df[["cimento", "su", "yas_gun"]].to_numpy()   # (300, 3) float64 — çift köşeli parantez: tablo
y_tablo = df["dayanim_mpa"].to_numpy()                  # (300,)            — tek köşeli parantez: sütun
Tabloyu CSV'ye yazmak df.to_csv("tablo.csv", index=False), okumak pd.read_csv("tablo.csv") kadar kolaydır. Betik geride dosya bırakmamak için bellekte çalışan bir “dosya” (io.StringIO) kullanıyor. Sonuç öğreticidir: geri okunan tablo için df.equals(df2) False döndü, çünkü bazı ondalık sayılar son basamakta değişti (en büyük fark 2,3·10⁻¹³). np.allclose ise True döndü. Ondalık sayıları == ile değil, bir toleransla karşılaştırın. Birebir aynı sayılar gerekiyorsa pd.read_csv(..., float_precision="round_trip") kullanılabilir.
8. Matplotlib ile grafik
Matplotlib'in iki arayüzü vardır. Kursta nesne yönelimli olanı kullanıyoruz: önce bir şekil (fig) ve bir ya da birkaç eksen (ax) oluşturulur, sonra her çizim komutu bir eksene verilir. Birden çok panelli şekillerde neyin nereye çizildiği böylece hep açıktır.
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")   # 1 satır, 2 panel
ax[0].hist(df["dayanim_mpa"], bins=kutular, label="Tüm küpler")
ax[1].scatter(df["su_baglayici"], df["dayanim_mpa"], s=18, label="Küpler")
ax[1].set(xlabel="Su / bağlayıcı oranı (–)", ylabel="Basınç dayanımı (MPa)", title="...")
ax[1].legend()
fig.savefig("grafik.png", dpi=160)
plt.close(fig)
Her betiğin başındaki stil bloğu (RENK = [...] ile başlayan satırlar) kurs boyunca aynıdır. plt.rcParams ile yazı boyutlarını, ızgarayı ve renk sırasını bir kez ayarlar; böylece bütün derslerin grafikleri aynı görünür. matplotlib.use("Agg") satırı pencere açmadan doğrudan dosyaya çizer. VS Code'da grafikleri ekranda görmek isterseniz bu satırı kaldırın ve her fig.savefig(...) satırından sonra gelen plt.close(fig) çağrısını plt.show() ile değiştirin; betik her şekli kaydettikten sonra kapattığı için yalnız sona plt.show() eklemek yetmez. Uyduğumuz kurallar basittir: her eksenin birimli bir etiketi olur; birden çok seri varsa lejant eklenir; iki farklı ölçek aynı eksene sıkıştırılmaz, iki panele ayrılır.
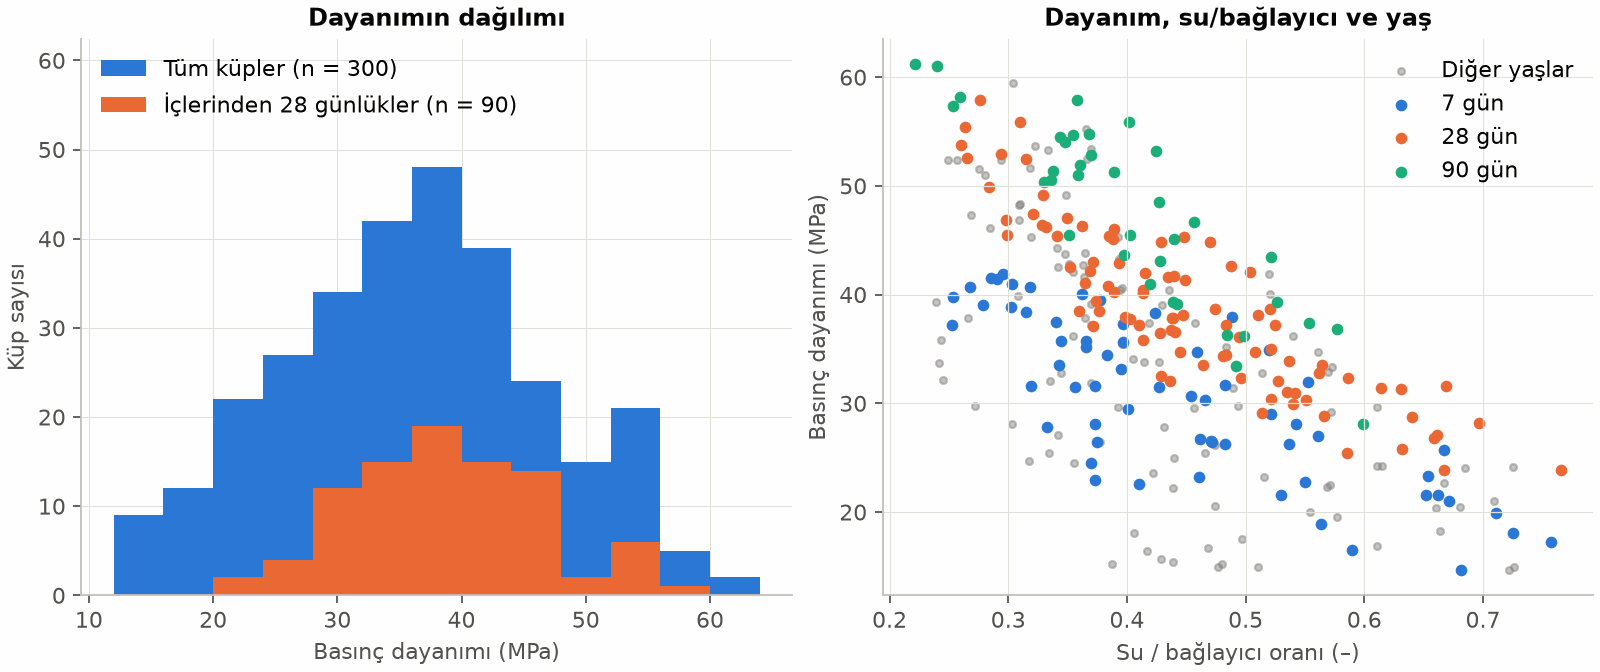
Sağ panel, makine öğrenmesinin neden işe yaradığını da gösteriyor. Dayanımı belirleyen bir ilişki var: su/bağlayıcı oranı arttıkça dayanım azalıyor, yaş arttıkça artıyor. Ama aynı orandaki noktalar arasında da saçılma var; çimento tipi, katkılar ve ölçüm saçılması bu farkı yaratıyor. Bir modelin işi, bu etkilerin hepsini aynı anda hesaba katmaktır. İlk modeli Ders 01'de bu tablonun bir benzeriyle kuracağız.
9. Çalıştırılabilir kod
Betik yedi bölümden oluşur ve bölümler bu sayfanın 2–8. bölümleriyle aynı sıradadır. # %% işaretleri, VS Code veya Spyder'da her bölümü ayrı bir hücre olarak çalıştırmanızı sağlar. Kurulum için Ders 01'deki adımları izleyin. Çıktıdaki hız oranı her çalıştırmada değişir (iki kata kadar); diğer bütün sayılar sabit tohum sayesinde aynı kalır.
"""Hazırlık 1 — Python, NumPy ve veriyle çalışmak.

Makine öğrenmesinde her gün kullanılan araçları küçük mühendislik örnekleriyle gösterir:
NumPy dizileri ve şekilleri, indeksleme ve maskeler, vektörleştirme, yayınlama (broadcasting)
ve tipik şekil hatası, eksen boyunca işlemler, rastgelelik, doğrusal sistem çözümü,
pandas ile tablo verisi ve Matplotlib ile grafik.

Veri sentetiktir. Altı küp numunesinin değerleri elle yazıldı (Abrams yasasına yakın, uydurma
sayılar). 200 000 düzlem gerilme durumu ve 300 satırlık beton tablosu sabit tohumlu rastgele
sayılarla üretilir; tablo, kursun ortak beton_verisi fonksiyonundan gelir. Gerçek deney kaydı değildir.

Çalıştır:  python h1_python_numpy.py
Gerekenler: numpy, pandas, matplotlib  (Python 3.12+)
Süre:      birkaç saniye
Çıktılar:  terminale sayılar, aynı klasöre iki PNG grafiği
"""
import io
import math
import time
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent


def beton_verisi(n, rng, eksik_oran=0.0):
    """Sentetik beton karışımı verisi (eğitim amaçlı; gerçek deney verisi değildir).

    Dayanım, Abrams yasası (f = 96,5 / 7^(s/b) MPa) ve EN 1992-1-1'deki yaş katsayısı
    β_cc(t) = exp(s·(1 − √(28/t))) ile üretilir; s/b oranında cüruf ve uçucu kül, EN 206'daki
    k-değeri kavramına benzer biçimde 0,6 ve 0,4 etkinlikle bağlayıcıya katılır.
    """
    cimento = rng.uniform(250, 500, n)                                   # kg/m³
    curuf = np.where(rng.random(n) < 0.4, rng.uniform(20, 200, n), 0.0)  # kg/m³
    ucucu_kul = np.where(rng.random(n) < 0.3, rng.uniform(20, 150, n), 0.0)
    su = rng.uniform(150, 210, n)                                        # kg/m³
    super_akiskan = np.where(rng.random(n) < 0.6, rng.uniform(2, 12, n), 0.0)
    iri_agrega = rng.uniform(850, 1100, n)
    ince_agrega = rng.uniform(650, 900, n)
    yas_gun = rng.choice([3, 7, 14, 28, 56, 90], n, p=[.12, .2, .13, .3, .13, .12])
    tipler = np.array(["CEM I 42,5 R", "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"])
    tip_no = rng.choice(3, n, p=[.45, .35, .20])
    s_katsayi = np.array([0.20, 0.25, 0.38])[tip_no]      # EN 1992-1-1, Bağıntı 3.2: R, N, S sınıfı
    sinif_carpani = np.array([1.00, 0.97, 0.88])[tip_no]  # varsayım: dayanım sınıfı etkisi
    kalip_no = rng.integers(1, 21, n)                    # ilgisiz özellik
    ortam_sicakligi = rng.uniform(5, 30, n)              # ilgisiz özellik (bu üreticide)

    sb = su / (cimento + 0.6 * curuf + 0.4 * ucucu_kul)  # su / etkin bağlayıcı
    f28 = 96.5 / 7.0 ** sb * sinif_carpani + 0.25 * super_akiskan
    beta = np.exp(s_katsayi * (1 - np.sqrt(28 / yas_gun)))
    dayanim = f28 * beta * rng.lognormal(0.0, 0.07, n)

    df = pd.DataFrame({
        "cimento": cimento, "curuf": curuf, "ucucu_kul": ucucu_kul, "su": su,
        "super_akiskan": super_akiskan, "iri_agrega": iri_agrega, "ince_agrega": ince_agrega,
        "yas_gun": yas_gun, "cimento_tipi": tipler[tip_no], "kalip_no": kalip_no,
        "ortam_sicakligi": ortam_sicakligi, "dayanim_mpa": dayanim,
    })
    if eksik_oran > 0:
        df.loc[rng.random(n) < eksik_oran, "super_akiskan"] = np.nan
    return df


# %% 1. Diziler: oluşturma, veri tipi ve şekil
f = np.array([32.4, 41.0, 23.6, 47.1, 38.1, 33.2])   # altı küpün basınç dayanımı (MPa)
sb = np.array([0.55, 0.45, 0.60, 0.40, 0.48, 0.50])   # su/bağlayıcı oranı (birimsiz)
yas = np.array([28, 28, 7, 56, 28, 14])               # numune yaşı (gün), tam sayı dizisi
X = np.column_stack([sb, yas])   # özellik matrisi: satır = numune, sütun = özellik
y = f                            # hedef vektörü: her numune için bir sayı
print("=== 1. Diziler ve şekiller ===")
print(f"f = {f} → dtype {f.dtype}, shape {f.shape}, ndim {f.ndim}")
print(f"X.shape = {X.shape} (n_örnek, n_özellik), y.shape = {y.shape}, f.reshape(-1, 1).shape = "
      f"{f.reshape(-1, 1).shape}")
yas2 = yas.copy()
yas2[0] = 7.9                    # tam sayı dizisine ondalık sayı yazılınca sessizce kesilir
print(f"yas.dtype = {yas.dtype}: yas2[0] = 7.9 atandı → yas2[0] = {yas2[0]}")
assert X.shape == (len(f), 2) and y.ndim == 1

# %% 2. İndeksleme, dilimleme ve maskeler
print("\n=== 2. İndeksleme ve maskeler ===")
print(f"f[0] = {f[0]}, f[-1] = {f[-1]}, f[1:4] = {f[1:4]}, X[:, 1] = {X[:, 1]}")
maske = f > 35                              # her eleman için True/False
print(f"f > 35 → {maske} → f[maske] = {f[maske]} ({maske.sum()} küp)")
iki_kosul = (f > 35) & (yas == 28)          # 've' için &, parantezler zorunlu
print(f"(f > 35) & (yas == 28) → {f[iki_kosul]}; bu küplerin s/b ortalaması {sb[iki_kosul].mean():.3f}")
sira = np.argsort(f)[::-1][:3]              # dayanıma göre azalan sıra, ilk üçü
print(f"En yüksek üç dayanım: indeksler {sira} → {f[sira]} MPa")
dilim = f[1:4]                              # dilim bir görünümdür (view), kopya değil
dilim[0] = 0.0
print(f"dilim[0] = 0 yazıldı → f[1] = {f[1]} (dilim ile f aynı belleği paylaşıyor)")
f[1] = 41.0                                 # eski değere döndür
assert maske.sum() == 3 and f[1] == 41.0

# %% 3. Vektörleştirme: 200 000 noktada von Mises eşdeğer gerilmesi
rng = np.random.default_rng(42)
n = 200_000
# sütunlar σx, σy, τxy (MPa); ölçek listesi sütunlara yayınlanır
S = rng.normal(0.0, [90.0, 60.0, 40.0], size=(n, 3))


def von_mises_dongu(S):
    """Her satırı Python döngüsüyle tek tek hesaplar."""
    sonuc = np.empty(len(S))
    for i in range(len(S)):
        sx, sy, txy = S[i]
        sonuc[i] = math.sqrt(sx * sx - sx * sy + sy * sy + 3 * txy * txy)
    return sonuc


def von_mises_vektor(S):
    """Aynı formül, bütün sütunlar üzerinde tek seferde (derlenmiş NumPy kodu)."""
    sx, sy, txy = S[:, 0], S[:, 1], S[:, 2]
    return np.sqrt(sx**2 - sx * sy + sy**2 + 3 * txy**2)


t0 = time.perf_counter()
vm_dongu = von_mises_dongu(S)
sure_dongu = time.perf_counter() - t0
sure_vektor = np.inf
for _ in range(5):                           # en iyi 5 ölçüm: arka plan gürültüsünü azaltır
    t0 = time.perf_counter()
    vm = von_mises_vektor(S)
    sure_vektor = min(sure_vektor, time.perf_counter() - t0)
oran = float(f"{sure_dongu / sure_vektor:.2g}")   # iki anlamlı basamak yeter
asim = vm > 235.0                            # S235 çeliğinin akma dayanımı
print("\n=== 3. Vektörleştirme ===")
print(f"{n} nokta: döngü ve vektör sonucu aynı: {np.allclose(vm_dongu, vm)}; "
      f"σ_vm > 235 MPa: {asim.sum()} nokta (yüzde {100 * asim.mean():.2f})")
print(f"Süre oranı döngü / vektör ≈ {oran:.0f} kat (bu oran bilgisayara göre değişir)")
assert np.allclose(vm_dongu, vm)

# %% 4. Yayınlama (broadcasting) ve tipik şekil hatası
ort = X.mean(axis=0)            # (2,): her sütunun ortalaması
ss = X.std(axis=0)              # (2,): her sütunun standart sapması
Z = (X - ort) / ss              # (6, 2) − (2,) → (6, 2): her satırdan aynı vektör çıkar
print("\n=== 4. Yayınlama ===")
print(f"X.mean(axis=0) = {ort.round(3)} → şekil {ort.shape}; (X − ortalama).shape = {(X - ort).shape}")
print(f"Standartlaştırılmış sütunlar: ortalama {np.abs(Z.mean(axis=0)).round(12)}, std {Z.std(axis=0)}")

# Hedefi (n, 1) biçiminde tutmak: df[["dayanim_mpa"]].to_numpy() de böyle döner
y_sutun = f.reshape(-1, 1)
A = np.column_stack([X, np.ones(len(f))])             # [s/b, yaş, 1]
w, *_ = np.linalg.lstsq(A, y_sutun, rcond=None)       # w.shape = (3, 1)
tahmin = A @ w                                        # (6, 1)
fark = f - tahmin                                     # (6,) − (6, 1) → (6, 6) !
mse_yanlis = np.mean(fark**2)
mse_dogru = np.mean((f - tahmin[:, 0]) ** 2)          # ya da tahmin.ravel()
print(f"f.shape = {f.shape}, tahmin.shape = {tahmin.shape} → (f − tahmin).shape = {fark.shape}")
print(f"Yanlış MSE = {mse_yanlis:.2f} MPa², doğru MSE = {mse_dogru:.2f} MPa² (hata mesajı yok!)")
try:
    assert f.shape == tahmin.shape, f"şekiller farklı: {f.shape} ve {tahmin.shape}"
except AssertionError as hata:
    print(f"assert yakaladı → {hata}")
assert np.allclose(np.diag(fark), f - tahmin[:, 0])

# %% 5. Eksen boyunca işlemler, rastgelelik ve doğrusal sistem
D = np.array([[23.6, 33.2, 35.7],     # satır: karışım, sütun: 7, 28, 56 gün (MPa)
              [29.8, 40.2, 43.3],
              [18.5, 30.0, 32.4]])
print("\n=== 5. Eksenler, rastgelelik, doğrusal sistem ===")
print(f"D.mean(axis=0) = {D.mean(axis=0).round(2)} MPa (yaş başına), "
      f"D.max(axis=1) = {D.max(axis=1)} MPa")
a = np.random.default_rng(42).normal(30.0, 4.0, 3)
b = np.random.default_rng(42).normal(30.0, 4.0, 3)
c = np.random.default_rng(7).normal(30.0, 4.0, 3)
print(f"Tohum 42 iki kez: {a.round(3)} = {b.round(3)} → {np.array_equal(a, b)}; tohum 7: {c.round(3)}")
K = np.array([[35.0, -15.0, 0.0],     # seri bağlı üç yay (20, 15, 10 kN/mm), sol uç ankastre
              [-15.0, 25.0, -10.0],
              [0.0, -10.0, 10.0]])
F = np.array([0.0, 0.0, 6.0])         # serbest uçta 6 kN
u = np.linalg.solve(K, F)             # K u = F, ters matris almadan
print(f"K u = F → u = {u.round(4)} mm; K @ u ile F aynı mı? {np.allclose(K @ u, F)}")
assert np.allclose(u, [0.3, 0.7, 1.3])

# %% 6. pandas: tablo verisi
df = beton_verisi(300, np.random.default_rng(42), eksik_oran=0.05)
df["su_baglayici"] = df["su"] / (df["cimento"] + df["curuf"] + df["ucucu_kul"])
tipler = ", ".join(f"{t}: {k}" for t, k in df.dtypes.astype(str).value_counts().items())
print("\n=== 6. pandas ===")
print(f"df.shape = {df.shape}; sütun tipleri → {tipler}")
print(df[["cimento", "su", "su_baglayici", "yas_gun", "cimento_tipi", "dayanim_mpa"]].head(3).round(2))
print(df[["su_baglayici", "dayanim_mpa"]].describe().T.round(2))
eksik = int(df["super_akiskan"].isna().sum())
medyan = df["super_akiskan"].median()
df["super_akiskan"] = df["super_akiskan"].fillna(medyan)
print(f"Eksik super_akiskan: {eksik} satır → medyan {medyan:.2f} kg/m³ ile dolduruldu; "
      f"kalan eksik: {int(df.isna().sum().sum())}")
print(df.groupby("yas_gun")["dayanim_mpa"].agg(["count", "mean", "std"]).round(1))
guclu = df[df["dayanim_mpa"] > 40]
print(f"Dayanımı 40 MPa'yı aşan {len(guclu)} küp; bunların {int((guclu['yas_gun'] == 28).sum())} tanesi 28 günlük")
X_tablo = df[["cimento", "su", "yas_gun"]].to_numpy()
y_tablo = df["dayanim_mpa"].to_numpy()
print(f"to_numpy: X {X_tablo.shape} {X_tablo.dtype}, y {y_tablo.shape}")
tampon = io.StringIO()                # dosya yerine bellekte bir "dosya"
df.to_csv(tampon, index=False)
tampon.seek(0)
df2 = pd.read_csv(tampon)
sayisal = df.select_dtypes("number").columns
en_buyuk_fark = np.abs(df[sayisal].to_numpy() - df2[sayisal].to_numpy()).max()
print(f"CSV gidiş-dönüş: df.equals(df2) = {df.equals(df2)}, en büyük fark {en_buyuk_fark:.1e}, "
      f"np.allclose = {np.allclose(df[sayisal], df2[sayisal])}")
assert X_tablo.shape == (300, 3) and y_tablo.shape == (300,)

# %% 7. Matplotlib: grafikler
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
kutular = np.arange(4 * np.floor(df["dayanim_mpa"].min() / 4), df["dayanim_mpa"].max() + 4, 4)
y28 = df.loc[df["yas_gun"] == 28, "dayanim_mpa"]
ax[0].hist(df["dayanim_mpa"], bins=kutular, color=RENK[0], label=f"Tüm küpler (n = {len(df)})")
ax[0].hist(y28, bins=kutular, color=RENK[1], label=f"İçlerinden 28 günlükler (n = {len(y28)})")
ax[0].set(xlabel="Basınç dayanımı (MPa)", ylabel="Küp sayısı", title="Dayanımın dağılımı")
ax[0].set_ylim(0, 1.3 * np.histogram(df["dayanim_mpa"], bins=kutular)[0].max())   # lejanta yer aç
ax[0].set_axisbelow(True)              # ızgara çizgileri çubukların arkasında kalsın
ax[0].legend(loc="upper left")
diger = ~df["yas_gun"].isin([7, 28, 90])
ax[1].scatter(df.loc[diger, "su_baglayici"], df.loc[diger, "dayanim_mpa"], s=10, color=SOLUK, alpha=0.5,
              label="Diğer yaşlar")
for renk, gun in zip(RENK[:3], [7, 28, 90]):
    sec = df["yas_gun"] == gun
    ax[1].scatter(df.loc[sec, "su_baglayici"], df.loc[sec, "dayanim_mpa"], s=18, color=renk, label=f"{gun} gün")
ax[1].set(xlabel="Su / bağlayıcı oranı (–)", ylabel="Basınç dayanımı (MPa)", title="Dayanım, su/bağlayıcı ve yaş")
ax[1].legend(loc="upper right")
fig.savefig(KLASOR / "h1_python_numpy_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
artik = f - tahmin[:, 0]
ax[0].bar(np.arange(len(f)), artik, color=RENK[0], width=0.6)
ax[0].axhline(0, color=MUREKKEP, lw=1)
ax[0].set_axisbelow(True)
ax[0].set(xlabel="Küp indeksi i", ylabel="Artık f[i] − tahmin[i] (MPa)",
          title=f"Doğru: (6,) − (6,) → (6,), MSE = {mse_dogru:.2f}")
sinir = np.abs(fark).max()
im = ax[1].imshow(fark, cmap="RdBu_r", vmin=-sinir, vmax=sinir)
for i in range(len(f)):
    for j in range(len(f)):
        ax[1].text(j, i, f"{fark[i, j]:.1f}", ha="center", va="center", fontsize=8,
                   color="white" if abs(fark[i, j]) > 0.6 * sinir else MUREKKEP)
    ax[1].add_patch(plt.Rectangle((i - 0.5, i - 0.5), 1, 1, fill=False, ec=MUREKKEP, lw=2))
ax[1].grid(False)
ax[1].set(xlabel="Ölçüm indeksi j", ylabel="Tahmin indeksi i",
          title=f"Hatalı: (6,) − (6, 1) → (6, 6), MSE = {mse_yanlis:.1f}")
fig.colorbar(im, ax=ax[1], label="f[j] − tahmin[i, 0] (MPa)")
fig.savefig(KLASOR / "h1_python_numpy_2.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: h1_python_numpy_1.png, h1_python_numpy_2.png")=== 1. Diziler ve şekiller ===
f = [32.4 41. 23.6 47.1 38.1 33.2] → dtype float64, shape (6,), ndim 1
X.shape = (6, 2) (n_örnek, n_özellik), y.shape = (6,), f.reshape(-1, 1).shape = (6, 1)
yas.dtype = int64: yas2[0] = 7.9 atandı → yas2[0] = 7
=== 2. İndeksleme ve maskeler ===
f[0] = 32.4, f[-1] = 33.2, f[1:4] = [41. 23.6 47.1], X[:, 1] = [28. 28. 7. 56. 28. 14.]
f > 35 → [False True False True True False] → f[maske] = [41. 47.1 38.1] (3 küp)
(f > 35) & (yas == 28) → [41. 38.1]; bu küplerin s/b ortalaması 0.465
En yüksek üç dayanım: indeksler [3 1 4] → [47.1 41. 38.1] MPa
dilim[0] = 0 yazıldı → f[1] = 0.0 (dilim ile f aynı belleği paylaşıyor)
=== 3. Vektörleştirme ===
200000 nokta: döngü ve vektör sonucu aynı: True; σ_vm > 235 MPa: 5879 nokta (yüzde 2.94)
Süre oranı döngü / vektör ≈ 110 kat (bu oran bilgisayara göre değişir)
=== 4. Yayınlama ===
X.mean(axis=0) = [ 0.497 26.833] → şekil (2,); (X − ortalama).shape = (6, 2)
Standartlaştırılmış sütunlar: ortalama [0. 0.], std [1. 1.]
f.shape = (6,), tahmin.shape = (6, 1) → (f − tahmin).shape = (6, 6)
Yanlış MSE = 108.34 MPa², doğru MSE = 0.70 MPa² (hata mesajı yok!)
assert yakaladı → şekiller farklı: (6,) ve (6, 1)
=== 5. Eksenler, rastgelelik, doğrusal sistem ===
D.mean(axis=0) = [23.97 34.47 37.13] MPa (yaş başına), D.max(axis=1) = [35.7 43.3 32.4] MPa
Tohum 42 iki kez: [31.219 25.84 33.002] = [31.219 25.84 33.002] → True; tohum 7: [30.005 31.195 28.903]
K u = F → u = [0.3 0.7 1.3] mm; K @ u ile F aynı mı? True
=== 6. pandas ===
df.shape = (300, 13); sütun tipleri → float64: 10, int64: 2, str: 1
cimento su su_baglayici yas_gun cimento_tipi dayanim_mpa
0 443.49 190.31 0.43 56 CEM III/A 32,5 N 39.05
1 359.72 207.64 0.34 28 CEM I 42,5 R 45.37
2 464.65 172.25 0.29 7 CEM I 42,5 R 41.44
count mean std min 25% 50% 75% max
su_baglayici 300.0 0.44 0.12 0.22 0.35 0.42 0.51 0.77
dayanim_mpa 300.0 36.10 10.63 14.67 28.59 36.24 42.82 61.19
Eksik super_akiskan: 17 satır → medyan 3.81 kg/m³ ile dolduruldu; kalan eksik: 0
count mean std
yas_gun
3 44 24.0 7.1
7 63 30.5 7.4
14 34 35.1 8.2
28 90 38.7 7.7
56 33 44.5 8.3
90 36 47.5 8.4
Dayanımı 40 MPa'yı aşan 106 küp; bunların 38 tanesi 28 günlük
to_numpy: X (300, 3) float64, y (300,)
CSV gidiş-dönüş: df.equals(df2) = False, en büyük fark 2.3e-13, np.allclose = True
Grafikler kaydedildi: h1_python_numpy_1.png, h1_python_numpy_2.png10. Sık yapılan hatalar
(n,)ile(n, 1)dizilerini karıştırmak. Hata mesajı gelmez, sonuç(n, n)olur. Hata ölçen her fonksiyonda şekliassertile kontrol edin.- Dizilerle
and/orkullanmak ya da parantezi unutmak. Doğrusu(a > 1) & (b < 2)biçimidir. - Bir görünümü farkında olmadan değiştirmek. Dilim asıl diziyle aynı belleği paylaşır; bağımsız kopya için
.copy()yazın. pandas'ta zincirleme atama yerine.lockullanın. - Tam sayı dizisine ondalık değer yazmak. Değer sessizce kesilir; diziyi
floatoluşturun. - NumPy ile pandas'ın standart sapmasını karıştırmak. Biri $n$'ye, diğeri $n-1$'e böler.
- Ondalık sayıları
==ile karşılaştırmak.np.iscloseveyanp.allclosekullanın.
11. Alıştırmalar
Alıştırma 1KolayŞekli önceden söyleyin
Çalıştırmadan önce aşağıdaki işlemlerin sonuç şeklini ya da hata vereceğini yazın, sonra deneyin: np.ones((5, 3)) - np.ones(3), np.ones((5, 3)) - np.ones(5), np.ones((5, 3)) - np.ones((5, 1)), np.zeros((4, 1)) + np.zeros(3).
Çözümü göster
Sırasıyla (5, 3); hata; (5, 3); (4, 3). İkincide sağdaki boyutlar 3 ve 5'tir; ikisi de 1 olmadığı için NumPy “operands could not be broadcast together with shapes (5,3) (5,)” hatası verir. Satır başına bir değer çıkarmak istiyorsanız vektörü (5, 1) yapın (üçüncü işlem). Dördüncüde iki taraf da yayılır: (4, 1) sütunu 3 sütuna, (3,) satırı 4 satıra genişler.
Alıştırma 2KolayMaskeyle sayım
Betikteki df tablosunda dayanımı 30 ile 40 MPa arasında (iki sınır dahil) olan 28 günlük küp kaç tanedir? 28 günlük küplerin yüzde kaçı bu aralıktadır?
Çözümü göster
m28 = df["yas_gun"] == 28
aralik = m28 & (df["dayanim_mpa"] >= 30) & (df["dayanim_mpa"] <= 40)
aralik.sum(), aralik.sum() / m28.sum()       # 41, 0.456
90 küpün 41'i, yani yüzde 45,6'sı bu aralıkta. df["dayanim_mpa"].between(30, 40) aynı sonucu verir; iki sınır varsayılan olarak dahildir.
Alıştırma 3OrtaÇimento tipine göre gruplama
Yalnız 28 günlük küpleri seçin ve çimento tipine göre küp sayısını ve ortalama dayanımı bulun. Ardından pivot_table ile satırları yaş, sütunları çimento tipi olan bir ortalama dayanım tablosu kurun. 3 günlük ve 28 günlük satırlar arasında ne fark görüyorsunuz?
Çözümü göster
df[df["yas_gun"] == 28].groupby("cimento_tipi")["dayanim_mpa"].agg(["count", "mean"]).round(1)
df.pivot_table(index="yas_gun", columns="cimento_tipi", values="dayanim_mpa", aggfunc="mean").round(1)
28 günde: CEM I 42,5 R için 34 küp ve 38,3 MPa; CEM II/A-LL 42,5 N için 37 küp ve 39,9 MPa; CEM III/A 32,5 N için 19 küp ve 37,0 MPa. Ortalamalar birbirine yakın, hatta CEM II, CEM I'in biraz üstünde. Üreteçte CEM II'nin dayanım çarpanı CEM I'inkinden düşük olduğu hâlde; 30–40 küplük gruplarda karışımlar rastgele farklı olduğu için grup ortalamaları da birkaç MPa oynar.
3 günde tablo bambaşkadır: 27,5, 24,9 ve 16,0 MPa. Yavaş dayanım kazanan CEM III/A, erken yaşta belirgin biçimde geride kalıyor ve 28 güne kadar aradaki farkı büyük ölçüde kapatıyor. Üreteçteki yaş katsayısının çimento sınıfına bağlı olmasının sonucu budur. Tek bir sütunun ortalamasına bakmak bu etkileşimi göstermezdi.
Alıştırma 4OrtaTabloda şekil hatası
Bir arkadaşınız şu kodu yazmış ve modelin MSE değerini çok yüksek bulmuş. Hatayı bulun, doğru MSE'yi hesaplayın ve yanlış değerin neden tam olarak o çıktığını açıklayın.
X = df[["cimento", "su", "yas_gun"]].to_numpy()
A = np.column_stack([X, np.ones(len(X))])
w, *_ = np.linalg.lstsq(A, df[["dayanim_mpa"]].to_numpy(), rcond=None)
tahmin = A @ w
mse = np.mean((df["dayanim_mpa"].to_numpy() - tahmin) ** 2)
Çözümü göster
Hedef çift köşeli parantezle seçildiği için (300, 1) oldu; w (4, 1), tahmin (300, 1) çıktı. Fark işlemi (300,) − (300, 1) → (300, 300) oldu. Yanlış MSE 186,23 MPa², doğrusu tahmin.ravel() ile 38,92 MPa² (RMSE 6,24 MPa).
Yanlış değer rastgele değildir. $n$ paydalı varyanslarla (np.var), bütün $(i, j)$ çiftlerinin ortalaması $\mathrm{var}(y) + \mathrm{var}(\hat y) + (\bar y - \bar{\hat y})^2$'dir. Birler sütunlu en küçük kareler çözümünde $\bar{\hat y} = \bar y$ ve $\mathrm{var}(\hat y) = \mathrm{var}(y) - \mathrm{MSE}$ olduğundan sonuç $2\,\mathrm{var}(y) - \mathrm{MSE}$ olur. Burada np.var(y) = 112,573 MPa² ve MSE = 38,918 MPa²:
Yani yanlış sayı (186,23 MPa²), modelin kalitesiyle neredeyse hiç ilgili değildir.
Alıştırma 5OrtaEğitim istatistikleriyle standartlaştırma
X_tablo'nun ilk 225 satırını eğitim, son 75 satırını test kabul edin. Ortalama ve standart sapmayı yalnız eğitim satırlarından hesaplayıp iki parçayı da yayınlamayla standartlaştırın. Test sütunlarının ortalaması ve standart sapması kaç çıkar? Bu bir hata mı?
Çözümü göster
Xe, Xt = X_tablo[:225], X_tablo[225:]
ort, ss = Xe.mean(axis=0), Xe.std(axis=0)        # (3,) ve (3,)
Ze, Zt = (Xe - ort) / ss, (Xt - ort) / ss       # (225, 3) ve (75, 3)
Zt.mean(axis=0), Zt.std(axis=0)                 # [-0.085 -0.058 -0.087], [1.09  1.04  0.894]
Eğitim sütunları tam olarak 0 ortalama ve 1 standart sapmaya sahiptir; test sütunları ise değildir. Bu hata değil, doğru davranıştır. Model yalnız eğitim verisinin ölçeğini bilir; test verisi ileride karşılaşacağımız yeni örnekleri temsil eder ve onların istatistiğini önceden bilemeyiz. Testi kendi ortalamasıyla standartlaştırmak, test bilgisini sürece sızdırmak olurdu.
Alıştırma 6ZorÇift döngüyü vektörleştirin
Standartlaştırılmış Z = (X_tablo - X_tablo.mean(axis=0)) / X_tablo.std(axis=0) özelliklerinde ilk altı küp arasındaki Öklid uzaklıklarını önce iki iç içe döngüyle, sonra döngüsüz hesaplayın. Birbirine en yakın küp çifti hangisidir? Aynı yöntemi 20.000 örnekle denemek neden kötü bir fikir olur?
Çözümü göster
Z6 = Z[:6]
D = np.sqrt(((Z6[:, None, :] - Z6[None, :, :]) ** 2).sum(axis=-1))   # (6,1,3) − (1,6,3) → (6,6,3) → (6,6)
Z6[:, None, :] araya boyutu 1 olan bir eksen ekler. (6, 1, 3) − (1, 6, 3) yayınlaması her küp çiftinin farkını tek seferde üretir; son eksen boyunca kareler toplanır. Sonuç döngüyle aynıdır (np.allclose → True). En yakın çift 0 ve 5 numaralı küplerdir (uzaklık 0,91), onları 2 ve 3 izler (0,96).
Ara dizi (n, n, p) şeklindedir. $n = 20.000$ ve $p = 3$ için $20.000^2 \cdot 3 \cdot 8$ bayt ≈ 9,6 GB bellek gerekir. Vektörleştirme hız kazandırır, ama ara sonuçların belleğe sığması gerekir. Büyük veride hesap parçalara bölünür ya da scipy.spatial.distance.cdist veya scikit-learn'ün komşu arama yapıları kullanılır (Ders 06).
Özet
- NumPy dizisi tek tipte sayıları bitişik bellekte tutar; işlemler derlenmiş kodla bütün dizi üzerinde yapılır. Bağımsız satırlar üzerindeki döngüler vektörleştirilmelidir.
- Sözleşme:
X(n, p),y(n,). Yayınlama sütun işlemlerini döngüsüz yaptırır, ama(n,) − (n, 1)sessizce(n, n)üretir; şekilleriassertile kontrol edin. - Maskeler ve
axisparametresi, veriyi seçmenin ve özetlemenin temel araçlarıdır. Dilimler görünümdür, maskeler kopya döndürür. - pandas tabloyu adlı ve tipli sütunlarla tutar:
describe,isna/fillna,groupby,locve modele geçerkento_numpy(). - Grafiklerde nesne yönelimli Matplotlib arayüzünü, birimli etiketleri ve kursun ortak stil bloğunu kullanıyoruz.
Sonraki derste aynı araçlarla makine öğrenmesinin dayandığı matematiği sayısal olarak doğrulayacağız: iç çarpım ve normlar, koşul sayısı, gradyan, zincir kuralı ve en çok olabilirlik.
Kaynaklar
- NumPy: the absolute basics for beginners ve Broadcasting belgeleri.
- 10 minutes to pandas — pandas kullanıcı kılavuzu.
- W. McKinney — Python for Data Analysis, 3. baskı (NumPy, pandas ve Matplotlib bölümleri).
- J. VanderPlas — Python Data Science Handbook, 2. baskı, Kısım II–IV.