Bu derste öğrenecekleriniz
- Dizi problemini ve doğrusal sistemlerde dürtü tepkisine dayanan FIR modelini kurmak
- RNN'yi, zamanda geri yayılımı ve kaybolan/patlayan gradyanı açıklamak
- LSTM ve GRU kapı denklemlerini yazmak, GRU hücresini NumPy ile doğrulamak
- PyTorch ile bir GRU'yu kesik BPTT ve gradyan kırpmayla eğitmek
- Nedensel evrişim (TCN) ile dikkat mekanizmasını karşılaştırıp uygun modeli seçmek
- Dizi modelini kayıt düzeyinde ve eğitim aralığı dışında dürüstçe değerlendirmek
1. Problem: depremde yapının hafızası
Bir yapının deprem sırasındaki yer değiştirmesi, o anki yer ivmesine değil, ivmenin bütün geçmişine bağlıdır. Doğrusal elastik tek serbestlik dereceli bir sistemde bu bağ Duhamel integraliyle yazılır: $u(t) = \int_0^t h(t - \tau)\, a_g(\tau)\, \dd\tau$. Burada $h$ birim dürtü tepkisidir. Yapı akmaya başladığında iş daha da zorlaşır: geri çağıran kuvvet yalnızca yer değiştirmeye değil, sistemin daha önce nereye kadar gidip döndüğüne de bağlıdır (histerezis). Deprem bittikten sonra yapı sıfıra dönmeyebilir; geriye kalıcı bir yer değiştirme kalır.
Girdisi de çıktısı da zamanla değişen, çıktısı girdinin geçmişine bağlı bu tür problemlere dizi problemi denir. Şimdiye kadarki modellerimiz bir özellik vektörünü bir sayıya eşliyordu. Bu derste bir ivme dizisini bir yer değiştirme dizisine eşleyeceğiz. Mühendislikte bunun açık bir getirisi vardır: çok serbestlik dereceli bir modelin doğrusal olmayan zaman tanım alanı analizi dakikalar sürer, kırılganlık eğrisi için ise binlerce analiz gerekir. Tepkiyi milisaniyede veren bir vekil model bu hesabı ucuzlatabilir. Bizim örneğimiz bilerek basit tutuldu: doğru cevabı bildiğimiz için yöntemleri dürüstçe karşılaştırabileceğiz.
Sitedeki deprem simülasyonu aracında doğrusal davranan çok katlı binaların sarsıntıdaki tepkisini izleyebilirsiniz. Bu derste tek katlı ama akabilen bir sistemle çalışıyoruz.
Yapı: Bouc–Wen histerezisi
Kütle başına yazılmış hareket denklemi:
$$ \begin{aligned} &\ddot u + 2\zeta\omega\,\dot u + \alpha\,\omega^2 u + (1-\alpha)\,\omega^2 z \\ &\qquad = -a_g(t) \end{aligned} $$Geri çağıran kuvvet doğrusal bir parçadan ($\alpha\,\omega^2 u$) ve histeretik yer değiştirme $z$'ye bağlı bir parçadan ($(1-\alpha)\,\omega^2 z$) oluşur; $\alpha$, akma sonrası rijitliğin başlangıç rijitliğine oranıdır. $z$'nin evrimini Bouc–Wen denklemi verir ($n = 1$):
$$ \dot z = A\,\dot u - \beta\,\lvert\dot u\rvert\, z - \gamma\,\dot u\,\lvert z\rvert $$Parametreler: $T = 0{,}5$ s ($\omega = 2\pi/T$), $\zeta = 0{,}05$, $\alpha = 0{,}1$, $A = 1$ ve $\beta = \gamma = 1/(2u_y)$, $u_y = 2$ cm.
Parametreler ne anlatıyor?
$z$, $A/(\beta+\gamma) = u_y$ değerine yaklaşır; histeretik kuvvet bu noktada doyar ve sistem yalnızca $\alpha$ oranındaki pekleşmeyle direnir. $\beta = \gamma$ seçince boşalma ($\dot u\, z < 0$) tam elastik olur. $n = 1$ geçişi yumuşak yapar: rijitlik, akma başlamadan önce de yavaş yavaş düşer. Bu seçimlerle nominal akma dayanımı ($k\,u_y$; başlangıç doğrusu ile akma sonrası asimptotun kesişimi) ağırlığın 0,322 katıdır. $n = 1$ olduğundan ilk yüklemede $u = u_y$'de kuvvet bunun ancak %67'sidir: $z = u_y(1 - e^{-u/u_y})$ ve $0{,}1 + 0{,}9\,(1 - e^{-1}) \approx 0{,}67$. 280 kaydın %80'inde sistem akıyor (süneklik $\mu = \max\lvert u\rvert/u_y > 1$); süneklik medyanı 1,61, en büyüğü 7,37.
Yer hareketleri
Gerçek deprem kaydı kullanmıyoruz. Her kayıt üç adımla üretildi. Önce beyaz gürültü, zemin tabakasını temsil eden Kanai–Tajimi süzgecinden geçirildi:
$$ H(\omega) = \frac{\omega_g^2 + 2i\zeta_g\omega_g\,\omega}{\omega_g^2 - \omega^2 + 2i\zeta_g\omega_g\,\omega} $$Zemin frekansı $\omega_g/2\pi$ her kayıtta 1,5–5 Hz, sönüm $\zeta_g$ 0,4–0,7 arasında rastgele seçildi. Sonra sinyal, yükselen, sabit kalan ve üstel sönen bir zarfla çarpıldı. Son olarak en büyük yer ivmesi (PGA) istenen değere ölçeklendi. Kayıtlar 20 s uzunlukta, $\Delta t = 0{,}02$ s, yani 1.000 örnek. 280 kaydın PGA'sı 0,1–0,6 g arasında; bunların 200'ü eğitim, 40'ı doğrulama, 40'ı test için. Ayrıca PGA'sı 0,6–0,8 g olan 40 kayıt, modeli eğitim aralığının dışında sınamak için ayrıldı.
Bütün kayıtları aynı anda çözmek için RK4'ü vektörleştirdik: durum $[u, \dot u, z]$ her kayıt için bir satırdır ve zaman döngüsü yalnızca bir kez döner. İvme iki örnek arasında doğrusal kabul edilir ve her örnek aralığı dört alt adıma bölünür. Çözücüyü iki yoldan sınadık. $\alpha = 1$ seçince sistem doğrusal olur ve doğrusal ara değerlemeli girdi için kesin çözüm matris üsteliyle hesaplanabilir (scipy.signal.lsim); en büyük bağıl fark $1{,}7\times10^{-6}$. Doğrusal olmayan sistemde ise alt adımı yarıya indirince sonuç $2{,}0\times10^{-4}$ oranında değişiyor. Bu fark RK4'ten beklenenden büyüktür, çünkü $\lvert\dot u\rvert$ ve $\lvert z\rvert$ terimleri sıfırdan geçerken türevlenemez; adım yarılama denemelerinde yakınsama mertebesi 4'ten yaklaşık 2'ye iniyor. Yine de bizim amacımız için fazlasıyla yeterli.
Veri sentetiktir. Kanai–Tajimi süzgeci ve zarf fonksiyonu gerçek kayıtların frekans içeriğini ve süresini kabaca taklit eder, ama yakın fay etkisini, hız darbelerini ya da bir sahaya özgü tepki spektrumunu temsil etmez. Buradaki sonuçlar hiçbir yönetmelik hesabının yerine geçmez.
2. Doğrusal referans: dürtü tepkisi ve FIR
Sistem doğrusal olsaydı Duhamel integrali her şeyi söylerdi. Ayrık zamanda integral bir toplama döner:
$$ u_t \approx \sum_{j=0}^{L-1} w_j\, a_{g,\,t-j} $$Bu, son $L$ ivme örneğinin ağırlıklı toplamıdır. Sinyal işlemede buna sonlu dürtü tepkili süzgeç (FIR) denir. Makine öğrenmesi açısından ise sıradan bir doğrusal regresyondur: her zaman adımı bir satır, gecikmeli ivmeler özelliklerdir. $w_j$ ağırlıkları, ayrıklaştırılmış dürtü tepkisini öğrenir.
$L$ ne kadar olmalı? Dürtü tepkisinin zarfı $e^{-\zeta\omega t}$ ile söner; zaman sabiti $1/(\zeta\omega) = 1{,}59$ s. Bu yüzden $L = 250$ örnek (5 s) seçtik; bu sürede zarf %4,3'e iner. Ağırlıkları Ders 04'teki ridge regresyonla buluyoruz. 200 eğitim kaydının 200.000 satırını bir arada tutmak yerine normal denklemlerin iki terimini kayıt kayıt biriktiriyoruz:
def gecikmeli(x):
    """(T,) → (T, L): j. sütun x[t − j]; kayıt başlamadan önce yer hareketsiz (sıfır)."""
    xp = np.concatenate([np.zeros(L - 1), x])
    return np.lib.stride_tricks.sliding_window_view(xp, L)[:, ::-1]

FtF, Fty = np.zeros((L, L)), np.zeros(L)
for a, u in zip(A_g, U_hedef):                 # kayıt kayıt
    F = np.ascontiguousarray(gecikmeli(a / s_a))
    FtF += F.T @ F
    Fty += F.T @ (u / s_u)
w = np.linalg.solve(FtF + lam * np.eye(L), Fty)   # (Σ FᵀF + λI) w = Σ Fᵀy
$\lambda$'yı doğrulama kayıtlarıyla 0,001–1000 arasındaki dört adaydan seçtik; en küçüğü (0,001) kazandı. 200.000 satırlık veride 250 ağırlık zaten iyi belirlenmiştir, düzenlileştirmenin etkisi küçüktür. Bu model aynı yapının doğrusal elastik hâlinin ($\alpha = 1$) verisiyle eğitilince test kayıtlarında normalize RMSE'nin (NRMSE, hata RMS'sinin tepki RMS'sine oranı) medyanı 0,043 çıkıyor; doğrusal bir sistem için yöntem çalışıyor. Aynı model Bouc–Wen verisiyle eğitilince NRMSE 0,572'ye çıkıyor. Nedeni ilkeseldir: doğrusal model süperpozisyona uyar. Rijitliği genliğe göre değiştiremez; girdi bittikten $L$ örnek sonra da çıktısı sıfıra döner. Yani kalıcı yer değiştirmeyi hiçbir ağırlık seçimiyle üretemez.
3. Yinelemeli sinir ağları
FIR modeli geçmişi açıkça, sabit bir pencere olarak taşır. Başka bir yol, geçmişi bir durum vektöründe özetlemektir. Fizikte bu zaten tanıdıktır: tek serbestlik dereceli sistemin bütün geçmişi $[u, \dot u, z]$ durumunda saklıdır. Yinelemeli sinir ağı (RNN) aynı fikri öğrenilebilir ağırlıklarla kurar:
$$ \vect h_t = \tanh\!\big(W_x \vect x_t + W_h \vect h_{t-1} + \vect b\big) $$ $$ \hat{\vect y}_t = W_y \vect h_t + \vect c $$Aynı ağırlıklar her zaman adımında yeniden kullanılır. Bu, modelin hangi uzunlukta bir diziyi işleyebileceğini parametre sayısından bağımsız kılar. Ağı zamanda “açarsak” her adımı bir katman olan çok derin bir ileri beslemeli ağ elde ederiz. Eğitim de bu açılmış ağda geri yayılımdır: zamanda geri yayılım (backpropagation through time, BPTT).
Gradyan neden kaybolur ya da patlar?
Kayıp bütün adımlar üzerinden toplanır, $\mathcal L = \sum_t \ell_t$. $\ell_t$'nin daha önceki bir durum $\vect h_k$'ye duyarlılığı zincir kuralıyla bir çarpım olarak yazılır:
$$ \frac{\partial \vect h_t}{\partial \vect h_k} = \prod_{j=k+1}^{t} \mathrm{diag}\big(1 - \vect h_j^2\big)\, W_h $$$\lvert\tanh'\rvert \le 1$ olduğundan bu çarpımın normu $\big(\sigma_{\max}(W_h)\big)^{t-k}$ ile sınırlıdır. $W_h$'nin en büyük tekil değeri 1'den küçükse uzak geçmişin etkisi üstel olarak kaybolur (kaybolan gradyan). Çarpanlar 1'den büyük olabiliyorsa gradyan üstel olarak büyüyebilir (patlayan gradyan). 1.000 adımlık bir dizide 0,99 ile 1,01 arasındaki fark, $0{,}99^{1000} \approx 4\times10^{-5}$ ile $1{,}01^{1000} \approx 2\times10^{4}$ arasındaki farktır.
Patlamaya karşı basit ve etkili bir çare gradyan kırpmadır (gradient clipping): gradyanın normu bir eşiği aşarsa yönü korunarak boyu küçültülür, $\vect g \leftarrow \vect g\,\min(1, \tau/\lVert\vect g\rVert)$. Kodda bunu nn.utils.clip_grad_norm_(model.parameters(), 1.0) yapıyor. Kaybolmaya karşı ise mimari bir çözüm gerekir; bu da bir sonraki bölümün konusu.
Uzun dizilerde bir pratik sorun daha var: 1.000 adımı tek seferde geri yaymak hem bellek hem zaman ister. Kesik BPTT (truncated BPTT) diziyi parçalara böler. Durum bir parçadan ötekine taşınır, ama gradyan parça sınırında kesilir. Biz 5 s'lik parçalar kullanıyoruz:
for s in range(0, X_eg.shape[1], PARCA):
    tahmin, h = model(X_eg[:, s:s + PARCA], h)
    h = h.detach()                                  # durum taşınır, gradyan parça sınırında kesilir
    kayip = ((tahmin - Y_eg[:, s:s + PARCA])**2).mean()
    opt.zero_grad()
    kayip.backward()
    nn.utils.clip_grad_norm_(model.parameters(), 1.0)    # gradyan kırpma
    opt.step()
4. Kapılı hücreler: LSTM ve GRU
Hochreiter ve Schmidhuber'in 1997'de önerdiği LSTM (long short-term memory), kaybolan gradyan sorununu durumun güncellenme biçimini değiştirerek çözer. Gizli durumun yanında bir hücre durumu $\vect c_t$ taşınır ve bu durum ağırlık matrisiyle çarpılarak değil, kapılarla ölçeklenip toplanarak güncellenir. Ne kadarının unutulacağına, ne kadar yeni bilgi yazılacağına ve ne kadarının dışarı verileceğine, değerleri 0 ile 1 arasında olan üç kapı karar verir ($\sigma$: lojistik fonksiyon, $\odot$: eleman eleman çarpım):
$$ \vect f_t = \sigma(W_f \vect x_t + U_f \vect h_{t-1} + \vect b_f) $$ $$ \vect i_t = \sigma(W_i \vect x_t + U_i \vect h_{t-1} + \vect b_i) $$ $$ \vect o_t = \sigma(W_o \vect x_t + U_o \vect h_{t-1} + \vect b_o) $$ $$ \tilde{\vect c}_t = \tanh(W_c \vect x_t + U_c \vect h_{t-1} + \vect b_c) $$ $$ \vect c_t = \vect f_t \odot \vect c_{t-1} + \vect i_t \odot \tilde{\vect c}_t $$ $$ \vect h_t = \vect o_t \odot \tanh(\vect c_t) $$Önemli olan beşinci satırdır: kapıların $\vect h_{t-1}$ üzerinden $\vect c_{t-1}$'e bağlılığı bir yana bırakılırsa (doğrudan yol) $\partial\vect c_t/\partial\vect c_{t-1} = \mathrm{diag}(\vect f_t)$'dir. Unutma kapısı 1'e yakın kaldıkça bilgi ve gradyan, ağırlık matrisleriyle tekrar tekrar çarpılmadan uzun mesafe taşınır. (Unutma kapısı özgün 1997 makalesinde yoktu; birkaç yıl sonra eklendi ve bugün standarttır.)
Cho ve arkadaşlarının (2014) GRU'su (gated recurrent unit) aynı fikri daha az parametreyle uygular: ayrı bir hücre durumu yoktur ve iki kapı yeter. PyTorch'un kullandığı biçim:
$$ \vect r_t = \sigma(W_r \vect x_t + U_r \vect h_{t-1} + \vect b_r) $$ $$ \vect z_t = \sigma(W_z \vect x_t + U_z \vect h_{t-1} + \vect b_z) $$ $$ \begin{aligned} \vect n_t = \tanh\big(&W_n \vect x_t + \vect b_{in} \\ &+ \vect r_t \odot (U_n \vect h_{t-1} + \vect b_{hn})\big) \end{aligned} $$ $$ \vect h_t = (1 - \vect z_t) \odot \vect n_t + \vect z_t \odot \vect h_{t-1} $$Güncelleme kapısı $\vect z_t$, eski durumun ne kadarının korunacağını; sıfırlama kapısı $\vect r_t$, aday durum hesaplanırken geçmişin ne kadar dikkate alınacağını belirler. $\vect z_t \approx 1$ iken $\vect h_t \approx \vect h_{t-1}$ olur ve durum, LSTM'deki hücre durumu gibi neredeyse değişmeden taşınır. Denklemleri NumPy ile yazıp PyTorch'un nn.GRU'su ile karşılaştırdık; en büyük fark $3{,}7\times10^{-8}$, yani yalnızca 32 bit kayan nokta yuvarlaması:
def gru_hucresi(x, h, W_ih, W_hh, b_ih, b_hh):
    """PyTorch sırası: [sıfırlama r, güncelleme z, aday n]."""
    H = h.shape[1]
    gi, gh = x @ W_ih.T + b_ih, h @ W_hh.T + b_hh
    r = sigmoid(gi[:, :H] + gh[:, :H])
    z = sigmoid(gi[:, H:2 * H] + gh[:, H:2 * H])
    n = np.tanh(gi[:, 2 * H:] + r * gh[:, 2 * H:])
    return (1 - z) * n + z * h
Bizim modelimiz
Tek katmanlı, 64 nöronlu bir GRU ve ardından doğrusal bir çıkış katmanı; toplam 13.957 parametre. Girdi ve çıktı eğitim verisinin standart sapmasıyla ölçeklendi. 1.000 adımlık bir diziyi işlemciyle tek tek adımlamak yavaştır, çünkü her adım bir öncekini bekler. Bu yüzden ardışık 5 örneği (0,1 s) tek bir GRU adımına girdi olarak veriyor ve çıkıştan yine 5 örnek alıyoruz. Dizi 200 adıma iner. Bunun küçük bir bedeli var: bir çerçevenin ilk çıktı örneği, aynı çerçevedeki 4 sonraki ivme örneğini (en çok 0,08 s ileriyi) görür. Kaydın tamamı elde olduğunda bu sorun değildir: $u_t$ yalnızca $t$'ye kadarki ivmeye bağlı olduğundan, gelecekteki örnekler hedef hakkında bilgi sızdırmaz ve FIR ile karşılaştırma adil kalır. Gerçek zamanlı kullanımda ya çerçevenin çıktıları çerçeve tamamlanınca (en çok 0,08 s gecikmeyle) verilir ya da çıktı çerçevesi bir adım (0,1 s) ileri kaydırılıp model 0,02–0,1 s ilerisini kestirmeye zorlanır; ikincisi doğruluğu düşürebilir.
Eğitimde Adam (öğrenme hızı 0,01'den kosinüs eğrisiyle 0,0001'e), gradyan kırpma ve 5 s'lik parçalarla kesik BPTT kullanıyoruz. 100 epok sürüyor; her 10 epokta doğrulama kayıtlarında tam diziyle tahmin yapılıyor ve en iyi model saklanıyor.
5. Yinelemesiz dizi modelleri: evrişim ve dikkat
RNN'lerin temel zayıflığı sıralı olmalarıdır: $t$ adımı, $t-1$ bitmeden hesaplanamaz. İki aile bu kısıtı kaldırır.
Nedensel ve genişletilmiş evrişim (TCN)
Ders 13'teki evrişimin tek boyutlu, yalnızca geçmişe bakan hâlidir. Genişletme (dilation) $d$ ile çekirdek elemanları arasına boşluk bırakılır:
$$ y_t = \sum_{k=0}^{K-1} w_k\, x_{t - d\,k} $$Katmanlarda $d = 1, 2, 4, \dots, 2^{N-1}$ seçilirse alıcı alan katman sayısıyla üstel büyür: $R = 1 + (K-1)(2^N - 1)$. Çekirdek boyu 3 ve 7 katmanla $R = 255$ örnek, yani 5,10 s; bu, FIR modelimizin penceresine denk. Bütün zaman adımları paralel hesaplanır, eğitim hızlıdır. Bedeli, hafızanın alıcı alanla sınırlı olmasıdır: alıcı alanın dışındaki geçmiş modele hiç ulaşmaz. Bu mimari, ses üretimi için önerilen WaveNet'te yaygınlaştı; genel dizi problemlerinde RNN'lere iyi bir rakip olduğunu Bai, Kolter ve Koltun (2018) gösterdi.
Dikkat ve Transformer
Dikkat mekanizmasında her zaman adımı, diğer bütün adımlara “ne kadar ilgili olduklarını” sorar ve onların bilgisini bu ilgiyle ağırlıklandırarak toplar. Girdi dizisinden üç matris türetilir: sorgular $Q = XW_Q$, anahtarlar $K = XW_K$ ve değerler $V = XW_V$ (Vaswani vd., 2017):
$$ \mathrm{Dikkat}(Q, K, V) = \mathrm{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right) V $$$QK^\top$'nin $(t, s)$ elemanı, $t$ adımının sorgusu ile $s$ adımının anahtarının iç çarpımıdır. Softmax her satırı toplamı 1 olan ağırlıklara çevirir. $\sqrt{d_k}$'ya bölmenin nedeni şudur: bileşenleri bağımsız, sıfır ortalamalı ve birim varyanslı iki vektörün iç çarpımının varyansı $d_k$'dır. Ölçeklemeden softmax birkaç büyük skora yapışır ve gradyanı neredeyse sıfır olur. Dizi modellemesinde $s > t$ olan skorlar $-\infty$ yapılarak gelecek gizlenir (nedensel maske).
def nedensel_dikkat(Q, K, V):
    """softmax(QKᵀ/√d_k)V; her adım yalnız kendisine ve geçmişe bakar."""
    S = Q @ K.T / np.sqrt(Q.shape[-1])
    S = np.where(np.tril(np.ones_like(S)) == 1, S, -np.inf)
    A = np.exp(S - S.max(axis=1, keepdims=True))
    A /= A.sum(axis=1, keepdims=True)
    return A @ V
Bu fonksiyon PyTorch'un scaled_dot_product_attention'ı ile $1{,}9\times10^{-7}$ farkla aynı sonucu veriyor. Maskesiz dikkat sıraya duyarsızdır (permütasyona eşdeğişkendir): diziyi karıştırsanız çıktılar da aynı biçimde karışır. Zamanı modele anlatmak için girdilere bir konum kodlaması eklenir. Özgün Transformer'da $p$ konumunun $i$'nci bileşen çifti
ile verilir; farklı frekanslardaki bu sinüsler her konuma ayırt edilebilir bir imza verir. Transformer, dikkat katmanlarını ileri beslemeli katmanlar, artık bağlantılar ve katman normalleştirmesiyle üst üste koyar. Her adım bütün geçmişe doğrudan bakabildiği için uzun bağımlılıklarda güçlüdür. Bedeli, dizi uzunluğuyla karesel büyüyen hesaptır: 1.000 adımlık bir kayıtta her katman ve her dikkat başlığı için $10^6$ skor. Ayrıca çok veri ister; birkaç yüz kayıtla aşırı uyuma çok yatkındır.
6. Hangisini seçmeli?
| Model | Hafıza | Eğitim | Ne zaman? |
|---|---|---|---|
| Doğrusal FIR / ARX | Sabit pencere (FIR); ARX'te çıktı geri beslemesiyle sınırsız | Kapalı çözüm, saniyeler | Doğrusal sistemler; her zaman referans olarak |
| RNN, LSTM, GRU | Durumda özetlenmiş, ilke olarak sınırsız | Sıralı, yavaş | Durum taşıyan fiziksel sistemler, orta uzunlukta diziler, az veri |
| TCN | Alıcı alan kadar | Paralel, hızlı | Uzun diziler, hafıza süresi kestirilebiliyorsa |
| Transformer | Bütün dizi | Paralel, $O(T^2)$ | Çok veri, uzun ve düzensiz bağımlılıklar |
Mühendislik zaman serilerinde iyi bir sıra şudur: önce fizik temelli ya da doğrusal bir referans kurun ve ne kadar iyi olduğunu ölçün. Doğrusal olmayan bir durum (histerezis, hasar birikimi) varsa ve veri azsa GRU ya da LSTM ile başlayın. Diziler çok uzunsa TCN deneyin ya da örnekleme aralığını büyütün. Transformer, verinin bol olduğu ve bağımlılıkların uzun ve düzensiz olduğu durumlar içindir.
7. Çalıştırılabilir kod
Betik yedi bölümden oluşur: yer hareketleri, Bouc–Wen çözümü ve doğrulaması, doğrusal referans, sıfırdan GRU ve dikkat denetimi, GRU eğitimi, değerlendirme ve grafikler. Eğitim süresi işlemciye göre değişir; iki çekirdekli bir bilgisayarda birkaç dakikayı bulabilir. PyTorch'un CPU sürümü yeterlidir; kurulum için Ders 12'ye bakın.
"""Ders 14 — Dizi modelleri: RNN, LSTM ve dikkat.

Zemin ivmesinden (a_g) doğrusal olmayan tek serbestlik dereceli bir yapının yer değiştirme tepkisini (u)
tahmin ediyoruz. Veri tamamen sentetiktir:
  * Yer hareketleri: Kanai–Tajimi süzgecinden geçirilmiş beyaz gürültü × zarf fonksiyonu. PGA 0,1–0,6 g
    (eğitim, doğrulama, test) ve 0,6–0,8 g (eğitim aralığı dışı sınama); dt = 0,02 s, süre 20 s.
  * Yapı: Bouc–Wen histerezisli tek serbestlik dereceli sistem; T = 0,5 s, ζ = %5, α = 0,1, u_y = 2 cm.
    Bütün kayıtlar aynı anda, vektörleştirilmiş RK4 ile çözülür.
Gerçek deprem kaydı ya da gerçek bir yapı değildir; yönetmelik hesabının yerine geçmez.

Modeller: (1) doğrusal referans: son 250 ivme örneğine ridge regresyon (FIR), (2) GRU (PyTorch).
Çalıştır:  python d14_dizi_modelleri.py
Gerekenler: numpy, scipy, matplotlib, torch  (Python 3.12+)
Süre: 2 çekirdekli bir işlemcide birkaç dakika; eğitim süresi makineye göre değişir
Çıktılar: terminale sayılar, aynı klasöre dört PNG grafiği
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
import torch
from scipy import signal
from torch import nn

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent
rng = np.random.default_rng(42)
torch.manual_seed(42)

# %% 1. Yer hareketleri: süzülmüş beyaz gürültü × zarf (sentetik)
G = 9.81
DT, N_ADIM = 0.02, 1000                      # 20 s
t = np.arange(N_ADIM) * DT


def yer_hareketi(n, pga_aralik):
    """Kanai–Tajimi süzgeci: H(ω) = (ω_g² + 2iζ_gω_gω) / (ω_g² − ω² + 2iζ_gω_gω); sonra zarf ve PGA ölçeği."""
    f_g = rng.uniform(1.5, 5.0, n)           # zemin baskın frekansı (Hz)
    z_g = rng.uniform(0.4, 0.7, n)           # zemin sönümü
    t1 = rng.uniform(1.0, 2.5, n)            # yükselme süresi
    t2 = t1 + rng.uniform(4.0, 8.0, n)       # kuvvetli hareketin sonu
    c = rng.uniform(0.3, 0.6, n)             # sönümlenme hızı (1/s)
    pga = rng.uniform(*pga_aralik, n)
    m = 2 * N_ADIM                           # FFT ile süzme dairesel evrişimdir; durağan gürültüde sarma zararsız
    om = 2 * np.pi * np.fft.rfftfreq(m, DT)
    wg = 2 * np.pi * f_g[:, None]
    H = (wg**2 + 2j * z_g[:, None] * wg * om) / (wg**2 - om**2 + 2j * z_g[:, None] * wg * om)
    a = np.fft.irfft(np.fft.rfft(rng.normal(size=(n, m)), axis=1) * H, n=m, axis=1)[:, :N_ADIM]
    tt = t[None, :]
    zarf = np.where(tt < t1[:, None], (tt / t1[:, None])**2,
                    np.where(tt <= t2[:, None], 1.0, np.exp(-c[:, None] * (tt - t2[:, None]))))
    a *= zarf
    return a / np.abs(a).max(axis=1, keepdims=True) * pga[:, None] * G, pga


N_EG, N_DOG, N_TEST, N_DIS = 200, 40, 40, 40
a_g, pga = yer_hareketi(N_EG + N_DOG + N_TEST, (0.1, 0.6))
a_dis, pga_dis = yer_hareketi(N_DIS, (0.6, 0.8))            # eğitim aralığı dışı
i_eg = np.arange(N_EG)
i_dog = np.arange(N_EG, N_EG + N_DOG)
i_te = np.arange(N_EG + N_DOG, N_EG + N_DOG + N_TEST)

# %% 2. Bouc–Wen sistemi: m ü + c u̇ + αku + (1−α)kz = −m a_g
T_N, ZETA, ALFA, UY = 0.5, 0.05, 0.1, 0.02  # s, -, -, m
W = 2 * np.pi / T_N


def bouc_wen_rk4(ag, alfa=ALFA, alt_adim=4):
    """Bütün kayıtları (satırlar) birlikte çözer. ż = A u̇ − β|u̇|z − γ u̇|z| (n = 1, A = 1, β = γ)."""
    beta = gamma = 0.5 / UY                 # z'nin üst sınırı A/(β+γ) = UY
    n = ag.shape[0]
    u, v, z = np.zeros(n), np.zeros(n), np.zeros(n)
    U, Z = np.zeros_like(ag), np.zeros_like(ag)
    h = DT / alt_adim

    def f(u, v, z, a):
        return (v,
                -a - 2 * ZETA * W * v - alfa * W**2 * u - (1 - alfa) * W**2 * z,
                v - beta * np.abs(v) * z - gamma * v * np.abs(z))

    for k in range(ag.shape[1] - 1):
        da = ag[:, k + 1] - ag[:, k]        # ivme iki örnek arasında doğrusal değişir
        for s in range(alt_adim):
            a0, a1, a2 = (ag[:, k] + da * (s + r) / alt_adim for r in (0.0, 0.5, 1.0))
            k1 = f(u, v, z, a0)
            k2 = f(u + h / 2 * k1[0], v + h / 2 * k1[1], z + h / 2 * k1[2], a1)
            k3 = f(u + h / 2 * k2[0], v + h / 2 * k2[1], z + h / 2 * k2[2], a1)
            k4 = f(u + h * k3[0], v + h * k3[1], z + h * k3[2], a2)
            u = u + h / 6 * (k1[0] + 2 * k2[0] + 2 * k3[0] + k4[0])
            v = v + h / 6 * (k1[1] + 2 * k2[1] + 2 * k3[1] + k4[1])
            z = z + h / 6 * (k1[2] + 2 * k2[2] + 2 * k3[2] + k4[2])
        U[:, k + 1], Z[:, k + 1] = u, z
    return U, Z


u_g, z_g = bouc_wen_rk4(a_g)
u_dis, z_dis = bouc_wen_rk4(a_dis)
u_lin, _ = bouc_wen_rk4(a_g, alfa=1.0)       # α = 1: aynı yapının doğrusal elastik hâli

# Doğrulama 1: doğrusal durumda kesin çözüm (parça parça doğrusal girdi için matris üsteli, lsim)
sistem = signal.StateSpace([[0, 1], [-W**2, -2 * ZETA * W]], [[0], [-1]], [[1, 0]], [[0]])
hata_lin = max(np.abs(signal.lsim(sistem, a_g[i], t)[1] - u_lin[i]).max() / np.abs(u_lin[i]).max()
               for i in range(5))
# Doğrulama 2: doğrusal olmayan durumda adım yarılama
u_ince, _ = bouc_wen_rk4(a_g[:20], alt_adim=8)
hata_yari = np.abs(u_ince - u_g[:20]).max() / np.abs(u_ince).max()

suneklik = np.abs(u_g).max(axis=1) / UY
artik_g = u_g[:, -50:].mean(axis=1)          # son 1 s'nin ortalaması: kalıcı yer değiştirme
print("=== 1. Veri ve sayısal çözüm ===")
print(f"Kayıt: eğitim {N_EG}, doğrulama {N_DOG}, test {N_TEST} (PGA 0.1–0.6 g); aralık dışı {N_DIS} (0.6–0.8 g)")
print(f"Yapı: T = {T_N} s, ζ = {ZETA}, α = {ALFA}, u_y = {UY * 100:.0f} cm; "
      f"akma dayanımı / ağırlık = {W**2 * UY / G:.3f}")
print(f"Süneklik μ = max|u|/u_y: medyan {np.median(suneklik):.2f}, en büyük {suneklik.max():.2f}; "
      f"akan kayıt oranı (μ > 1) = {np.mean(suneklik > 1):.2f}")
print(f"Kalıcı yer değiştirme |u_res|: ortalama {np.mean(np.abs(artik_g)) * 100:.2f} cm, "
      f"en büyük {np.abs(artik_g).max() * 100:.2f} cm")
print(f"RK4 doğrulama: doğrusal durumda kesin çözümden en büyük bağıl fark {hata_lin:.1e}; "
      f"adım yarılamada fark {hata_yari:.1e}")
assert hata_lin < 1e-4 and hata_yari < 1e-3 and np.all(np.isfinite(u_g))

# %% 3. Doğrusal referans: son L ivme örneğine ridge regresyon (FIR), normal denklemlerle sıfırdan
L = 250                                      # 5 s geçmiş
s_a, s_u = a_g[i_eg].std(), u_g[i_eg].std()  # ölçekleme yalnız eğitim verisinden


def gecikmeli(x):
    """(T,) → (T, L): j. sütun x[t − j]; kayıt başlamadan önce yer hareketsiz (sıfır)."""
    xp = np.concatenate([np.zeros(L - 1), x])
    return np.lib.stride_tricks.sliding_window_view(xp, L)[:, ::-1]


def fir_birikim(A_g, U_hedef):
    """Σ FᵀF ve Σ Fᵀy: bütün zaman adımları, kayıt kayıt biriktirilir (λ'dan bağımsız)."""
    FtF, Fty = np.zeros((L, L)), np.zeros(L)
    for a, u in zip(A_g, U_hedef):
        F = np.ascontiguousarray(gecikmeli(a / s_a))
        FtF += F.T @ F
        Fty += F.T @ (u / s_u)
    return FtF, Fty


def fir_coz(FtF, Fty, lam):
    return np.linalg.solve(FtF + lam * np.eye(L), Fty)          # (Σ FᵀF + λI) w = Σ Fᵀy


def fir_tahmin(w, A_g):
    return np.stack([gecikmeli(a / s_a) @ w for a in A_g]) * s_u


def nrmse(p, u):
    return np.sqrt(np.mean((p - u)**2, axis=1)) / np.sqrt(np.mean(u**2, axis=1))


birikim = fir_birikim(a_g[i_eg], u_g[i_eg])
lam_aday = [1e-3, 1e-1, 1e1, 1e3]
dog_hata = [np.median(nrmse(fir_tahmin(fir_coz(*birikim, lam), a_g[i_dog]), u_g[i_dog])) for lam in lam_aday]
lam = lam_aday[int(np.argmin(dog_hata))]
w_fir = fir_coz(*birikim, lam)
w_fir_lin = fir_coz(*fir_birikim(a_g[i_eg], u_lin[i_eg]), lam)
p_fir = fir_tahmin(w_fir, a_g[i_te])
p_fir_dis = fir_tahmin(w_fir, a_dis)
e_fir_lin = nrmse(fir_tahmin(w_fir_lin, a_g[i_te]), u_lin[i_te])
print("\n=== 2. Doğrusal referans (FIR, son 250 örnek, ridge) ===")
print(f"Dürtü tepkisi zaman sabiti 1/(ζω) = {1 / (ZETA * W):.2f} s; L = {L} örnekte ({L * DT:.0f} s) "
      f"zarf %{np.exp(-ZETA * W * L * DT) * 100:.1f}'e iner")
print(f"Doğrulamayla seçilen λ = {lam:g} (adaylar: {', '.join(f'{v:g}' for v in lam_aday)})")
print(f"Doğrusal elastik sistem (α = 1) verisiyle: test NRMSE medyanı = {np.median(e_fir_lin):.3f}")
print(f"Bouc–Wen sistemi verisiyle            : test NRMSE medyanı = {np.median(nrmse(p_fir, u_g[i_te])):.3f}")

# %% 4. Sıfırdan: GRU hücresi ve nedensel dikkat; PyTorch ile aynı sonuç
def sigmoid(x):
    return 1 / (1 + np.exp(-x))


def gru_hucresi(x, h, W_ih, W_hh, b_ih, b_hh):
    """PyTorch sırası: [sıfırlama r, güncelleme z, aday n]."""
    H = h.shape[1]
    gi, gh = x @ W_ih.T + b_ih, h @ W_hh.T + b_hh
    r = sigmoid(gi[:, :H] + gh[:, :H])
    z = sigmoid(gi[:, H:2 * H] + gh[:, H:2 * H])
    n = np.tanh(gi[:, 2 * H:] + r * gh[:, 2 * H:])
    return (1 - z) * n + z * h


def nedensel_dikkat(Q, K, V):
    """softmax(QKᵀ/√d_k)V; her adım yalnız kendisine ve geçmişe bakar."""
    S = Q @ K.T / np.sqrt(Q.shape[-1])
    S = np.where(np.tril(np.ones_like(S)) == 1, S, -np.inf)
    A = np.exp(S - S.max(axis=1, keepdims=True))
    A /= A.sum(axis=1, keepdims=True)
    return A @ V


kucuk = nn.GRU(3, 8, batch_first=True)
xk = torch.randn(4, 6, 3)
with torch.no_grad():
    yk, _ = kucuk(xk)
prm = [p.detach().numpy().astype(np.float64) for p in kucuk.parameters()]   # W_ih, W_hh, b_ih, b_hh
h = np.zeros((4, 8))
for k in range(6):
    h = gru_hucresi(xk[:, k].numpy().astype(np.float64), h, *prm)
fark_gru = np.abs(h - yk[:, -1].numpy()).max()
q, k_, v_ = (torch.randn(7, 4) for _ in range(3))
fark_dikkat = np.abs(nedensel_dikkat(q.numpy(), k_.numpy(), v_.numpy())
                     - nn.functional.scaled_dot_product_attention(q[None], k_[None], v_[None],
                                                                  is_causal=True)[0].numpy()).max()
alici = 1 + (3 - 1) * sum(2**i for i in range(7))                         # çekirdek 3, genişletme 1…64
print("\n=== 3. Sıfırdan GRU hücresi ve dikkat ===")
print(f"NumPy GRU ile nn.GRU arasındaki en büyük fark: {fark_gru:.1e}")
print(f"NumPy nedensel dikkat ile PyTorch arasındaki en büyük fark: {fark_dikkat:.1e}")
print(f"Nedensel genişletilmiş evrişim (çekirdek 3, 7 katman): alıcı alan {alici} örnek = {alici * DT:.2f} s")
assert fark_gru < 1e-5 and fark_dikkat < 1e-5

# %% 5. GRU: çerçeveli girdi, kesik zamanda geri yayılım (TBPTT)
KARE = 5                                     # her GRU adımı 5 örnek (0,1 s) alır, 5 örnek üretir
PARCA = 50                                   # 50 GRU adımı = 5 s'lik parçalar
EPOK = 100


def cerceve(x):
    return torch.tensor(x.reshape(len(x), -1, KARE), dtype=torch.float32)


class GRUModel(nn.Module):
    def __init__(self, gizli=64):
        super().__init__()
        self.gru = nn.GRU(KARE, gizli, batch_first=True)
        self.cikis = nn.Linear(gizli, KARE)

    def forward(self, x, h=None):
        y, h = self.gru(x, h)
        return self.cikis(y), h


def gru_tahmin(model, A_g):
    with torch.no_grad():
        p, _ = model(cerceve(A_g / s_a))                 # sıfır başlangıç durumu, tüm kayıt
    return p.reshape(len(A_g), -1).numpy().astype(np.float64) * s_u


X_eg, Y_eg = cerceve(a_g[i_eg] / s_a), cerceve(u_g[i_eg] / s_u)
model = GRUModel()
opt = torch.optim.Adam(model.parameters(), lr=1e-2)
zamanlayici = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=EPOK, eta_min=1e-4)
egitim_kaybi, dog_kaybi, en_iyi = [], [], (np.inf, None, 0)
for epok in range(EPOK):
    h, toplam = None, 0.0
    for s in range(0, X_eg.shape[1], PARCA):
        tahmin, h = model(X_eg[:, s:s + PARCA], h)
        h = h.detach()                                  # durum taşınır, gradyan parça sınırında kesilir
        kayip = ((tahmin - Y_eg[:, s:s + PARCA])**2).mean()
        opt.zero_grad()
        kayip.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)    # gradyan kırpma
        opt.step()
        toplam += kayip.item()
    zamanlayici.step()
    egitim_kaybi.append(toplam / (X_eg.shape[1] // PARCA))
    if (epok + 1) % 10 == 0:
        dk = np.mean(((gru_tahmin(model, a_g[i_dog]) - u_g[i_dog]) / s_u)**2)
        dog_kaybi.append((epok + 1, dk))
        if dk < en_iyi[0]:
            en_iyi = (dk, {k: v.clone() for k, v in model.state_dict().items()}, epok + 1)
model.load_state_dict(en_iyi[1])
p_gru = gru_tahmin(model, a_g[i_te])
p_gru_dis = gru_tahmin(model, a_dis)
print("\n=== 4. GRU eğitimi ===")
print(f"Parametre sayısı: {sum(p.numel() for p in model.parameters())}; "
      f"{EPOK} epok × {X_eg.shape[1] // PARCA} parça; en iyi doğrulama epoku {en_iyi[2]}")
print(f"Eğitim kaybı (ölçekli MSE): ilk epok {egitim_kaybi[0]:.3f}, son epok {egitim_kaybi[-1]:.4f}; "
      f"en iyi doğrulama MSE {en_iyi[0]:.4f}")

# %% 6. Değerlendirme: NRMSE, tepe ve kalıcı yer değiştirme
def tepe_hatasi(p, u):
    return (np.abs(p).max(axis=1) - np.abs(u).max(axis=1)) / np.abs(u).max(axis=1)


def artik(x):
    return x[:, -50:].mean(axis=1)


zayif = pga[i_te] < 0.25
print("\n=== 5. Test kayıtları (PGA 0.1–0.6 g) ===")
print(f"{'Model':10s} {'NRMSE med.':>11s} {'zayıf':>7s} {'kuvvetli':>9s} {'|tepe hatası|':>14s} "
      f"{'kalıcı y.d. hatası':>19s}")
for ad, p in [("Doğrusal", p_fir), ("GRU", p_gru)]:
    e = nrmse(p, u_g[i_te])
    print(f"{ad:10s} {np.median(e):11.3f} {np.median(e[zayif]):7.3f} {np.median(e[~zayif]):9.3f} "
          f"{np.mean(np.abs(tepe_hatasi(p, u_g[i_te]))) * 100:13.1f}% "
          f"{np.mean(np.abs(artik(p) - artik(u_g[i_te]))) * 100:15.2f} cm")
print(f"Gerçek kalıcı yer değiştirme (test): ortalama |u_res| = {np.mean(np.abs(artik(u_g[i_te]))) * 100:.2f} cm; "
      f"GRU ile korelasyon {np.corrcoef(artik(p_gru), artik(u_g[i_te]))[0, 1]:.3f}")
k_te = int(np.argmax(np.abs(u_g[i_te]).max(axis=1)))
e_gru_te = nrmse(p_gru, u_g[i_te])
print(f"Testteki en büyük tepe: gerçek {np.abs(u_g[i_te[k_te]]).max() * 100:.1f} cm, "
      f"GRU {np.abs(p_gru[k_te]).max() * 100:.1f} cm, doğrusal {np.abs(p_fir[k_te]).max() * 100:.1f} cm; "
      f"bu kayıtta GRU NRMSE {e_gru_te[k_te]:.3f}")
j_te = int(np.argmax(pga[i_te]))                # Şekil 1'deki kayıt: testte PGA'sı en büyük olan
u_j, g_j, f_j = u_g[i_te[j_te]] * 100, p_gru[j_te] * 100, p_fir[j_te] * 100
print(f"Şekil 1 kaydı (PGA {pga[i_te[j_te]]:.2f} g): en büyük |u| gerçek {np.abs(u_j).max():.2f}, "
      f"GRU {np.abs(g_j).max():.2f}, doğrusal {np.abs(f_j).max():.2f} cm; "
      f"kalıcı y.d. gerçek {u_j[-50:].mean():.2f}, GRU {g_j[-50:].mean():.2f} cm")
sira = int(np.sum(e_gru_te >= e_gru_te[j_te]))
print(f"   bu kayıtta GRU NRMSE {e_gru_te[j_te]:.3f} (testte büyükten küçüğe {sira}. "
      f"/ {len(e_gru_te)}); testteki en kötü GRU NRMSE {e_gru_te.max():.3f}")
print("\n=== 6. Eğitim aralığı dışı (PGA 0.6–0.8 g) ===")
for ad, p in [("Doğrusal", p_fir_dis), ("GRU", p_gru_dis)]:
    print(f"{ad:10s} NRMSE medyanı {np.median(nrmse(p, u_dis)):.3f}, "
          f"tepe hatası ortalaması {np.mean(tepe_hatasi(p, u_dis)) * 100:+.1f}% (işaretli)")
print(f"Aralık dışı kayıtlarda süneklik medyanı {np.median(np.abs(u_dis).max(axis=1) / UY):.2f} "
      f"(eğitimde {np.median(suneklik[i_eg]):.2f})")
k_en = int(np.argmax(np.abs(u_dis).max(axis=1)))
print(f"En büyük tepe: gerçek {np.abs(u_dis[k_en]).max() * 100:.1f} cm, "
      f"GRU {np.abs(p_gru_dis[k_en]).max() * 100:.1f} cm; "
      f"GRU'nun aralık dışı kayıtlardaki en büyük tepe tahmini {np.abs(p_gru_dis).max() * 100:.1f} cm")
assert np.all(np.isfinite(p_gru)) and np.median(nrmse(p_gru, u_g[i_te])) < np.median(nrmse(p_fir, u_g[i_te]))

# %% 7. Grafikler
j, jj = i_te[j_te], j_te                     # testteki en kuvvetli kayıt
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained", width_ratios=[1.6, 1])
ax[0].plot(t, a_g[j] / G, color=SOLUK, lw=1)
ax[0].set(xlabel="Zaman (s)", ylabel=r"Yer ivmesi $a_g$ (g)", title=f"Test kaydı: PGA = {pga[j]:.2f} g")
kuvvet = (ALFA * W**2 * u_g[j] + (1 - ALFA) * W**2 * z_g[j]) / G
ax[1].plot(u_g[j] * 100, kuvvet, color=MUREKKEP, lw=1)
ax[1].set(xlabel="Yer değiştirme u (cm)", ylabel="Geri çağıran kuvvet / ağırlık",
          title="Bouc–Wen histerezisi (gerçek)")
fig.savefig(KLASOR / "d14_dizi_modelleri_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(figsize=(9, 4.8), layout="constrained")
ax.plot(t, u_g[j] * 100, color=MUREKKEP, ls="--", lw=1.4, label="Gerçek (RK4)")
ax.plot(t, p_gru[jj] * 100, color=RENK[0], lw=1.6, label="GRU")
ax.plot(t, p_fir[jj] * 100, color=RENK[1], ls=":", lw=1.6, label="Doğrusal FIR")
ax.axhline(0, color=IKINCIL, lw=0.6)
ax.set(xlabel="Zaman (s)", ylabel="Yer değiştirme u (cm)", title="Tepki: gerçek, GRU ve doğrusal referans")
ax.legend(loc="upper right", ncols=3)
fig.savefig(KLASOR / "d14_dizi_modelleri_2.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
tepe_g, tepe_d = np.abs(u_g[i_te]).max(axis=1) * 100, np.abs(u_dis).max(axis=1) * 100
ax[0].scatter(tepe_g, np.abs(p_fir).max(axis=1) * 100, s=22, color=RENK[1], marker="^", label="Doğrusal (test)")
ax[0].scatter(tepe_g, np.abs(p_gru).max(axis=1) * 100, s=22, color=RENK[0], label="GRU (test)")
ax[0].scatter(tepe_d, np.abs(p_gru_dis).max(axis=1) * 100, s=26, facecolor="white", edgecolor=RENK[0],
              label="GRU (aralık dışı)")
sinir = max(tepe_d.max(), tepe_g.max()) * 1.05
ax[0].plot([0, sinir], [0, sinir], color=MUREKKEP, ls="--", lw=1.2, label="Tam isabet")
ax[0].set(xlabel="Gerçek tepe |u| (cm)", ylabel="Tahmin edilen tepe |u| (cm)", title="Tepe yer değiştirme",
          xlim=(0, sinir), ylim=(0, sinir))
ax[0].legend(loc="upper left")
ax[1].axvspan(0.6, 0.8, color=SOLUK, alpha=0.15, lw=0, label="Eğitim aralığı dışı")
ax[1].scatter(pga[i_te], nrmse(p_fir, u_g[i_te]), s=22, color=RENK[1], marker="^", label="Doğrusal")
ax[1].scatter(pga_dis, nrmse(p_fir_dis, u_dis), s=22, color=RENK[1], marker="^")
ax[1].scatter(pga[i_te], nrmse(p_gru, u_g[i_te]), s=22, color=RENK[0], label="GRU")
ax[1].scatter(pga_dis, nrmse(p_gru_dis, u_dis), s=26, facecolor="white", edgecolor=RENK[0])
ax[1].set(xlabel="PGA (g)", ylabel="NRMSE", title="Kayıt başına hata", ylim=(0, 1.25))
ax[1].legend(loc="upper left", ncols=3, fontsize=9)
fig.savefig(KLASOR / "d14_dizi_modelleri_3.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].semilogy(np.arange(1, EPOK + 1), egitim_kaybi, color=RENK[0], label="Eğitim (parça ortalaması)")
ax[0].semilogy(*zip(*dog_kaybi), "o-", color=RENK[1], ms=4, lw=1.4, label="Doğrulama (tam kayıt)")
ax[0].set(xlabel="Epok", ylabel="MSE (ölçekli)", title="GRU öğrenme eğrisi")
ax[0].legend(loc="upper right")
r_g, r_f, r_t = artik(p_gru) * 100, artik(p_fir) * 100, artik(u_g[i_te]) * 100
sinir = np.abs(np.concatenate([r_g, r_f, r_t])).max() * 1.1
ax[1].plot([-sinir, sinir], [-sinir, sinir], color=MUREKKEP, ls="--", lw=1.2, label="Tam isabet")
ax[1].scatter(r_t, r_f, s=22, color=RENK[1], marker="^", label="Doğrusal")
ax[1].scatter(r_t, r_g, s=22, color=RENK[0], label="GRU")
ax[1].set(xlabel="Gerçek kalıcı yer değiştirme (cm)", ylabel="Tahmin (cm)", title="Kalıcı yer değiştirme (test)",
          xlim=(-sinir, sinir), ylim=(-sinir, sinir))
ax[1].legend(loc="upper left")
fig.savefig(KLASOR / "d14_dizi_modelleri_4.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d14_dizi_modelleri_1.png, _2.png, _3.png, _4.png")=== 1. Veri ve sayısal çözüm ===
Kayıt: eğitim 200, doğrulama 40, test 40 (PGA 0.1–0.6 g); aralık dışı 40 (0.6–0.8 g)
Yapı: T = 0.5 s, ζ = 0.05, α = 0.1, u_y = 2 cm; akma dayanımı / ağırlık = 0.322
Süneklik μ = max|u|/u_y: medyan 1.61, en büyük 7.37; akan kayıt oranı (μ > 1) = 0.80
Kalıcı yer değiştirme |u_res|: ortalama 0.28 cm, en büyük 1.35 cm
RK4 doğrulama: doğrusal durumda kesin çözümden en büyük bağıl fark 1.7e-06; adım yarılamada fark 2.0e-04
=== 2. Doğrusal referans (FIR, son 250 örnek, ridge) ===
Dürtü tepkisi zaman sabiti 1/(ζω) = 1.59 s; L = 250 örnekte (5 s) zarf %4.3'e iner
Doğrulamayla seçilen λ = 0.001 (adaylar: 0.001, 0.1, 10, 1000)
Doğrusal elastik sistem (α = 1) verisiyle: test NRMSE medyanı = 0.043
Bouc–Wen sistemi verisiyle : test NRMSE medyanı = 0.572
=== 3. Sıfırdan GRU hücresi ve dikkat ===
NumPy GRU ile nn.GRU arasındaki en büyük fark: 3.7e-08
NumPy nedensel dikkat ile PyTorch arasındaki en büyük fark: 1.9e-07
Nedensel genişletilmiş evrişim (çekirdek 3, 7 katman): alıcı alan 255 örnek = 5.10 s
=== 4. GRU eğitimi ===
Parametre sayısı: 13957; 100 epok × 4 parça; en iyi doğrulama epoku 100
Eğitim kaybı (ölçekli MSE): ilk epok 0.961, son epok 0.0198; en iyi doğrulama MSE 0.0301
=== 5. Test kayıtları (PGA 0.1–0.6 g) ===
Model NRMSE med. zayıf kuvvetli |tepe hatası| kalıcı y.d. hatası
Doğrusal 0.572 0.625 0.517 13.5% 0.29 cm
GRU 0.138 0.159 0.138 6.7% 0.10 cm
Gerçek kalıcı yer değiştirme (test): ortalama |u_res| = 0.29 cm; GRU ile korelasyon 0.946
Testteki en büyük tepe: gerçek 14.7 cm, GRU 9.2 cm, doğrusal 9.6 cm; bu kayıtta GRU NRMSE 0.292
Şekil 1 kaydı (PGA 0.57 g): en büyük |u| gerçek 8.62, GRU 6.79, doğrusal 6.48 cm; kalıcı y.d. gerçek -0.64, GRU -0.66 cm
bu kayıtta GRU NRMSE 0.136 (testte büyükten küçüğe 23. / 40); testteki en kötü GRU NRMSE 0.305
=== 6. Eğitim aralığı dışı (PGA 0.6–0.8 g) ===
Doğrusal NRMSE medyanı 0.549, tepe hatası ortalaması -17.0% (işaretli)
GRU NRMSE medyanı 0.233, tepe hatası ortalaması -14.3% (işaretli)
Aralık dışı kayıtlarda süneklik medyanı 3.42 (eğitimde 1.57)
En büyük tepe: gerçek 18.4 cm, GRU 9.2 cm; GRU'nun aralık dışı kayıtlardaki en büyük tepe tahmini 9.2 cm
Grafikler kaydedildi: d14_dizi_modelleri_1.png, _2.png, _3.png, _4.pngPyTorch eğitimlerinde son basamaklar işlemciye, iş parçacığı sayısına ve kitaplık sürümüne göre biraz farklı çıkabilir; eğilimler ve sonuçlar aynı kalır.
8. Sonuçları yorumlayın
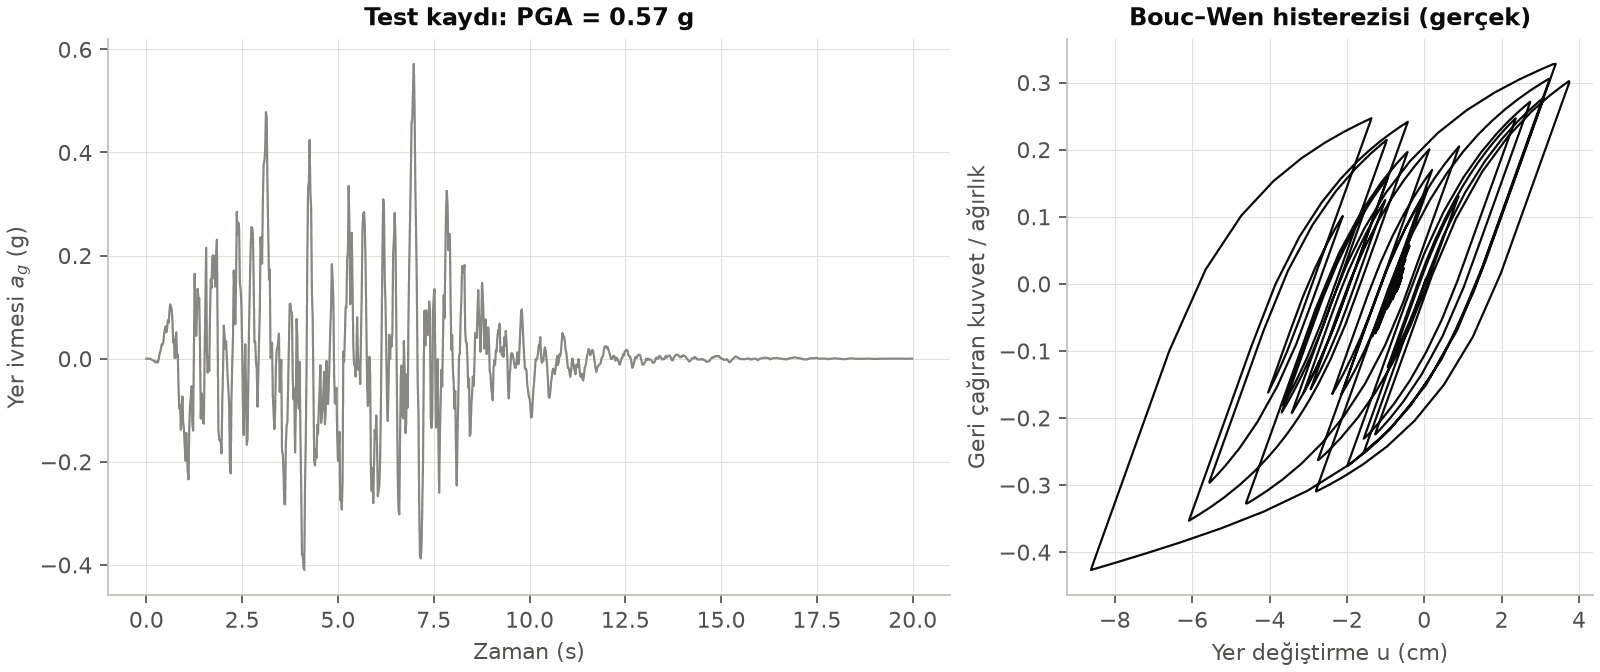
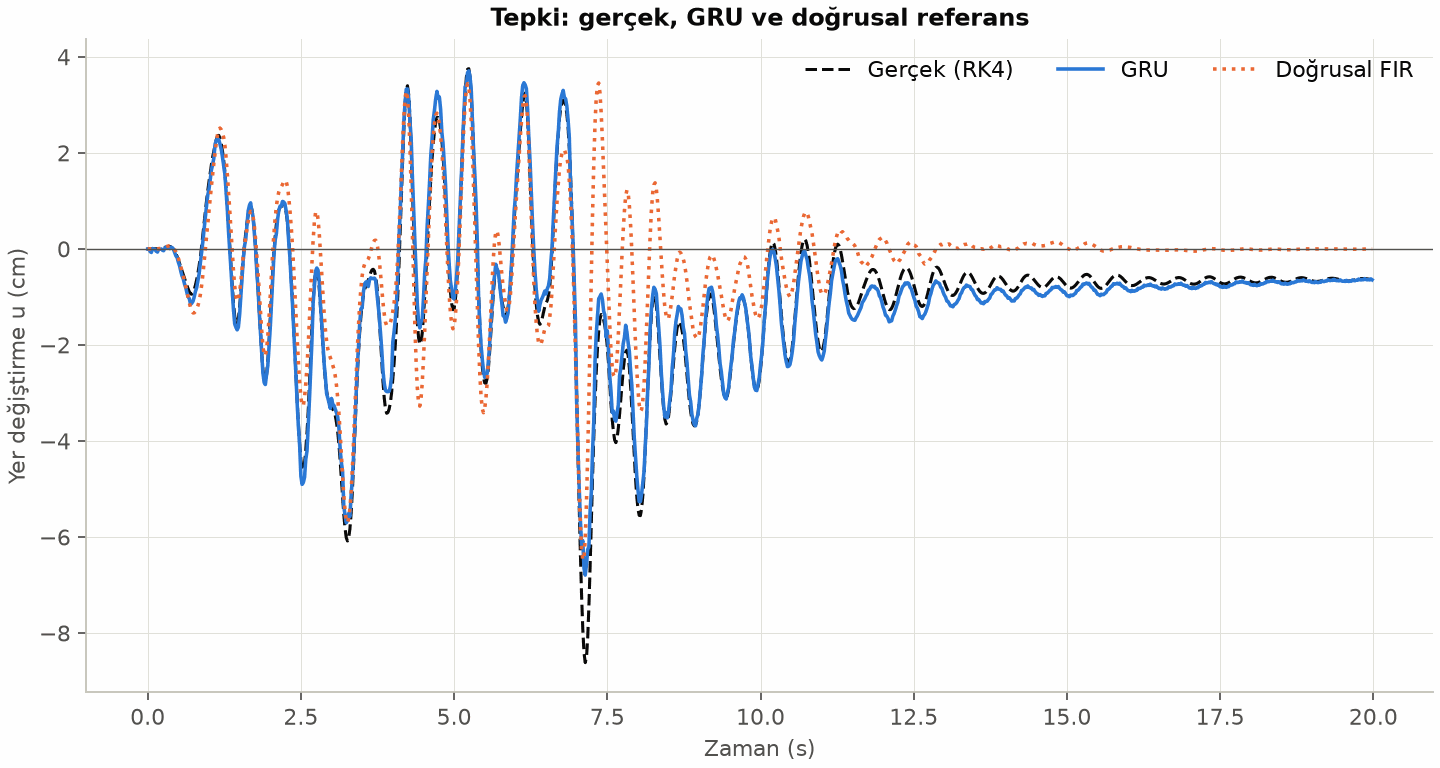
Şekillerdeki kayıt, testte PGA'sı en büyük olan kayıt; GRU için tipik bir örnek: NRMSE'si 0,136, 40 test kaydı arasında büyükten küçüğe 23. sırada (en kötüsü 0,305). Histerezis döngüleri sistemin iki yönde de aktığını gösteriyor; en büyük yer değiştirme 8,62 cm. GRU tahmini fazı baştan sona koruyor ve kayıt sonundaki kalıcı yer değiştirmeyi buluyor: gerçek –0,64 cm, tahmin –0,66 cm. Hatası en büyük tepede yoğunlaşıyor: gerçek 8,62 cm, GRU 6,79 cm. Doğrusal model tepeyi 6,48 cm buluyor, ama asıl sorunu başka: ilk saniyelerde, sistem henüz elastikken iyi gidiyor; akma başladıktan sonra hem genliği hem fazı kaçırıyor ve hareket bitince sıfıra dönüyor.
| Model | NRMSE medyanı | PGA < 0,25 g | PGA ≥ 0,25 g | Tepe hatası (ort. mutlak) | Kalıcı y.d. hatası |
|---|---|---|---|---|---|
| Doğrusal FIR | 0,572 | 0,625 | 0,517 | %13,5 | 0,29 cm |
| GRU | 0,138 | 0,159 | 0,138 | %6,7 | 0,10 cm |
GRU'nun NRMSE medyanı 0,138, doğrusal modelinki 0,572. Dikkat çekici bir ayrıntı var: doğrusal model zayıf kayıtlarda (PGA < 0,25 g) kuvvetli kayıtlardan bile kötü. En küçük kareler, büyük genlikli kayıtların hatalarını daha çok önemsediği için, akan sisteme benzeyen “eşdeğer doğrusal” bir sistem öğreniyor: daha yumuşak ve daha sönümlü. Bu sistem neredeyse elastik kalan zayıf kayıtlara uymuyor. Tek bir doğrusal model iki rejimi birden temsil edemez.
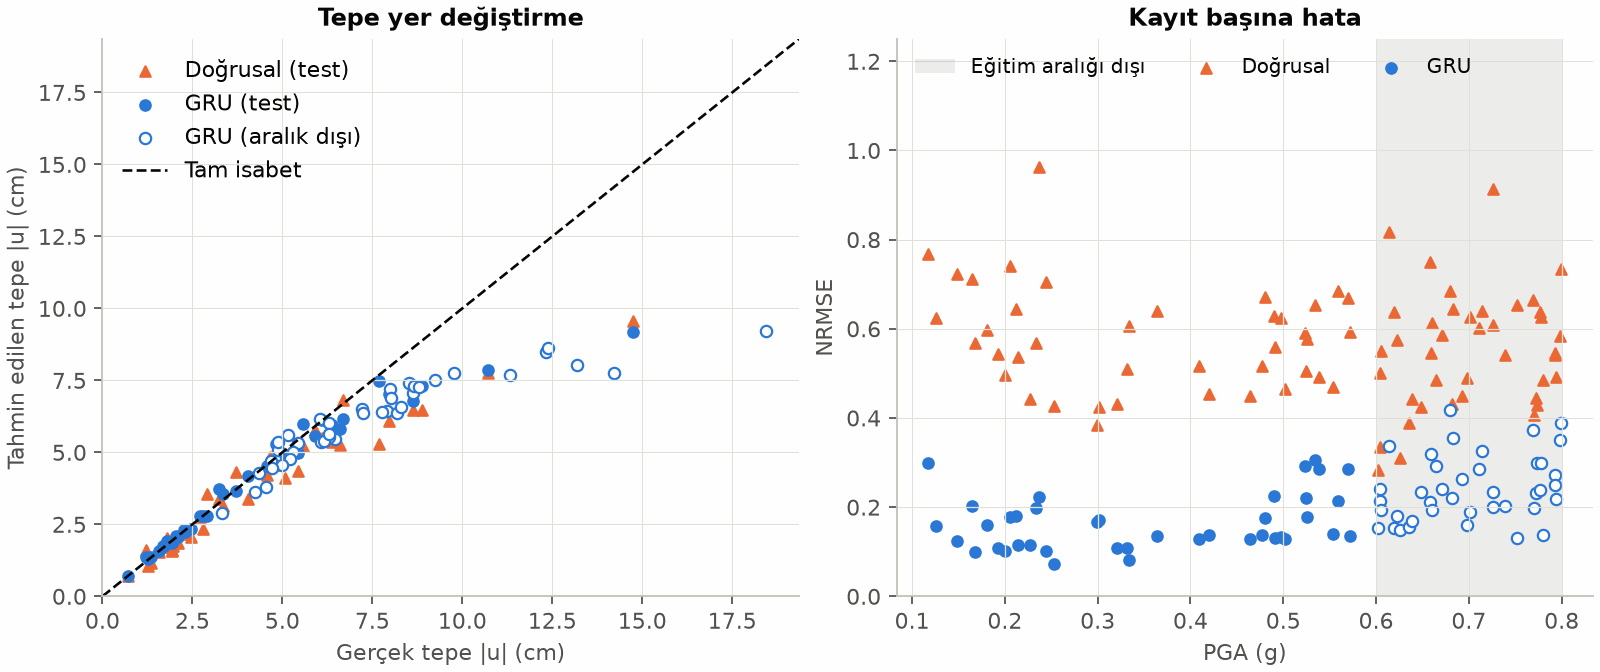
Tepe yer değiştirmede GRU'nun ortalama mutlak hatası %6,7. Ama sol grafik önemli bir ayrıntı gösteriyor: hatanın işareti rastgele değil. Büyük tepelerde GRU sistematik olarak eksik tahmin ediyor. Testteki en büyük tepe 14,7 cm; GRU bunu 9,2 cm buluyor (bu kayıttaki NRMSE'si 0,292), doğrusal model (9,6 cm) bile biraz daha yakın. Bunun iki nedeni var. Eğitim verisinde bu büyüklükte tepeler azdır, model onları “ortalamaya çeker”. Ayrıca GRU'nun gizli durumu $\tanh$ ve kapılar yüzünden $(-1, 1)$ aralığında kalır; çıkış katmanı doğrusal olduğu için üretilebilecek en büyük değer ağırlıklarla sınırlıdır. Ağ, eğitimde gerekmeyen büyüklükleri üretmeyi öğrenmez.
Bu eğilim eğitim aralığı dışında belirginleşiyor. PGA'sı 0,6–0,8 g olan kayıtlarda süneklik medyanı 3,42; (eğitim kayıtlarında 1,57). Bu kayıtlarda GRU'nun NRMSE medyanı 0,233'e çıkıyor ve tepeleri ortalama %14,3 eksik tahmin ediyor. Aralık dışındaki en büyük gerçek tepe 18,4 cm; GRU bu kayıtta 9,2 cm buluyor ve bütün aralık dışı kayıtlarda verdiği en büyük tepe de bu. Ağ, görmediği büyüklükte bir yer değiştirmeyi üretmeyi öğrenmedi. Doğrusal modelin tepe hatası da –%17,0. Bu, Ders 07'de ağaçlarda gördüğümüz dış değer sorununun dizi modellerindeki karşılığıdır: model ne kadar iyi olursa olsun, eğitim dağılımının dışına çıkınca söylediklerine güvenmeyin.
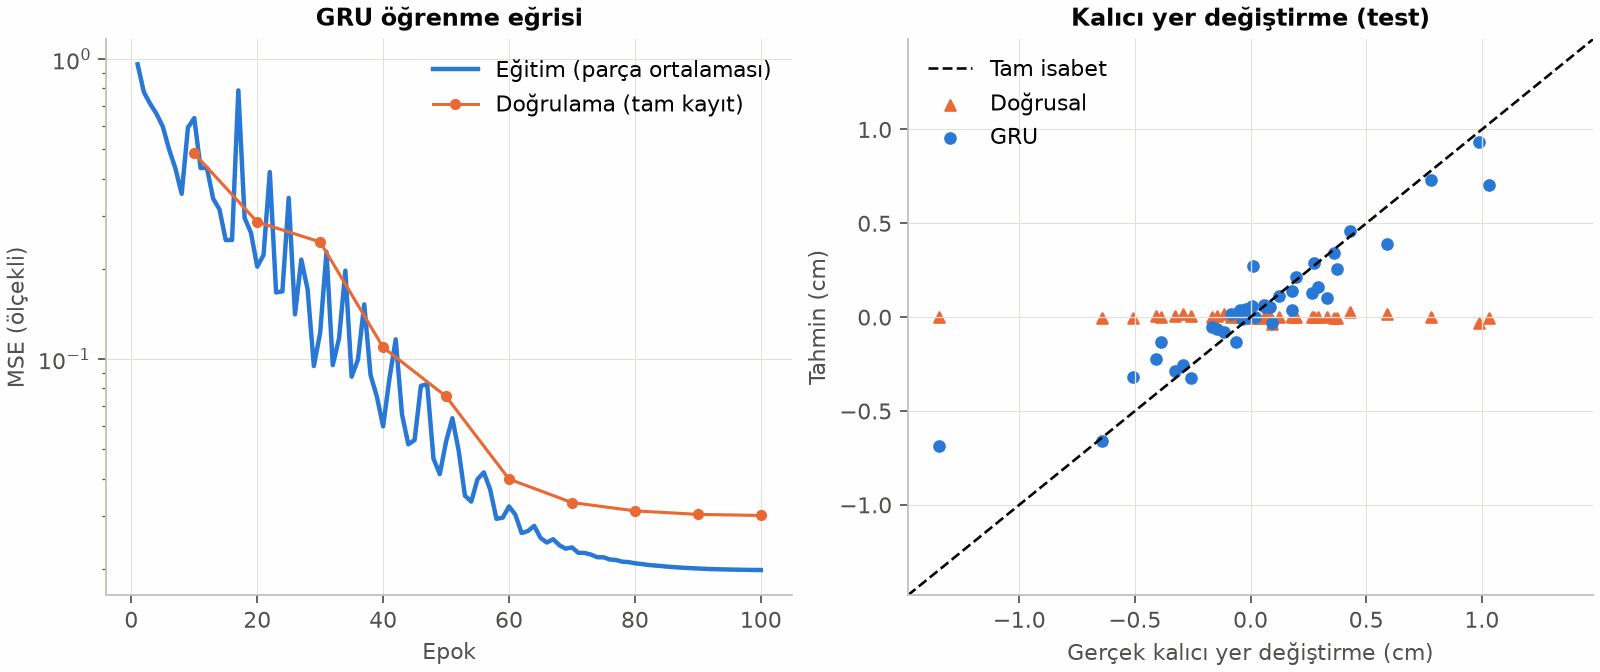
Öğrenme eğrisindeki sıçramalar, yüksek öğrenme hızının ilk epoklardaki bedeli. Kosinüs eğrisiyle öğrenme hızı düşünce kayıp düzgünleşiyor. Doğrulama kaybı eğitim kaybından biraz yüksek (0,0301'e karşı 0,0198), ama ikisi de son epoklarda yatay; belirgin bir aşırı uyum yok.
Kalıcı yer değiştirme bu problemin en “doğrusal olmayan” çıktısıdır ve iki model arasındaki farkı en açık gösteren yerdir. Doğrusal model her kayıtta sıfır veriyor. GRU tahminleriyle gerçek değerler arasındaki korelasyon 0,946, ortalama mutlak hata 0,10 cm (gerçek değerlerin ortalama büyüklüğü 0,29 cm). Bu sayı kaba bir mühendislik kararı için yeterli olabilir, ama ayrıntılı bir değerlendirme için değil.
9. Sık yapılan hatalar
- Zaman adımlarını rastgele bölmek. Aynı kaydın komşu örnekleri hem eğitimde hem testte olursa model ezberler ve test hatası anlamsız derecede küçük çıkar. Bölmeyi kayıt düzeyinde yapın (Ders 03'teki gruplu bölme).
- Gerçek geçmiş çıktıyla değerlendirmek. ARX modelleri ve bazı RNN eğitimleri bir sonraki adımı gerçek $u_{t-1}$'den tahmin eder. Kullanımda ise yalnızca ivme bilinir; model kendi tahminleriyle ilerlemek zorundadır. Bir adım ileri tahminde iyi olan model serbest çalıştırmada (free-run) hızla sapabilir. Değerlendirmeyi kullanımdaki gibi yapın.
- Nedenselliği unutmak. Çift yönlü RNN ya da maskesiz dikkat gelecekteki girdiyi de görür. Kayıt tamamen elde ise sorun olmayabilir, ama gerçek zamanlı bir uygulamada kullanılamaz.
- Ölçekleyiciyi bütün veriyle kurmak. Ortalama ve standart sapma yalnızca eğitim kayıtlarından hesaplanmalı; aksi hâlde test bilgisi modele sızar.
- Gradyanları izlememek. Kayıp aniden
nanoluyorsa patlayan gradyan ilk şüphelidir. Gradyan kırpma ve daha küçük bir öğrenme hızı genellikle yeter. - Eğitim aralığının dışında güvenmek. 0,6 g'ye kadar eğitilen model 0,6–0,8 g kayıtlarında tepeleri ortalama %14 eksik tahmin etti. Kullanım aralığını eğitim verisiyle sınırlayın ya da bu bölgeye veri ekleyin.
10. Alıştırmalar
Alıştırma 1KolayAlıcı alan
Çekirdek boyu 3 olan nedensel bir TCN'de genişletmeler 1, 2, 4, … diye ikiye katlanıyor. Alıcı alanın, dürtü tepkisi zarfının %5'e indiği süreyi ($3/(\zeta\omega)$) kapsaması için en az kaç katman gerekir? $\Delta t = 0{,}02$ s.
Çözümü göster
Zarfın %5'e inmesi $e^{-3} \approx 0{,}05$'ten $t = 3/(\zeta\omega) = 4{,}775$ s, yani 238,7 örnek demektir. $N$ katmanlı yapıda alıcı alan $R = 1 + 2(2^N - 1)$: 6 katmanla 127 örnek (2,54 s), 7 katmanla 255 örnek (5,10 s). En az 7 katman gerekir.
Her yeni katman alıcı alanı iki katına çıkarır; uzun hafızayı az parametreyle kazanmanın yolu budur. Ama alıcı alanın dışı model için hiç yoktur: hafıza süresini bilmiyorsanız ya da kalıcı yer değiştirme gibi süresiz bir hafıza varsa, durum taşıyan bir model daha doğal bir seçimdir.
Alıştırma 2KolayKaybolan gradyan, sayılarla
Skaler doğrusal bir RNN düşünün: $h_t = w\,h_{t-1} + x_t$. $\partial h_T/\partial h_0$ nedir? $w = 0{,}95$ ve $w = 1{,}05$ için $T = 200$ (bizim GRU'nun adım sayısı) ve $T = 1000$ (çerçevesiz dizi) değerlerini hesaplayın.
Çözümü göster
$h_T = w^T h_0 + \sum_{t=1}^{T} w^{T-t} x_t$ olduğundan $\partial h_T/\partial h_0 = w^T$.
- $w = 0{,}95$: $T = 200$ için $3{,}5\times10^{-5}$, $T = 1000$ için $5{,}3\times10^{-23}$.
- $w = 1{,}05$: $T = 200$ için $1{,}7\times10^{4}$, $T = 1000$ için $1{,}5\times10^{21}$.
1'den yalnızca %5 sapan bir çarpan, 1.000 adımda gradyanı ya yok ediyor ya da 21 mertebe büyütüyor. Bu derste kullandığımız çerçeve hilesi (5 örnek → 1 adım) dizinin boyunu 5 kat kısaltarak bu sorunu da hafifletir.
Alıştırma 3OrtaFIR penceresi
Doğrusal referansta pencereyi $L = 250$ yerine $L = 50$ örnek (1 s) yapın ve modeli doğrusal elastik sistemin ($\alpha = 1$) verisiyle eğitin. Test NRMSE'si nasıl değişir? Neden?
Çözümü göster
Doğrusal sistemde test NRMSE medyanı $L = 50$ ile 0,532, $L = 100$ ile 0,284, $L = 250$ ile 0,043. Bu sayılar, dürtü tepkisinin pencere sonundaki zarfına, $e^{-\zeta\omega L\Delta t}$'ye neredeyse eşit: 0,533, 0,285 ve 0,043.
Bu bir tesadüf değil. Az sönümlü bir sistemde dürtü tepkisinin pencere dışında kalan kuyruğu, kendisinin $e^{-\zeta\omega L\Delta t}$ ile küçültülmüş ve faz kaydırılmış bir kopyasıdır. Pencere dışında kalan geçmiş girdiler, penceredekilerle neredeyse ilişkisiz olduğu için regresyon bu kaybı başka ağırlıklarla telafi edemez. Ders: FIR penceresi sistemin hafıza süresinin birkaç katı olmalı. 50 örnek (1 s) burada zaman sabitinden (1,59 s) bile kısa.
Alıştırma 4OrtaDaha küçük bir GRU
Gizli boyutu 64'ten 16'ya indirin ve modeli yeniden eğitin. Parametre sayısı, test NRMSE'si, tepe hatası ve aralık dışı NRMSE nasıl değişiyor?
Çözümü göster
Parametre sayısı 13.957'den 1.189'a iniyor. Test NRMSE medyanı 0,138'den 0,219'a, ortalama mutlak tepe hatası %6,7'den %10,9'a çıkıyor; kalıcı yer değiştirme hatası 0,16 cm (64 nöronla 0,10 cm). Eğitim aralığı dışında NRMSE medyanı 0,316, tepe hatası ortalaması –%22,9; aralık dışı kayıtlarda verdiği en büyük tepe 7,1 cm.
Küçük model de doğrusal referanstan (0,572) çok daha iyi, ama kapasitesi özellikle büyük genlikleri temsil etmeye yetmiyor. Gizli boyutu büyütmek ise her adımın maliyetini artırır; hangi boyutun yeterli olduğuna doğrulama kayıtlarıyla karar verin.
Alıştırma 5ZorDoğrusal yapı, doğrusal bir RNN'dir
Doğrusal tek serbestlik dereceli sistemin ($\alpha = 1$) serbest titreşimi $u(t) = e^{-\zeta\omega t}(C_1\cos\omega_d t + C_2\sin\omega_d t)$ biçimindedir, $\omega_d = \omega\sqrt{1-\zeta^2}$. Örnekleme aralığı $\Delta$ ise girdisiz kısımda $u_{k+1} = a_1 u_k + a_2 u_{k-1}$ olduğunu gösterin ve $a_1$, $a_2$'yi bulun. Sonra betiğin ürettiği doğrusal tepkilerde $u_{k+1}$'i $u_k$, $u_{k-1}$ ve son üç ivme örneğine regresyonla bağlayıp bulduğunuz katsayıları karşılaştırın.
Çözümü göster
Girdisiz kısımda $u_k = \rho^k (C_1\cos k\theta + C_2\sin k\theta)$; burada $\rho = e^{-\zeta\omega\Delta}$, $\theta = \omega_d\Delta$. Kosinüs için (sinüs için de aynı biçimde) şu özdeşlik geçerlidir:
$$ \begin{aligned} &\cos(k+1)\theta + \cos(k-1)\theta \\ &\qquad = 2\cos\theta\cos k\theta \end{aligned} $$Bunu $u_{k+1}$ ve $u_{k-1}$'e uygulayınca:
$$ u_{k+1} = 2\rho\cos\theta\; u_k - \rho^2\, u_{k-1} $$Yani $a_1 = 2e^{-\zeta\omega\Delta}\cos(\omega_d\Delta) = 1{,}913130$ ve $a_2 = -e^{-2\zeta\omega\Delta} = -0{,}975180$. Doğrusal tepkilerde $u_{k+1}$'i $u_k$, $u_{k-1}$ ve $a_{g,k+1}$, $a_{g,k}$, $a_{g,k-1}$'e bağlayan regresyon aynı katsayıları altı basamağa kadar buluyor; artığın RMS'i tepkinin RMS'inin $1{,}15\times10^{-14}$'ü, yani yalnızca yuvarlama hatası. Doğrusal yapı, iki boyutlu bir durumu ($u_k$, $u_{k-1}$) olan doğrusal bir yinelemeli modeldir ve bütün davranışı beş katsayıda saklıdır.
Aynı regresyonu Bouc–Wen verisine uygulayınca $a_1 = 1{,}887757$, $a_2 = -0{,}911146$ çıkıyor: daha sönümlü, “eşdeğer” bir doğrusal sistem. Bu model test kayıtlarında bir adım ileri tahminde (gerçek $u_k$ ve $u_{k-1}$ verilerek) 0,0240 gibi etkileyici bir NRMSE medyanı veriyor. Kendi tahminleriyle ilerletilince (serbest çalıştırma) ise NRMSE medyanı 0,938'e fırlıyor. Sık yapılan hatalar bölümündeki uyarının sayısal karşılığı budur.
Özet
- Dizi problemlerinde çıktı, girdinin geçmişine bağlıdır. Doğrusal sistemlerde bu bağ bir evrişimdir ve gecikmeli girdilere doğrusal regresyon (FIR) yeterlidir; histerezisi ve kalıcı yer değiştirmeyi ise hiçbir doğrusal model üretemez.
- RNN geçmişi bir durum vektöründe taşır ve zamanda geri yayılımla eğitilir. Uzun dizilerde gradyan kaybolur ya da patlar; kırpma, kesik BPTT ve kapılı hücreler (LSTM, GRU) bunun çareleridir.
- TCN geçmişe sabit bir alıcı alanla, dikkat ise bütün diziye doğrudan bakar; ikisi de paralel eğitilir, ama dikkatin bedeli dizi uzunluğuyla karesel büyür.
- GRU, Bouc–Wen sisteminde doğrusal referansın NRMSE'sini 0,572'den 0,138'e indirdi ve kalıcı yer değiştirmeyi yakaladı; eğitim aralığı dışında ise tepeleri sistematik olarak eksik tahmin etti.
Bu derste modelin tahminine ne kadar güvenebileceğimizi yalnızca test hatasıyla ölçtük. Sonraki derste her tahminin yanına kendi belirsizliğini koyan bir yöntemle çalışacağız: Gauss süreçleri.
Kaynaklar
- I. Goodfellow, Y. Bengio, A. Courville — Deep Learning, MIT Press, 2016, Bölüm 10 (dizi modellemesi: yinelemeli ve özyinelemeli ağlar).
- S. Hochreiter, J. Schmidhuber — “Long Short-Term Memory”, Neural Computation, 9(8), 1997; K. Cho vd. — “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation”, EMNLP 2014.
- A. Vaswani vd. — “Attention Is All You Need”, NeurIPS 2017, arXiv:1706.03762; S. Bai, J. Z. Kolter, V. Koltun — “An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling”, arXiv:1803.01271.
- M. Ismail, F. Ikhouane, J. Rodellar — “The Hysteresis Bouc–Wen Model, a Survey”, Archives of Computational Methods in Engineering, 16, 2009; PyTorch nn.GRU belgesi.