Bu derste öğrenecekleriniz
- Rastlantısal ve epistemik belirsizliği ayırt etmek
- Gauss süreci regresyonunu Cholesky ayrışımıyla sıfırdan yazmak ve scikit-learn ile doğrulamak
- Çekirdek ve hiperparametrelerin etkisini marjinal olabilirlikle yorumlamak
- AK-MCS ile az sayıda fonksiyon çağrısıyla göçme olasılığı hesaplamak
- Kantil regresyon, bölünmüş uyumlu tahmin ve CQR aralıklarının kapsamasını ölçmek
1. Neden belirsizlik?
Bir vekil model “bu noktada dinamik büyütme 1,95” dediğinde mühendis için asıl soru şudur: Buna ne kadar güvenebilirim? Aynı tahmin, çevresinde on simülasyon varken başka, en yakın simülasyon uzaktayken başka bir anlam taşır. Birinci durumda değeri tasarımda kullanırız. İkincisinde önce bir simülasyon daha çalıştırırız.
Mühendislik kararları zaten belirsizlik üzerine kuruludur. Karakteristik dayanım bir dağılımın %5'lik alt değeridir, güvenlik katsayıları da belirsizliği karşılamak için vardır. Bu yüzden bir makine öğrenmesi modelinden yalnızca tek bir sayı değil, o sayının ne kadar oynayabileceğini de isteriz. Belirsizliğin iki kaynağını ayırmak işe yarar:
- Rastlantısal belirsizlik (aleatoric uncertainty): olgunun kendi saçılımı. Aynı gerilmede test edilen iki numunenin yorulma ömrü farklıdır, yıllık en büyük rüzgâr hızı yıldan yıla değişir. Daha çok veri toplamak bu saçılımı azaltmaz, yalnızca daha iyi ölçer.
- Epistemik belirsizlik (epistemic uncertainty): bilgi eksikliği. Az sayıda simülasyon, hiç veri görmediğimiz bir bölge ya da emin olmadığımız bir model biçimi. Veri arttıkça azalır.
Bu derste üç araç kuracağız. Gauss süreçleri (Gaussian process, GP), az veriyle çalışan ve epistemik belirsizliği doğal olarak veren bir regresyon yöntemidir. AK-MCS, bu belirsizliği kullanarak pahalı bir modeli yalnızca gereken yerde çalıştıran bir güvenilirlik yöntemidir. Uyumlu tahmin (conformal prediction) ise herhangi bir modelin çevresine, dağılım varsayımı yapmadan kapsama güvencesi olan aralıklar çizer. Üç örneğin verisi de sentetiktir ve betik içinde üretilir.
2. Fonksiyonlar üzerinde bir dağılım
Şimdiye kadarki derslerde tek bir fonksiyon seçip parametrelerini veriye uydurduk. Gauss süreci başka bir yoldan gider: olası bütün fonksiyonlar üzerine bir olasılık dağılımı koyar, sonra gözlemlerle uyumlu olmayan fonksiyonları eler. Geriye kalan fonksiyonların ortalaması tahmindir, yayılımı da belirsizliktir.
Gauss süreci
$f(x)$ bir Gauss sürecidir, $f \sim \mathcal{GP}(m, k)$, eğer herhangi sonlu sayıda noktadaki değerleri $[f(x_1), \dots, f(x_n)]$ ortak (çok değişkenli) normal dağılıma uyuyorsa. Dağılımın ortalaması $m(x_i)$, kovaryans matrisi ise $K_{ij} = k(x_i, x_j)$'dir. $k$'ye çekirdek (kernel) ya da kovaryans fonksiyonu denir.
Çekirdek, fonksiyon hakkındaki önsel (prior) inancımızı taşır: birbirine yakın iki girdinin çıktıları da benzer olmalıdır. En yaygın seçim kare üstel (RBF) çekirdektir:
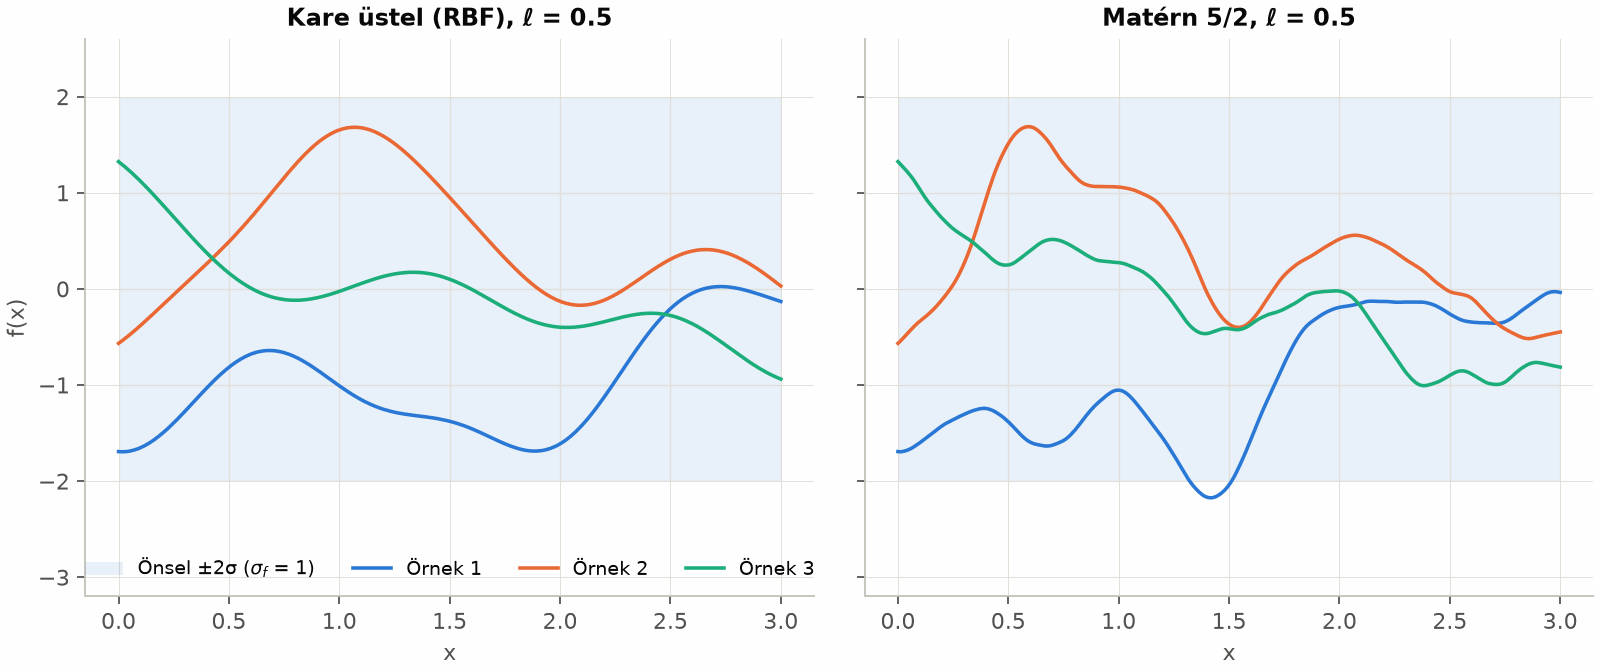
$$ k(x, x') = \sigma_f^2 \exp\!\left(-\frac{(x - x')^2}{2\ell^2}\right) $$$\sigma_f$ sinyal genliğidir: fonksiyonun ortalamadan tipik sapması. $\ell$ uzunluk ölçeğidir: iki nokta arasındaki ilişkinin ne kadar uzağa uzandığı. $|x - x'| = \ell$ olduğunda korelasyon $e^{-1/2} \approx 0{,}61$'e, $3\ell$ uzaklıkta ise neredeyse sıfıra iner. Kare üstel çekirdekten çekilen fonksiyonlar sonsuz kez türevlenebilir, yani çok düzgündür. Fiziksel tepkiler çoğu zaman bu kadar düzgün değildir. Bu yüzden Matérn 5/2 çekirdeği de sık kullanılır ($r = |x - x'|$):
$$ \begin{aligned} k(r) = \sigma_f^2 &\left(1 + \frac{\sqrt5\, r}{\ell} + \frac{5r^2}{3\ell^2}\right) \\ &\times \exp\!\left(-\frac{\sqrt5\, r}{\ell}\right) \end{aligned} $$Matérn 5/2 sürecinin örnekleri iki kez türevlenebilir. Aşağıdaki şekilde iki çekirdekten de, hiçbir veri görmeden, üçer fonksiyon çektik. Bunun için kovaryans matrisinin Cholesky ayrışımını $K = LL^\top$ alıp standart normal bir $\vect z$ vektörünü $L$ ile çarpmak yeter: $\vect f = L\vect z$'nin kovaryansı $L\,I\,L^\top = K$'dir.
Her fonksiyon çekirdek olamaz: bütün nokta kümeleri için $K$ pozitif yarı tanımlı olmalıdır. Pratikte, özellikle kare üstel çekirdekte, yakın noktalar $K$'yi neredeyse tekil yapar. Bu yüzden köşegene $10^{-8}$ gibi küçük bir sayı (jitter) eklenir. Gözlem gürültüsü varsa bu rolü $\sigma_n^2$ zaten üstlenir.
3. Gözlemlerden sonra: sonsal dağılım
Gözlemlerimiz gürültülü olsun: $y_i = f(x_i) + \varepsilon_i$, $\varepsilon_i \sim \mathcal N(0, \sigma_n^2)$. Eğitim noktalarındaki gözlemler $\vect y$ ile tahmin noktalarındaki değerler $\vect f_*$ birlikte normal dağılır. $K = k(X, X)$, $K_* = k(X, X_*)$ ve $K_{**} = k(X_*, X_*)$ yazarsak:
$$ \begin{bmatrix} \vect y \\ \vect f_* \end{bmatrix} \sim \mathcal N\!\left(\vect 0,\ \begin{bmatrix} K + \sigma_n^2 I & K_* \\ K_*^\top & K_{**} \end{bmatrix}\right) $$Normal dağılımın bir parçası verildiğinde geri kalanı da normaldir. Bu koşullu dağılım, GP regresyonunun bütün sonucudur:
$$ \vect\mu_* = K_*^\top \left(K + \sigma_n^2 I\right)^{-1} \vect y $$ $$ \Sigma_* = K_{**} - K_*^\top \left(K + \sigma_n^2 I\right)^{-1} K_* $$Koşullu normal dağılım
$\vect a$ ve $\vect b$ birlikte normal olsun: ortalamalar $\vect\mu_a$, $\vect\mu_b$; kovaryans blokları $A = \mathrm{Cov}(\vect a)$, $B = \mathrm{Cov}(\vect b)$, $C = \mathrm{Cov}(\vect a, \vect b)$. $\vect b - C^\top A^{-1}\vect a$ vektörünün $\vect a$ ile kovaryansı $C^\top - C^\top A^{-1} A = 0$'dır. Normal dağılımda ilişkisizlik bağımsızlık demektir, dolayısıyla bu vektör $\vect a$'dan bağımsızdır. Şimdi $\vect b = (\vect b - C^\top A^{-1}\vect a) + C^\top A^{-1}\vect a$ yazalım. $\vect a$ verildiğinde ilk parçanın dağılımı değişmez, ikinci parça ise sabittir. Ortalamayı ve kovaryansı ayrı ayrı hesaplayınca
$$ \E[\vect b \mid \vect a] = \vect\mu_b + C^\top A^{-1}(\vect a - \vect\mu_a) $$ $$ \mathrm{Cov}[\vect b \mid \vect a] = B - C^\top A^{-1} C $$çıkar. $\vect a = \vect y$, $\vect b = \vect f_*$, $A = K + \sigma_n^2 I$, $C = K_*$, $B = K_{**}$ ve sıfır ortalama koyunca yukarıdaki iki formül elde edilir.
İki formülün okunuşu öğreticidir. Sonsal ortalama, gözlemlerin ağırlıklı bir toplamıdır; ağırlıkları çekirdek belirler. Sonsal varyans ise önsel varyanstan, gözlemlerin getirdiği bilgi çıkarılarak bulunur. Varyans formülünde $\vect y$ yoktur: belirsizlik yalnızca gözlemlerin nerede yapıldığına bağlıdır, ne çıktığına bağlı değildir (hiperparametreler sabitken). Bu özellik, bir sonraki simülasyonun yerini çalıştırmadan önce seçebilmemizi sağlar.
Formüldeki ters matrisi hiçbir zaman açıkça hesaplamayız. $K_y = K + \sigma_n^2 I$ simetrik ve pozitif tanımlı olduğu için Cholesky ayrışımı $K_y = LL^\top$ hem en hızlı hem de en kararlı yoldur. Rasmussen ve Williams'ın kitabındaki algoritma birkaç satırdır:
def gp_sonsal(x, y, xs, l, sf, sn, cekirdek=kare_ustel):
    K = cekirdek(x, x, l, sf) + sn**2 * np.eye(len(x))
    L = np.linalg.cholesky(K)                                     # K = L Lᵀ
    alfa = solve_triangular(L.T, solve_triangular(L, y, lower=True), lower=False)   # K⁻¹y
    Ks = cekirdek(x, xs, l, sf)
    mu = Ks.T @ alfa                                              # k*ᵀ K⁻¹ y
    v = solve_triangular(L, Ks, lower=True)
    var = sf**2 - np.sum(v**2, axis=0)                            # k(x*,x*) − k*ᵀ K⁻¹ k*
    lml = -0.5 * y @ alfa - np.sum(np.log(np.diag(L))) - 0.5 * len(x) * np.log(2 * np.pi)
    return mu, var, lml
scikit-learn'deki karşılığı GaussianProcessRegressor'dır. Aynı çekirdek ve aynı hiperparametrelerle iki uygulama makine hassasiyetinde aynı sonucu verir; betik bunu assert ile denetler.
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF, ConstantKernel

cek = ConstantKernel(1.0, (1e-4, 1e4)) * RBF(1.0, (1e-2, 1e2))   # σ_f² · RBF(ℓ)
gp = GaussianProcessRegressor(cek, alpha=SN**2, n_restarts_optimizer=10, random_state=42)
gp.fit(x[:, None], yc)
ort, std = gp.predict(xs[:, None], return_std=True)scikit-learn'de gürültüyü iki yoldan verebilirsiniz. alpha=σ_n² yalnızca eğitimde köşegene eklenir; predict'in döndürdüğü std gürültüsüz $f_*$'ın belirsizliğidir. Gürültüyü WhiteKernel ile çekirdeğe koyarsanız döndürülen std gürültüyü de içerir, yani yeni bir ölçümün belirsizliğidir. İkisini karıştırmak, bandı ya fazla dar ya fazla geniş okumaya yol açar.
4. Hiperparametreler ve marjinal olabilirlik
$\ell$, $\sigma_f$ ve $\sigma_n$'yi nasıl seçeceğiz? Çapraz doğrulama kullanılabilir, ama GP daha doğal bir ölçüt sunar: verinin, modelin bütün olası fonksiyonları üzerinden ortalanmış olasılığı. Buna marjinal olabilirlik denir ve kapalı biçimde yazılabilir ($\vect\theta$: hiperparametreler):
$$ \begin{aligned} \log p(\vect y \mid X, \vect\theta) = &-\tfrac12\, \vect y^\top K_y^{-1}\vect y \\ &- \tfrac12 \log\lvert K_y\rvert - \tfrac{n}{2}\log 2\pi \end{aligned} $$Birinci terim veri uyumudur: model gözlemleri ne kadar iyi açıklıyor. İkinci terim karmaşıklık cezasıdır: kısa uzunluk ölçekli, her şeye uyabilen bir model geniş bir fonksiyon ailesine olasılık dağıttığı için $\log\lvert K_y\rvert$ üzerinden cezalandırılır. Üçüncüsü sabittir. Böylece marjinal olabilirlik, ayrı bir doğrulama kümesine gerek kalmadan, veriye uyan ama gereğinden karmaşık olmayan modeli seçer. Cholesky ile $\tfrac12\log\lvert K_y\rvert = \sum_i \log L_{ii}$ olur; koddaki lml satırı tam olarak bu formüldür.
Hiperparametreleri pozitif tutmak için logaritmalarını en iyileriz ve L-BFGS-B'yi birkaç farklı başlangıç noktasından çalıştırırız; olabilirlik yüzeyinde birden fazla yerel tepe olabilir. Örnek A'da simülasyon gürültüsünü bildiğimizi varsayıp $\sigma_n = 0{,}05$'i sabit tutacak, $\ell$ ile $\sigma_f$'yi veriden bulacağız. Sekiz noktayla gürültüyü sinyalden ayırmak zordur; bildiğiniz bir ölçüm hassasiyeti varsa onu kullanmak daha güvenlidir.
Kriging: aynı yöntemin jeoistatistikteki adı
1950'lerde Güney Afrikalı maden mühendisi D. G. Krige, sondaj örneklerinden altın tenörünü kestirmek için yakın örneklere ağırlık veren bir yöntem geliştirdi. 1960'larda G. Matheron yöntemi kuramsal olarak kurdu ve adını “kriging” koydu. GP regresyonu ile kriging aynı tahmincidir. Jeoistatistikçiler kovaryans yerine variogram ile çalışır: durağan bir süreçte $\gamma(h) = k(0) - k(h)$. Variogramın sıfırdaki sıçraması (nugget), bizim $\sigma_n^2$ dediğimiz gürültüdür. Sıradan kriging (ordinary kriging) sabit ortalamayı da veriden kestirir; biz örneklerde ortalamayı basitçe örneklem ortalaması olarak çıkardık.
GP'nin bedeli hesap maliyetidir. Cholesky ayrışımı yaklaşık $n^3/3$ işlem, $K$'yi saklamak $n^2$ bellek ister. Birkaç bin noktaya kadar sorun yoktur. $n = 10^5$ olduğunda yalnızca $K$ matrisi 80 GB tutar. Büyük veri için seyrek (indüklenen nokta) yaklaşımları ya da bölgesel modeller kullanılır. Mühendislikte GP'nin parladığı yer ise zaten tam tersidir: her noktası pahalı, sayısı az veri.
Girdi birden çok boyutluysa her boyuta ayrı bir uzunluk ölçeği verilebilir: $\exp\!\big(-\tfrac12\sum_d (x_d - x'_d)^2/\ell_d^2\big)$. Büyük $\ell_d$, çıktının o girdiye az bağlı olduğunu söyler. Örnek B'deki vekil model bu biçimi kullanıyor.
Kendiniz deneyin
Aşağıdaki denemede GP regresyonu tarayıcıda, bu derstekiyle aynı formüllerle hesaplanır. Grafiğe tıklayarak gözlem ekleyin ya da Örnek noktalar düğmesiyle hazır bir küme yükleyin. Mavi çizgi sonsal ortalama, açık mavi bant $\pm 2\sigma$ aralığıdır; okuma kutusunda log marjinal olabilirliği izleyin.
- Uzunluk ölçeği ℓ'yi 0,1'den 5'e kaydırın. Kısa $\ell$'de ortalama noktalar arasında sıfıra geri döner ve bant şişer; uzun $\ell$'de eğri noktaları ıskalar. Log marjinal olabilirlik hangi değerde en büyük?
- İki gözlem arasındaki boşluğa tıklayıp nokta ekleyin; bandın yalnızca o çevrede daraldığına bakın.
- Gürültü σ_n'yi 0,001'e indirin ve 1'e çıkarın: model noktalardan geçmeye zorlanır ya da noktaları gürültü sayar.
- Çekirdeği kare üstelden Matérn 5/2'ye çevirin ve Sonsal örnek fonksiyonlar kutusunu açın; örneklerin pürüzlülüğünü karşılaştırın. Sonra Hiperparametreleri en iyile düğmesine basın.
Bu etkileşimli deneme için tarayıcıda JavaScript açık olmalıdır.
5. Güvenilirlik analizi ve aktif öğrenme
Yapısal güvenilirlikte bir sınır durum fonksiyonu (limit state function) tanımlanır: $g(\vect X) = R - S$. $R$ dayanım, $S$ yük etkisidir; $g \le 0$ göçme demektir. Göçme olasılığı $P_f = P(g(\vect X) \le 0)$, bütün rastgele değişkenlerin ortak dağılımı üzerinden alınan bir integraldir ve genellikle kapalı biçimde hesaplanamaz.
Örnek B'de bir cephe panelini ele alıyoruz. $R$, panelin taşıyabildiği rüzgâr basıncıdır: lognormal, ortalaması 2,0 kPa, değişim katsayısı 0,15. $V$, yıllık en büyük rüzgâr hızıdır: Gumbel dağılımlı, ortalaması 25 m/s, değişim katsayısı 0,20. Yük etkisi rüzgâr hızının karesiyle büyür:
$$ g(R, V) = R - \tfrac12\,\rho\, c\, V^2 $$Burada $\rho = 1{,}25$ kg/m³ hava yoğunluğu, $c = 1{,}3$ basınç ve esinti etkilerini toplayan bir katsayıdır. Değerler eğitim amaçlıdır; bir yönetmeliğin rüzgâr hesabı değildir. İki değişkenli bu problemde $P_f$'yi tek boyutlu bir integralle kesin olarak da bulabiliyoruz, $P_f = \int F_R\big(\tfrac12\rho c v^2\big)\, f_V(v)\,\dd v$. Bu kesin değer, yöntemleri sınamak için elimizde bir ölçüt olacak.
Monte Carlo ve maliyeti
En genel yöntem Monte Carlo'dur: $N$ örnek çekilir, $P_f \approx \frac1N\sum_i \mathbb 1[g(\vect x_i) \le 0]$. Tahminin değişim katsayısı
$$ \mathrm{CoV} = \sqrt{\frac{1 - P_f}{N\,P_f}} $$olduğundan küçük olasılıklar çok örnek ister. $P_f \approx 10^{-3}$ için $10^6$ örnekle değişim katsayısı yaklaşık %3'tür (örneğimizdeki $P_f \approx 1{,}6\times10^{-3}$ için %2,5). $g$ bir satırlık bir formülse sorun yoktur. Ama her $g$ çağrısı bir saatlik bir sonlu eleman çözümüyse $10^6$ çağrı yüz yılı aşar.
AK-MCS: belirsizliği kullanarak örnek seçmek
Echard, Gayton ve Lemaire'in (2011) AK-MCS yöntemi, Monte Carlo örneklerini korur ama $g$'yi her birinde çalıştırmaz. $g$ yerine bir GP vekil modeli kullanır ve gerçek $g$'yi yalnızca vekilin kararsız kaldığı yerlerde çağırır. Ölçüt U fonksiyonudur:
$$ U(\vect x) = \frac{\lvert \mu(\vect x) \rvert}{\sigma(\vect x)} $$GP'ye göre $g(\vect x)$ normal dağılımlıdır, dolayısıyla işaretinin yanlış tahmin edilme olasılığı $\Phi(-U)$'dur. $U$'nun küçük olduğu yer ya sınıra yakındır ($\mu \approx 0$) ya da vekilin bilgisiz olduğu yerdir ($\sigma$ büyük). İkisi de tam olarak yeni bilgiye ihtiyaç duyduğumuz yerlerdir. Algoritma şöyledir:
- Monte Carlo kümesini çek ($10^6$ nokta). Gerçek $g$ henüz çağrılmadı.
- Küçük bir başlangıç tasarımında (12 noktalı Latin hiperküp) $g$'yi çalıştır ve GP'yi uydur.
- Bütün Monte Carlo noktalarında $\mu$, $\sigma$ ve $U$'yu hesapla.
- $\min U \ge 2$ ise dur. Değilse $U$'su en küçük noktada $g$'yi çalıştır, tasarıma ekle, GP'yi yeniden uydur ve 3. adıma dön.
- $P_f \approx \frac1N\sum_i \mathbb 1[\mu(\vect x_i) \le 0]$.
Durma ölçütündeki 2 sayısı, her noktada işaretin yanlış olma olasılığının $\Phi(-2) \approx 0{,}023$'ün altına inmesi demektir. GP'yi değişkenlerin fiziksel değerleri yerine standart normal uzayda kuruyoruz: $u_1 = (\ln R - \mu_{\ln R})/\sigma_{\ln R}$ ve $u_2 = \Phi^{-1}(F_V(V))$. Bu uzayda iki değişken de standart normaldir. Göçme olasılığı çoğu zaman güvenilirlik indeksiyle ifade edilir, $\beta = -\Phi^{-1}(P_f)$; sınır bu uzayda doğrusalsa $\beta$, sınırın merkeze en kısa uzaklığına eşittir. Echard ve arkadaşları öğrenme bittikten sonra $P_f$ tahmininin değişim katsayısına da bakar; yaklaşık %5'i aşarsa Monte Carlo kümesi büyütülür ve döngü sürdürülür. Bizim $10^6$ örneğimizde bu oran 0,025.
AK-MCS, Monte Carlo'nun istatistik hatasını küçültmez; yalnızca pahalı fonksiyonun çağrı sayısını küçültür. Vekil kusursuz olsa bile sonuç, aynı $10^6$ örnekle yapılmış Monte Carlo'nun değişim katsayısını taşır.
6. Başka belirsizlik araçları
GP her probleme uymaz: veri on binlerce satırsa ya da model zaten bir gradient boosting ise başka araçlar gerekir. Üç yaygın aracı, saçılımı gerilmeyle değişen sentetik bir yorulma (S–N) verisinde karşılaştıracağız. Veri $\log_{10} N = 12{,}4 - 3\log_{10} S + \varepsilon$ ile üretildi; $\varepsilon$'un standart sapması 320 MPa'da 0,08'den 80 MPa'da 0,38'e çıkıyor. Yorulma deneylerinde düşük gerilmede saçılımın büyümesi bilinen bir durumdur, ama buradaki sayılar gerçek bir deney serisinden alınmadı.
Bootstrap topluluğu
Eğitim verisinden yerine koyarak $B$ yeni küme çekilir, her birine bir model eğitilir (Ders 08'deki torbalama). Modellerin tahminleri arasındaki yayılım, ortalama tahminin belirsizliğini, yani epistemik belirsizliği ölçer. Tek tek ölçümlerin saçılımını içermez. Bunu sonuçlarda sayıyla göreceğiz.
Kantil regresyon
Ortalama yerine bir kantili (quantile) tahmin eden modeller kurulabilir. Bunun için kare hata yerine pinball kaybı küçültülür ($r = y - \hat y$, $\tau$: kantil düzeyi):
$$ \rho_\tau(r) = \max\big(\tau\, r,\ (\tau - 1)\, r\big) $$Bu kaybın beklenen değerini en küçük yapan sabit, dağılımın $\tau$ kantilidir. $\tau = 0{,}05$ ve $\tau = 0{,}95$ için iki model eğitilince %90'lık bir aralık elde edilir. scikit-learn'de GradientBoostingRegressor(loss="quantile", alpha=τ) bunu yapar. Aralığın genişliği girdiyle değişebilir, ama kapsamanın %90 olacağına dair bir güvence yoktur.
Uyumlu tahmin
Uyumlu tahmin, herhangi bir modelin çevresine kapsama güvencesi olan bir aralık koyar. En basit biçimi bölünmüş uyumlu tahmindir (split conformal):
- Modeli eğitim verisiyle eğit.
- Modelin hiç görmediği $n$ noktalık bir kalibrasyon kümesinde skorları hesapla: $s_i = \lvert y_i - \hat y(x_i)\rvert$.
- $k = \lceil (n+1)(1-\alpha)\rceil$ olmak üzere $k$'ıncı en küçük skoru $\hat q$ al.
- Yeni bir nokta için aralık: $[\hat y(x) - \hat q,\ \hat y(x) + \hat q]$.
Veri noktaları değiştirilebilir (exchangeable) olduğu sürece, örneğin bağımsız ve aynı dağılımdan geldiğinde, yeni bir gözlemin bu aralığa düşme olasılığı en az $1 - \alpha$'dır (olasılık hem kalibrasyon kümesinin hem yeni noktanın çekilişi üzerindendir). Skorlar arasında eşitlik yoksa en fazla $1 - \alpha + 1/(n+1)$'dir. Kanıt sıralamaya dayanır: yeni noktanın skoru, $n+1$ skor arasında her sıraya eşit olasılıkla düşer. Model biçimi, dağılım ya da gürültü hakkında hiçbir varsayım yoktur.
Güvencenin bir sınırı vardır: kapsama bütün girdiler üzerinden ortalamadır (marjinal), her $x$ için ayrı ayrı değil. Bölünmüş uyumlu aralığın genişliği her yerde $2\hat q$'dur. Saçılım değişiyorsa bir bölgede fazla, öbüründe az kapsar. Uyumlu kantil regresyon (CQR) bu sorunu büyük ölçüde hafifletir (koşullu kapsamayı yine de güvenceye almaz): skor olarak kantil aralığının dışına taşma miktarını kullanır, $E_i = \max\big(\hat q_{\text{alt}}(x_i) - y_i,\ y_i - \hat q_{\text{üst}}(x_i)\big)$, ve kantil aralığını $\hat Q$ kadar genişletir ya da daraltır. Aynı marjinal güvenceyi korur, genişliği ise girdiye göre uyarlanır.
k_sira = int(np.ceil((n_kal + 1) * (1 - ALFA)))                 # ⌈(n+1)(1−α)⌉. en küçük skor
skor = np.abs(y_kal - nokta.predict(x_kal[:, None]))           # bölünmüş uyumlu tahmin skoru
q_hat = np.sort(skor)[k_sira - 1]
E = np.maximum(q_alt.predict(x_kal[:, None]) - y_kal, y_kal - q_ust.predict(x_kal[:, None]))   # CQR skoru
Q_hat = np.sort(E)[k_sira - 1]
7. Çalıştırılabilir kod
Betik beş bölümden oluşur: çekirdekler ve sıfırdan GP, Örnek A, güvenilirlik ve AK-MCS (Örnek B), yorulma verisinde aralık yöntemleri (Örnek C) ve grafikler. AK-MCS her adımda $10^6$ noktada GP tahmini yaptığı için en uzun süren bölümdür; bütün betik iki çekirdekli bir bilgisayarda yaklaşık bir dakika sürüyor; sizde farklı olabilir.
"""Ders 15 — Gauss süreçleri ve belirsizlik.

Üç sentetik örnek:
  A) "Pahalı simülasyon": tek serbestlik dereceli bir sistemin dinamik büyütme katsayısı
     D(r) = 1/√((1−r²)² + (2ζr)²), ζ = 0,25. Fonksiyonu biliyoruz; her noktası saatler süren bir
     hesapmış gibi davranıp yalnız 8 gürültülü değerini (σ = 0,05) kullanıyoruz.
  B) Güvenilirlik: g = R − k·V². R: bir cephe panelinin taşıyabildiği rüzgâr basıncı (kPa, lognormal),
     V: yıllık en büyük rüzgâr hızı (m/s, Gumbel). Göçme olasılığı 10⁶ örnekli Monte Carlo, sayısal
     integral ve AK-MCS (GP vekil model + U fonksiyonu) ile. Katsayılar eğitim amaçlıdır; bir
     yönetmeliğin rüzgâr hesabı değildir.
  C) Yorulma deneyini andıran, saçılımı gerilmeyle değişen sentetik S–N verisi: kantil regresyon,
     bölünmüş uyumlu tahmin (split conformal), CQR ve bootstrap topluluğu; deneysel kapsama oranları.

Çalıştır:  python d15_gauss_surecleri.py
Gerekenler: numpy, scipy, scikit-learn, matplotlib  (Python 3.12+)
Süre: yaklaşık 1 dakika
Çıktılar: terminale sayılar, aynı klasöre dört PNG grafiği
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from scipy import integrate, stats
from scipy.linalg import solve_triangular
from scipy.optimize import minimize
from scipy.stats import qmc
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF, ConstantKernel, WhiteKernel

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent
rng = np.random.default_rng(42)


# %% 1. Çekirdekler ve sıfırdan Gauss süreci regresyonu
def kare_ustel(xa, xb, l, sf):
    """Kare üstel (RBF) çekirdek: sf² · exp(−(x − x')² / (2ℓ²))."""
    return sf**2 * np.exp(-0.5 * (xa[:, None] - xb[None, :])**2 / l**2)


def matern52(xa, xb, l, sf):
    """Matérn 5/2 çekirdeği: sf² (1 + √5 r/ℓ + 5r²/(3ℓ²)) exp(−√5 r/ℓ)."""
    r = np.abs(xa[:, None] - xb[None, :]) / l
    return sf**2 * (1 + np.sqrt(5) * r + 5 * r**2 / 3) * np.exp(-np.sqrt(5) * r)


def gp_sonsal(x, y, xs, l, sf, sn, cekirdek=kare_ustel):
    """Sonsal ortalama, sonsal varyans ve log marjinal olabilirlik (Cholesky ile)."""
    K = cekirdek(x, x, l, sf) + sn**2 * np.eye(len(x))
    L = np.linalg.cholesky(K)                                     # K = L Lᵀ
    alfa = solve_triangular(L.T, solve_triangular(L, y, lower=True), lower=False)   # K⁻¹y
    Ks = cekirdek(x, xs, l, sf)
    mu = Ks.T @ alfa                                              # k*ᵀ K⁻¹ y
    v = solve_triangular(L, Ks, lower=True)
    var = sf**2 - np.sum(v**2, axis=0)                            # k(x*,x*) − k*ᵀ K⁻¹ k*
    lml = -0.5 * y @ alfa - np.sum(np.log(np.diag(L))) - 0.5 * len(x) * np.log(2 * np.pi)
    return mu, var, lml


def en_iyi_hiper(x, y, sn, cekirdek=kare_ustel):
    """σ_n sabitken ℓ ve σ_f'yi log marjinal olabilirliği en büyütecek biçimde bulur."""
    def eksi_lml(th):
        l, sf = np.exp(th)
        return -gp_sonsal(x, y, x[:1], l, sf, sn, cekirdek)[2]
    sonuc = None
    for l0 in [0.1, 0.3, 1.0, 3.0]:                               # birkaç başlangıç noktası
        r = minimize(eksi_lml, np.log([l0, 1.0]), method="L-BFGS-B",
                     bounds=[(np.log(1e-2), np.log(1e2))] * 2)
        if sonuc is None or r.fun < sonuc.fun:
            sonuc = r
    return np.exp(sonuc.x), -sonuc.fun


# %% 2. Örnek A: 8 noktalı "pahalı simülasyon"
def buyutme(r, zeta=0.25):
    return 1 / np.sqrt((1 - r**2)**2 + (2 * zeta * r)**2)


SN = 0.05                                                         # simülasyon gürültüsü (bilinen)
x = np.sort(qmc.LatinHypercube(d=1, seed=rng).random(8)[:, 0] * 3.0)   # Latin hiperküp tasarımı
y = buyutme(x) + rng.normal(0, SN, x.size)
y_ort = y.mean()                                                  # sabit ortalama: örneklem ortalaması
yc = y - y_ort
xs = np.linspace(0, 3.0, 400)
gercek = buyutme(xs)

(l_opt, sf_opt), lml_opt = en_iyi_hiper(x, yc, SN)
mu, var, _ = gp_sonsal(x, yc, xs, l_opt, sf_opt, SN)
sd = np.sqrt(np.maximum(var, 0))
rmse_A = np.sqrt(np.mean((mu + y_ort - gercek)**2))
kapsama_A = np.mean(np.abs(mu + y_ort - gercek) <= 2 * sd)

# scikit-learn: aynı çekirdek ve aynı (sabit) gürültüyle hiperparametre en iyileme
cek = ConstantKernel(1.0, (1e-4, 1e4)) * RBF(1.0, (1e-2, 1e2))
skl = GaussianProcessRegressor(cek, alpha=SN**2, n_restarts_optimizer=10, random_state=42).fit(x[:, None], yc)
sf_skl = np.sqrt(skl.kernel_.k1.constant_value)
l_skl = skl.kernel_.k2.length_scale
# hiperparametreler sabitken iki uygulama birebir aynı sonucu vermeli
sabit = GaussianProcessRegressor(ConstantKernel(sf_opt**2, "fixed") * RBF(l_opt, "fixed"),
                                 alpha=SN**2, optimizer=None).fit(x[:, None], yc)
mu_skl, sd_skl = sabit.predict(xs[:, None], return_std=True)
fark_mu, fark_sd = np.abs(mu - mu_skl).max(), np.abs(sd - sd_skl).max()
# gürültüyü de öğrenmeye çalışırsak (WhiteKernel): 8 noktayla zor
beyaz = GaussianProcessRegressor(ConstantKernel(1.0, (1e-4, 1e4)) * RBF(1.0, (1e-2, 1e2))
                                 + WhiteKernel(1e-2, (1e-8, 1.0)), n_restarts_optimizer=10,
                                 random_state=42).fit(x[:, None], yc)
sn_beyaz = np.sqrt(beyaz.kernel_.k2.noise_level)

print("=== 1. Örnek A: 8 noktalı pahalı simülasyon (dinamik büyütme katsayısı) ===")
print("Tasarım noktaları r =", " ".join(f"{v:.2f}" for v in x))
print(f"Sıfırdan GP (RBF, σ_n = {SN} sabit): ℓ = {l_opt:.3f}, σ_f = {sf_opt:.3f}, log ML = {lml_opt:.3f}")
print(f"scikit-learn GPR           : ℓ = {l_skl:.3f}, σ_f = {sf_skl:.3f}, "
      f"log ML = {skl.log_marginal_likelihood_value_:.3f}")
print(f"Aynı hiperparametrelerle en büyük fark: ortalama {fark_mu:.1e}, std {fark_sd:.1e}")
print(f"Gerçek eğriye göre RMSE = {rmse_A:.3f}; ±2σ bandının gerçek eğriyi kapsadığı oran = {kapsama_A:.3f}")
print(f"En büyük sonsal std = {sd.max():.3f} (r = {xs[np.argmax(sd)]:.2f}); "
      f"rezonans tepesi r = {np.sqrt(1 - 2 * 0.25**2):.3f}, D = {buyutme(np.sqrt(1 - 2 * 0.25**2)):.3f}")
for l_den in [0.1, 1.5]:
    m_, v_, lml_ = gp_sonsal(x, yc, xs, l_den, sf_opt, SN)
    rmse_ = np.sqrt(np.mean((m_ + y_ort - gercek)**2))
    print(f"ℓ = {l_den:4.1f} (σ_f aynı): log ML = {lml_:8.3f}, RMSE = {rmse_:.3f}")
(l_m, sf_m), lml_m = en_iyi_hiper(x, yc, SN, matern52)
m_m, _, _ = gp_sonsal(x, yc, xs, l_m, sf_m, SN, matern52)
print(f"Matérn 5/2 : ℓ = {l_m:.3f}, σ_f = {sf_m:.3f}, log ML = {lml_m:.3f}, "
      f"RMSE = {np.sqrt(np.mean((m_m + y_ort - gercek)**2)):.3f}")
print(f"Gürültü de öğrenilirse (WhiteKernel): σ_n = {sn_beyaz:.4f} (gerçek {SN})")
assert fark_mu < 1e-8 and fark_sd < 1e-8
assert abs(skl.log_marginal_likelihood_value_ - lml_opt) < 1e-3

# %% 3. Örnek B: güvenilirlik, Monte Carlo ve AK-MCS
R_ORT, R_DK = 2.0, 0.15            # kPa, değişim katsayısı
V_ORT, V_DK = 25.0, 0.20           # m/s
K_BASINC = 0.5 * 1.25 * 1.3 / 1000  # ½·ρ·c / 1000 → kPa/(m/s)²; c = 1,3 basınç ve esinti katsayısı
s_lnR = np.sqrt(np.log(1 + R_DK**2))
m_lnR = np.log(R_ORT) - s_lnR**2 / 2
b_V = V_DK * V_ORT * np.sqrt(6) / np.pi
loc_V = V_ORT - np.euler_gamma * b_V


def g_fiziksel(R, V):
    return R - K_BASINC * V**2       # g ≤ 0: göçme


def g_u(u):
    """Standart normal uzaydaki u = (u1, u2) noktasını fiziksel değişkenlere çevirip g'yi hesaplar."""
    R = np.exp(m_lnR + s_lnR * u[:, 0])
    V = stats.gumbel_r.isf(stats.norm.sf(u[:, 1]), loc_V, b_V)
    return g_fiziksel(R, V)


pf_integral, _ = integrate.quad(
    lambda v: stats.norm.cdf((np.log(K_BASINC * v**2) - m_lnR) / s_lnR) * stats.gumbel_r.pdf(v, loc_V, b_V),
    0, 200, limit=200)
N_MC = 1_000_000
U = rng.standard_normal((N_MC, 2))
g_mc = g_u(U)
pf_mc = np.mean(g_mc <= 0)
se_mc = np.sqrt(pf_mc * (1 - pf_mc) / N_MC)

def lbfgs(amac, theta0, bounds):
    """scikit-learn'ün varsayılanıyla aynı L-BFGS-B. g neredeyse doğrusal olduğundan olabilirlik yüzeyi çok
    düzdür; çizgi araması erken bitince varsayılan uyarı yazar, burada en iyi nokta sessizce döner."""
    r = minimize(amac, theta0, method="L-BFGS-B", jac=True, bounds=bounds)
    return r.x, r.fun


# AK-MCS: küçük bir Latin hiperküp tasarımıyla başla, U = |μ|/σ en küçük olan örneği ekle
n0 = 12
X_t = qmc.LatinHypercube(d=2, seed=rng).random(n0) * 10 - 5     # [−5, 5]² kutusu (u uzayı)
y_t = g_u(X_t)
gecmis = []
for adim in range(60):
    # alpha (nugget) küçük kalmalı: büyürse tasarım noktalarında σ sıfıra inmez ve U ≥ 2 hiç sağlanmaz
    vekil = GaussianProcessRegressor(ConstantKernel(1.0, (1e-3, 1e4)) * RBF([1.0, 1.0], (1e-2, 1e3)),
                                     alpha=1e-8, normalize_y=True, optimizer=lbfgs, n_restarts_optimizer=3,
                                     random_state=42).fit(X_t, y_t)
    mu_g, sd_g = np.empty(N_MC), np.empty(N_MC)
    for s in range(0, N_MC, 100_000):                           # belleği korumak için parça parça
        mu_g[s:s + 100_000], sd_g[s:s + 100_000] = vekil.predict(U[s:s + 100_000], return_std=True)
    U_fonk = np.abs(mu_g) / np.maximum(sd_g, 1e-12)
    j = np.argmin(U_fonk)
    gecmis.append((len(y_t), np.mean(mu_g <= 0), U_fonk[j]))
    if U_fonk[j] >= 2:                                          # durma ölçütü: min U ≥ 2
        break
    X_t = np.vstack([X_t, U[j]])
    y_t = np.append(y_t, g_u(U[j:j + 1]))
pf_ak = gecmis[-1][1]
yanlis = int(np.sum((mu_g <= 0) != (g_mc <= 0)))

print("\n=== 2. Örnek B: güvenilirlik ve aktif öğrenme (AK-MCS) ===")
print(f"Sayısal integral       : P_f = {pf_integral:.4e}  (β = {-stats.norm.ppf(pf_integral):.3f})")
print(f"Monte Carlo, 10⁶ örnek : P_f = {pf_mc:.4e}  (%95 aralık {pf_mc - 1.96 * se_mc:.4e} – "
      f"{pf_mc + 1.96 * se_mc:.4e}, değişim katsayısı {se_mc / pf_mc:.3f})")
for n_c, pf_c, u_c in gecmis:
    print(f"   AK-MCS: {n_c:2d} çağrı → P_f = {pf_c:.4e}, en küçük U = {u_c:.3f}")
print(f"AK-MCS sonucu: P_f = {pf_ak:.4e}, gerçek fonksiyon çağrısı = {len(y_t)} "
      f"(başlangıç {n0} + {len(y_t) - n0} ekleme); yanlış sınıflanan örnek = {yanlis}")
assert len(gecmis) < 60 and abs(pf_ak - pf_mc) < 3 * se_mc

# %% 4. Örnek C: değişen saçılım, kantil regresyon ve uyumlu tahmin
S_MIN, S_MAX = 80.0, 320.0           # gerilme genliği (MPa)


def sn_verisi(n):
    logS = rng.uniform(np.log10(S_MIN), np.log10(S_MAX), n)
    sacilim = 0.08 + 0.30 * (np.log10(S_MAX) - logS) / (np.log10(S_MAX) - np.log10(S_MIN))
    logN = 12.4 - 3.0 * logS + sacilim * rng.normal(size=n)       # eğim 3, saçılım düşük gerilmede büyük
    return logS, logN


x_eg, y_eg = sn_verisi(500)          # eğitim
x_kal, y_kal = sn_verisi(500)        # kalibrasyon (yalnız uyumlu tahmin için)
x_te, y_te = sn_verisi(5000)         # test: kapsamayı ölçmek için
ALFA = 0.10                          # hedef kapsama 1 − α = %90
gb = dict(n_estimators=150, max_depth=2, learning_rate=0.05, min_samples_leaf=20, random_state=42)
nokta = GradientBoostingRegressor(**gb).fit(x_eg[:, None], y_eg)
q_alt = GradientBoostingRegressor(loss="quantile", alpha=ALFA / 2, **gb).fit(x_eg[:, None], y_eg)
q_ust = GradientBoostingRegressor(loss="quantile", alpha=1 - ALFA / 2, **gb).fit(x_eg[:, None], y_eg)

n_kal = len(y_kal)
k_sira = int(np.ceil((n_kal + 1) * (1 - ALFA)))                 # ⌈(n+1)(1−α)⌉. en küçük skor
skor = np.abs(y_kal - nokta.predict(x_kal[:, None]))           # bölünmüş uyumlu tahmin skoru
q_hat = np.sort(skor)[k_sira - 1]
E = np.maximum(q_alt.predict(x_kal[:, None]) - y_kal, y_kal - q_ust.predict(x_kal[:, None]))   # CQR skoru
Q_hat = np.sort(E)[k_sira - 1]

p_te = nokta.predict(x_te[:, None])
alt_te, ust_te = q_alt.predict(x_te[:, None]), q_ust.predict(x_te[:, None])
B = 25
tahminler = np.empty((B, x_te.size))
for b in range(B):                                              # bootstrap topluluğu
    idx = rng.integers(0, x_eg.size, x_eg.size)
    tahminler[b] = GradientBoostingRegressor(**{**gb, "random_state": b}).fit(
        x_eg[idx, None], y_eg[idx]).predict(x_te[:, None])
b_alt, b_ust = np.percentile(tahminler, [5, 95], axis=0)

yontemler = {
    "Bölünmüş uyumlu": (p_te - q_hat, p_te + q_hat),
    "Kantil GBR": (alt_te, ust_te),
    "CQR": (alt_te - Q_hat, ust_te + Q_hat),
    "Bootstrap (25 model)": (b_alt, b_ust),
}
kenarlar = np.log10(np.geomspace(S_MIN, S_MAX, 5))               # 4 gerilme aralığı
bolge = np.clip(np.digitize(x_te, kenarlar[1:-1]), 0, 3)
print("\n=== 3. Örnek C: değişen saçılımlı yorulma verisi, hedef kapsama %90 ===")
print(f"Kalibrasyon: n = {n_kal}, sıra k = ⌈(n+1)(1−α)⌉ = {k_sira}; q̂ = {q_hat:.3f}, "
      f"CQR düzeltmesi Q̂ = {Q_hat:.3f}")
etiket = [f"{10**kenarlar[i]:.0f}–{10**kenarlar[i + 1]:.0f}" for i in range(4)]
print("Gerilme aralıkları (MPa): " + ", ".join(etiket))
print(f"{'Yöntem':22s} {'kapsama':>8s}   aralık başına kapsama        ortalama genişlik (log10 N)")
kapsama_tablo = {}
for ad, (alt, ust) in yontemler.items():
    icinde = (y_te >= alt) & (y_te <= ust)
    kb = [icinde[bolge == i].mean() for i in range(4)]
    kapsama_tablo[ad] = kb
    print(f"{ad:22s} {icinde.mean():8.3f}   " + " ".join(f"{v:.3f}" for v in kb)
          + f"      {np.mean(ust - alt):.3f}")
assert np.isfinite(q_hat) and abs(np.mean(np.abs(y_te - p_te) <= q_hat) - 0.9) < 0.03

# %% 5. Grafikler
# Şekil 1: önsel örnekler
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained", sharey=True)
xg = np.linspace(0, 3, 300)
z = rng.standard_normal((xg.size, 3))
for a, (cekirdek, ad) in zip(ax, [(kare_ustel, "Kare üstel (RBF), ℓ = 0.5"), (matern52, "Matérn 5/2, ℓ = 0.5")]):
    Kp = cekirdek(xg, xg, 0.5, 1.0) + 1e-8 * np.eye(xg.size)
    ornek = np.linalg.cholesky(Kp) @ z
    a.fill_between(xg, -2, 2, color=RENK[0], alpha=0.10, lw=0, label=r"Önsel ±2σ ($\sigma_f$ = 1)")
    for i in range(3):
        a.plot(xg, ornek[:, i], color=RENK[i], lw=1.6, label=f"Örnek {i + 1}")
    a.set(xlabel="x", title=ad, ylim=(-3.2, 2.6))
ax[0].set_ylabel("f(x)")
ax[0].legend(loc="lower center", ncols=4, fontsize=8.5)
fig.savefig(KLASOR / "d15_gauss_surecleri_1.png", dpi=160)
plt.close(fig)

# Şekil 2: sonsal ve uzunluk ölçeğinin etkisi
fig, ax = plt.subplots(2, 2, figsize=(10, 7.0), layout="constrained")
for a, l_den, baslik in [(ax[0, 0], l_opt, f"En büyük olabilirlik: ℓ = {l_opt:.2f}"),
                         (ax[0, 1], 0.1, "ℓ = 0.1: çok kısa"), (ax[1, 0], 1.5, "ℓ = 1.5: çok uzun")]:
    m_, v_, _ = gp_sonsal(x, yc, xs, l_den, sf_opt, SN)
    s_ = np.sqrt(np.maximum(v_, 0))
    a.fill_between(xs, m_ + y_ort - 2 * s_, m_ + y_ort + 2 * s_, color=RENK[0], alpha=0.18, lw=0,
                   label="Ortalama ± 2σ")
    a.plot(xs, gercek, color=MUREKKEP, ls="--", lw=1.3, label="Gerçek eğri")
    a.plot(xs, m_ + y_ort, color=RENK[0], label="GP ortalaması")
    a.scatter(x, y, s=34, color=SOLUK, zorder=5, label="Simülasyon (8 nokta)")
    a.set(xlabel=r"Frekans oranı $r = \omega/\omega_n$", ylabel="Dinamik büyütme D", title=baslik,
          ylim=(-0.6, 3.0))
ax[0, 0].legend(loc="upper right", fontsize=9)
l_izgara = np.geomspace(0.05, 3, 120)
lml_izgara = [gp_sonsal(x, yc, x[:1], lv, sf_opt, SN)[2] for lv in l_izgara]
ax[1, 1].semilogx(l_izgara, lml_izgara, color=RENK[0])
ax[1, 1].axvline(l_opt, color=MUREKKEP, ls=":", lw=1.2, label=f"En iyi ℓ = {l_opt:.2f}")
ax[1, 1].set(xlabel="Uzunluk ölçeği ℓ (log)", ylabel="log marjinal olabilirlik",
             title=r"Marjinal olabilirlik ($\sigma_f$ ve $\sigma_n$ sabit)",
             ylim=(max(min(lml_izgara), -60), lml_opt + 5))
ax[1, 1].legend(loc="lower left")
fig.savefig(KLASOR / "d15_gauss_surecleri_2.png", dpi=160)
plt.close(fig)

# Şekil 3: AK-MCS
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
u1, u2 = np.meshgrid(np.linspace(-5, 5, 220), np.linspace(-5, 5, 220))
izgara = np.column_stack([u1.ravel(), u2.ravel()])
g_iz = g_u(izgara).reshape(u1.shape)
mu_iz = vekil.predict(izgara).reshape(u1.shape)
alt_kume = U[:8000]
ax[0].contourf(u1, u2, g_iz, levels=[g_iz.min() - 1, 0], colors=[RENK[1]], alpha=0.10)
ax[0].scatter(alt_kume[:, 0], alt_kume[:, 1], s=1, color=SOLUK, alpha=0.25, rasterized=True)
ax[0].contour(u1, u2, g_iz, levels=[0], colors=MUREKKEP, linestyles="--", linewidths=1.4)
ax[0].contour(u1, u2, mu_iz, levels=[0], colors=RENK[0], linewidths=1.6)
ax[0].plot(X_t[:n0, 0], X_t[:n0, 1], "s", ms=6, mfc="white", mec=RENK[1], mew=1.5, ls="none",
           label=f"Başlangıç tasarımı ({n0})")
ax[0].plot(X_t[n0:, 0], X_t[n0:, 1], "o", ms=6, color=RENK[2], ls="none",
           label=f"AK-MCS eklemeleri ({len(y_t) - n0})")
ax[0].plot([], [], color=MUREKKEP, ls="--", lw=1.4, label="Gerçek sınır g = 0")
ax[0].plot([], [], color=RENK[0], lw=1.6, label="GP sınırı μ = 0")
ax[0].text(-2.6, 4.4, "göçme bölgesi (g ≤ 0)", ha="center", va="center", fontsize=9, color=IKINCIL)
ax[0].set(xlabel="u₁ (dayanım R, standart normal)", ylabel="u₂ (rüzgâr hızı V, standart normal)",
          title="Standart normal uzayda sınır durum", xlim=(-5, 5), ylim=(-5, 5))
ax[0].legend(loc="lower left", fontsize=8.5)
cagri = [h[0] for h in gecmis]
ax[1].fill_between([cagri[0] - 0.5, cagri[-1] + 0.5], 1e3 * (pf_mc - 1.96 * se_mc), 1e3 * (pf_mc + 1.96 * se_mc),
                   color=SOLUK, alpha=0.25, lw=0, label="MC (10⁶ örnek) %95 aralığı")
ax[1].axhline(1e3 * pf_integral, color=MUREKKEP, ls="--", lw=1.2, label="Sayısal integral")
ax[1].plot(cagri, [1e3 * h[1] for h in gecmis], "-o", color=RENK[0], ms=5, label="AK-MCS tahmini")
ax[1].set(xlabel="Gerçek fonksiyon çağrısı", ylabel=r"Göçme olasılığı $P_f$ (×10⁻³)",
          title=r"$P_f$ tahmininin yakınsaması")
ax[1].legend(loc="lower right")
fig.savefig(KLASOR / "d15_gauss_surecleri_3.png", dpi=160)
plt.close(fig)

# Şekil 4: uyumlu tahmin
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
sira = np.argsort(x_te)
S_te = 10**x_te[sira]
ax[0].scatter(10**x_te[:1500], y_te[:1500], s=4, color=SOLUK, alpha=0.5, label="Test verisi (sentetik)")
ax[0].plot(S_te, (p_te - q_hat)[sira], color=RENK[1], lw=1.4, label="Bölünmüş uyumlu (sabit genişlik)")
ax[0].plot(S_te, (p_te + q_hat)[sira], color=RENK[1], lw=1.4)
ax[0].plot(S_te, (alt_te - Q_hat)[sira], color=RENK[0], lw=1.6, label="CQR (uyarlanır genişlik)")
ax[0].plot(S_te, (ust_te + Q_hat)[sira], color=RENK[0], lw=1.6)
ax[0].plot(S_te, p_te[sira], color=MUREKKEP, lw=1.0, ls=":", label="Nokta tahmini")
ax[0].set(xscale="log", xlabel="Gerilme genliği S (MPa)", ylabel="log₁₀ N (çevrim)", title="%90 tahmin aralıkları")
ax[0].legend(loc="upper right", fontsize=8.5)
genislik = 0.2
merkez = np.arange(4)
for i, (ad, renk) in enumerate([("Bölünmüş uyumlu", RENK[1]), ("CQR", RENK[0]), ("Kantil GBR", RENK[2]),
                                ("Bootstrap (25 model)", RENK[3])]):
    ax[1].bar(merkez + (i - 1.5) * genislik, kapsama_tablo[ad], width=genislik, color=renk, label=ad)
ax[1].axhline(0.9, color=MUREKKEP, ls="--", lw=1.2, label="Hedef %90")
ax[1].set_xticks(merkez, etiket)
ax[1].set(xlabel="Gerilme aralığı (MPa)", ylabel="Deneysel kapsama", ylim=(0, 1.32),
          yticks=np.arange(0, 1.01, 0.2), title="Gerilme aralığına göre kapsama")
ax[1].legend(loc="upper center", ncols=3, fontsize=8)
fig.savefig(KLASOR / "d15_gauss_surecleri_4.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d15_gauss_surecleri_1.png, _2.png, _3.png, _4.png")=== 1. Örnek A: 8 noktalı pahalı simülasyon (dinamik büyütme katsayısı) ===
Tasarım noktaları r = 0.02 0.47 0.78 1.43 1.50 1.91 2.30 2.88
Sıfırdan GP (RBF, σ_n = 0.05 sabit): ℓ = 0.411, σ_f = 0.612, log ML = -4.244
scikit-learn GPR : ℓ = 0.411, σ_f = 0.612, log ML = -4.244
Aynı hiperparametrelerle en büyük fark: ortalama 3.1e-15, std 2.3e-15
Gerçek eğriye göre RMSE = 0.084; ±2σ bandının gerçek eğriyi kapsadığı oran = 0.907
En büyük sonsal std = 0.168 (r = 2.62); rezonans tepesi r = 0.935, D = 2.066
ℓ = 0.1 (σ_f aynı): log ML = -6.234, RMSE = 0.383
ℓ = 1.5 (σ_f aynı): log ML = -69.144, RMSE = 0.247
Matérn 5/2 : ℓ = 0.492, σ_f = 0.600, log ML = -4.279, RMSE = 0.082
Gürültü de öğrenilirse (WhiteKernel): σ_n = 0.0663 (gerçek 0.05)
=== 2. Örnek B: güvenilirlik ve aktif öğrenme (AK-MCS) ===
Sayısal integral : P_f = 1.6009e-03 (β = 2.948)
Monte Carlo, 10⁶ örnek : P_f = 1.5950e-03 (%95 aralık 1.5168e-03 – 1.6732e-03, değişim katsayısı 0.025)
AK-MCS: 12 çağrı → P_f = 1.6160e-03, en küçük U = 0.014
AK-MCS: 13 çağrı → P_f = 1.5660e-03, en küçük U = 0.042
AK-MCS: 14 çağrı → P_f = 1.5940e-03, en küçük U = 0.046
AK-MCS: 15 çağrı → P_f = 1.5960e-03, en küçük U = 0.216
AK-MCS: 16 çağrı → P_f = 1.5950e-03, en küçük U = 1.404
AK-MCS: 17 çağrı → P_f = 1.5950e-03, en küçük U = 2.965
AK-MCS sonucu: P_f = 1.5950e-03, gerçek fonksiyon çağrısı = 17 (başlangıç 12 + 5 ekleme); yanlış sınıflanan örnek = 0
=== 3. Örnek C: değişen saçılımlı yorulma verisi, hedef kapsama %90 ===
Kalibrasyon: n = 500, sıra k = ⌈(n+1)(1−α)⌉ = 451; q̂ = 0.387, CQR düzeltmesi Q̂ = 0.035
Gerilme aralıkları (MPa): 80–113, 113–160, 160–226, 226–320
Yöntem kapsama aralık başına kapsama ortalama genişlik (log10 N)
Bölünmüş uyumlu 0.893 0.761 0.843 0.955 0.999 0.775
Kantil GBR 0.882 0.863 0.859 0.902 0.903 0.731
CQR 0.914 0.883 0.894 0.929 0.946 0.801
Bootstrap (25 model) 0.237 0.218 0.217 0.225 0.287 0.133
Grafikler kaydedildi: d15_gauss_surecleri_1.png, _2.png, _3.png, _4.png8. Sonuçları yorumlayın
Örnek A: sekiz simülasyonla bir rezonans eğrisi
Tek serbestlik dereceli bir sistemin harmonik yük altındaki dinamik büyütme katsayısını, $D(r) = 1/\sqrt{(1-r^2)^2 + (2\zeta r)^2}$, $\zeta = 0{,}25$ ile pahalı bir simülasyon gibi ele aldık. Fonksiyonu biliyoruz, ama GP yalnızca Latin hiperküp tasarımıyla seçilmiş 8 frekans oranındaki gürültülü değerleri görüyor. Tepe $r = 0{,}935$'te ve $D = 2{,}066$.
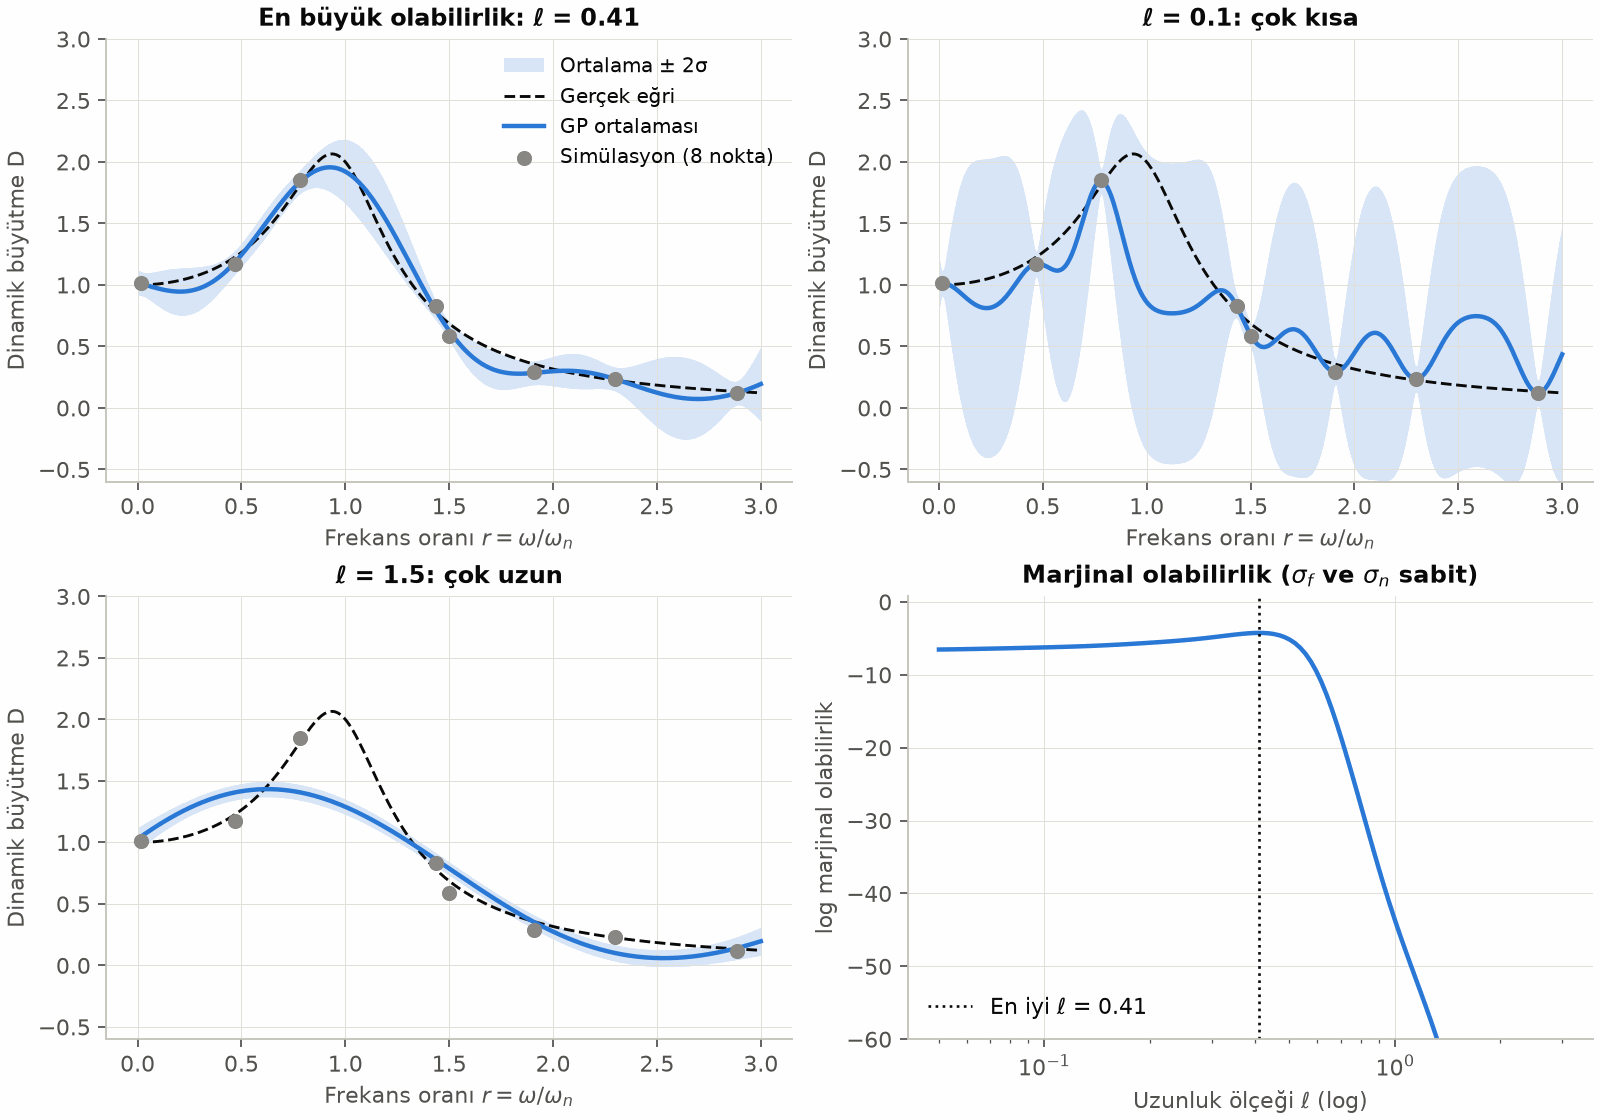
Sıfırdan yazdığımız GP ile scikit-learn aynı hiperparametreleri buluyor: $\ell = 0{,}411$, $\sigma_f = 0{,}612$, log marjinal olabilirlik $-4{,}244$. Hiperparametreler sabitken iki uygulamanın tahminleri arasındaki en büyük fark ortalamada $3{,}1\times10^{-15}$, standart sapmada $2{,}3\times10^{-15}$; yani yalnızca yuvarlama hatası.
Gerçek eğriye göre RMSE 0,084. Daha önemlisi, $\pm 2\sigma$ bandı gerçek eğrinin %90,7'sini içine alıyor. Normal dağılımda $\pm 2\sigma$ yaklaşık %95'e karşılık gelir; sekiz noktalı bir modelden bu yakınlık iyidir ama kusursuz değildir. Bant, tasarım noktalarının seyrek olduğu iki bölgede şişiyor: 0,78 ile 1,43 arasındaki tepe bölgesi ve 2,30 ile 2,88 arası. En büyük sonsal standart sapma 0,168 ile $r = 2{,}62$'de. Bandın nerede geniş olduğu, bir sonraki simülasyonu nereye koyacağımızı söyler; Alıştırma 2'de bunu deneyeceksiniz.
Uzunluk ölçeğinin etkisi sayılarda da açık. $\ell = 0{,}1$ ile log marjinal olabilirlik $-6{,}234$'e düşüyor, RMSE 0,383'e çıkıyor. $\ell = 1{,}5$ ile log marjinal olabilirlik $-69{,}144$'e çöküyor, RMSE 0,247. Sağ alttaki eğri asimetriyi gösteriyor: çok uzun $\ell$, veriyi açıklayamadığı için ağır cezalanıyor; çok kısa $\ell$ ise yalnızca karmaşıklık terimiyle, daha hafif cezalanıyor. Az veride kısa uzunluk ölçeğine kaymaya bu yüzden dikkat etmek gerekir.
Matérn 5/2 çekirdeği neredeyse aynı sonucu veriyor: $\ell = 0{,}492$, log marjinal olabilirlik $-4{,}279$, RMSE 0,082. Sekiz noktayla iki çekirdeği ayırt edecek kadar bilgi yok. Gürültüyü de veriden öğrenmeye çalıştığımızda (WhiteKernel) $\sigma_n = 0{,}0663$ bulunuyor; gerçek değer 0,05. Bu örnekte makul bir tahmin, ama bu kadar az noktayla gürültü tahmininin oynak olmasını bekleyin.
Örnek B: 17 çağrıyla göçme olasılığı
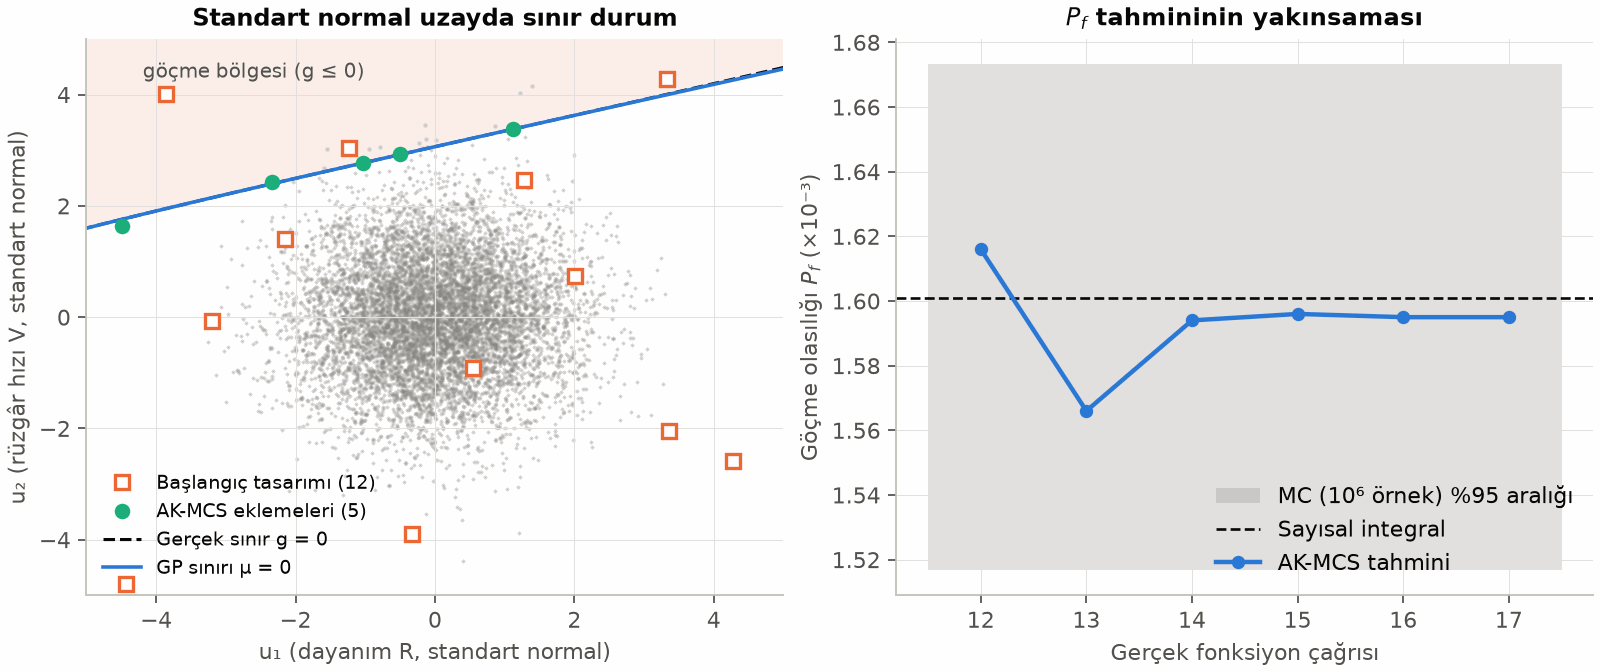
Sayısal integral kesin değeri veriyor: $P_f = 1{,}6009\times10^{-3}$, yani $\beta = 2{,}948$. $10^6$ örnekli Monte Carlo $1{,}5950\times10^{-3}$ buluyor; %95 güven aralığı $1{,}5168$–$1{,}6732\times10^{-3}$ kesin değeri içeriyor ve değişim katsayısı 0,025.
AK-MCS, 12 noktalı başlangıç tasarımıyla $1{,}6160\times10^{-3}$ ile başlıyor; o anda en küçük $U$ 0,014, yani vekil sınırın yerinden emin değil. Her adımda sınırın üzerindeki bir noktayı ekliyor. Beşinci eklemeden sonra en küçük $U$ 2,965'e çıkıyor ve döngü duruyor. Sonuç: 17 gerçek fonksiyon çağrısıyla $P_f = 1{,}5950\times10^{-3}$. Bu, aynı $10^6$ örneğe gerçek $g$ ile uygulanan Monte Carlo sonucunun tam kendisi: vekil hiçbir örneği yanlış sınıflandırmadı. Bir milyon çağrı yerine 17 çağrı.
Şekle dikkat edin: başlangıç tasarımının çoğu sınırdan uzakta, göçme olasılığına hiçbir katkısı olmayan bölgelerde. AK-MCS'in eklediği bütün noktalar ise sınırın üzerinde ve Monte Carlo bulutunun kenarında. Örnek kolaydı: standart normal uzayda sınır neredeyse bir doğru. Eğri ya da birden çok parçalı sınırlarda daha çok ekleme gerekir; Alıştırma 4'te başlangıç tasarımının etkisini deneyeceksiniz.
Örnek C: aralıkların kapsaması
| Yöntem | Toplam kapsama | 80–113 MPa | 226–320 MPa | Ortalama genişlik |
|---|---|---|---|---|
| Bölünmüş uyumlu tahmin | 0,893 | 0,761 | 0,999 | 0,775 |
| Kantil GBR | 0,882 | 0,863 | 0,903 | 0,731 |
| CQR | 0,914 | 0,883 | 0,946 | 0,801 |
| Bootstrap (25 model) | 0,237 | 0,218 | 0,287 | 0,133 |
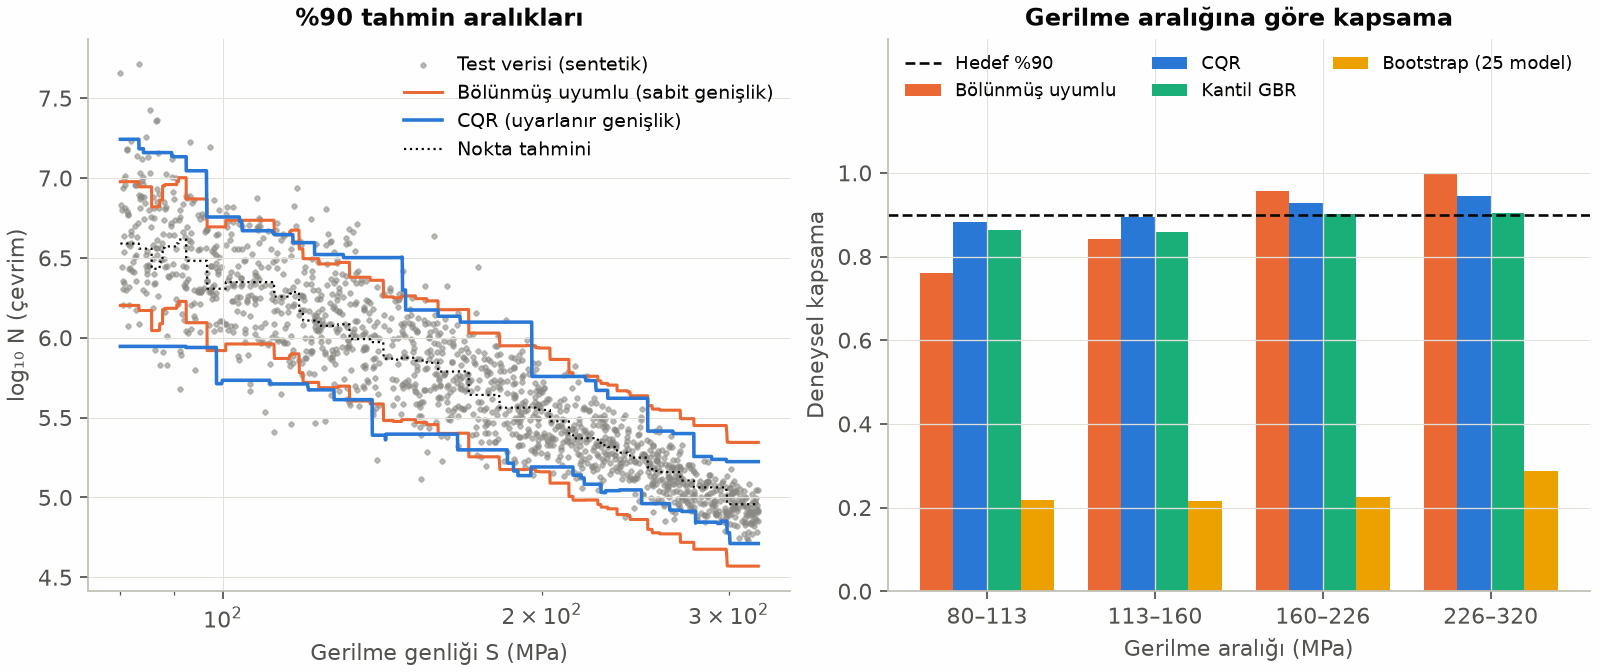
Kalibrasyon kümesinde $n = 500$ ve $k = \lceil 501 \times 0{,}9\rceil = 451$. Bölünmüş uyumlu tahmin $\hat q = 0{,}387$ buluyor ve toplam kapsama 0,893, hedefe çok yakın. Güvence, kalibrasyon çekilişleri üzerinden ortalamada en az 0,90'dır; $n = 500$'de tek bir çekilişin ±0,013 kadar oynaması normaldir (Alıştırma 3). Ama aralıklara ayırınca tablo değişiyor: saçılımın büyük olduğu 80–113 MPa aralığında kapsama 0,761, küçük olduğu 226–320 MPa aralığında 0,999. Ortalama doğru, her bölge yanlış.
Kantil GBR aralığı saçılıma uyarlanıyor ama toplamda 0,882'de kalıyor; eğitim verisine fazla uyan kantil modelleri aralığı biraz dar kurar ve bunu düzeltecek bir mekanizma yoktur. CQR iki dünyanın iyisini alıyor: kantil aralığını kalibrasyon kümesiyle $\hat Q = 0{,}035$ kadar genişletiyor, toplam kapsamayı 0,914'e çıkarıyor ve aralıklardaki kapsama 0,883 ile 0,946 arasında kalıyor. Bunun için ortalama genişlik 0,801'e çıkıyor; bölünmüş uyumlu tahminden yalnızca biraz daha geniş.
Bootstrap topluluğunun 5–95 yüzdelik aralığı ise ölçümlerin yalnızca %23,7'sini içine alıyor. Bu bir hata değildir: 25 modelin birbirinden farkı, ortalama eğrinin ne kadar iyi bilindiğini ölçer. Tek bir numunenin ömrü ise ortalama eğrinin çevresinde çok daha geniş saçılıyor; bootstrap aralığının ortalama genişliği 0,133, bölünmüş uyumlu aralığınki 0,775. Bootstrap aralığını tahmin aralığı diye kullanmak, belirsizliği beş kattan fazla küçük göstermek demektir.
9. Sık yapılan hatalar
- GP bandını kesin bir güvence sanmak. Bant, çekirdek varsayımları kadar dürüsttür. Örnek A'da $\ell = 1{,}5$ ile bant hem dar hem yanlıştı. Kapsama güvencesi gerekiyorsa bandı ayrı bir kalibrasyon kümesiyle sınayın ya da uyumlu tahminle düzeltin.
- Ters matris almak, jitter'ı unutmak. Cholesky kullanın. Gürültüsüz bir simülatörde köşegene küçük bir sayı ekleyin, ama büyütmeyin: AK-MCS'te büyük bir
alphatasarım noktalarında $\sigma$'nın sıfıra inmesini engeller, $U \ge 2$ ölçütüne hiç ulaşılamayabilir. - Ortalamayı ve ölçeği unutmak. Sıfır ortalamalı bir GP, verinin uzağında sıfıra döner. Hedefi merkezleyin (
normalize_y=Trueya da ortalamayı çıkarın) ve girdileri benzer ölçeklere getirin. - scikit-learn'de
alphaileWhiteKernel'i karıştırmak. Birincisinde döndürülen std $f$'nin, ikincisinde yeni bir ölçümün belirsizliğidir. - Kalibrasyon verisini eğitimde de kullanmak. Model kalibrasyon noktalarını görmüşse skorlar küçük çıkar, aralık daralır ve güvence ortadan kalkar. Zaman serisinde ya da gruplu veride değiştirilebilirlik varsayımı da bozulabilir (Ders 03).
- Marjinal kapsamayı koşullu kapsama sanmak. Toplam 0,893, düşük gerilmede 0,761 demek olabilir. Kapsamayı her zaman önemli alt gruplarda da raporlayın.
10. Alıştırmalar
Alıştırma 1KolayTek gözlemli GP
Tek bir gözlem var: $x_1 = 0$, $y_1 = 1$. Kare üstel çekirdek, $\ell = 1$, $\sigma_f = 1$, $\sigma_n = 0{,}1$. Sonsal ortalamayı ve standart sapmayı $x_* = 0{,}5$ ve $x_* = 2$ için elle hesaplayın ve gp_sonsal ile doğrulayın.
Çözümü göster
Tek gözlemde formüller skalerdir: $\mu_* = k_*\,y_1/(\sigma_f^2 + \sigma_n^2)$ ve $\sigma_*^2 = \sigma_f^2 - k_*^2/(\sigma_f^2 + \sigma_n^2)$, burada $k_* = \exp(-x_*^2/2)$ ve payda $1{,}01$.
- $x_* = 0{,}5$: $k_* = e^{-0{,}125} = 0{,}8825$, $\mu_* = 0{,}8738$, $\sigma_* = 0{,}4784$.
- $x_* = 2$: $k_* = e^{-2} = 0{,}1353$, $\mu_* = 0{,}1340$, $\sigma_* = 0{,}9909$.
Gözlemden uzaklaştıkça ortalama önsel ortalamaya (0), standart sapma önsel değere ($\sigma_f = 1$) döner. GP, verinin uzağında “bilmiyorum” der; bu, dış değer bölgesinde sessizce kendinden emin tahmin üreten modellerden önemli bir farktır.
Alıştırma 2OrtaBir simülasyon daha: nereye?
Örnek A'da sonsal standart sapmanın en büyük olduğu noktaya ($r = 2{,}62$) yeni bir gürültülü simülasyon ekleyin (gürültüyü np.random.default_rng(7).normal(0, 0.05) ile çekin), hiperparametreleri yeniden bulun ve RMSE ile kapsamayı karşılaştırın. Tepe bölgesindeki (0,8–1,2) en büyük hata nasıl değişiyor? Bu ölçüt AK-MCS'in U ölçütünden nasıl farklı?
Çözümü göster
Yeni nokta $r = 2{,}617$'de. Hiperparametreler yeniden bulununca $\ell = 0{,}433$, $\sigma_f = 0{,}605$ oluyor. RMSE 0,084'ten 0,074'e iniyor, kapsama 0,905. Tepe bölgesindeki en büyük hata da 0,171'den 0,141'e iniyor: yeni nokta tepeden uzakta olsa da ortalama ve hiperparametreler yeniden hesaplandığı için bütün eğri biraz değişiyor. En büyük sonsal standart sapma artık 0,132 ile $r = 1{,}12$'de, yani tepe bölgesinde. Bir sonraki simülasyon oraya gidecek.
Sayılar yeni simülasyonun gürültüsüne bağlıdır. Bu çekilişte gürültü neredeyse sıfır (+0,0001); gürültüyü –0,1 ile +0,1 arasında değiştirince RMSE 0,073–0,084, kapsama 0,855–1,000 arasında oynuyor. En büyük belirsizlik her durumda $r = 1{,}12$'ye taşınıyor.
“En büyük varyans” ölçütü fonksiyonu her yerde eşit derecede iyi öğrenmeye çalışır. AK-MCS'in U ölçütü ise yalnızca $g$'nin işaretiyle ilgilenir: $\sigma$'sı büyük olsa bile $\lvert\mu\rvert$'su da büyük olan, yani sınırdan uzak bölgelere nokta koymaz. Amaç bir eğriyi bütünüyle öğrenmekse varyans ölçütü, bir sınırı bulmaksa U ölçütü uygundur.
Alıştırma 3OrtaKalibrasyon kümesi ne kadar büyük olmalı?
Örnek C'deki nokta modelini sabit tutun. Bölünmüş uyumlu tahmini $n = 20$, $100$ ve $500$ noktalık kalibrasyon kümeleriyle 1.000'er kez tekrarlayın (her seferinde yeni bir kalibrasyon kümesi çekerek) ve test kümesindeki kapsamanın ortalamasını ve %5–%95 aralığını bulun. Sonucu kuramla karşılaştırın: kapsama, $\mathrm{Beta}(k,\ n+1-k)$ dağılımına uyar.
Çözümü göster
$n = 20$ için $k = \lceil 21 \times 0{,}9\rceil = 19$: yirmi skorun en büyüğünden bir öncekini alıyoruz. 1.000 tekrarda kapsamanın ortalaması 0,903, ama %5–%95 aralığı 0,779–0,979; tekrarların %39'unda kapsama %90'ın altında kalıyor. $n = 100$'de aralık 0,848–0,944'e, $n = 500$'de 0,876–0,923'e daralıyor; ortalama ikisinde de 0,900.
Kuram: $\mathrm{Beta}(k, n+1-k)$ dağılımının ortalaması $k/(n+1)$, standart sapması üç durumda 0,063, 0,030 ve 0,013. Benzetimden bulunan standart sapmalar 0,065, 0,030 ve 0,014. Sayıları, tek bir test kümesinin şansını ortadan kaldırmak için 200.000 noktalık taze bir test kümesiyle hesapladık.
Ders: güvence, kalibrasyon kümesinin rastgele çekilişi üzerinden bir ortalamadır. Tek bir küçük kalibrasyon kümesiyle aralığınız gerçekte %78'i de kapsayabilir. Betikteki çekilişin verdiği 0,893 ise $n = 500$ için beklenen aralığın rahatça içinde. Birkaç yüz kalibrasyon noktası, ±%2–3'lük bir oynamayı kabul ediyorsanız yeterlidir.
Alıştırma 4OrtaAK-MCS ve başlangıç tasarımı
Örnek B'de başlangıç Latin hiperküp tasarımını 12 yerine 6 ve 20 noktayla kurun. Toplam gerçek fonksiyon çağrısı ve $P_f$ nasıl değişiyor?
Çözümü göster
6 noktalı başlangıçla toplam 16, 20 noktalı başlangıçla 23 gerçek çağrı gerekiyor (12 noktayla 17'ydi). Üçünde de $P_f = 1{,}5950\times10^{-3}$ ve yanlış sınıflanan örnek yok. Küçük başlangıçta ara tahminler çok oynak: 6 noktalı tasarımla ilk tahmin $P_f = 7{,}44\times10^{-2}$, gerçeğin yaklaşık 47 katı; tek bir eklemeden sonra $9{,}42\times10^{-4}$. (Bu denemede scikit-learn bir uzunluk ölçeğinin üst sınıra dayandığını söyleyen bir uyarı yazabilir; sınır neredeyse doğrusal olduğundan bu beklenen bir durumdur.) Büyük başlangıç tasarımı ise noktalarının çoğunu sınırdan uzağa, sonuca katkısı olmayan yerlere harcıyor.
İki ders çıkar: ara $P_f$ değerlerine değil, durma ölçütüne güvenin; başlangıç tasarımını da yalnızca vekilin kabaca kurulmasına yetecek kadar küçük tutun.
Alıştırma 5ZorMarjinal olabilirliğin gradyanı
Marjinal olabilirliğin bir hiperparametreye göre türevi
$$ \frac{\partial \log p}{\partial \theta_j} = \tfrac12\,\mathrm{tr}\!\left[\big(\vect\alpha\vect\alpha^\top - K_y^{-1}\big)\frac{\partial K_y}{\partial \theta_j}\right] $$ile verilir; $\vect\alpha = K_y^{-1}\vect y$. Kare üstel çekirdek için $\partial K/\partial\log\ell$'yi türetin, formülü Örnek A'nın verisinde ($\sigma_f = 0{,}612$, $\sigma_n = 0{,}05$) $\ell = 0{,}3$ ve $\ell = 0{,}411$ için sonlu farkla karşılaştırın.
Çözümü göster
$K_{ij} = \sigma_f^2\exp\!\big(-D_{ij}^2/(2\ell^2)\big)$, $D_{ij} = x_i - x_j$ için $\partial K/\partial\ell = K \odot D^2/\ell^3$; dolayısıyla $\partial K/\partial\log\ell = \ell\,\partial K/\partial\ell = K \odot D^2/\ell^2$. Gürültü terimi $\ell$'ye bağlı değildir.
D2 = (x[:, None] - x[None, :])**2
Kf = sf**2 * np.exp(-0.5 * D2 / l**2)
Ky = Kf + SN**2 * np.eye(len(x))
Kinv = np.linalg.inv(Ky)          # yalnız bu küçük doğrulama için
a = Kinv @ yc
dK = Kf * D2 / l**2               # ∂K/∂(log ℓ)
grad = 0.5 * np.trace((np.outer(a, a) - Kinv) @ dK)
$\ell = 0{,}3$'te analitik gradyan 2,442631, merkezi sonlu fark 2,442631: altı basamak aynı. Pozitif işaret, $\ell$'yi büyütmenin olabilirliği artıracağını söyler. $\ell = 0{,}411$'de (en iyi değer) ikisi de 0,000001, yani sıfır; en iyi noktada gradyanın sıfır olması beklenen sonuçtur. scikit-learn de hiperparametreleri en iyilerken bu analitik gradyanı kullanır.
Özet
- Gauss süreci, fonksiyonlar üzerinde bir dağılımdır. Sonsal ortalama ve varyans koşullu normal dağılımdan kapalı biçimde gelir ve Cholesky ayrışımıyla birkaç satırda hesaplanır.
- Çekirdek ve hiperparametreleri modelin varsayımlarıdır. Marjinal olabilirlik, veri uyumu ile karmaşıklık arasında dengeyi kendiliğinden kurar; bant ancak bu varsayımlar kadar güvenilirdir.
- Belirsizlik bir karar aracıdır: AK-MCS, $U = \lvert\mu\rvert/\sigma$ ile pahalı modeli yalnızca sınırın yakınında çağırarak $10^6$ yerine 17 çağrıyla aynı göçme olasılığını buldu.
- Bölünmüş uyumlu tahmin, dağılım varsayımı olmadan marjinal kapsama güvencesi verir; CQR genişliği girdiye uyarlar. Bootstrap yayılımı ölçüm saçılımını değil, model belirsizliğini ölçer.
Bu derste fizik, yalnızca veriyi üreten simülasyondaydı. Sonraki derste bir adım öteye geçip kiriş denklemini doğrudan sinir ağının kayıp fonksiyonuna koyacağız: fizik bilgili sinir ağları.
Kaynaklar
- C. E. Rasmussen, C. K. I. Williams — Gaussian Processes for Machine Learning, MIT Press, 2006, Bölüm 2 (regresyon, Algoritma 2.1) ve Bölüm 5 (marjinal olabilirlik).
- B. Echard, N. Gayton, M. Lemaire — “AK-MCS: An active learning reliability method combining Kriging and Monte Carlo Simulation”, Structural Safety, 33(2), 2011.
- A. N. Angelopoulos, S. Bates — “A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification”, arXiv:2107.07511; Y. Romano, E. Patterson, E. Candès — “Conformalized Quantile Regression”, NeurIPS 2019.
- O. Ditlevsen, H. O. Madsen — Structural Reliability Methods, Wiley, 1996; scikit-learn — Gaussian Processes belgesi.