Bu derste öğrenecekleriniz
- Korelasyonlu ağaçların ortalamasının varyansını ($\rho\sigma^2 + (1-\rho)\sigma^2/B$) türetmek ve ölçümle sınamak
- Bootstrap, torbalama, torba dışı (OOB) hata ve rastgele ormanın
max_featuresayarını açıklamak - Gradyan artırmayı fonksiyon uzayında gradyan inişi olarak türetmek ve sıfırdan yazmak
- XGBoost ve HistGradientBoosting'i doğrulama kümesiyle erken durdurarak eğitmek
- Modelleri çapraz doğrulamayla karşılaştırmak; ağaçların veri aralığı dışındaki davranışını göstermek
- Safsızlık ve permütasyon önemini, kısmi bağımlılık grafiklerini doğru yorumlamak
1. Problem: tek ağaçtan topluluğa
Bir beton karışımının basınç dayanımını karışım oranlarından tahmin etmek, malzeme laboratuvarlarının klasik problemidir. Ders 04'te bu problemi doğrusal modellerle çözdük ve su/bağlayıcı oranı gibi anlamlı özelliklerin ne kadar fark yarattığını gördük. Ders 07'deki karar ağaçları ise özellik mühendisliği yapmadan doğrusal olmayan ilişkileri ve etkileşimleri kendiliğinden yakalıyordu. Ama tek bir ağacın iki kusuru vardı. Varyansı yüksektir: veride küçük bir değişiklik bambaşka bir ağaç üretir. Tahmini de basamaklıdır ve veri aralığının dışında sabit kalır.
Bu derste ağaçları bir araya getirmenin iki yolunu öğreneceğiz. Torbalama (bagging) ve rastgele orman (random forest), çok sayıda derin ağacın ortalamasını alarak varyansı düşürür. Artırma (boosting) ise sığ ağaçları sırayla ekler. Her yeni ağaç, o ana kadarki topluluğun hatasını biraz düzeltir; böylece yanlılık düşer. İki aile de topluluk (ensemble) yöntemidir: tek başına zayıf ya da kararsız modellerden daha iyi bir model kurar.
Veri, Ders 04'teki üreticiden gelen 800 sentetik karışımdır. Her satırda çimento, cüruf, uçucu kül, su ve süper akışkanlaştırıcı miktarı (kg/m³), iri ve ince agrega, yaş (3–90 gün), çimento tipi (üç sınıf), kalıp numarası ve ortam sıcaklığı bulunur. Hedef, basınç dayanımıdır: 12,0–64,2 MPa aralığında, ortalaması 37,2 MPa. Dayanım üç adımda üretildi. Önce su/bağlayıcı oranı hesaplanır: s/b = su / (çimento + 0,6·cüruf + 0,4·uçucu kül). Cüruf ve uçucu kül, bağlayıcıya daha düşük etkinlikle katılır. Ardından 28 günlük dayanım hesaplanır. Formüldeki $96{,}5/7^{\,s/b}$ terimi Abrams yasasıdır; diğer iki terim üreticinin varsayımlarıdır:
$$ f_{28} = \frac{96{,}5}{7^{\,s/b}}\;k_{\text{tip}} + 0{,}25\,\text{SA} $$$k_{\text{tip}}$, çimento sınıfının etkisini temsil eden bir çarpandır (1,00 / 0,97 / 0,88); SA ise süper akışkanlaştırıcı miktarıdır (kg/m³). Gerçekte süper akışkanlaştırıcı dayanımı asıl olarak su ihtiyacını azaltarak, yani s/b üzerinden etkiler; buradaki ayrı terim bir eğitim varsayımıdır. 96,5 ve 7 sabitleri de eğitim için seçildi; gerçek bir karışımda bu sabitler kullanılan malzemelerle yapılan deneylerden bulunur. Son adımda yaş etkisi EN 1992-1-1'deki zamana bağlı dayanım katsayısıyla eklenir:
$$ \beta_{cc}(t) = \exp\!\Big[s\Big(1-\sqrt{28/t}\,\Big)\Big] $$$s$, çimentonun sertleşme hızına bağlıdır. Üreticideki üç çimento EN 1992-1-1'in sınıflarına şöyle eşlendi: CEM I 42,5 R → R (hızlı), $s$ = 0,20; CEM II/A-LL 42,5 N → N (normal), $s$ = 0,25; CEM III/A 32,5 N → S (yavaş), $s$ = 0,38. Dayanım $f = f_{28}\,\beta_{cc}(t)\,\varepsilon$'dur; $\varepsilon$ yaklaşık %7 saçılımlı log-normal bir gürültüdür. İri ve ince agrega, kalıp numarası ve ortam sıcaklığı üretimde hiç kullanılmadı. Gerçek betonda agrega ve kür sıcaklığı dayanımı etkiler; burada bu dört sütunu, önem ölçülerini sınamak için bilerek ilgisiz bıraktık.
Gerçek fonksiyonu bildiğimiz için ulaşılabilecek en iyi hatayı da hesaplayabiliyoruz. %7'lik gürültü yüzünden kusursuz bir model bile yeni karışımlarda ortalama 2,70 MPa RMSE ile tahmin eder. Buna gürültü tabanı diyeceğiz ve bütün sonuçları bu sayıyla karşılaştıracağız.
Bu bir karışım tasarımı aracı değil
Veri sentetiktir ve Abrams yasasıyla EN 1992-1-1'deki yaş katsayısından türetilmiştir; gerçek bir laboratuvarın deney kayıtlarını temsil etmez. Gerçek projelerde beton sınıfı ve karışım tasarımı ilgili standartlara ve numune deneylerine göre belirlenir. Bu dersteki modeller, yöntemleri karşılaştırmak için kurulmuş eğitim örnekleridir.
2. Ortalama almak neden işe yarar?
Aynı büyüklüğü birbirinden bağımsız $B$ cihazla ölçüp ortalarsanız, ortalamanın varyansı tek bir ölçümünkinin $1/B$'sine iner. Ağaçlar için durum biraz farklıdır: hepsi aynı veriden öğrenir, bu yüzden hataları birbiriyle ilişkilidir. Bu ilişkiyi formüle katalım.
$T_b(x)$, $b$'inci ağacın $x$ noktasındaki tahmini olsun. Eğitim verisi ve ağacın kendi rastgeleliği (bootstrap örneği, özellik seçimi) yüzünden bu tahmin bir rastgele değişkendir. Bütün ağaçlar aynı dağılımdan gelsin: her birinin varyansı $\sigma^2$, herhangi iki ağacın tahminleri arasındaki korelasyon $\rho$ olsun. Topluluk tahmini ağaçların ortalamasıdır:
$$ \bar f_B(x) = \frac{1}{B}\sum_{b=1}^{B} T_b(x) $$Bu ortalamanın varyansı:
$$ \operatorname{Var}\big[\bar f_B(x)\big] = \rho\,\sigma^2 + \frac{1-\rho}{B}\,\sigma^2 $$Korelasyonlu değişkenlerin ortalamasının varyansı
Bir toplamın varyansı, bütün ikililerin kovaryanslarının toplamıdır:
$$ \operatorname{Var}\big[\bar f_B\big] = \frac{1}{B^2}\sum_{b,\,b'}\operatorname{Cov}\big(T_b, T_{b'}\big) $$Toplamda $B$ tane köşegen terim $\sigma^2$, $B(B-1)$ tane köşegen dışı terim ise $\rho\sigma^2$'dir:
$$ \operatorname{Var}\big[\bar f_B\big] = \frac{B\sigma^2 + B(B-1)\,\rho\sigma^2}{B^2} $$Kesri sadeleştirince $\sigma^2/B + \rho\sigma^2 - \rho\sigma^2/B$ kalır; terimleri toplayınca yukarıdaki formül çıkar.
$\rho = 0$ için tanıdık $\sigma^2/B$ sonucu, $\rho = 1$ için ise $\sigma^2$ çıkar: birbirinin kopyası olan ağaçların ortalaması hiçbir şey kazandırmaz.
Formülden üç sonuç çıkar:
- Ağaç sayısını artırmak zarar vermez ama kazanç doyar. $B \to \infty$ iken ikinci terim kaybolur, varyans $\rho\sigma^2$'nin altına inemez.
- Daha aşağı inmenin yolu $\rho$'yu düşürmektir. Ağaçlar birbirinden ne kadar farklıysa ortalama o kadar çok kazandırır. Rastgele ormanın bütün fikri budur.
- Ortalama almak yanlılığı değiştirmez. $\E[\bar f_B] = \E[T_b]$ olduğu için topluluk, tek bir ağacın sistematik hatasını aynen taşır. Bu yüzden ortalaması alınacak ağaçlar yanlılığı düşük, varyansı yüksek modeller olmalıdır: budanmamış derin ağaçlar.
Ders 03'teki yanlılık–varyans ayrışımı bu tabloyu tamamlar. $m(x) = \E[y \mid x]$ gerçek fonksiyon, $\sigma_\varepsilon^2$ indirgenemez gürültü olmak üzere, yeni bir noktadaki beklenen kare hata üç parçaya ayrılır:
$$ \begin{aligned} \E\big[(y-\bar f_B)^2\big] = {}& \big(\E[\bar f_B]-m\big)^2 \\ &+ \operatorname{Var}\big[\bar f_B\big] + \sigma_\varepsilon^2 \end{aligned} $$Torbalama ve rastgele orman yalnızca ortadaki terimi küçültür. Artırma ise asıl olarak ilk terimi, yani yanlılığı hedefler.
3. Torbalama ve rastgele orman
Bootstrap ve torbalama
Elimizde tek bir eğitim kümesi varken birbirinden farklı ağaçları nasıl üretiriz? Bootstrap cevabı: $n$ gözlemlik kümeden, yerine koyarak $n$ çekim yapılır. Bazı gözlemler iki üç kez gelir, bazıları hiç gelmez. Belirli bir gözlemin bir örnekte bulunma olasılığı:
$$ 1-\Big(1-\frac1n\Big)^n \;\to\; 1-e^{-1} \approx 0{,}632 $$$n$ = 800 için formül 0,632 veriyor; kodda 200 bootstrap örneğinin ortalaması 0,633 çıktı. Torbalama (bootstrap aggregating), her bootstrap örneğine derin bir ağaç uydurur ve tahminlerin ortalamasını alır (Breiman, 1996). Sınıflandırmada ortalama yerine çoğunluk oyu ya da olasılıkların ortalaması kullanılır.
Her ağacın görmediği yaklaşık %37'lik gözlemler bedava bir doğrulama kümesidir. Bir gözlem için yalnızca onu görmeyen ağaçların ortalamasını alıp gerçek değerle karşılaştırırsak torba dışı (out-of-bag, OOB) hatayı elde ederiz. scikit-learn'de oob_score=True bunu yapar. Ayrı bir doğrulama kümesine veri ayıramayacak kadar küçük veri kümelerinde çok kullanışlıdır.
Rastgele orman: ağaçları birbirinden uzaklaştırmak
Torbalamada bütün ağaçlar aynı güçlü özellikleri görür. Bir iki özellik çok güçlüyse hemen her ağaç ilk bölmesini onlarla yapar; ağaçlar benzeşir ve $\rho$ büyür. Rastgele orman (Breiman, 2001) her bölmede bütün $p$ özelliğe değil, rastgele seçilmiş $m$ tanesine bakar. scikit-learn'deki adı max_features'tır. Bunun iki etkisi vardır:
- Ağaçlar farklı özelliklerle bölünür, aralarındaki korelasyon $\rho$ düşer.
- Her ağaç tek başına kötüleşir: bazı bölmeler zayıf ya da ilgisiz bir sütunla yapılmak zorunda kalır, $\sigma^2$ ve yanlılık artar.
Hangisinin ağır basacağı veriye bağlıdır; $m$ bir hiperparametredir. Yöntemin yazarlarının önerdiği başlangıç değerleri regresyon için $m = p/3$, sınıflandırma için $m = \sqrt p$'dir (Hastie, Tibshirani ve Friedman, ESL Bölüm 15). Dikkat: scikit-learn'de RandomForestRegressor'ın varsayılanı max_features=1.0'dır, yani özellik alt örneklemesi yapmaz ve aslında torbalamadır.
Bir adım ileri giden aşırı rastgele ağaçlar (Extra-Trees; Geurts, Ernst ve Wehenkel, 2006), aday özelliklerde en iyi eşiği aramaz, her biri için rastgele bir eşik çeker ve en iyisini seçer. scikit-learn'deki ExtraTreesRegressor varsayılan olarak bootstrap da yapmaz. Ağaçlar daha da farklılaşır, eğitim daha hızlıdır. Gürültülü verilerde rastgele ormandan iyi sonuç verebilir, ama yine aynı ödünleşimle: daha düşük $\rho$, daha zayıf tek ağaçlar.
Varyans formülünü sınamak için $\sigma^2$ ile $\rho$'yu ölçmemiz gerekir. Bu iki sayı, “başka bir eğitim kümesi gelseydi” sorusuyla tanımlıdır. Gerçek bir projede elimizde tek bir küme vardır. Sentetik verinin avantajı burada ortaya çıkar: aynı üreticiden istediğimiz kadar yeni eğitim kümesi çekebiliriz. Kodda 16 yeni küme çekip her birinde 40 ağaçlık bir orman eğittik ve her ağacın 400 sabit noktadaki tahminini sakladık:
for r in range(R):
    d = beton_verisi(800, np.random.default_rng(100 + r))   # aynı süreçten yeni eğitim kümesi
    orman = RandomForestRegressor(B, max_features=max_features, random_state=r, n_jobs=1)
    orman.fit(ozellikler(d).to_numpy(), d["dayanim_mpa"].to_numpy())
    T[r] = [agac.predict(X_sabit) for agac in orman.estimators_]
$\sigma^2$, tek tek ağaç tahminlerinin varyansıdır. $\rho$ ise aynı eğitim kümesinden gelen ağaç çiftlerinin kovaryansının $\sigma^2$'ye oranıdır. İkisi de 400 noktanın ortalaması olarak hesaplanır. Formülü dürüstçe sınamak için bu iki sayıyı ağaçların ikinci yarısından (21–40) tahmin ettik ve formülün öngörüsünü ilk yarıdaki ağaçlarla kurulan 1, 2, 5, 10 ve 20 ağaçlık toplulukların ölçülen varyansıyla karşılaştırdık. Aynı ağaçlarla hem tahmin edip hem sınasaydık, $B$ = 40'ta eşitlik cebirsel olarak kendiliğinden sağlanırdı.
4. Artırma: artıklara ağaç eklemek
Artırmanın fikri, mühendislikteki ardışık düzeltmeye benzer. Önce kaba bir tahmin yapılır, sonra kalan hataya bakılıp küçük bir düzeltme eklenir, bu döngü tekrarlanır. Regresyonda en kaba tahmin sabit bir sayıdır, yani hedefin ortalaması: $F_0(x) = \bar y$. Ardından her adımda:
- Artıkları hesapla: $r_i = y_i - F_{m-1}(x_i)$.
- Artıklara sığ bir ağaç $T_m$ uydur (bizde derinlik 2).
- Modeli güncelle:
$\eta$ öğrenme hızıdır; burada küçültme (shrinkage) diye de anılır. Her ağaç, hatanın yalnızca küçük bir kısmını düzeltir.
Fonksiyon uzayında gradyan inişi
Friedman (2001) bu algoritmanın neden çalıştığını şöyle açıklar. Kayıp fonksiyonu $L = \sum_i \tfrac12\big(y_i - F(x_i)\big)^2$ olsun ve $n$ tane $F(x_i)$ değerini parametre gibi düşünelim. Kaybın bu parametrelere göre negatif gradyanı:
$$ -\frac{\partial L}{\partial F(x_i)} = y_i - F(x_i) = r_i $$Yani artık, tam olarak negatif gradyandır. Artıklara ağaç uydurmak, gradyan yönünü bir ağaçla yaklaşık temsil etmek demektir. Ağacın avantajı, bu yönü eğitimde görülmeyen yeni $x$'lerde de hesaplayabilmesidir. $\eta$ ile çarpıp eklemek ise Ders 02'deki gradyan inişi adımının aynısıdır, yalnız parametreler yerine fonksiyonun kendisi güncellenir. Bu yüzden yönteme gradyan artırma (gradient boosting) denir.
Bu bakış, yöntemi başka kayıplara genişletir. Mutlak hata $|y - F|$ için negatif gradyan $\operatorname{sign}(y - F)$ olur; ağaç bu sözde artıklara (pseudo-residual) uydurulur. Lojistik kayıpla da sınıflandırma yapılır (Ders 05). Alıştırma 5'te mutlak hatayı deneyeceksiniz.
def gradyan_artirma(X, y, n_agac, ogrenme_hizi, derinlik=2, tohum=42):
    """Kare hata için gradyan artırma: her yeni ağaç o anki artıklara uydurulur."""
    rs = np.random.RandomState(tohum)       # scikit-learn ile aynı eşitlik bozma sırası
    f0 = y.mean()                           # F_0: en iyi sabit tahmin
    F = np.full(len(y), f0)
    agaclar = []
    for _ in range(n_agac):
        artik = y - F                       # −∂L/∂F, L = ½(y − F)²
        agac = DecisionTreeRegressor(max_depth=derinlik, random_state=rs).fit(X, artik)
        F += ogrenme_hizi * agac.predict(X)  # fonksiyon uzayında küçük bir adım
        agaclar.append(agac)
    return f0, agaclar


def asamali_tahmin(f0, agaclar, ogrenme_hizi, X):
    """1, 2, …, M ağaçlı modellerin tahminleri (M × n)."""
    katki = np.array([agac.predict(X) for agac in agaclar])
    return f0 + ogrenme_hizi * np.cumsum(katki, axis=0)
Bu iki fonksiyon, scikit-learn'ün GradientBoostingRegressor'ı ile aynı tahmini veriyor: 200 ağaçta iki uygulama arasındaki en büyük fark 7,1×10⁻¹⁴ MPa. Tek incelik random_state=rs satırındadır. Bir ağaç, kazancı tam olarak eşit iki bölmeyle karşılaştığında rastgele bir özellik sırasına göre seçim yapar. Örneğin tek bir aykırı gözlemi ayıran bölme, birçok sütunla aynı kazancı verebilir. scikit-learn her aşamada aynı RandomState nesnesini kullanır; biz de öyle yapınca aynı ağaçlar kurulur. Tamsayı bir tohumla eğitim tahminleri yine aynı çıkar, ama yeni noktalardaki tahminler eşitlik bozmaya göre biraz değişebilir.
Torbalama ile artırma neden zıt ağaçlar kullanır?
Torbalama, yanlılığı düşük ama varyansı yüksek derin ağaçların ortalamasını alır ve varyansı düşürür. Artırma ise yanlılığı yüksek ama varyansı düşük sığ ağaçları üst üste ekler ve yanlılığı düşürür. Derinlik 2'lik bir ağaç en fazla iki özelliğin etkileşimini temsil eder; artırma bu küçük parçaları toplayarak karmaşık bir yüzey kurar. Bir fark daha var: torbalamada ağaç eklemek aşırı uyum yaratmaz, artırmada ise yaratır. Bu yüzden artırmada ağaç sayısını doğrulama verisiyle seçmek gerekir.
5. XGBoost, HistGradientBoosting ve hiperparametreler
XGBoost (Chen ve Guestrin, 2016) gradyan artırmayı iki yönden geliştirir. Kaybın yalnız birinci değil ikinci türevini de kullanır ve yaprak değerlerini doğrudan düzenlileştirir. $m$'inci adımda eklenecek ağacın $J$ yaprağı ve yaprak değerleri $w_j$ olsun. $g_i$ ve $h_i$, kaybın $F(x_i)$'ye göre birinci ve ikinci türevleri olmak üzere, en iyilenecek amaç:
$$ \begin{aligned} \mathcal L^{(m)} \approx {}& \sum_{i} g_i\,T_m(x_i) \\ &+ \tfrac12\sum_{i} h_i\,T_m(x_i)^2 \\ &+ \gamma J + \tfrac12\lambda\sum_{j} w_j^2 \end{aligned} $$Ağacın yapısı sabitken her yaprağın en iyi değeri kapalı biçimde bulunur. $G_j$ ve $H_j$, yaprağa düşen gözlemlerin $g_i$ ve $h_i$ toplamlarıdır:
$$ w_j^{*} = -\frac{G_j}{H_j + \lambda} $$Kare hata için yaprak değeri ve bölme kazancı
Kare hata $\tfrac12(y - F)^2$ için $g_i = F(x_i) - y_i = -r_i$ ve $h_i = 1$'dir. Yaprakta $n_j$ gözlem varsa:
$$ w_j^{*} = \frac{\sum_{i \in j} r_i}{n_j + \lambda} $$$\lambda = 0$ iken bu, yapraktaki artıkların ortalamasıdır; sıfırdan yazdığımız sürüm tam olarak budur. $\lambda > 0$ ise az gözlemli yaprakların değerini sıfıra doğru çeker. Amaca $w_j^*$'ı geri koymak, bir ağaç yapısının değerini verir: $-\tfrac12\sum_j G_j^2/(H_j+\lambda) + \gamma J$. Bir yaprağı sol (L) ve sağ (R) diye bölmenin kazancı da buradan çıkar:
$$ \begin{aligned} \text{Kazanç} = {}& \frac{G_L^2}{2(H_L+\lambda)} \\ &+ \frac{G_R^2}{2(H_R+\lambda)} \\ &- \frac{(G_L+G_R)^2}{2(H_L+H_R+\lambda)} \\ &- \gamma \end{aligned} $$Kazanç negatifse bölme yapılmaz. Başka bir deyişle, $\gamma$ çıkarılmadan önceki kayıp azalması $\gamma$'dan küçükse yaprak bölünmez; $\gamma$ bu yüzden bir budama eşiği gibi çalışır.
scikit-learn'deki HistGradientBoostingRegressor aynı fikri başka bir hızlandırmayla uygular. Her özelliği en fazla 255 kutuya (histogram) böler ve bölmeleri kutu sınırlarında arar. Büyük veride çok hızlıdır, eksik değerleri ve kategorik özellikleri doğrudan işler. Bizim 800 satırlık veride hız farkı önemsizdir. Önemli hiperparametreler (önce XGBoost, sonra HistGradientBoosting adı) ve bu derste kullandığımız değerler:
n_estimators/max_iter: ağaç sayısının üst sınırı; asıl sayıyı erken durdurma seçer. Bu derste ikisinde de 2000.learning_rate: adım büyüklüğü $\eta$; küçüldükçe daha çok ağaç gerekir. Bu derste 0,05.max_depth/max_leaf_nodes: ağacın karmaşıklığı. Derinlik $d$ olan bir ağaç en fazla $d$ özelliğin etkileşimini temsil eder. Bu derste derinlik 3 / en çok 15 yaprak.subsamplevecolsample_bytree(XGBoost): her ağaç için satırların ve sütunların bir kısmını kullanmak. Satır örneklemesine stokastik gradyan artırma denir; ağaçları çeşitlendirir ve varyansı düşürür. Bu derste 0,8 ve 0,8.min_child_weight/min_samples_leaf: yapraktaki en küçük $H_j$ (kare hatada gözlem sayısı) ya da en az gözlem. Bu derste 1 / 10.reg_lambda/l2_regularization: yaprak değerlerine L2 cezası $\lambda$. Bu derste ikisinde de 1.early_stopping_rounds/n_iter_no_change: doğrulama hatası kaç tur iyileşmezse durulacağı. Bu derste ikisinde de 50.
Erken durdurma (early stopping), artırmanın en önemli düzenlileştiricisidir. Her ağaçtan sonra ayrı bir doğrulama kümesindeki hata izlenir. Hata belirli sayıda tur iyileşmezse eğitim durur ve en iyi noktadaki ağaç sayısı kullanılır. Bu doğrulama kümesi test kümesinden ayrı olmalıdır. Çapraz doğrulamada ise her eğitim katının içinden ayrı bir doğrulama parçası ayrılır; kodda bunun için her katın %15'ini kullandık.
İki kütüphane erken durdurmayı farklı uygular
XGBoost'un scikit-learn arayüzünde erken durdurma kullanıldıysa predict, varsayılan olarak en iyi iterasyona kadar olan ağaçları kullanır; kod bunu bir assert ile denetliyor. HistGradientBoostingRegressor ise durduğu andaki bütün ağaçları tutar. Son n_iter_no_change ağaç doğrulama hatasını iyileştirmemiş olsa bile modelde kalır. Küçük öğrenme hızında fark önemsizdir, ama raporladığınız ağaç sayısının ne anlama geldiğini bilin.
6. Çalıştırılabilir kod
Kod yedi bölümden oluşur: veri, torbalama ve rastgele orman deneyi, sıfırdan gradyan artırma, kütüphanelerle erken durdurma, beş katlı çapraz doğrulama, yorumlama ve grafikler. Ortak beton üreticisi beton_verisi, betiğin tek başına çalışabilmesi için dosyanın içine kopyalandı. Betik 2 çekirdekli bir bilgisayarda yaklaşık yarım dakika sürer. En başta OMP_NUM_THREADS=1 ayarlanır; küçük veride HistGradientBoosting tek iş parçacığıyla hem daha hızlı hem de tam tekrarlanabilir çalışır.
"""Ders 08 — Topluluk yöntemleri: Random Forest ve Gradient Boosting.

Sentetik beton karışımı verisinden 800 numunenin basınç dayanımını tahmin ediyoruz:
  * torbalama ve rastgele ormanın varyansı nasıl düşürdüğünü, aynı üreticiden çekilen
    16 farklı eğitim kümesiyle ölçüyoruz (Var = ρσ² + (1−ρ)σ²/B formülünün sınaması),
  * gradyan artırmayı (gradient boosting) sıfırdan yazıp scikit-learn ile karşılaştırıyoruz,
  * HistGradientBoosting ve XGBoost'u doğrulama kümesiyle erken durduruyoruz,
  * beş katlı çapraz doğrulamayla doğrusal modellerle kıyaslıyoruz,
  * modeli permütasyon önemi ve kısmi bağımlılıkla yorumluyoruz.

Veri sentetiktir (Ders 04'teki beton_verisi üreticisi): dayanım Abrams yasası ve EN 1992-1-1'deki
yaş katsayısı β_cc(t) ile, %7 log-normal gürültüyle üretilir. Gerçek deney verisi değildir.

Çalıştır:  python d08_topluluk.py
Gerekenler: numpy, pandas, scikit-learn, xgboost, matplotlib  (Python 3.12+)
Süre:      2 çekirdekli bir bilgisayarda yaklaşık yarım dakika
Çıktılar:  terminale sayılar, aynı klasöre dört PNG grafiği
"""
import os
os.environ.setdefault("OMP_NUM_THREADS", "1")  # küçük veride tek iş parçacığı: hızlı ve tekrarlanabilir

from collections import Counter
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D
from matplotlib.patches import Patch
from matplotlib.ticker import NullFormatter
from sklearn.ensemble import (GradientBoostingRegressor, HistGradientBoostingRegressor,
                              RandomForestRegressor)
from sklearn.inspection import permutation_importance
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import KFold
from sklearn.tree import DecisionTreeRegressor
from xgboost import XGBRegressor

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent


# --- Ortak beton verisi üreticisi (kurs genelinde aynı; Ders 04 ile aynı fonksiyon) ---
def beton_verisi(n, rng, eksik_oran=0.0):
    """Sentetik beton karışımı verisi (eğitim amaçlı; gerçek deney verisi değildir).

    Dayanım, Abrams yasası (f = 96,5 / 7^(s/b) MPa) ve EN 1992-1-1'deki yaş katsayısı
    β_cc(t) = exp(s·(1 − √(28/t))) ile üretilir; s/b oranında cüruf ve uçucu kül, EN 206'daki
    k-değeri kavramına benzer biçimde 0,6 ve 0,4 etkinlikle bağlayıcıya katılır.
    """
    cimento = rng.uniform(250, 500, n)                                   # kg/m³
    curuf = np.where(rng.random(n) < 0.4, rng.uniform(20, 200, n), 0.0)  # kg/m³
    ucucu_kul = np.where(rng.random(n) < 0.3, rng.uniform(20, 150, n), 0.0)
    su = rng.uniform(150, 210, n)                                        # kg/m³
    super_akiskan = np.where(rng.random(n) < 0.6, rng.uniform(2, 12, n), 0.0)
    iri_agrega = rng.uniform(850, 1100, n)
    ince_agrega = rng.uniform(650, 900, n)
    yas_gun = rng.choice([3, 7, 14, 28, 56, 90], n, p=[.12, .2, .13, .3, .13, .12])
    tipler = np.array(["CEM I 42,5 R", "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"])
    tip_no = rng.choice(3, n, p=[.45, .35, .20])
    s_katsayi = np.array([0.20, 0.25, 0.38])[tip_no]      # EN 1992-1-1, Bağıntı 3.2: R, N, S sınıfı
    sinif_carpani = np.array([1.00, 0.97, 0.88])[tip_no]  # varsayım: dayanım sınıfı etkisi
    kalip_no = rng.integers(1, 21, n)                    # ilgisiz özellik
    ortam_sicakligi = rng.uniform(5, 30, n)              # ilgisiz özellik (bu üreticide)

    sb = su / (cimento + 0.6 * curuf + 0.4 * ucucu_kul)  # su / etkin bağlayıcı
    f28 = 96.5 / 7.0 ** sb * sinif_carpani + 0.25 * super_akiskan
    beta = np.exp(s_katsayi * (1 - np.sqrt(28 / yas_gun)))
    dayanim = f28 * beta * rng.lognormal(0.0, 0.07, n)

    df = pd.DataFrame({
        "cimento": cimento, "curuf": curuf, "ucucu_kul": ucucu_kul, "su": su,
        "super_akiskan": super_akiskan, "iri_agrega": iri_agrega, "ince_agrega": ince_agrega,
        "yas_gun": yas_gun, "cimento_tipi": tipler[tip_no], "kalip_no": kalip_no,
        "ortam_sicakligi": ortam_sicakligi, "dayanim_mpa": dayanim,
    })
    if eksik_oran > 0:
        df.loc[rng.random(n) < eksik_oran, "super_akiskan"] = np.nan
    return df


# Üreticideki sabitler: gürültüsüz "gerçek" fonksiyonu yazmak için (yalnız denetim ve grafikte)
TIPLER = ["CEM I 42,5 R", "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"]
KISA = {"CEM I 42,5 R": "CEM I", "CEM II/A-LL 42,5 N": "CEM II/A-LL", "CEM III/A 32,5 N": "CEM III/A"}
S_KATSAYI = dict(zip(TIPLER, [0.20, 0.25, 0.38]))
SINIF = dict(zip(TIPLER, [1.00, 0.97, 0.88]))
SIGMA_LN = 0.07                       # log-normal gürültünün parametresi
ILGISIZ = ["iri_agrega", "ince_agrega", "kalip_no", "ortam_sicakligi"]   # üretimde kullanılmayan


def su_baglayici(d):
    return d["su"] / (d["cimento"] + 0.6 * d["curuf"] + 0.4 * d["ucucu_kul"])


def gercek_ortalama(d, sb=None, yas=None):
    """Gürültüsüz ortalama E[dayanım | x] (MPa). sb veya yas verilirse o değere sabitlenir."""
    sb = su_baglayici(d) if sb is None else sb
    yas = d["yas_gun"] if yas is None else yas
    f28 = 96.5 / 7.0 ** sb * d["cimento_tipi"].map(SINIF) + 0.25 * d["super_akiskan"]
    beta = np.exp(d["cimento_tipi"].map(S_KATSAYI) * (1 - np.sqrt(28 / yas)))
    return np.asarray(f28 * beta, dtype=float) * np.exp(SIGMA_LN**2 / 2)  # log-normalin ortalaması


def ozellikler(d, sb=None, yas=None, sb_sutunu=False):
    """Ham sütunlar (çimento tipi üç ikili sütun); istenirse s/b sütunu eklenir."""
    X = d.drop(columns=["dayanim_mpa", "cimento_tipi"]).copy()
    if yas is not None:
        X["yas_gun"] = yas
    for tip in TIPLER:
        X[KISA[tip]] = (d["cimento_tipi"] == tip).astype(float)
    if sb_sutunu:
        X["s/b"] = su_baglayici(d) if sb is None else sb
    return X


def muhendislik(d, sb=None, yas=None, etkilesim=False):
    """Doğrusal model için: ham sütunlar + s/b + ln t (hedef: ln dayanım). Referans tip CEM I."""
    Z = ozellikler(d, sb=sb, yas=yas, sb_sutunu=True).drop(columns="CEM I")
    Z["ln_t"] = np.log(Z["yas_gun"])
    if etkilesim:  # çimento tipi sertleşme hızını değiştirir (β_cc'deki s katsayısı)
        Z["ln_t*CEM II"] = Z["ln_t"] * Z["CEM II/A-LL"]
        Z["ln_t*CEM III"] = Z["ln_t"] * Z["CEM III/A"]
    return Z


def rmse(a, b):
    return float(np.sqrt(np.mean((np.asarray(a) - np.asarray(b)) ** 2)))


# %% 1. Veri
rng = np.random.default_rng(42)
df = beton_verisi(800, rng)
y = df["dayanim_mpa"].to_numpy()
X = ozellikler(df)
ADLAR = list(X.columns)
m_gercek = gercek_ortalama(df)
taban = np.sqrt(np.mean(m_gercek**2 * (np.exp(SIGMA_LN**2) - 1)))   # gürültünün RMS'i = en iyi RMSE
print("=== 1. Veri ===")
print(f"Örnek: {len(df)}, özellik: {X.shape[1]} (çimento tipi 3 ikili sütun), "
      f"dayanım {y.min():.1f}–{y.max():.1f} MPa (ortalama {y.mean():.1f})")
print(f"Gürültü tabanı: gerçek fonksiyonun beklenen RMSE'si {taban:.2f} MPa")

# %% 2. Ortalama almak neden işe yarar? Aynı süreçten 16 eğitim kümesi
n = len(df)
print("\n=== 2. Torbalama ve rastgele orman: varyans ayrışımı ===")
tekil = np.mean([np.unique(rng.integers(0, n, n)).size / n for _ in range(200)])
print(f"Bootstrap örneğinde farklı gözlem oranı: {tekil:.3f} "
      f"(1 − (1 − 1/n)^n = {1 - (1 - 1/n)**n:.3f})")

d_sabit = beton_verisi(400, np.random.default_rng(7))       # x noktaları sabit tutulur
X_sabit = ozellikler(d_sabit).to_numpy()
m_sabit = gercek_ortalama(d_sabit)
gurultu = np.mean(m_sabit**2 * (np.exp(SIGMA_LN**2) - 1))    # indirgenemez hata (MPa²)
R, B = 16, 40
B_SINAMA = [1, 2, 5, 10, 20]       # formülü ağaçların ilk yarısıyla kurulan topluluklarda sınarız


def agac_tahminleri(max_features):
    """R eğitim kümesinin her birinde B ağaçlık orman; her ağacın sabit x'lerdeki tahmini."""
    T = np.empty((R, B, len(X_sabit)))
    for r in range(R):
        d = beton_verisi(800, np.random.default_rng(100 + r))   # aynı süreçten yeni eğitim kümesi
        orman = RandomForestRegressor(B, max_features=max_features, random_state=r, n_jobs=1)
        orman.fit(ozellikler(d).to_numpy(), d["dayanim_mpa"].to_numpy())
        T[r] = [agac.predict(X_sabit) for agac in orman.estimators_]
        if r == 0:   # ilk kümedeki ağaçlar ilk bölmeyi hangi sütunla yapıyor?
            kok = Counter(ADLAR[agac.tree_.feature[0]] for agac in orman.estimators_)
    return T, kok


def sigma_rho(U):
    """Tek ağacın varyansı σ² ve aynı kümeden iki ağacın korelasyonu ρ (x üzerinden ortalama)."""
    k = U.shape[1]
    sapma = U - U.mean(axis=(0, 1))
    sigma2 = (sapma**2).mean()
    kov = (sapma.sum(axis=1)**2 - (sapma**2).sum(axis=1)) / (k * (k - 1))   # b ≠ b' çiftleri
    return sigma2, kov.mean() / sigma2


def ayristir(T):
    """σ², ρ: ağaçların ikinci yarısından; sınama: ilk yarıdan kurulan b ağaçlı topluluklar."""
    sigma2, rho = sigma_rho(T[:, B // 2:])
    sinama = {b: (T[:, :b].mean(axis=1).var(axis=0).mean(),        # ölçülen varyans
                  rho * sigma2 + (1 - rho) * sigma2 / b)           # ρσ² + (1 − ρ)σ²/B
              for b in B_SINAMA}
    hata = {}
    for b in (1, B):
        f_b = T[:, :b].mean(axis=1)                                # b ağaçlı topluluk (R × x)
        hata[b] = (np.mean((f_b.mean(axis=0) - m_sabit)**2), f_b.var(axis=0).mean())  # yanlılık², varyans
    return sigma2, rho, sinama, hata


ayrisim, koklar = {}, {}
for ad, mf in [("Torbalama", 1.0), ("Rastgele orman", 1 / 3)]:
    T, koklar[ad] = agac_tahminleri(mf)
    sigma2, rho, sinama, hata = ayristir(T)
    ayrisim[ad] = (sigma2, rho, sinama, hata)
    print(f"{ad} (max_features={mf:.2f}): σ² = {sigma2:.2f}, ρ = {rho:.3f} | Var ölçülen/formül: "
          + ", ".join(f"B={b} {sinama[b][0]:.2f}/{sinama[b][1]:.2f}" for b in (5, 20)))
    for b in B_SINAMA:
        assert abs(sinama[b][0] / sinama[b][1] - 1) < 0.25
print("Kök bölmenin sütunu (ilk eğitim kümesi, 40 ağaç):")
print("   torbalama: " + ", ".join(f"{a} {k}" for a, k in koklar["Torbalama"].most_common())
      + " | rastgele orman: " + ", ".join(f"{a} {k}" for a, k in koklar["Rastgele orman"].most_common(4))
      + f", diğer {B - sum(k for _, k in koklar['Rastgele orman'].most_common(4))}")
print(f"Hata ayrışımı (MPa²)      yanlılık²  varyans  gürültü  toplam   RMSE")
for ad in ayrisim:
    for b in (1, B):
        y2, v = ayrisim[ad][3][b]
        etiket = f"{ad}, B={b}"
        print(f"  {etiket:22s} {y2:8.2f} {v:8.2f} {gurultu:8.2f} {y2 + v + gurultu:7.2f} "
              f"{np.sqrt(y2 + v + gurultu):6.2f}")

# Torba dışı (OOB) tahmin: her ağaç, bootstrap'a girmeyen ~%37'lik gözlemlerde sınanır
sira = rng.permutation(n)
egt, dog, tst = sira[:480], sira[480:640], sira[640:]   # eğitim / doğrulama / test
egt_dog = sira[:640]
orman = RandomForestRegressor(200, max_features=1 / 3, oob_score=True, random_state=42, n_jobs=1)
orman.fit(X.to_numpy()[egt_dog], y[egt_dog])
p_orman = orman.predict(X.to_numpy()[tst])
print(f"OOB (640 örnek): RMSE {rmse(orman.oob_prediction_, y[egt_dog]):.2f} MPa, R² {orman.oob_score_:.3f}"
      f" | ayrı test (160): RMSE {rmse(p_orman, y[tst]):.2f}, R² {r2_score(y[tst], p_orman):.3f}")


# %% 3. Gradyan artırma, sıfırdan
def gradyan_artirma(X, y, n_agac, ogrenme_hizi, derinlik=2, tohum=42):
    """Kare hata için gradyan artırma: her yeni ağaç o anki artıklara uydurulur."""
    rs = np.random.RandomState(tohum)       # scikit-learn ile aynı eşitlik bozma sırası
    f0 = y.mean()                           # F_0: en iyi sabit tahmin
    F = np.full(len(y), f0)
    agaclar = []
    for _ in range(n_agac):
        artik = y - F                       # −∂L/∂F, L = ½(y − F)²
        agac = DecisionTreeRegressor(max_depth=derinlik, random_state=rs).fit(X, artik)
        F += ogrenme_hizi * agac.predict(X)  # fonksiyon uzayında küçük bir adım
        agaclar.append(agac)
    return f0, agaclar


def asamali_tahmin(f0, agaclar, ogrenme_hizi, X):
    """1, 2, …, M ağaçlı modellerin tahminleri (M × n)."""
    katki = np.array([agac.predict(X) for agac in agaclar])
    return f0 + ogrenme_hizi * np.cumsum(katki, axis=0)


Xn = X.to_numpy()
print(f"\n=== 3. Gradyan artırma, sıfırdan (eğitim/doğrulama/test: {len(egt)}/{len(dog)}/{len(tst)}) ===")
egriler = {}
for eta, M in [(0.1, 1000), (0.3, 400), (1.0, 150)]:
    f0, agaclar = gradyan_artirma(Xn[egt], y[egt], M, eta)
    hata = {ad: np.sqrt(((asamali_tahmin(f0, agaclar, eta, Xn[i]) - y[i])**2).mean(axis=1))
            for ad, i in [("egitim", egt), ("dogrulama", dog), ("test", tst)]}
    egriler[eta] = hata
    m_en = int(hata["dogrulama"].argmin())     # erken durdurma: yalnız doğrulama hatasına bakılır
    print(f"η = {eta:3.1f}: en iyi M = {m_en + 1:3d} (doğrulama {hata['dogrulama'][m_en]:.2f}, "
          f"eğitim {hata['egitim'][m_en]:.2f}, test {hata['test'][m_en]:.2f}); "
          f"M = {M}: doğrulama {hata['dogrulama'][-1]:.2f}, eğitim {hata['egitim'][-1]:.2f}")
    if eta == 0.1:
        skl = GradientBoostingRegressor(n_estimators=200, learning_rate=0.1, max_depth=2, random_state=42)
        skl.fit(Xn[egt], y[egt])
        fark = np.abs(skl.predict(Xn[tst]) - asamali_tahmin(f0, agaclar[:200], eta, Xn[tst])[-1]).max()
        print(f"   scikit-learn GradientBoostingRegressor ile en büyük fark (200 ağaç): {fark:.1e} MPa")
        assert fark < 1e-8

# %% 4. Kütüphaneler: erken durdurma yalnız doğrulama kümesiyle
print("\n=== 4. HistGradientBoosting ve XGBoost (erken durdurma: doğrulama kümesi) ===")


def hgb_model():
    return HistGradientBoostingRegressor(learning_rate=0.05, max_iter=2000, max_leaf_nodes=15,
                                         min_samples_leaf=10, l2_regularization=1.0, early_stopping=True,
                                         n_iter_no_change=50, random_state=42)


def xgb_model():
    return XGBRegressor(n_estimators=2000, learning_rate=0.05, max_depth=3, subsample=0.8,
                        colsample_bytree=0.8, min_child_weight=1, reg_lambda=1.0,
                        early_stopping_rounds=50, eval_metric="rmse", random_state=42, n_jobs=1)


hgb = hgb_model().fit(Xn[egt], y[egt], X_val=Xn[dog], y_val=y[dog])
xgb = xgb_model().fit(Xn[egt], y[egt], eval_set=[(Xn[dog], y[dog])], verbose=False)
assert np.allclose(xgb.predict(Xn[tst]), xgb.predict(Xn[tst], iteration_range=(0, xgb.best_iteration + 1)))
print(f"HistGradientBoosting: {hgb.n_iter_} iterasyon | doğrulama {rmse(hgb.predict(Xn[dog]), y[dog]):.2f}, "
      f"test {rmse(hgb.predict(Xn[tst]), y[tst]):.2f} MPa")
print(f"XGBoost             : {xgb.best_iteration + 1} ağaç     | doğrulama "
      f"{rmse(xgb.predict(Xn[dog]), y[dog]):.2f}, test {rmse(xgb.predict(Xn[tst]), y[tst]):.2f} MPa")


# %% 5. Beş katlı çapraz doğrulama
def ic_bolme(k, oran=0.15):
    """Eğitim katının içinden erken durdurma için doğrulama parçası ayırır."""
    p = np.random.default_rng(0).permutation(k)
    j = int(round(oran * k))
    return p[j:], p[:j]


def dogrusal_ham(d_tr, d_te):
    model = LinearRegression().fit(ozellikler(d_tr).drop(columns="CEM I"), d_tr["dayanim_mpa"])
    return model.predict(ozellikler(d_te).drop(columns="CEM I"))


def dogrusal_muh(etkilesim):
    def tahmin(d_tr, d_te):
        model = LinearRegression().fit(muhendislik(d_tr, etkilesim=etkilesim), np.log(d_tr["dayanim_mpa"]))
        return np.exp(model.predict(muhendislik(d_te, etkilesim=etkilesim)))   # ln ölçeğinden geri
    return tahmin


def orman_model(mf):
    def tahmin(d_tr, d_te):
        model = RandomForestRegressor(100, max_features=mf, random_state=42, n_jobs=1)
        model.fit(ozellikler(d_tr).to_numpy(), d_tr["dayanim_mpa"])
        return model.predict(ozellikler(d_te).to_numpy())
    return tahmin


def artirma(kutuphane):
    def tahmin(d_tr, d_te):
        Xa, ya = ozellikler(d_tr).to_numpy(), d_tr["dayanim_mpa"].to_numpy()
        i_tr, i_val = ic_bolme(len(ya))
        if kutuphane == "hgb":
            model = hgb_model().fit(Xa[i_tr], ya[i_tr], X_val=Xa[i_val], y_val=ya[i_val])
        else:
            model = xgb_model().fit(Xa[i_tr], ya[i_tr], eval_set=[(Xa[i_val], ya[i_val])], verbose=False)
        return model.predict(ozellikler(d_te).to_numpy())
    return tahmin


MODELLER = {
    "Doğrusal, ham 13 sütun": dogrusal_ham,
    "Doğrusal, + s/b, ln t (ln hedef)": dogrusal_muh(False),
    "Doğrusal, + tip × ln t": dogrusal_muh(True),
    "Torbalama (100 ağaç)": orman_model(1.0),
    "Rastgele orman (100, p/3)": orman_model(1 / 3),
    "HistGradientBoosting": artirma("hgb"),
    "XGBoost": artirma("xgb"),
}
skor = {ad: [] for ad in MODELLER}
for i_tr, i_te in KFold(5, shuffle=True, random_state=42).split(df):
    d_tr, d_te = df.iloc[i_tr], df.iloc[i_te]
    for ad, tahmin in MODELLER.items():
        p = tahmin(d_tr, d_te)
        y_te = d_te["dayanim_mpa"].to_numpy()
        skor[ad].append([mean_absolute_error(y_te, p), rmse(p, y_te), r2_score(y_te, p)])
print("\n=== 5. Beş katlı çapraz doğrulama (ortalama ± std, MPa) ===")
print(f"{'Model':34s} {'MAE':>13s} {'RMSE':>13s} {'R²':>15s}")
for ad, s in skor.items():
    s = np.array(s)
    ort, std = s.mean(axis=0), s.std(axis=0, ddof=1)
    print(f"{ad:34s} {ort[0]:5.2f} ± {std[0]:4.2f}  {ort[1]:5.2f} ± {std[1]:4.2f}  "
          f"{ort[2]:6.3f} ± {std[2]:5.3f}")
    assert np.all(np.isfinite(s))
print(f"{'Gürültü tabanı (gerçek fonksiyon)':34s} {'':13s}  {taban:5.2f}")
fark = np.array(skor["XGBoost"])[:, 1] - np.array(skor["Doğrusal, + tip × ln t"])[:, 1]
print("Katlara göre RMSE farkı, XGBoost − doğrusal(+tip × ln t): "
      + " ".join(f"{f:+.2f}" for f in fark))

# %% 6. Yorumlama: safsızlık önemi ve permütasyon önemi (test kümesinde)
print("\n=== 6. Yorumlama ===")
perm = permutation_importance(orman, Xn[tst], y[tst], n_repeats=5, random_state=42,
                              scoring="neg_root_mean_squared_error")
mdi = orman.feature_importances_
sira_onem = np.argsort(-perm.importances_mean)
kullanilan = [j for j in sira_onem if ADLAR[j] not in ILGISIZ]   # üretimde kullanılan 9 sütun
print("Rastgele orman: permütasyon önemi (test RMSE artışı, MPa) / safsızlık önemi (MDI)")
print("  En önemli 5: "
      + ", ".join(f"{ADLAR[j]} {perm.importances_mean[j]:.2f}/{mdi[j]:.3f}" for j in kullanilan[:5]))
print("  Kullanılan diğer 4: "
      + ", ".join(f"{ADLAR[j]} {perm.importances_mean[j]:.2f}/{mdi[j]:.3f}" for j in kullanilan[5:]))
print("  İlgisiz: " + ", ".join(f"{a} {perm.importances_mean[ADLAR.index(a)]:.2f}/{mdi[ADLAR.index(a)]:.3f}"
                                 for a in ILGISIZ))
for a in ILGISIZ:   # permütasyon önemi ilgisiz sütunlarda sıfıra yakın olmalı
    assert abs(perm.importances_mean[ADLAR.index(a)]) < 0.15

# s/b sütunu eklenmiş XGBoost ve kısmi bağımlılık (PD)
Xs = ozellikler(df, sb_sutunu=True).to_numpy()
xgb_sb = xgb_model().fit(Xs[egt], y[egt], eval_set=[(Xs[dog], y[dog])], verbose=False)
ADLAR_SB = ADLAR + ["s/b"]
perm_sb = permutation_importance(xgb_sb, Xs[tst], y[tst], n_repeats=10, random_state=42,
                                 scoring="neg_root_mean_squared_error").importances_mean
print(f"XGBoost + s/b ({xgb_sb.best_iteration + 1} ağaç, test RMSE "
      f"{rmse(xgb_sb.predict(Xs[tst]), y[tst]):.2f}): permütasyon s/b "
      f"{perm_sb[ADLAR_SB.index('s/b')]:.2f}, su {perm_sb[ADLAR_SB.index('su')]:.2f}, "
      f"çimento {perm_sb[ADLAR_SB.index('cimento')]:.2f}, yaş {perm_sb[ADLAR_SB.index('yas_gun')]:.2f}")
d_pd = df.iloc[egt_dog]                       # PD, eğitim verisinin dağılımı üzerinden ortalanır
lin = LinearRegression().fit(muhendislik(d_pd, etkilesim=True), np.log(d_pd["dayanim_mpa"]))


def kismi_bagimlilik(alan, izgara):
    """Her ızgara değerinde alanı tüm satırlarda sabitle, tahminlerin ortalamasını al."""
    sonuc = {"gercek": [], "xgb": [], "dogrusal": []}
    for v in izgara:
        k = {alan: v}
        sonuc["gercek"].append(gercek_ortalama(d_pd, **k).mean())
        sonuc["xgb"].append(xgb_sb.predict(ozellikler(d_pd, sb_sutunu=True, **k).to_numpy()).mean())
        sonuc["dogrusal"].append(np.exp(lin.predict(muhendislik(d_pd, etkilesim=True, **k))).mean())
    return {a: np.array(b) for a, b in sonuc.items()}


sb_aralik = su_baglayici(d_pd).agg(["min", "max"]).to_numpy()
izgara_sb = np.linspace(0.15, 0.95, 41)
izgara_t = np.geomspace(1, 365, 41)
pd_sb = kismi_bagimlilik("sb", izgara_sb)
pd_t = kismi_bagimlilik("yas", izgara_t)
print(f"Kısmi bağımlılık (MPa)    gerçek  XGBoost  doğrusal   [eğitim: s/b "
      f"{sb_aralik[0]:.2f}–{sb_aralik[1]:.2f}, t 3–90 gün]")
NOKTALAR = [("s/b = 0.40", "sb", 0.40), ("s/b = 0.60", "sb", 0.60), ("s/b = 0.20 (dışarıda)", "sb", 0.20),
            ("t = 7 gün", "yas", 7.0), ("t = 28 gün", "yas", 28.0), ("t = 365 gün (dışarıda)", "yas", 365.0)]
for ad, alan, v in NOKTALAR:
    r_ = kismi_bagimlilik(alan, [v])
    print(f"  {ad:22s} {r_['gercek'][0]:7.2f} {r_['xgb'][0]:8.2f} {r_['dogrusal'][0]:10.2f}")
katsayi = dict(zip(muhendislik(d_pd, etkilesim=True).columns, lin.coef_))
print(f"Doğrusal modelin yaş katsayıları (ln dayanım): yas_gun {katsayi['yas_gun']:+.4f} 1/gün, "
      f"ln_t {katsayi['ln_t']:+.3f}")

# %% 7. Grafikler
# Şekil 1: ortalamanın varyansı ve hata ayrışımı
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
bb = np.geomspace(1, B, 100)
tutamac = []
for k, (ad, (sigma2, rho, sinama, _)) in enumerate(ayrisim.items()):
    ax[0].plot(bb, rho * sigma2 + (1 - rho) * sigma2 / bb, color=RENK[k])              # formül
    ax[0].plot(B_SINAMA, [sinama[b][0] for b in B_SINAMA], "o", color=RENK[k], ms=6)    # ölçülen
    ax[0].axhline(rho * sigma2, color=RENK[k], ls=":", lw=1.2)                           # B → ∞ sınırı
    tutamac.append(Line2D([], [], color=RENK[k], marker="o", ms=6, label=f"{ad} (ρ = {rho:.3f})"))
tutamac.append(Line2D([], [], color=SOLUK, ls=":", lw=1.2, label="B → ∞ sınırı: ρσ²"))
ax[0].set_xscale("log")
ax[0].set_yscale("log")
ax[0].set_xticks([1, 2, 5, 10, 20, 40], ["1", "2", "5", "10", "20", "40"])
ax[0].set_yticks([1, 2, 5, 10, 20, 50], ["1", "2", "5", "10", "20", "50"])
ax[0].xaxis.set_minor_formatter(NullFormatter())
ax[0].yaxis.set_minor_formatter(NullFormatter())
ax[0].set(xlabel="Ağaç sayısı B", ylabel="Topluluk tahmininin varyansı (MPa²)", ylim=(0.9, 60),
          title="Varyans: formül (çizgi) ve ölçüm (nokta)")
ax[0].legend(handles=tutamac, loc="upper right")
etiketler, yan, var = [], [], []
for ad in ayrisim:
    iki_satir = ad.replace(" ", "\n")
    for b in (1, B):
        etiketler.append(f"{iki_satir}\nB = {b}")
        yan.append(ayrisim[ad][3][b][0])
        var.append(ayrisim[ad][3][b][1])
xk = np.arange(4)
ax[1].bar(xk, yan, color=RENK[0], label="yanlılık²")
ax[1].bar(xk, var, bottom=yan, color=RENK[1], label="varyans")
ax[1].bar(xk, gurultu, bottom=np.add(yan, var), color=SOLUK, label="gürültü")
for x_, toplam in zip(xk, np.add(yan, var) + gurultu):
    ax[1].text(x_, toplam + 1.5, f"RMSE {np.sqrt(toplam):.2f}", ha="center", fontsize=9, color=IKINCIL)
ax[1].set_xticks(xk, etiketler, fontsize=9)
ax[1].set(ylabel="Beklenen test MSE (MPa²)", ylim=(0, 80),
          title="Hata ayrışımı: kazanç varyanstan geliyor")
ax[1].legend(loc="upper center", ncol=3)
fig.savefig(KLASOR / "d08_topluluk_1.png", dpi=160)
plt.close(fig)

# Şekil 2: artırmada eğitim/doğrulama hatası ve öğrenme hızı
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
h = egriler[0.1]
mm = np.arange(1, len(h["egitim"]) + 1)
m_en = int(h["dogrulama"].argmin())
ax[0].plot(mm, h["egitim"], color=RENK[0], label="Eğitim")
ax[0].plot(mm, h["dogrulama"], color=RENK[1], label="Doğrulama")
ax[0].axvline(m_en + 1, color=MUREKKEP, ls=":", lw=1.2, label=f"Erken durdurma: M = {m_en + 1}")
ax[0].axhline(taban, color=SOLUK, ls="--", lw=1.2, label=f"Gürültü tabanı ({taban:.2f} MPa)")
ax[0].set(xlabel="Ağaç sayısı M", ylabel="RMSE (MPa)", ylim=(0, 16),
          title="Sıfırdan gradyan artırma (η = 0.1, derinlik 2)")
ax[0].legend(loc="upper left")
for k, eta in enumerate([1.0, 0.3, 0.1]):
    d_ = egriler[eta]["dogrulama"]
    j = int(d_.argmin())
    renk = RENK[[2, 1, 0][k]]
    ax[1].plot(np.arange(1, len(d_) + 1), d_, color=renk, label=f"η = {eta:g} (en iyi M = {j + 1})")
    ax[1].plot(j + 1, d_[j], "o", color=renk, ms=6)
ax[1].set(xlabel="Ağaç sayısı M", ylabel="Doğrulama RMSE (MPa)", ylim=(3, 8),
          title="Öğrenme hızı küçüldükçe gereken ağaç artar")
ax[1].legend(loc="upper right")
for a in ax:
    a.set_xscale("log")
    a.set_xticks([1, 10, 100, 1000], ["1", "10", "100", "1000"])
fig.savefig(KLASOR / "d08_topluluk_2.png", dpi=160)
plt.close(fig)

# Şekil 3: safsızlık önemi ve permütasyon önemi
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained", sharey=True)
sira_c = np.argsort(perm.importances_mean)
renk_c = [SOLUK if ADLAR[j] in ILGISIZ else RENK[0] for j in sira_c]
yk = np.arange(len(ADLAR))
ax[0].barh(yk, mdi[sira_c], color=renk_c)
ax[0].set_yticks(yk, [ADLAR[j] for j in sira_c])
ax[0].set(xlabel="Safsızlık önemi (MDI, toplam 1)", title="Eğitimde safsızlık azalması (MDI)")
ax[1].barh(yk, perm.importances_mean[sira_c], xerr=perm.importances_std[sira_c], color=renk_c,
           error_kw={"ecolor": MUREKKEP, "lw": 1})
ax[1].axvline(0, color=MUREKKEP, lw=1)
ax[1].set(xlabel="Permütasyon önemi: test RMSE artışı (MPa)",
          title="Test kümesinde permütasyon önemi")
ax[1].legend(handles=[Patch(color=RENK[0], label="üretimde kullanılan"),
                      Patch(color=SOLUK, label="üretimde kullanılmayan")], loc="lower right")
fig.savefig(KLASOR / "d08_topluluk_3.png", dpi=160)
plt.close(fig)

# Şekil 4: kısmi bağımlılık ve aralık dışı davranış
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
for a, izgara, pdv, aralik, xl in [(ax[0], izgara_sb, pd_sb, sb_aralik, "Su/bağlayıcı oranı s/b"),
                                   (ax[1], izgara_t, pd_t, (3, 90), "Yaş t (gün, log ölçek)")]:
    a.axvspan(*aralik, color="#e1e0d9", alpha=0.6, lw=0, label="Eğitim verisinin aralığı")
    a.plot(izgara, pdv["gercek"], color=MUREKKEP, ls="--", lw=1.6, label="Gerçek (üretici)")
    a.plot(izgara, pdv["xgb"], color=RENK[0], label="XGBoost (+ s/b sütunu)")
    a.plot(izgara, pdv["dogrusal"], color=RENK[1], label="Doğrusal (+ tip × ln t)")
    a.set(xlabel=xl, ylabel="Ortalama tahmin (MPa)")
ax[0].set_title("Kısmi bağımlılık: Abrams eğrisi")
ax[1].set_xscale("log")
ax[1].set_xticks([1, 3, 7, 28, 90, 365], ["1", "3", "7", "28", "90", "365"])
ax[1].xaxis.set_minor_formatter(NullFormatter())
ax[1].set_title(r"Kısmi bağımlılık: yaş katsayısı $\beta_{cc}(t)$")
ax[0].legend(loc="upper right")
fig.savefig(KLASOR / "d08_topluluk_4.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d08_topluluk_1.png, _2.png, _3.png, _4.png")=== 1. Veri ===
Örnek: 800, özellik: 13 (çimento tipi 3 ikili sütun), dayanım 12.0–64.2 MPa (ortalama 37.2)
Gürültü tabanı: gerçek fonksiyonun beklenen RMSE'si 2.70 MPa
=== 2. Torbalama ve rastgele orman: varyans ayrışımı ===
Bootstrap örneğinde farklı gözlem oranı: 0.633 (1 − (1 − 1/n)^n = 0.632)
Torbalama (max_features=1.00): σ² = 25.96, ρ = 0.093 | Var ölçülen/formül: B=5 7.01/7.12, B=20 3.54/3.58
Rastgele orman (max_features=0.33): σ² = 43.28, ρ = 0.025 | Var ölçülen/formül: B=5 9.03/9.51, B=20 3.40/3.18
Kök bölmenin sütunu (ilk eğitim kümesi, 40 ağaç):
torbalama: yas_gun 40 | rastgele orman: yas_gun 12, curuf 8, cimento 7, CEM III/A 7, diğer 6
Hata ayrışımı (MPa²) yanlılık² varyans gürültü toplam RMSE
Torbalama, B=1 7.63 25.14 7.02 39.79 6.31
Torbalama, B=40 5.74 3.01 7.02 15.77 3.97
Rastgele orman, B=1 10.99 41.06 7.02 59.07 7.69
Rastgele orman, B=40 8.32 2.29 7.02 17.63 4.20
OOB (640 örnek): RMSE 4.37 MPa, R² 0.821 | ayrı test (160): RMSE 4.03, R² 0.832
=== 3. Gradyan artırma, sıfırdan (eğitim/doğrulama/test: 480/160/160) ===
η = 0.1: en iyi M = 174 (doğrulama 3.60, eğitim 2.04, test 3.09); M = 1000: doğrulama 3.75, eğitim 0.68
scikit-learn GradientBoostingRegressor ile en büyük fark (200 ağaç): 7.1e-14 MPa
η = 0.3: en iyi M = 76 (doğrulama 3.59, eğitim 1.87, test 3.10); M = 400: doğrulama 3.89, eğitim 0.53
η = 1.0: en iyi M = 37 (doğrulama 4.33, eğitim 2.12, test 4.61); M = 150: doğrulama 4.96, eğitim 0.54
=== 4. HistGradientBoosting ve XGBoost (erken durdurma: doğrulama kümesi) ===
HistGradientBoosting: 218 iterasyon | doğrulama 3.91, test 3.36 MPa
XGBoost : 293 ağaç | doğrulama 3.54, test 3.01 MPa
=== 5. Beş katlı çapraz doğrulama (ortalama ± std, MPa) ===
Model MAE RMSE R²
Doğrusal, ham 13 sütun 4.02 ± 0.40 5.05 ± 0.44 0.751 ± 0.029
Doğrusal, + s/b, ln t (ln hedef) 2.61 ± 0.22 3.32 ± 0.26 0.892 ± 0.017
Doğrusal, + tip × ln t 2.26 ± 0.21 2.91 ± 0.28 0.917 ± 0.013
Torbalama (100 ağaç) 3.18 ± 0.27 4.04 ± 0.36 0.842 ± 0.010
Rastgele orman (100, p/3) 3.25 ± 0.28 4.16 ± 0.41 0.832 ± 0.015
HistGradientBoosting 2.71 ± 0.19 3.42 ± 0.25 0.886 ± 0.011
XGBoost 2.53 ± 0.17 3.20 ± 0.19 0.900 ± 0.008
Gürültü tabanı (gerçek fonksiyon) 2.70
Katlara göre RMSE farkı, XGBoost − doğrusal(+tip × ln t): +0.31 +0.28 +0.10 +0.33 +0.42
=== 6. Yorumlama ===
Rastgele orman: permütasyon önemi (test RMSE artışı, MPa) / safsızlık önemi (MDI)
En önemli 5: yas_gun 4.95/0.288, cimento 4.28/0.299, su 1.35/0.114, curuf 1.15/0.081, CEM III/A 0.58/0.025
Kullanılan diğer 4: CEM I 0.20/0.013, ucucu_kul 0.16/0.021, super_akiskan 0.03/0.027, CEM II/A-LL -0.00/0.006
İlgisiz: iri_agrega 0.03/0.033, ince_agrega -0.02/0.034, kalip_no -0.01/0.027, ortam_sicakligi -0.04/0.032
XGBoost + s/b (160 ağaç, test RMSE 3.05): permütasyon s/b 5.84, su 0.01, çimento 0.16, yaş 6.60
Kısmi bağımlılık (MPa) gerçek XGBoost doğrusal [eğitim: s/b 0.25–0.82, t 3–90 gün]
s/b = 0.40 40.68 41.01 40.86
s/b = 0.60 27.89 30.12 27.28
s/b = 0.20 (dışarıda) 59.55 49.88 61.20
t = 7 gün 31.56 31.35 30.66
t = 28 gün 40.43 40.59 40.92
t = 365 gün (dışarıda) 48.47 44.30 22.17
Doğrusal modelin yaş katsayıları (ln dayanım): yas_gun -0.0039 1/gün, ln_t +0.234
Grafikler kaydedildi: d08_topluluk_1.png, _2.png, _3.png, _4.png7. Sonuçlar: varyans, korelasyon ve yanlılık
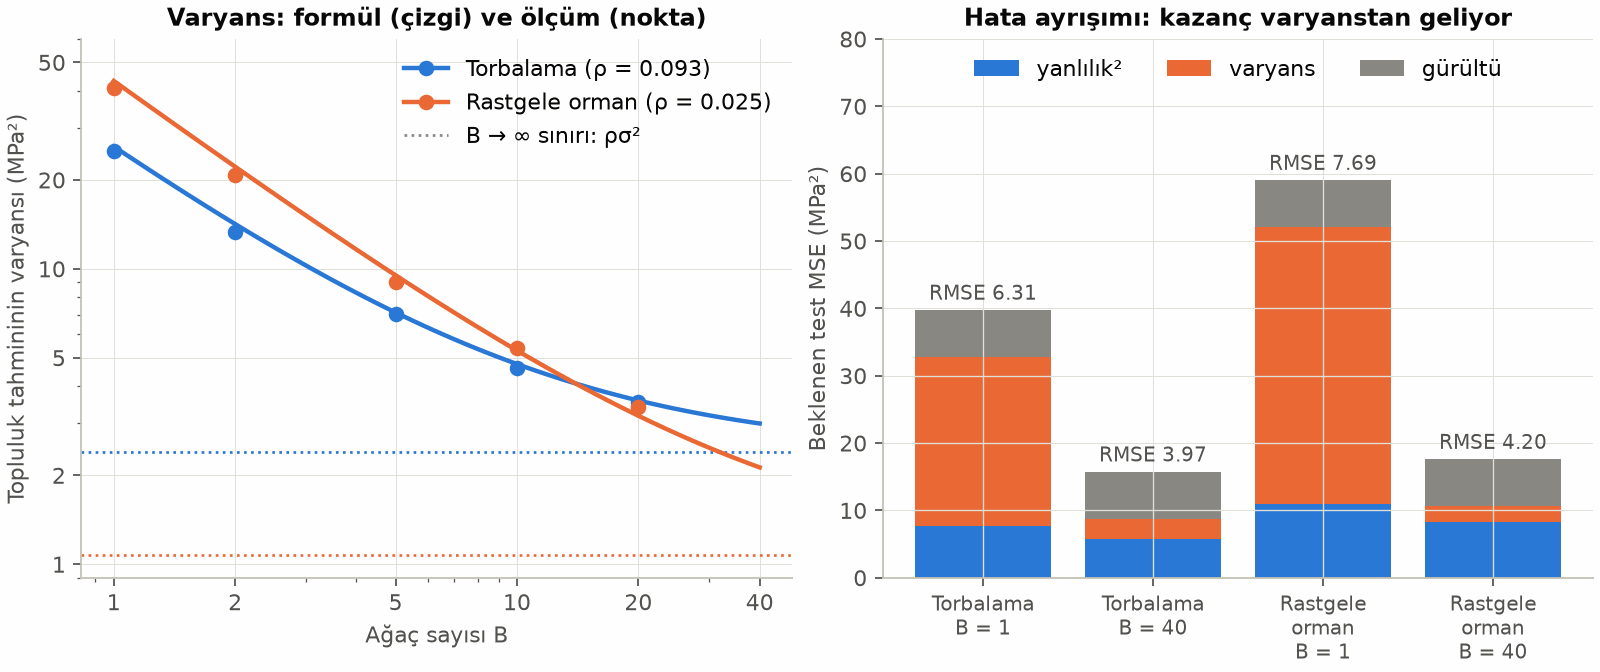
Torbalamada tek bir ağacın varyansı $\sigma^2$ = 25,96 MPa², ağaçlar arası korelasyon $\rho$ = 0,093 çıktı. Rastgele ormanda ($m = p/3$, yani 13 sütunun 4'ü) $\sigma^2$ = 43,28 MPa², $\rho$ = 0,025. Formül, ölçümü birkaç yüzde içinde tutturuyor. Torbalamada 5 ağaçlık topluluğun ölçülen varyansı 7,01, formülün öngörüsü 7,12 MPa²; 20 ağaçta 3,54'e karşı 3,58. Rastgele ormanda 20 ağaçta 3,40'a karşı 3,18 MPa². Kalan farklar, yalnız 16 eğitim kümesiyle yapılan bir ölçümün örnekleme gürültüsü mertebesinde.
Korelasyonun nereden geldiğini kök bölmeler gösteriyor. İlk eğitim kümesindeki 40 torbalama ağacının 40'ı da ilk bölmeyi yaşla yapıyor; ağaçların üst bölmeleri neredeyse aynı. Buna rağmen torbalamada bile $\rho$'nun 0,093 gibi düşük çıkması çelişki değil: derin ağaçların yaprakları bootstrap örneğindeki birkaç gürültülü gözlemden oluşur, bu yüzden aynı $x$ noktasındaki tahminler zayıf ilişkilidir. Rastgele ormanda kök bölmeler dağılıyor: yaş 12, cüruf 8, çimento 7 ve CEM III/A 7 ağaçta, kalan 6 ağaçta başka sütunlar. $\rho$'nun 0,093'ten 0,025'e düşmesi bu çeşitlenmenin sonucudur.
| Model | Yanlılık² | Varyans | Toplam | RMSE (MPa) |
|---|---|---|---|---|
| Torbalama, tek ağaç ($B$ = 1) | 7,63 | 25,14 | 39,79 | 6,31 |
| Torbalama, $B$ = 40 | 5,74 | 3,01 | 15,77 | 3,97 |
| Rastgele orman, tek ağaç ($B$ = 1) | 10,99 | 41,06 | 59,07 | 7,69 |
| Rastgele orman, $B$ = 40 | 8,32 | 2,29 | 17,63 | 4,20 |
Tablonun ilk iki satırı topluluk yöntemlerinin özünü gösteriyor. 40 ağacın ortalaması varyansı 25,14'ten 3,01 MPa²'ye indiriyor, RMSE 6,31'den 3,97 MPa'ya düşüyor. Yanlılık ise kuramda hiç değişmemeli. Tablodaki küçük fark (7,63 → 5,74), yanlılığı yalnız 16 eğitim kümesinin ortalamasıyla tahmin etmemizden kaynaklanıyor. Bu ortalama da gürültülüdür: tek ağacın büyük varyansının yaklaşık $\sigma^2/16 \approx 1{,}6$ MPa²'lik kısmı yanlılık tahminine karışır.
İkinci gözlem daha şaşırtıcı: bu veride rastgele orman torbalamadan kötü (RMSE 4,20'ye karşı 3,97). Özellik alt örneklemesi $\rho$'yu 0,093'ten 0,025'e indirdi, yani yapması gerekeni yaptı. Ama her ağaç belirgin biçimde kötüleşti. 13 sütunun dördü tamamen ilgisiz, üçü çimento tipinin ikili sütunları. Her bölmede yalnız 4 aday olunca birçok bölme zayıf bir sütunla yapılmak zorunda kalıyor; yanlılık² 5,74'ten 8,32'ye çıkıyor. Formül, kazancın neden küçük kaldığını da söylüyor. Torbalamada $\rho$ zaten düşük; ulaşılabilecek en küçük varyans $\rho\sigma^2 \approx 2{,}41$ MPa², rastgele ormanda $\approx 1{,}08$ MPa². Korelasyonu düşürmenin getirebileceği en fazla kazanç 1,3 MPa² civarındayken yanlılıktaki kayıp 2,6 MPa². Rastgele orman, birkaç güçlü özelliğin bütün ağaçlara hâkim olduğu ve $\rho$'nun büyük olduğu problemlerde parlar. Alıştırma 2'de max_features'ı tarayacaksınız.
Bölüm 2 çıktısının son satırı torba dışı (OOB) tahmini sınıyor. 640 eğitim örneğiyle kurulan rastgele ormanın OOB RMSE'si 4,37 MPa (R² = 0,821), ayrı tutulan 160 örnekteki test RMSE'si 4,03 MPa (R² = 0,832). İkisi de birer kestirimdir ve 160 gözlemlik test kümesinin de kendi örnekleme hatası vardır. OOB tahmini ise hiç veri harcamadan bu büyüklük mertebesini veriyor.
8. Sonuçlar: artırma ve erken durdurma
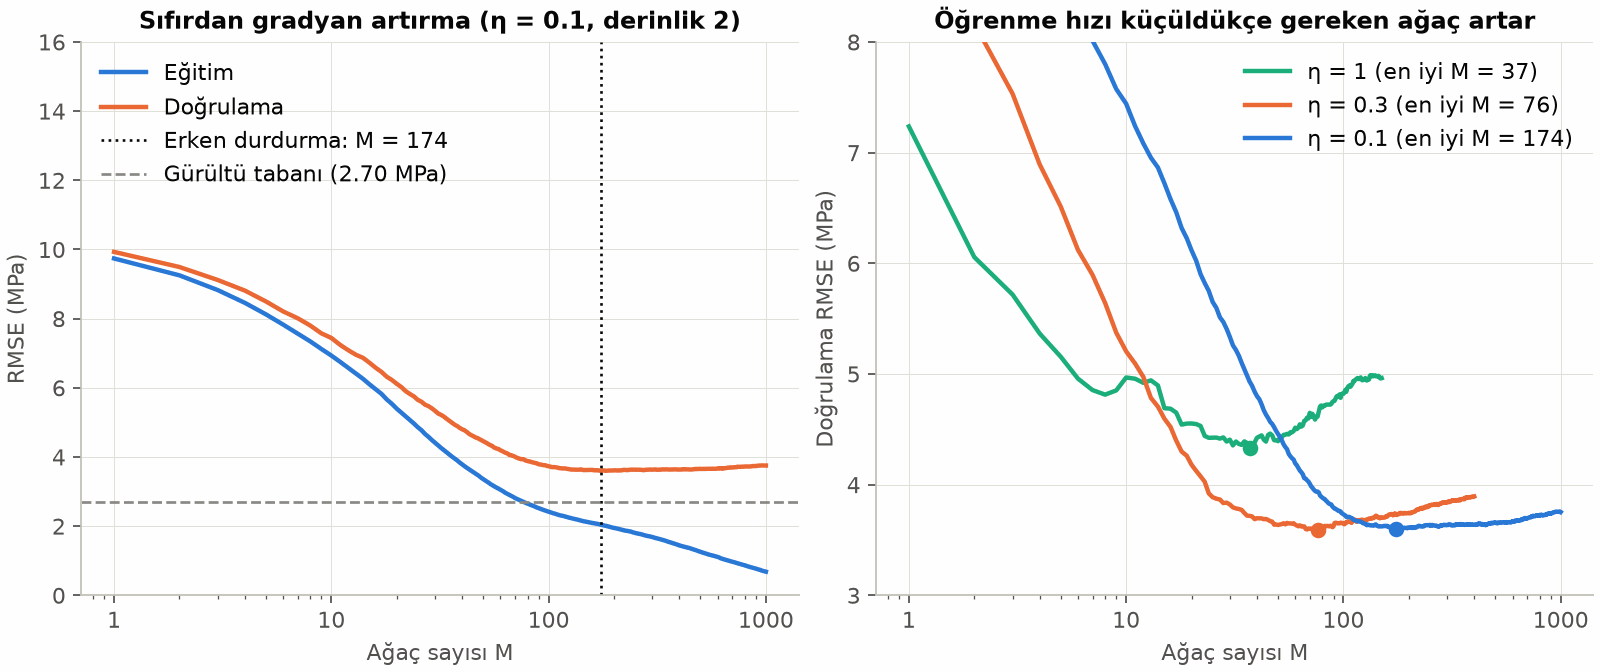
Veriyi 480 eğitim, 160 doğrulama ve 160 test örneğine ayırdık. $\eta$ = 0,1 ile doğrulama hatası 174 ağaçta en düşük değerine (3,60 MPa) iniyor, sonra yavaşça yükseliyor; 1000 ağaçta 3,75 MPa. Eğitim hatası ise durmadan düşüyor: 174 ağaçta 2,04, 1000 ağaçta 0,68 MPa. Gürültü tabanının (2,70 MPa) altına inen bir eğitim hatası, modelin artık gürültüyü ezberlediğinin işaretidir. Erken durdurulan modelin test RMSE'si 3,09 MPa.
Sağdaki grafik öğrenme hızının etkisini gösteriyor. $\eta$ = 1'de her ağaç hatanın tamamını düzeltmeye çalışıyor; en iyi doğrulama hatası 37 ağaçta 4,33 MPa'da kalıyor ve test hatası 4,61 MPa. $\eta$ = 0,3 en iyi noktaya 76 ağaçta (3,59 MPa), $\eta$ = 0,1 ise 174 ağaçta (3,60 MPa) ulaşıyor. Bu veride iki küçük öğrenme hızı aynı minimuma iniyor; fark minimumdan sonra ortaya çıkıyor. $\eta$ = 0,3'ün eğrisi daha hızlı yükseliyor, 400 ağaçta 3,89 MPa'ya çıkıyor. $\eta$ = 0,1'de ise 1000 ağaçta bile 3,75 MPa. Küçük öğrenme hızı daha çok ağaç ister ama durma noktasındaki hatayı daha az cezalandırır. Uygulamada genellikle $\eta$ = 0,01–0,1 seçilir ve ağaç sayısını erken durdurma belirler.
Aynı bölünmede kütüphaneler şu sonuçları verdi: HistGradientBoosting 218 iterasyonda durdu, doğrulama RMSE'si 3,91, test RMSE'si 3,36 MPa. XGBoost en iyi noktayı 293 ağaçta buldu, doğrulama 3,54, test 3,01 MPa. Doğrulama ve test hatalarının bu kadar farklı olmasına dikkat edin (3,54'e karşı 3,01). 160 örneklik tek bir bölünme, modelleri sıralamak için fazla gürültülüdür. Karşılaştırmayı bu yüzden çapraz doğrulamayla yapacağız.
9. Çapraz doğrulamayla karşılaştırma
Yedi modeli aynı beş katta sınadık. Artırma modellerinin erken durdurması, her eğitim katının içinden ayrılan %15'lik doğrulama parçasıyla yapıldı; test katı hiçbir kararda kullanılmadı. Doğrusal modellerden ikisi Ders 04'tekine benzer özellikler kullanıyor. Hedef olarak dayanımın logaritması alınıyor, tahmin üstel fonksiyonla MPa'ya geri çevriliyor. Ham sütunlara s/b ve $\ln t$ ekleniyor. Üçüncü doğrusal model buna çimento tipi ile $\ln t$'nin çarpımlarını, yani tip × ln t etkileşimini ekliyor.
| Model | MAE (MPa) | RMSE (MPa) | R² |
|---|---|---|---|
| Doğrusal, ham 13 sütun | 4,02 ± 0,40 | 5,05 ± 0,44 | 0,751 ± 0,029 |
| Doğrusal, + s/b ve $\ln t$ (ln hedef) | 2,61 ± 0,22 | 3,32 ± 0,26 | 0,892 ± 0,017 |
| Doğrusal, + tip × ln t | 2,26 ± 0,21 | 2,91 ± 0,28 | 0,917 ± 0,013 |
| Torbalama (100 ağaç) | 3,18 ± 0,27 | 4,04 ± 0,36 | 0,842 ± 0,010 |
| Rastgele orman (100 ağaç, $p/3$) | 3,25 ± 0,28 | 4,16 ± 0,41 | 0,832 ± 0,015 |
| HistGradientBoosting | 2,71 ± 0,19 | 3,42 ± 0,25 | 0,886 ± 0,011 |
| XGBoost | 2,53 ± 0,17 | 3,20 ± 0,19 | 0,900 ± 0,008 |
| Gürültü tabanı (gerçek fonksiyon) | — | 2,70 | — |
Tablonun en iyisi bir topluluk yöntemi değil. Çimento tipinin sertleşme hızını değiştirdiğini bilen doğrusal model 2,91 MPa RMSE ile gürültü tabanına (2,70) en çok yaklaşan model oldu. Beş katın beşinde de XGBoost'tan iyi: katlara göre RMSE farkı +0,10 ile +0,42 MPa arasında. Bu sonuç sürpriz sayılmamalı. Veriyi üreten bağıntılar, logaritma alınınca neredeyse doğrusaldır. Doğru özellikleri veren bir mühendis, modele işin fiziğini zaten söylemiş olur.
Artırmanın gücü, bu bilgi olmadığında ortaya çıkıyor. Ham sütunlarla doğrusal model 5,05 MPa'da kalırken XGBoost hiçbir özellik mühendisliği yapmadan 3,20 MPa'ya iniyor. s/b ve $\ln t$ eklenmiş doğrusal modelden de (3,32) biraz iyi; ama bu fark katlar arasındaki saçılımın içinde. İkinci ve üçüncü satır arasındaki sıçrama da öğretici. Doğrusal modelin 3,32'den 2,91'e inmesi için etkileşimi bizim yazmamız gerekti. Derinlik 3'lük ağaçlar ise böyle etkileşimleri kendileri bulur. Kısacası artırma, etkileşimlerin ve doğrusal olmayan biçimlerin bilinmediği problemlerde kazanır.
Torbalama ve rastgele orman (4,04 ve 4,16) artırmanın gerisinde kaldı. Derin ağaçların ortalaması, düzgün ve monoton bir fonksiyonu 640 örnekle yaklaşık temsil ederken yanlılık taşır. Artırma ise tam bu yanlılığı hedefler. Pratikte izlenecek yol: önce fiziğe dayanan basit bir modelle başlayın, sonra artırmayı deneyin. Artırma belirgin biçimde daha iyiyse basit model bir şeyi kaçırıyordur; artıklarına bakın. Fark yoksa basit ve yorumlanabilir modeli tercih edin.
10. Model ne öğrendi? Önem ölçüleri ve kısmi bağımlılık
Safsızlık önemi ve permütasyon önemi
Ağaç modelleriyle gelen hazır önem ölçüsü safsızlık azalmasıdır (mean decrease in impurity, MDI). Bir özelliğin bütün bölmelerde sağladığı kare hata azalması toplanır, ağaçlar üzerinden ortalanır ve toplam 1 olacak biçimde ölçeklenir. Hesap eğitim verisinde yapılır. Bu yüzden çok sayıda olası bölme noktası olan sürekli sütunlar, gürültüyü bölerek bile “önem” toplayabilir.
Permütasyon önemi ise ayrı tutulan veride ölçülür. Test kümesinde bir sütunun değerleri karıştırılır, böylece o sütunun hedefle bağı kopar ama dağılımı aynı kalır. Modelin hatasındaki artış o sütunun önemidir. Karıştırma birkaç kez tekrarlanıp ortalama alınır:
$$ \begin{aligned} I_j = {}& \text{RMSE}\big(\vect y,\ \hat f(X^{\pi_j})\big) \\ &- \text{RMSE}\big(\vect y,\ \hat f(X)\big) \end{aligned} $$Burada $X^{\pi_j}$, $j$'inci sütunu karıştırılmış test matrisidir. scikit-learn'deki karşılığı sklearn.inspection.permutation_importance fonksiyonudur.
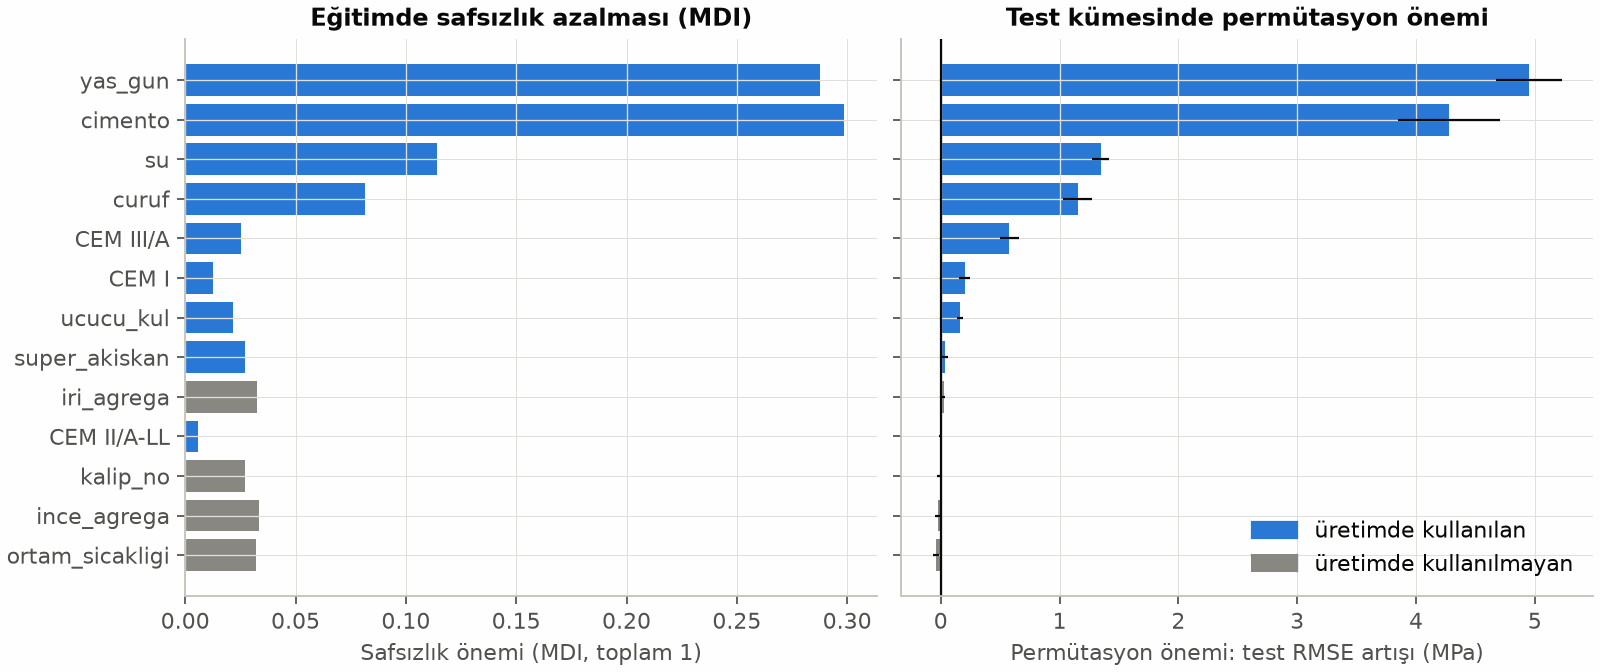
Permütasyon önemine göre en önemli beş özellik yaş (karıştırınca RMSE 4,95 MPa artıyor), çimento (4,28), su (1,35), cüruf (1,15) ve CEM III/A tipi (0,58). Üretimde kullanılmayan dört sütunun permütasyon önemi −0,04 ile 0,03 MPa arasında, yani sıfır. Safsızlık önemi ise bu dört sütuna 0,027–0,034 pay veriyor. Bu değerler, üretimde gerçekten kullanılan uçucu külün (0,021) ve CEM III/A sütununun (0,025) MDI'sinden büyük, süper akışkanlaştırıcınınkiyle (0,027) aynı ya da ondan büyük. Permütasyon önemi ise uçucu külü (0,16 MPa) dört ilgisiz sütunun hepsinin önüne koyuyor. MDI sıralamasına güvenseydik ince agreganın ve ortam sıcaklığının uçucu külden önemli olduğuna karar verecektik.
İlişkili özellikler başka bir tuzak kurar. XGBoost'a s/b sütununu da verdiğimizde (160 ağaç, test RMSE 3,05 MPa) permütasyon önemi s/b için 5,84, su için 0,01, çimento için 0,16 MPa çıktı. Su elbette önemsiz değildir; model su ve çimentonun bilgisini s/b üzerinden kullanmayı öğrenmiştir. Önem ölçüleri modelin hangi sütunlara dayandığını söyler, fiziğin hangi değişkene bağlı olduğunu değil. İlişkili sütunlardan birini karıştırmak ayrıca gerçekte olmayan karışımlar (örneğin çok su ve çok düşük s/b) üretir.
Kısmi bağımlılık
Kısmi bağımlılık (partial dependence, PD) modelin bir özelliğe ortalama tepkisini gösterir. Her satırda $j$'inci özellik $v$ değerine sabitlenir, diğer sütunlar olduğu gibi bırakılır ve tahminlerin ortalaması alınır:
$$ \text{PD}_j(v) = \frac{1}{n}\sum_{i=1}^{n} \hat f\big(v,\ \vect x_{i,-j}\big) $$Aynı işlemi üreticinin gerçek fonksiyonuna uygulayınca “gerçek” eğriyi de çizebiliyoruz. scikit-learn'de sklearn.inspection.partial_dependence bu hesabı yapar. s/b türetilmiş bir sütun olduğu için kodda hesabı elle, birkaç satırla yazdık.
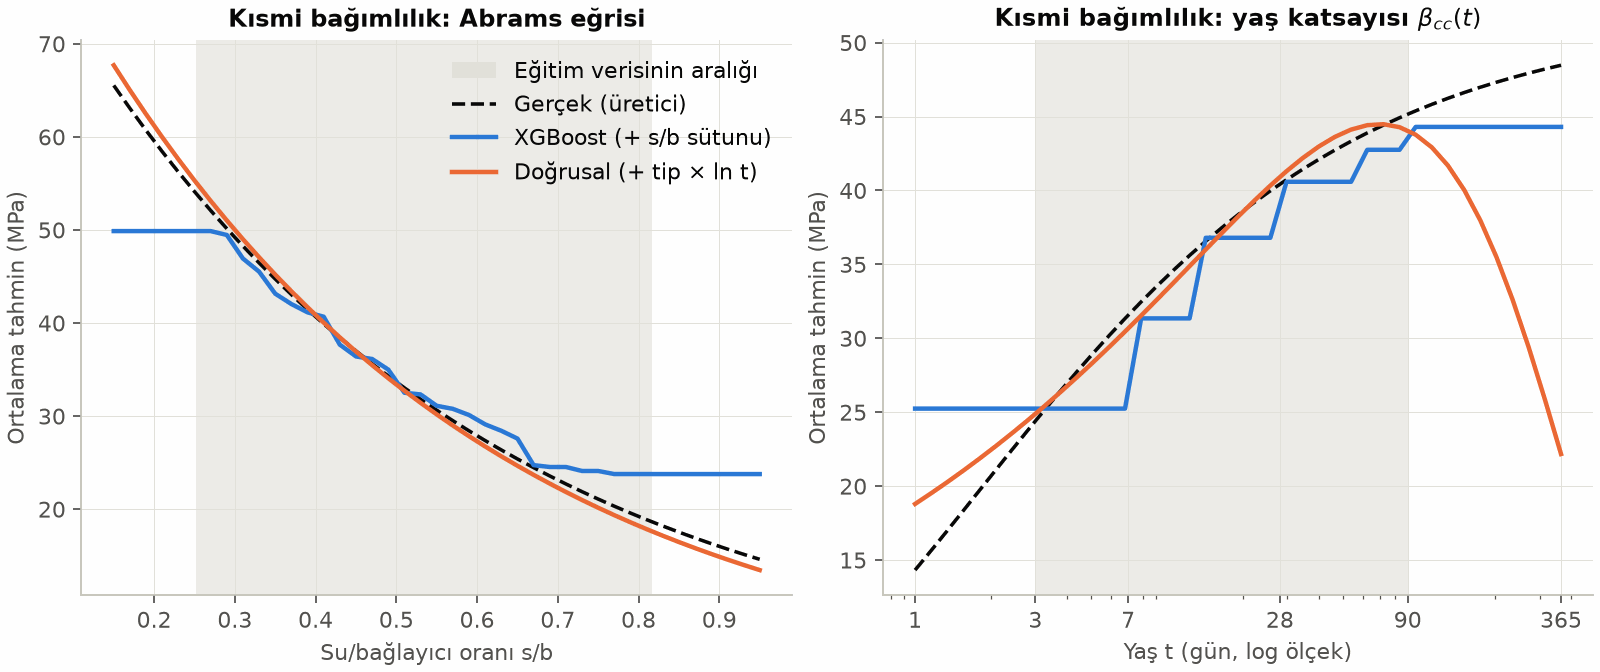
Eğitim aralığının içinde XGBoost, Abrams eğrisini ve yaş katsayısının biçimini veriden geri kazanmış. s/b = 0,40'ta gerçek değer 40,68, XGBoost 41,01 MPa; 7 günde 31,56'ya karşı 31,35; 28 günde 40,43'e karşı 40,59 MPa. Verinin seyrekleştiği uçlarda sapma büyüyor: s/b = 0,60'ta 27,89'a karşı 30,12 MPa. Yaş eğrisinin basamaklı olduğuna da dikkat edin. Veride yalnız altı farklı yaş var (3, 7, 14, 28, 56 ve 90 gün); ağaçlar bu değerlerin arasında bilgi taşımaz ve sabit kalır.
Eğitim aralığının dışı ise iki model ailesinin sınırlarını açıkça gösteriyor. Ağaçlar dış değer üretemez (Ders 07): s/b = 0,20'de XGBoost 49,88 MPa diyor, gerçek değer 59,55; 365 günde 44,30 diyor, gerçek değer 48,47. Doğrusal modelin davranışı ise özelliğin biçimine bağlı. Abrams yasası logaritma alınınca s/b'de tam doğrusaldır; model s/b = 0,20'de 61,20 MPa ile gerçeğe yakın kalıyor. Yaşta ise 365 günde 22,17 MPa'ya çöküyor. Nedeni katsayılarda: modelde hem ham yaş sütunu hem de $\ln t$ var. 3–90 gün aralığındaki eğriliği yakalamak için yaş −0,0039 1/gün, $\ln t$ +0,234 katsayısı almış. 90 günden sonra doğrusal terim baskın çıkıyor. Ders: hiçbir model, biçimi doğru değilse veri aralığının dışında güvenilir değildir. Alıştırma 4'te yaş için doğru biçimi kullanınca bu sorunun nasıl kaybolduğunu göreceksiniz.
Kısmi bağımlılık nedensellik değildir
PD, bir özelliği değiştirirken diğerlerini sabit tutar. Özellikler ilişkiliyse bu, gerçekte görülmeyen birleşimlerin ortalamasını almak demektir: s/b'yi 0,20'ye çekip su ve çimentoyu olduğu gibi bırakmak gibi. Ayrıca PD modelin davranışını gösterir; model yanlışsa eğri de yanlıştır. Tek tek satırların eğrilerini çizen ICE grafikleri ve ilişkili özelliklere daha dayanıklı ALE grafikleri, bu konunun devamıdır. Monoton kısıtlarla modeli fiziğe uydurmayı Ders 17'de göreceğiz.
11. Sık yapılan hatalar
- Erken durdurmayı test kümesiyle yapmak. Ağaç sayısı da bir hiperparametredir. Test hatasına bakarak seçilirse test hatası iyimser çıkar. Erken durdurma için ayrı bir doğrulama kümesi, çapraz doğrulamada ise kat içi bir doğrulama parçası kullanın.
- Safsızlık önemine güvenmek. MDI eğitim verisinde hesaplanır ve sürekli sütunlara pay verir; bu derste ilgisiz dört sütunun hepsi uçucu külden önemli göründü. Kararı ayrı tutulan veride permütasyon önemiyle verin.
- scikit-learn'ün rastgele ormanını varsayılanlarla kullanıp özellik alt örneklemesi yapıldığını sanmak.
RandomForestRegressor'da varsayılanmax_features=1.0'dır, yani torbalamadır.max_features'ı OOB hatasıyla ayarlayın. - Ağaç modelinden veri aralığının dışını tahmin etmesini beklemek. 90 güne kadar verilerle eğitilen bir model 365 günlük dayanımı 90 günlükle aynı tahmin eder.
- Büyük öğrenme hızı ve sınırsız ağaç sayısı. $\eta$ = 1 bu veride en iyi noktada bile belirgin biçimde kötüydü. Küçük $\eta$ seçin, ağaç sayısını erken durdurmaya bırakın.
- Modelleri tek bir bölünmeyle sıralamak. Aynı XGBoost modelinin doğrulama ve test hatası 3,54 ve 3,01 MPa çıktı. Karşılaştırmayı çapraz doğrulamayla, mümkünse her kattaki farklara bakarak yapın.
12. Alıştırmalar
Alıştırma 1KolayKaç ağaç yeter?
Kodun çıktısındaki $\sigma^2$ ve $\rho$ değerlerini kullanarak, topluluk varyansının $B \to \infty$ sınırının en fazla %10 üstünde kalması için gereken ağaç sayısını torbalama ve rastgele orman için hesaplayın. Hangi yöntem daha çok ağaç ister? Neden?
Çözümü göster
Koşul $(1-\rho)\sigma^2/B \le 0{,}1\,\rho\sigma^2$, yani $B \ge (1-\rho)/(0{,}1\,\rho)$'dur; $\sigma^2$ sadeleşir. Torbalamada $\rho$ = 0,093 için $B \ge 97{,}5$, yani 98 ağaç. Rastgele ormanda $\rho$ = 0,025 için $B \ge 390$ ağaç.
Korelasyon düştükçe varyansın ulaşabileceği sınır ($\rho\sigma^2$: 2,41'e karşı 1,08 MPa²) da düşer, ama bu sınıra yaklaşmak için daha çok ağaç gerekir. 100 ağaçta torbalamanın varyansı 2,65, rastgele ormanınki 1,50 MPa²'dir. Rastgele ormanlarda ağaç sayısının birkaç yüze çıkarılmasının nedeni budur. Ağaç eklemek aşırı uyum yaratmadığı için tek bedel hesap süresidir.
Alıştırma 2Ortamax_features taraması
640 eğitim örneğinde 200 ağaçlık rastgele ormanı max_features = 0,2; 1/3; 0,5; 0,75 ve 1,0 ile eğitin ve oob_score=True ile OOB RMSE'sini karşılaştırın. Sonucu ders içindeki yanlılık–varyans ayrışımıyla açıklayın.
Çözümü göster
OOB RMSE'leri sırasıyla 5,22; 4,37; 4,17; 4,16 ve 4,21 MPa çıkar. En iyi değerler 0,5–0,75 aralığında, ama torbalamadan (1,0) farkları 0,05 MPa civarında ve önemsiz. Asıl kayıp küçük değerlerde: 0,2'de her bölmede yalnız 2 aday sütun kalıyor ve ağaçlar sık sık ilgisiz sütunlarla bölünüyor. Bölüm 7'deki ayrışım bunu gösteriyordu: $m$ küçüldükçe $\rho$ düşer ama yanlılık ve tek ağaç varyansı artar. Bu veride $\rho$ zaten küçük olduğu için korelasyonu daha da düşürmek yanlılık kaybını karşılamıyor. $p/3$ önerisi bir başlangıç noktasıdır; OOB hatası, ayrı veri harcamadan bu ayarı yapmanın ucuz yoludur.
Alıştırma 3OrtaXGBoost'a mühendislik bilgisi vermek
Çapraz doğrulamadaki XGBoost modeline s/b sütununu ekleyin (ozellikler(d, sb_sutunu=True)) ve beş katlı RMSE'yi yeniden hesaplayın. Doğrusal modeldeki kadar büyük bir iyileşme bekler misiniz?
Çözümü göster
RMSE 3,20 ± 0,19'dan 3,14 ± 0,26 MPa'ya iniyor: küçük ve katlar arasındaki saçılımın içinde bir iyileşme. Doğrusal modelde s/b'nin eklenmesi ise belirleyiciydi (5,05 → 3,32). Fark şuradan geliyor: ağaçlar s/b'yi su ve çimento eşiklerinin birleşimleriyle zaten yaklaşık kurabiliyor. Açık bir sütun bunu kolaylaştırır, daha az ağaç ve daha basit bölmelerle aynı bilgiyi verir. Ama doğrusal modeldeki gibi temsil gücünü kökten değiştirmez. Mühendislik özellikleri, ağaç modellerinde doğruluktan çok yorumlanabilirlik ve veri verimliliği için değerlidir.
Alıştırma 4OrtaYaş için doğru biçim
Doğrusal modelde $\ln t$ yerine EN 1992-1-1'deki biçimi kullanın: $u = 1-\sqrt{28/t}$ ve çimento tipiyle çarpımları ($u$ × CEM II, $u$ × CEM III). Ham yas_gun sütununu modelden çıkarın. Beş katlı RMSE'yi ve 365 günlük kısmi bağımlılık değerini bulun; aynı şeyi $\ln t$ biçimiyle (ham yaş sütunu yine çıkarılmış) tekrarlayın.
Çözümü göster
$u$ biçimiyle RMSE 2,81 ± 0,27 MPa'ya iniyor ve gürültü tabanına (2,70) çok yaklaşıyor. 365 günlük kısmi bağımlılık 48,46 MPa, gerçek değer 48,47 MPa: model veri aralığının dört katı ötesinde bile doğru. Çünkü $\ln f$, $u$'da tam doğrusaldır ve model fiziğin kendisini öğrenmiştir. $\ln t$ biçimiyle ise RMSE 3,35 ± 0,30 MPa, 365 günlük tahmin 62,03 MPa olur: bu kez çökme yerine %28'lik bir aşırı tahmin. Ham yaş sütunu modelde kalsaydı bile $u$ biçimiyle RMSE 2,81 ± 0,28 MPa çıkardı; ama 365 günlük tahmin, yaşın küçük negatif katsayısı yüzünden 44,90 MPa'ya düşerdi. Gereksiz bir esneklik terimi, veri aralığının içinde zararsız görünür ama dışında modeli bozar.
Alıştırma 5ZorMutlak hata kaybıyla gradyan artırma
Laboratuvar kayıtlarında bazı numunelerin dayanımı hatalı girilmiş olsun: eğitim kümesindeki 480 etiketin 24'ünü (%5) 0,4 ile çarpın. Bozulacak etiketleri bozuk = np.random.default_rng(1).choice(480, 24, replace=False) ile seçin (eğitim kümesi içindeki sıra numaraları). Doğrulama ve test kümelerini temiz bırakın. gradyan_artirma fonksiyonunu mutlak hata kaybı için değiştirin: $F_0$ medyan, ağaç $\operatorname{sign}(y - F)$ sözde artıklarına uydurulsun, her yaprağın değeri ise o yapraktaki artıkların medyanı olsun. Kare hata ve mutlak hata sürümlerini temiz ve bozuk etiketlerle karşılaştırın ($\eta$ = 0,1, derinlik 2, 1000 ağaç; ağaç sayısını temiz doğrulama kümesindeki RMSE'ye göre erken durdurmayla seçin).
Çözümü göster
def gradyan_artirma_l1(X, y, n_agac, ogrenme_hizi, derinlik=2, tohum=42):
    rs = np.random.RandomState(tohum)
    f0 = np.median(y)                                  # mutlak hatada en iyi sabit: medyan
    F = np.full(len(y), f0)
    agaclar = []
    for _ in range(n_agac):
        artik = y - F
        agac = DecisionTreeRegressor(max_depth=derinlik, random_state=rs).fit(X, np.sign(artik))
        yaprak = agac.apply(X)                         # her gözlemin düştüğü yaprak
        deger = {j: np.median(artik[yaprak == j]) for j in np.unique(yaprak)}
        F += ogrenme_hizi * np.array([deger[j] for j in yaprak])
        agaclar.append((agac, deger))
    return f0, agaclar
Ağaç yalnız bölmeleri belirler; yaprak değeri, o yapraktaki kaybı en küçük yapan sabittir. Kare hatada bu ortalama, mutlak hatada medyandır. Friedman (2001) bu adımı her yaprak için ayrı bir doğru arama (line search) olarak tanımlar. Test kümesindeki sonuçlar:
| Etiketler | Kayıp | En iyi M | RMSE (MPa) | MAE (MPa) |
|---|---|---|---|---|
| Temiz | L2 | 174 | 3,09 | 2,38 |
| Temiz | L1 | 601 | 3,17 | 2,42 |
| %5 bozuk | L2 | 150 | 4,58 | 3,23 |
| %5 bozuk | L1 | 851 | 3,34 | 2,57 |
Temiz veride kare hata biraz daha iyidir; gürültü zaten normale yakın. Bozuk etiketlerle kare hatanın test RMSE'si 3,09'dan 4,58'e çıkar, mutlak hatanınki yalnız 3,17'den 3,34'e. Kare hatada büyük artıklar gradyana orantılı katkı yapar ve ağaçlar hatalı kayıtları “düzeltmeye” uğraşır. Mutlak hatada her gözlemin sözde artığı ±1'dir; aykırı değerin büyüklüğü önemsizleşir.
Kare hatanın sonucu, hangi etiketlerin bozulduğuna çok bağlıdır. Seçim tohumunu 0'dan 9'a değiştirince kare hatanın test RMSE'si 3,55 ile 4,58 MPa arasında dalgalanıyor (ortalama 4,00); tohum 1 bu aralığın en kötü ucu. Mutlak hata ise 3,19–3,46 MPa arasında kalıyor (ortalama 3,32). Yüksek dayanımlı bir numunenin bozulması büyük bir artık üretir ve kare hata o tek kayda takılır; mutlak hata bundan etkilenmez. Kayıt hatası beklenen verilerde mutlak hata ya da Huber kaybı daha güvenli bir seçimdir.
Özet
- Korelasyonu $\rho$ olan $B$ ağacın ortalamasının varyansı $\rho\sigma^2 + (1-\rho)\sigma^2/B$'dir. Ortalama almak varyansı düşürür, yanlılığı değiştirmez; formül, 16 eğitim kümesiyle yaptığımız ölçümü birkaç yüzde içinde tutturdu.
- Rastgele orman, özellik alt örneklemesiyle $\rho$'yu düşürür ama tek ağaçları kötüleştirir. Bu veride torbalamadan iyi değildi;
max_featuresbir hiperparametredir ve OOB hatasıyla ayarlanır. - Gradyan artırma, artıklara (negatif gradyana) sığ ağaçlar ekleyen bir fonksiyon uzayı gradyan inişidir. Ağaç sayısı aşırı uyum yaratır; erken durdurma yalnız doğrulama verisiyle yapılır.
- Fiziği bilen doğrusal model (2,91 MPa) XGBoost'u (3,20 MPa) geçti. Artırma, etkileşimler ve biçimler bilinmediğinde kazanır. Ağaçlar veri aralığının dışında sabit kalır.
- Safsızlık önemi ilgisiz sütunlara pay verir; ayrı tutulan veride permütasyon önemi kullanın. Kısmi bağımlılık modelin öğrendiği biçimi gösterir ama nedensellik değildir.
Sıradaki projede XGBoost'u bir zaman serisine uygulayacağız: geçmiş gözlemlerden bir sonraki adımı tahmin edip modeli basit bir referansla dürüstçe sınayacağız (Proje 2).
Kaynaklar
- L. Breiman (1996), “Bagging predictors”, Machine Learning 24(2), 123–140; L. Breiman (2001), “Random Forests”, Machine Learning 45(1), 5–32.
- J. H. Friedman (2001), “Greedy function approximation: a gradient boosting machine”, Annals of Statistics 29(5), 1189–1232.
- T. Chen, C. Guestrin (2016), “XGBoost: A Scalable Tree Boosting System”, KDD 2016 (arXiv:1603.02754).
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 8.7 (torbalama), 10 (artırma) ve 15 (rastgele orman).
- scikit-learn — Ensembles, Permutation feature importance ve XGBoost parametreleri belgeleri.