Bu derste öğrenecekleriniz
- Veriyi eğitim, doğrulama ve test bölümlerine ayırıp her birinin rolünü uygulamak
PolynomialFeatures, ölçekleme ve Ridge'i tek bir işlem zincirinde kurmak- Polinom derecesini doğrulama hatasıyla seçmek ve küçük farkların anlamını sorgulamak
- Test sonucunu bir referans modelle ve gürültü düzeyiyle birlikte yorumlamak
- Yüksek dereceli polinomların aralık dışındaki davranışını görmek
1. Problemi ve veriyi kurun
Sıcaklık ile bağıl nem arasındaki eğrisel bir ilişkiyi küçük bir regresyon modeliyle öğreneceğiz. Sıcaklık–nem ilişkisi beton kürü, cephelerde yoğuşma ya da ahşabın nemi gibi pek çok mühendislik sorusunda karşımıza çıkar; ama buradaki amaç yalnız yöntemi göstermektir.
240 bağımsız sıcaklık gözlemi (0–35 °C) üretip her biri için gürültülü bir nem değeri hesaplıyoruz:
$$ h = 75 - 2\,T + 0{,}045\,T^2 + \varepsilon $$Burada $T$ sıcaklık (°C), $h$ bağıl nem (%), $\varepsilon$ ise standart sapması 3 yüzde puan olan normal dağılımlı gürültüdür. Bu ilişki eğitim için tasarlanmıştır; gerçek hava verisi veya fiziksel bir nem yasası değildir. Sabit rastgelelik tohumu aynı örneği yeniden üretir.
Gerçek ilişkinin ikinci dereceden olduğunu biliyoruz. Bu, projenin asıl sorusunu ilginç kılar: veriye bakarak doğru karmaşıklığı seçebilecek miyiz ve seçimimiz ne kadar güvenilir?
2. Önce veriyi ayırın
Verinin %60'ı eğitim, %20'si doğrulama, %20'si test için ayrılır: 144, 48 ve 48 ölçüm. Önce test bölümü ayrılır; kalan geliştirme verisi eğitim ve doğrulama olarak ikiye bölünür. Bu rollerin neden ayrı olduğu Ders 01'de anlatıldı.
Sıcaklıklar bağımsız üretildiğinden rastgele bölme uygundur. Tarihli gerçek hava verilerinde bu varsayımı tekrar değerlendirmek gerekir: art arda günler birbirine benzer ve rastgele bölme testi iyimser gösterir. Zaman sırasının nasıl korunacağını Proje 2'de göreceksiniz.
3. Dereceyi doğrulama verisinde seçin
PolynomialFeatures, $T$'den $T^2$ ve daha yüksek kuvvetler üretir. Derece $d$ olan model şudur:
Derece 1 bir doğruya karşılık gelir. Model, bu yeni özelliklerin katsayıları bakımından hâlâ doğrusaldır; yani Ders 02'deki en küçük kareler mekanizması aynen çalışır. Değişen yalnız özelliklerdir.
Ölçekleme ve Ridge düzenlileştirmesi aynı işlem zincirinde tutulur. Ridge, kare hatalara katsayıların karesini de ekleyerek büyük katsayıları cezalandırır ($\alpha$ = 0,1; sabit terim cezalandırılmaz):
$$ \min_{\vect w}\; \lVert \vect h - X\vect w \rVert^2 + \alpha\,\lVert \vect w\rVert^2 $$Neden ölçekleme, neden tek bir işlem zinciri?
35 °C'de $T$ = 35 iken $T^8 \approx 2{,}25\times 10^{12}$'dir. Ölçeklenmemiş sütunlarda Ridge cezası katsayıları adil biçimde karşılaştıramaz ve sayısal koşul bozulur (Ders 02). Bu projedeki zincir standartlaştırmayı genişletmeden sonra yapar: sütunların ölçeği eşitlenir ama ham $T$'nin kuvvetleri birbirine çok benzer kalır (geliştirme verisinde $T^7$ ile $T^8$'in korelasyonu 0,998, 8. derecede özellik matrisinin koşul sayısı yaklaşık $4{,}0\times 10^{5}$). Burada Ridge cezası bu kötü koşullanmayı emer ve sonuç kararlı kalır; yine de daha iyi uygulama $T$'yi genişletmeden önce ölçeklemektir: $[-1, 1]$ aralığına alınmış $T$ ile koşul sayısı yaklaşık 254'e iner (Ders 03). Ölçekleyicinin ortalaması ve standart sapması yalnız eğitim verisinden öğrenilmelidir. make_pipeline bunu kendiliğinden sağlar: fit çağrısı ölçekleyiciyi de yalnız o çağrıya verilen veriyle eğitir. Düzenlileştirmenin ayrıntısı Ders 04'te.
def model(derece):
    return make_pipeline(PolynomialFeatures(derece, include_bias=False),
                         StandardScaler(), Ridge(alpha=0.1))


dogrulama_mae = {}
for derece in (1, 2, 3, 8):
    aday = model(derece).fit(X_train, y_train)
    dogrulama_mae[derece] = mean_absolute_error(y_val, aday.predict(X_val))
en_iyi_derece = min(dogrulama_mae, key=dogrulama_mae.get)
1, 2, 3 ve 8. derecelerin doğrulama MAE'si karşılaştırılır. En düşük hatalı derece seçilince model eğitim ve doğrulama verisi birleştirilerek yeniden eğitilir. Ayrılmış test bölümü yalnızca bu son modeli ölçer. Karşılaştırma için bir de “her zaman geliştirme verisinin ortalamasını söyleyen” referans modeli ölçüyoruz: ondan iyi olmayan bir model hiçbir şey öğrenmemiştir.
4. Çalıştırılabilir kod
Önce kurulum adımlarını tamamlayın ve requirements.txt ile kütüphaneleri yükleyin. Ardından polinom_regresyon.py dosyasını ortamınızdaki Python ile çalıştırın. Sonuç grafiği kodun bulunduğu klasöre kaydedilir.
"""Proje 1 — Polinom regresyonuyla nem tahmini.

Sıcaklıktan bağıl nemi tahmin eden polinom regresyon modelleri kuruyor, polinom derecesini
doğrulama verisiyle seçiyor ve son modeli yalnız bir kez, ayrılmış test verisinde ölçüyoruz.
Veri sentetiktir: 0–35 °C arasında 240 sıcaklık ve nem = 75 − 2T + 0,045T² + gürültü
(standart sapma 3 yüzde puan). Bu ilişki eğitim için uydurulmuştur; meteorolojik bir yasa
ya da gerçek hava verisi değildir.

Çalıştır:  python polinom_regresyon.py
Gerekenler: numpy, scikit-learn, matplotlib  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre bir PNG grafiği (polinom_regresyon.png)
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent

# %% 1. Veri: sıcaklık (°C) ve bağıl nem (%)
rng = np.random.default_rng(42)
X = rng.uniform(0, 35, (240, 1))
# Eğitim için uydurulmuş ilişki; meteorolojik bir yasa değildir.
y = 75 - 2 * X[:, 0] + 0.045 * X[:, 0] ** 2 + rng.normal(0, 3, len(X))
# Önce test (%20) ayrılır; kalan geliştirme verisi eğitim (%60) ve doğrulama (%20) olarak bölünür.
X_dev, X_test, y_dev, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train, X_val, y_train, y_val = train_test_split(X_dev, y_dev, test_size=0.25, random_state=42)
print("=== 1. Veri ===")
print(f"Örnek: {len(X)} (eğitim {len(X_train)}, doğrulama {len(X_val)}, test {len(X_test)})")


def model(derece):
    """Polinom özellikleri → standartlaştırma → Ridge; hepsi tek bir işlem zinciri (pipeline)."""
    return make_pipeline(PolynomialFeatures(derece, include_bias=False),
                         StandardScaler(), Ridge(alpha=0.1))


# %% 2. Dereceyi doğrulama verisinde seç
print("\n=== 2. Derece seçimi (doğrulama) ===")
dogrulama_mae = {}
for derece in (1, 2, 3, 8):
    aday = model(derece).fit(X_train, y_train)
    dogrulama_mae[derece] = mean_absolute_error(y_val, aday.predict(X_val))
    print(f"Derece {derece}: doğrulama MAE = {dogrulama_mae[derece]:.3f} yüzde puan")
en_iyi_derece = min(dogrulama_mae, key=dogrulama_mae.get)

# %% 3. Son model: eğitim + doğrulama verisiyle yeniden eğit, testte bir kez ölç
son_model = model(en_iyi_derece).fit(X_dev, y_dev)
tahmin = son_model.predict(X_test)
referans = np.full_like(y_test, y_dev.mean())          # her zaman ortalamayı söyleyen model
print("\n=== 3. Test (yalnız bir kez) ===")
print(f"Seçilen derece: {en_iyi_derece}")
print(f"Ortalama referansı MAE: {mean_absolute_error(y_test, referans):.3f}")
print(f"Test MAE: {mean_absolute_error(y_test, tahmin):.3f}")
print(f"Test RMSE: {np.sqrt(mean_squared_error(y_test, tahmin)):.3f}")
print(f"Test R²: {r2_score(y_test, tahmin):.3f}")
# Karşılaştırma: veriyi üreten gürültüsüz ilişkinin kendisi bile gürültüyü tahmin edemez
uretici = 75 - 2 * X_test[:, 0] + 0.045 * X_test[:, 0] ** 2
print(f"Veriyi üreten ilişkinin kendisi: test MAE = {mean_absolute_error(y_test, uretici):.3f}, "
      f"R² = {r2_score(y_test, uretici):.3f}")
assert np.isfinite(tahmin).all()

# %% 4. Grafik
eksen = np.linspace(0, 35, 250).reshape(-1, 1)
fig, ax = plt.subplots(figsize=(9, 4.8), layout="constrained")
ax.scatter(X_test[:, 0], y_test, s=22, color=SOLUK, alpha=.8, label="Ayrılan test verisi")
ax.plot(eksen[:, 0], son_model.predict(eksen), color=RENK[0], label=f"Model: derece {en_iyi_derece}")
ax.plot(eksen[:, 0], 75 - 2 * eksen[:, 0] + 0.045 * eksen[:, 0] ** 2, color=MUREKKEP, ls="--", lw=1.2,
        label="Veriyi üreten ilişki (gürültüsüz)")
ax.axhline(y_dev.mean(), color=RENK[1], ls=":", lw=1.5, label="Ortalama referansı")
ax.set(xlabel="Sıcaklık (°C)", ylabel="Bağıl nem (%)", title="Sentetik veride polinom regresyonu")
ax.legend(loc="lower left")
fig.savefig(KLASOR / "polinom_regresyon.png", dpi=160)
plt.close(fig)
print("\nGrafik kaydedildi: polinom_regresyon.png")=== 1. Veri ===
Örnek: 240 (eğitim 144, doğrulama 48, test 48)
=== 2. Derece seçimi (doğrulama) ===
Derece 1: doğrulama MAE = 4.697 yüzde puan
Derece 2: doğrulama MAE = 2.284 yüzde puan
Derece 3: doğrulama MAE = 2.286 yüzde puan
Derece 8: doğrulama MAE = 2.248 yüzde puan
=== 3. Test (yalnız bir kez) ===
Seçilen derece: 8
Ortalama referansı MAE: 4.777
Test MAE: 2.681
Test RMSE: 3.260
Test R²: 0.626
Veriyi üreten ilişkinin kendisi: test MAE = 2.702, R² = 0.624
Grafik kaydedildi: polinom_regresyon.png5. Sonuçları yorumlayın
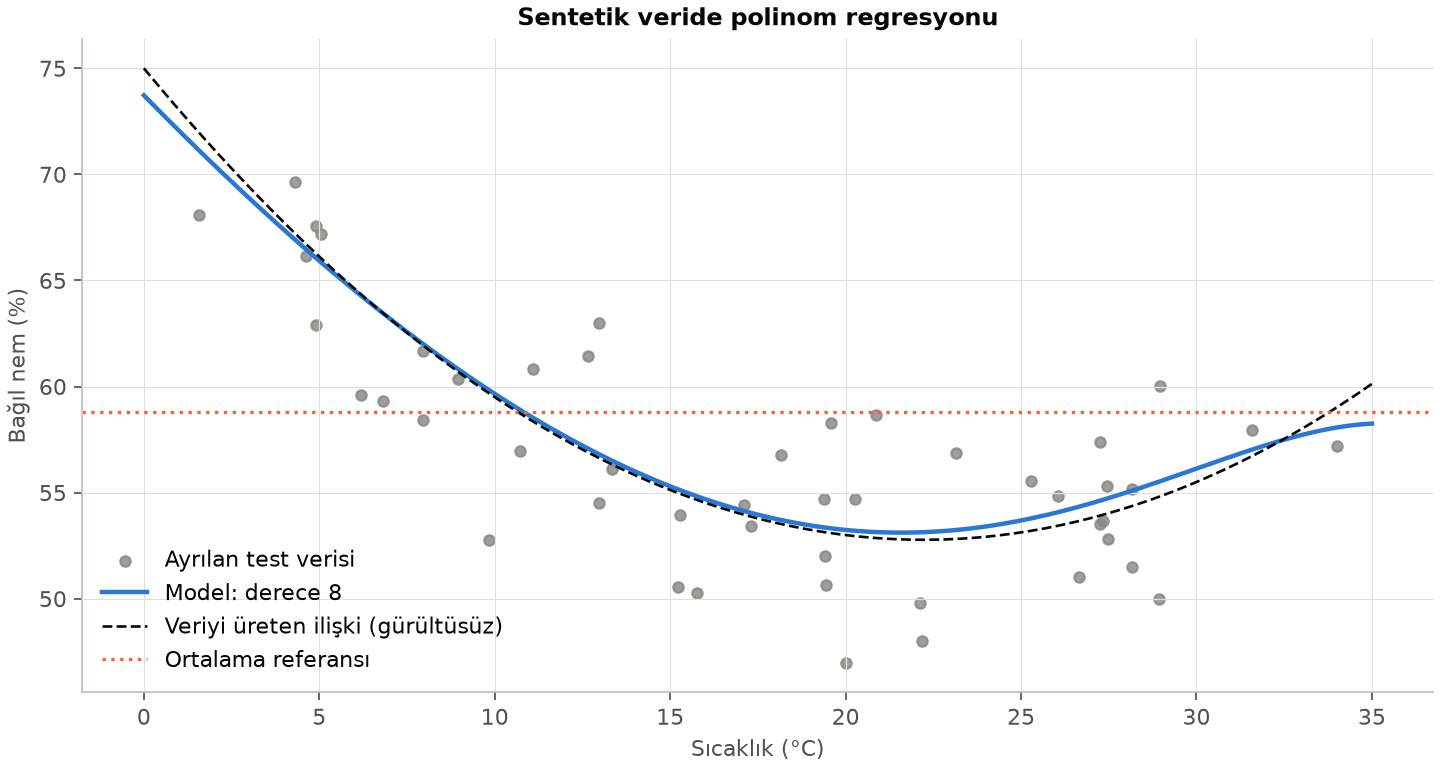
Bu çalıştırmada 8. derece seçildi: doğrulama MAE'si 2,248 yüzde puandı. 2. derecenin 2,284 değerine çok yakın olması, tek bir ayrımın küçük farklarına fazla anlam yüklemememiz gerektiğini gösterir. Daha yüksek derece her veri setinde daha iyi olmaz. 1. derece ise 4,697 ile açıkça yetersiz kalıyor: doğru, eğrinin minimumunu göremez.
Test MAE'si 2,681 yüzde puan, RMSE 3,260 ve $R^2$ 0,626. Geliştirme verisinin (eğitim + doğrulama) ortalamasını kullanan referansın MAE'si 4,777. Bu sayılar yalnızca üretilen sentetik örneğe aittir.
$R^2$ = 0,626 ilk bakışta zayıf görünebilir. Ama çıktıdaki son satır başka bir şey söylüyor: veriyi üreten gürültüsüz ilişkinin kendisi bile bu test verisinde 2,702 MAE ve 0,624 $R^2$ verir. Kalan hata, hiçbir modelin tahmin edemeyeceği gürültüdür. Modelimiz bu sınıra ulaşmış; daha iyisini beklemek, gürültüyü ezberlemek olurdu. Grafikte 8. derece eğri, veri aralığının içinde üreten ilişkiyle neredeyse üst üste; uçlarda ise 1–2 yüzde puan ayrılıyor: 0 °C'de 73,73'e karşı 75,00, 35 °C'de 58,25'e karşı 60,12. Bu, aşağıda göreceğimiz dış değer sorununun ilk işaretidir.
Gerçek ilişki ikinci dereceyken neden sekizinci derece seçilebilir?
Sonlu ve gürültülü bir doğrulama kümesinde küçük rastlantısal farklar olabilir. 48 ölçümlük bir kümede 2,248 ile 2,284 arasındaki fark, başka bir örneklemde kolayca tersine döner (Alıştırma 1). Ridge cezası da 8. derece modelin katsayılarını küçük tutarak onu veri aralığında 2. dereceye benzer bir eğriye zorlar. Bağımsız verilerde çapraz doğrulama, seçimin farklı bölmelerde ne kadar tutarlı olduğunu incelemeye yardımcı olur (Ders 03; bu projede Alıştırma 3). Testi tekrar tekrar seçim için kullanmayın.
İki model veri aralığında aynı hatayı veriyorsa basit olanı tercih etmenin pratik bir nedeni daha vardır: aralığın dışında çok farklı davranırlar. 35 °C'nin üstünde 8. derece model, gerçek ilişkiden hızla uzaklaşır (Alıştırma 4).
6. Sık yapılan hatalar
- Testi seçim için kullanmak. Dereceyi test hatasına bakarak seçer, sonra aynı test hatasını raporlarsanız sonuç iyimser olur. Test verisi yalnız en sonda, bir kez kullanılır.
- Ölçekleyiciyi bütün veriye uydurmak.
StandardScaler'ı bölmeden önce bütün veriye uydurmak, doğrulama ve test bilgisini eğitime sızdırır. İşlem zinciri (pipeline) bunu önler. - Küçük doğrulama farklarına anlam yüklemek. 2,248 ile 2,284 arasındaki fark gürültü düzeyindedir. Fark küçükse basit modeli seçin.
- Polinomla aralık dışına çıkmak. Yüksek dereceli polinomlar eğitim aralığının dışında hızla ıraksar. Model yalnız gördüğü sıcaklık aralığında kullanılmalıdır.
- $R^2$'yi tek başına yorumlamak. Gürültülü bir problemde düşük $R^2$ en iyi sonuç olabilir. Hatayı, gürültü düzeyi ve basit bir referansla birlikte okuyun.
7. Alıştırmalar
Alıştırma 1KolayBaşka bir tohum
Tohumu 42 yerine 7 yapın (np.random.default_rng(7); train_test_split içindeki random_state=42 kalsın). Seçilen derece değişiyor mu? Test sonuçları nasıl?
Çözümü göster
Bu kez 2. derece seçilir. Doğrulama MAE'leri derece 1, 2, 3 ve 8 için 4,519; 2,638; 2,661 ve 2,651'dir: 2, 3 ve 8. dereceler arasındaki farklar yine 0,03'ün altında. Test MAE'si 2,246, RMSE 2,767, $R^2$ 0,868; ortalama referansının MAE'si 6,128. $R^2$'nin yükselmesi modelin daha iyi olduğu anlamına gelmez: bu test kümesinde nem değerleri daha geniş yayıldığı için referansın hatası da büyüdü. Ders: tek bir doğrulama kümesine göre yapılan seçim, örneklemle değişebilir.
Alıştırma 2KolayGürültüyü artırın
Gürültünün standart sapmasını 3'ten 6'ya çıkarın (rng.normal(0, 6, len(X))). Seçilen derece ve referansla fark nasıl değişiyor?
Çözümü göster
Yine 8. derece seçilir (doğrulama MAE'leri 6,113; 4,537; 4,532; 4,481). Test MAE'si 5,339, RMSE 6,502, $R^2$ 0,212; ortalama referansı 6,396. Modelin referansa göre kazancı 2,096 yüzde puandan (4,777 − 2,681) 1,057'ye (6,396 − 5,339) iner. Gürültü arttıkça aynı sinyal daha zor ayırt edilir, doğrulama kümesindeki farklar da daha az anlamlı olur. Düşük $R^2$ burada da büyük ölçüde gürültüden gelir.
Alıştırma 3OrtaÇapraz doğrulamayla seçim
Tek bir doğrulama kümesi yerine geliştirme verisinde (192 ölçüm) 5 katlı çapraz doğrulama kullanın ve 1'den 8'e kadar bütün dereceleri karşılaştırın. Hangi derece seçilir? Derecelerin farkı katlar arasındaki değişkenliğe göre ne kadar büyük?
Çözümü göster
from sklearn.model_selection import KFold, cross_val_score
kf = KFold(n_splits=5, shuffle=True, random_state=42)
for derece in range(1, 9):
    mae = -cross_val_score(model(derece), X_dev, y_dev, cv=kf, scoring="neg_mean_absolute_error")
    print(derece, mae.mean(), mae.std())
En düşük ortalama MAE 2. derecededir: 2,368 (katlar arası standart sapma 0,296). 3–8. dereceler 2,378 ile 2,402 arasındadır; 1. derece 4,024. 2–8. dereceler arasındaki en büyük fark 0,034'tür; bu, ortalama MAE'nin standart hatasından ($0{,}296/\sqrt 5 \approx 0{,}13$) çok küçüktür. Bu modeller pratikte eşdeğerdir. “Bir standart hata” kuralı, en iyi ortalamaya bir standart hata kadar yakın olan en basit modeli seçer; burada yine 2. derecedir (1. derece 4,024 ile bu sınırın çok dışındadır). Çapraz doğrulama hem daha kararlı bir ortalama verir hem de farkların anlamlı olup olmadığını görmemizi sağlar (Ders 03).
Alıştırma 4ZorAynı test hatası, farklı dış değer
Geliştirme verisiyle 2. ve 8. derece modelleri eğitin. Test hatalarını karşılaştırın, sonra 35, 40 ve 45 °C için tahminlerini veriyi üreten ilişkiyle karşılaştırın. Ne görüyorsunuz?
Çözümü göster
Test hataları neredeyse aynıdır: 2. derece MAE 2,695 ve $R^2$ 0,628; 8. derece MAE 2,681 ve $R^2$ 0,626. Aralığın dışında ise yollar ayrılır:
| Sıcaklık | Üreten ilişki | 2. derece | 8. derece |
|---|---|---|---|
| 35 °C | 60,12 | 59,80 | 58,25 |
| 40 °C | 67,00 | 66,03 | 53,92 |
| 45 °C | 76,12 | 74,32 | 29,94 |
8. derece model 45 °C'de nemi yarıdan fazla düşük tahmin eder. Polinomun yüksek kuvvetleri, verinin olmadığı yerde hiçbir şeyle sınırlanmaz. Ridge cezası bunu bir ölçüde frenler: aynı modeli eğitim verisiyle $\alpha = 10^{-8}$ alarak eğitirseniz doğrulama MAE'si yine 2,271 olur, ama 45 °C tahmini −524'e gider. Ders: test hatası yalnız test verisinin aralığı için konuşur. Dış değer gerekiyorsa basit ve fiziksel olarak anlamlı model biçimleri seçin.
Özet
- Polinom regresyonu, özellikleri $T, T^2, \dots$ ile genişleten doğrusal bir modeldir; ölçekleme ve Ridge aynı işlem zincirinde tutulur.
- Derece doğrulama verisiyle seçilir, son model eğitim ve doğrulama birleştirilerek yeniden eğitilir, test yalnız bir kez kullanılır.
- Küçük doğrulama farkları gürültü olabilir: bu çalıştırmada 8. derece 2,248 ile seçildi, 2. derece 2,284'tü. Çapraz doğrulama 2. dereceyi seçti.
- Test MAE'si 2,681, referans 4,777. $R^2$ = 0,626 gürültü sınırındadır: üreten ilişkinin kendisi 0,624 verir.
Başlangıç seviyesi burada bitiyor. Orta seviyede Ders 05 ile sınıflandırmaya geçiyoruz: bir sayıyı değil, bir olasılığı tahmin edeceğiz.
Kaynaklar
- scikit-learn — model değerlendirme ve veri sızıntısı (sık yapılan hatalar).
- scikit-learn — doğrusal modeller ve Ridge belgeleri.
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 3 (Ridge) ve Bölüm 7 (model değerlendirme ve seçimi).