Bu derste öğrenecekleriniz
- Evrişimi (çapraz korelasyon) formülüyle yazmak ve NumPy ile uygulamak
- Dolgu, adım ve kanallarla çıktı boyutunu ve parametre sayısını hesaplamak
- Havuzlamanın, alıcı alanın ve öteleme eşdeğerliğinin rolünü açıklamak
- LeNet, VGG ve ResNet'in temel fikirlerini ve toplu normalleştirmeyi tanımak
- PyTorch ile küçük bir CNN'i veri artırmayla eğitip karışıklık matrisiyle değerlendirmek
- Örtme duyarlılığıyla modelin kararını incelemek ve alan kaymasını tartışmak
1. Problem: beton yüzeyinde çatlak var mı?
Köprü, tünel ve bina yüzeylerinin muayenesi büyük ölçüde gözle yapılır. Bugün dronlar ve araç üstü kameralar bir yapıdan binlerce fotoğraf topluyor; bunların hepsine tek tek bakmak hem yavaş hem de yorucu. Otomatik bir sınıflandırıcının ilk görevi basittir: her görüntü parçası için “çatlak var mı?” sorusunu yanıtlamak ve mühendisin bakması gereken görüntüleri öne çıkarmak. Çatlağın genişliği, deseni ve konumu gibi yapısal değerlendirme için gereken bilgiler daha sonraki adımlardır.
Görüntü bir sayı tablosudur: 64×64 piksellik gri tonlu bir görüntü 4096 sayıdan oluşur. Ders 11'deki tam bağlantılı bir ağa bu 4096 sayıyı doğrudan vermek mümkündür, ama iki büyük sorun vardır. Birincisi, çatlak görüntünün herhangi bir yerinde olabilir; tam bağlantılı ağ her konumu ayrı ayrı öğrenmek zorundadır. İkincisi, parametre sayısı patlar. Bu derste her iki sorunu da çözen evrişimli sinir ağlarını (CNN) tanıyacağız.
Veri sentetiktir ve betikte üretilir. Her görüntü bir “beton yüzeyi” dokusuyla başlar: rastgele bir taban gri tonu, iki ölçekte yumuşatılmış gürültü, ışık eğimi ve agrega tanesi ya da gözenek gibi küçük açık ve koyu lekeler. Çatlaklı görüntülere kenardan başlayan, yönü her adımda biraz sapan bir rastgele yürüyüşle 1–2,2 piksel genişliğinde koyu bir kırık çizgi çizilir; bazılarında bu çizgi dallanır. Toplam 3000 görüntünün yarısı çatlaklı; 2000'i eğitim, 500'ü doğrulama, 500'ü test için ayrıldı.
Kestirme öğrenmeye karşı dikkat dağıtıcılar
Çatlaklı görüntüler yalnızca “daha koyu” olsaydı, model koyu piksel sayarak doğru sonuca ulaşabilirdi; buna kestirme öğrenme (shortcut learning) denir. Bunu önlemek için görüntülere çatlakla benzer koyulukta ama daha geniş (2,8–4,5 piksel), düz bir derz çizgisi, lekeler ve kısa, ince, düz çizikler ekledik. Sonuçta koyu piksel oranı çatlaklı görüntülerde yüzde 6,2 ± 2,3, çatlaksızlarda yüzde 5,7 ± 2,5: iki dağılım neredeyse tamamen üst üste biniyor.
Ancak dikkat dağıtıcılar iki sınıfa eşit dağılmadı: derz çatlaksız görüntülerin yüzde 59'unda, çatlaklıların yüzde 30'unda; leke çatlaksızların yüzde 58'inde, çatlaklıların yüzde 41'inde var (çizik iki sınıfta da yaklaşık dörtte bir). Bu asimetrinin kendisi bir kestirme ipucudur: “derz varsa büyük olasılıkla sağlam” kuralı bu veride işe yarar ama gerçek yapılarda geçerli değildir. Model böyle bir ipucu kullanıyor mu, Bölüm 8'de kontrollü bir sınamayla bakacağız.
Bu görüntüler gerçek fotoğraf değildir. Gerçek yüzeylerdeki ışık, nem, kalıp izi, boya, kamera ve çözünürlük çeşitliliği burada yoktur; sonuçları bu gözle okuyun (Bölüm 9).
2. Evrişim işlemi
Evrişim katmanı, küçük bir ağırlık matrisini, yani bir çekirdeği (kernel), görüntünün üzerinde kaydırır ve her konumda çekirdekle altındaki piksellerin çarpımlarının toplamını alır. Girdi $X$, $k\times k$ çekirdek $K$, sapma $b$ ve adım $s$ için çıktı:
$$ \begin{aligned} Y[i,j] &= b + \sum_{u=0}^{k-1}\sum_{v=0}^{k-1} K[u,v] \\ &\qquad\times X[i\,s+u,\ j\,s+v] \end{aligned} $$Matematikteki evrişim tanımında çekirdek ters çevrilir; derin öğrenme kütüphanelerinin hesapladığı aslında yukarıdaki çapraz korelasyondur. Çekirdek zaten öğrenildiği için bu fark pratikte önemsizdir ve işleme yine evrişim denir.
Elle tasarlanmış klasik bir çekirdek örneği Sobel filtresidir. Yatay türevi, düşey yönde hafif bir yumuşatmayla birlikte yaklaşıklar:
$$ K_x = \begin{bmatrix} -1 & 0 & 1 \\ -2 & 0 & 2 \\ -1 & 0 & 1 \end{bmatrix} $$Düşey türev için $K_y = K_x^\top$ kullanılır; kenar şiddeti $|G| = \sqrt{G_x^2 + G_y^2}$'dir. Evrişimi NumPy ile iki döngüyle yazdık ve PyTorch'un conv2d fonksiyonuyla karşılaştırdık; en büyük fark $4{,}4\times10^{-16}$, yani makine hassasiyeti düzeyinde.
def evrisim2d(img, K, adim=1, dolgu=0, kip="constant"):
    if dolgu:
        img = np.pad(img, dolgu, mode=kip)
    k = K.shape[0]
    H = (img.shape[0] - k) // adim + 1          # = ⌊(n + 2p − k)/s⌋ + 1
    W = (img.shape[1] - k) // adim + 1
    Y = np.empty((H, W))
    for i in range(H):
        for j in range(W):
            Y[i, j] = np.sum(img[i * adim:i * adim + k, j * adim:j * adim + k] * K)
    return Y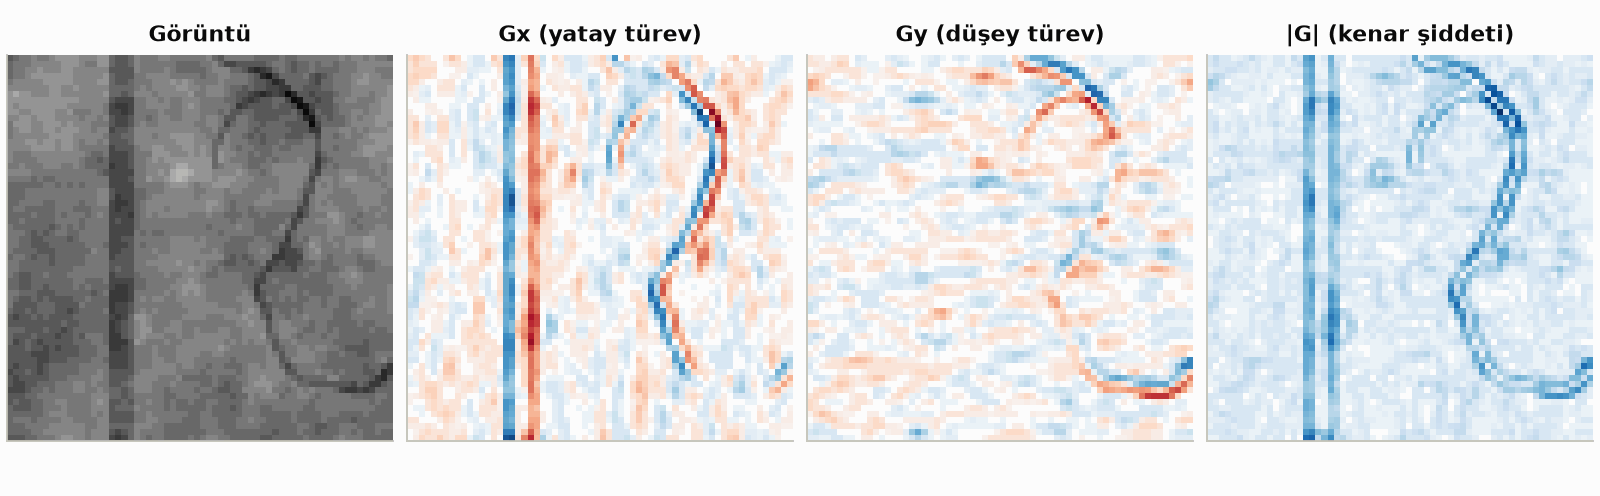
Şekil 1'deki görüntü hem bir derz hem de bir çatlak içeriyor. Sobel her ikisinin de kenarlarını buluyor: ortalama kenar şiddeti çatlak piksellerinde 0,56, derz piksellerinde 0,47, geri kalan piksellerde 0,22. Kenar bulmak yetmez; hangi kenar desenlerinin çatlağa ait olduğunu da bilmek gerekir. CNN'in yaptığı tam olarak budur: çekirdekleri elle tasarlamak yerine veriden öğrenir ve katmanları üst üste koyarak basit kenarlardan karmaşık desenlere doğru ilerler.
Adım, dolgu ve çıktı boyutu
$n\times n$ girdiye $k\times k$ çekirdek, $p$ piksellik dolgu (padding) ve $s$ adımla (stride) uygulanınca çıktının kenarı:
$$ n_{\text{çıkış}} = \left\lfloor \frac{n + 2p - k}{s} \right\rfloor + 1 $$3×3 çekirdek ve 1 piksel dolguyla adım 1'de boyut korunur (64 → 64). Adım 2'de yarıya iner: $\lfloor(64 + 2 - 3)/2\rfloor + 1 = 32$. Dolgu olmadan her 3×3 evrişim kenarlardan birer piksel yer. Dolguda genellikle sıfır kullanılır; Şekil 1'de kenarlarda yapay türev oluşmasın diye kenar piksellerini tekrarladık.
Kanallar ve parametre sayısı
Gerçek katmanlar çok kanallıdır. Girdinin $C_g$ kanalı (renkli görüntüde 3, önceki katmanın çıktısında onlarca) ve çıktının $C_ç$ kanalı varsa, her çıkış kanalı, bütün giriş kanallarına ayrı çekirdeklerle uygulanan evrişimlerin toplamıdır:
$$ \begin{aligned} Y[c,i,j] &= b_c + \sum_{c'=1}^{C_g}\sum_{u,v} W[c,c',u,v] \\ &\qquad\times X[c',\ i\,s+u,\ j\,s+v] \end{aligned} $$Ağırlık tensörünün boyutu $C_ç\times C_g\times k\times k$'dır (PyTorch'taki sıra) ve parametre sayısı $C_ç\,C_g\,k^2 + C_ç$'dir. Görüntünün boyutu bu sayıda yer almaz: aynı çekirdek her konumda yeniden kullanılır (ağırlık paylaşımı). 64×64'lük gri görüntüyü 16 kanala çeviren 3×3 bir evrişim katmanının 160 parametresi vardır. Aynı boyutta (16×64×64) çıktı üreten tam bağlantılı bir katmanın ise 268.500.992.
3. Havuzlama, alıcı alan ve öteleme
Havuzlama (pooling) özellik haritasını küçültür. 2×2 en büyük havuzlama (max pooling) her 2×2'lik bloktan en büyük değeri alır ve haritanın kenarlarını yarıya indirir; ortalama havuzlama ise ortalamayı alır. Küresel ortalama havuzlama (global average pooling) her kanalın bütün haritasının ortalamasını alıp tek bir sayıya indirir.
Bir birimin alıcı alanı (receptive field), çıktısını etkileyen girdi piksellerinin bölgesidir. Katmanlar üst üste geldikçe büyür. $j$, art arda adımların çarpımı (komşu iki birimin girdide kaç piksel aralıkla dizildiği) olmak üzere, $k$ çekirdekli ve $s$ adımlı her katmanda:
$$ r_l = r_{l-1} + (k_l - 1)\,j_{l-1} $$ $$ j_l = j_{l-1}\,s_l $$| Katman | $k$ | $s$ | $r$ | $j$ | Harita |
|---|---|---|---|---|---|
| Conv 3×3 | 3 | 1 | 3 | 1 | 8×64×64 |
| MaxPool 2×2 | 2 | 2 | 4 | 2 | 8×32×32 |
| Conv 3×3 | 3 | 1 | 8 | 2 | 16×32×32 |
| MaxPool 2×2 | 2 | 2 | 10 | 4 | 16×16×16 |
| Conv 3×3 | 3 | 1 | 18 | 4 | 32×16×16 |
| MaxPool 2×2 | 2 | 2 | 22 | 8 | 32×8×8 |
Son haritadaki her birim görüntünün 22×22 piksellik bir bölgesini görür. Bu, bir çatlağın birkaç kıvrımını ya da bir derzin düz bir parçasını kapsayacak kadar geniştir. Küresel ortalama havuzlama bu 8×8 = 64 birimin ortalamasını alarak kararı bütün görüntüye dayandırır.
Öteleme eşdeğerliği ve değişmezliği
Girdiyi birkaç piksel kaydırırsanız evrişimin çıktısı da aynı miktarda kayar (kenarlar dışında): $(T_\delta X)\star K = T_\delta(X\star K)$. Buna öteleme eşdeğerliği (translation equivariance) denir ve ağırlık paylaşımının doğrudan sonucudur. Havuzlama küçük kaymalara karşı yerel bir değişmezlik ekler; küresel ortalama havuzlama ise “çatlak nerede olursa olsun” yaklaşık aynı yanıtı verir (adımlı havuzlama ve sıfır dolgu yüzünden tam değil). Tam bağlantılı bir ağda bu özellikler yoktur: sol üst köşedeki çatlağı tanımayı öğrenen ağırlıklar, sağ alt köşedeki için hiçbir şey bilmez.
4. LeNet'ten ResNet'e
CNN mimarilerinin gelişimi birkaç kilometre taşıyla özetlenebilir:
- LeNet-5 (LeCun vd., 1998): evrişim–havuzlama–evrişim–havuzlama ve ardından tam bağlantılı katmanlar. El yazısı rakam tanımada kullanıldı; bugünkü yapının iskeleti.
- AlexNet (Krizhevsky, Sutskever ve Hinton, 2012): ReLU, dropout ve GPU ile eğitilen daha derin bir ağ; ImageNet yarışmasındaki başarısı derin öğrenme dönemini başlattı.
- VGG (Simonyan ve Zisserman, 2015): yalnızca 3×3 çekirdeklerin art arda dizilmesi. İki 3×3 katman bir 5×5 katmanla aynı alıcı alanı verir, ama $C$ kanal için $25C^2$ yerine $18C^2$ parametreyle ve arada bir doğrusal olmayan aktivasyonla.
- ResNet (He vd., 2016): artık bağlantı (residual connection). Bir blok girdisini dönüştürmek yerine girdiye bir düzeltme ekler.
Türev alınınca $\partial\vect y/\partial\vect x = \partial F/\partial\vect x + I$ çıkar. Birim matris terimi, gradyanın her blokta zayıflamadan geriye akabileceği bir yol açar. Bu sayede yüzden fazla katmanlı ağlar eğitilebilir hâle geldi; daha önce derinlik arttıkça eğitim hatası bile kötüleşiyordu.
Toplu normalleştirme, Ders 12'de gördüğümüz fikrin evrişim katmanlarındaki hâlidir: her kanal için ortalama ve varyans, mini-yığındaki bütün örnekler ve bütün konumlar üzerinden hesaplanır:
$$ \hat x = \frac{x - \mu_B}{\sqrt{\sigma_B^2 + \epsilon}} $$ $$ y = \gamma\,\hat x + \beta $$$\gamma$ ve $\beta$ kanal başına öğrenilir. $\beta$ zaten bir kaydırma olduğu için toplu normalleştirmeden önce gelen evrişimin sapmasına gerek yoktur; kodda bias=False kullandık. Değerlendirmede eğitim boyunca biriktirilen ortalamalar kullanılır; model.eval()'u unutmamanın bir nedeni daha.
5. Veri artırma ve aktarımlı öğrenme
Veri artırma (data augmentation), eğitim görüntülerine etiketi değiştirmeyen dönüşümler uygulayarak veriyi çoğaltır. Çatlağın belirli bir yönü yoktur; bu yüzden 90°'lik dönmeler ve aynalama güvenlidir. Işık koşulları değişkendir; parlaklık ve karşıtlık değişimi de güvenlidir. Kodda her örneğe rastgele 90°'lik dönme, yüzde 50 olasılıkla ayna ve ±yüzde 20 karşıtlık ile ±0,15 standart birimlik parlaklık değişimi uyguladık.
def artir(xb, g):
    k = torch.randint(0, 4, (len(xb),), generator=g)
    out = torch.empty_like(xb)
    for r in range(4):
        m = k == r
        if m.any():
            out[m] = torch.rot90(xb[m], r, dims=(2, 3))
    ayna = torch.rand(len(xb), generator=g) < 0.5
    out[ayna] = torch.flip(out[ayna], dims=(3,))
    c = 0.8 + 0.4 * torch.rand(len(xb), 1, 1, 1, generator=g)
    b = 0.3 * (torch.rand(len(xb), 1, 1, 1, generator=g) - 0.5)
    return out * c + b
Her dönüşüm her problem için güvenli değildir. Görüntüyü rastgele kırpmak çatlağı kadrajın dışında bırakabilir ve etiketi “sağlam”a çevirir; güçlü bulanıklaştırma ince çatlakları silebilir. Artırmayı seçerken “bu dönüşümden sonra etiket hâlâ doğru mu?” diye sorun.
Aktarımlı öğrenme (transfer learning), büyük bir veri kümesinde (tipik olarak 1000 sınıflı ImageNet) önceden eğitilmiş bir ağı başlangıç noktası olarak kullanır. İlk katmanlar kenar, köşe, doku gibi genel desenleri öğrendiği için başka görüntü problemlerine de aktarılabilir. Son katman yeni probleme göre değiştirilir; önce yalnızca o katman eğitilir, sonra gerekirse bütün ağ küçük bir öğrenme hızıyla ince ayarlanır (fine-tuning). Az etiketli verisi olan çatlak tespiti gibi problemlerde bu, sıfırdan eğitimden genellikle çok daha iyi sonuç verir. Aşağıdaki parça yalnızca fikri göstermek içindir; ayrı kurulan torchvision paketini ve ağırlıkların internetten indirilmesini gerektirdiği için bu dersin kodunda kullanmıyoruz:
import torchvision                                   # kurs ortamında yok, ayrıca kurulur
agirlik = torchvision.models.ResNet18_Weights.IMAGENET1K_V1  # ilk kullanımda indirilir
model = torchvision.models.resnet18(weights=agirlik)
model.fc = nn.Linear(model.fc.in_features, 1)        # 1000 sınıf yerine tek logit
for p in model.parameters():
    p.requires_grad = False                          # önce gövdeyi dondur
for p in model.fc.parameters():
    p.requires_grad = True                           # yalnız yeni katmanı eğit
# Gri görüntü 3 kanala kopyalanır ve ImageNet ortalama/std değerleriyle normalleştirilir.
6. Modelimiz ve eğitim
Ağımız üç blok ve bir çıkış katmanından oluşuyor. Her blok 3×3 evrişim, toplu normalleştirme, ReLU ve 2×2 en büyük havuzlamadır; kanal sayısı 8, 16, 32 diye artar. Son haritanın küresel ortalaması tek bir doğrusal katmana gider ve çatlak için bir logit üretir. Toplam 5977 parametre var: bloklar sırasıyla 88, 1184 ve 4672, çıkış katmanı 33 (88 + 1184 + 4672 + 33 = 5977). Evrişimlerde sapma yok, çünkü onun işini toplu normalleştirmenin kaydırması görüyor; her toplu normalleştirme katmanı kanal başına 2 parametre ($\gamma$, $\beta$) ekliyor. Örneğin ilk blok $8\cdot1\cdot3^2 + 2\cdot8 = 88$. Bu sayı Ders 12'deki tam bağlantılı plak ağından (8770) bile az, oysa girdisi 4 değil 4096 sayı.
class CatlakAgi(nn.Module):
    def __init__(self, kanallar=(8, 16, 32)):
        super().__init__()
        katmanlar, c_g = [], 1
        for c in kanallar:
            katmanlar += [nn.Conv2d(c_g, c, 3, padding=1, bias=False), nn.BatchNorm2d(c),
                          nn.ReLU(), nn.MaxPool2d(2)]
            c_g = c
        self.govde = nn.Sequential(*katmanlar)
        self.cikis = nn.Linear(c_g, 1)

    def forward(self, x):                      # x: (N, 1, 64, 64)
        h = self.govde(x)                      # (N, 32, 8, 8)
        h = h.mean(dim=(2, 3))                 # küresel ortalama havuzlama → (N, 32)
        return self.cikis(h).squeeze(1)        # logit
Kayıp fonksiyonu BCEWithLogitsLoss, optimizer Adam (öğrenme hızı 0,003, kosinüs azaltmayla), yığın boyu 64. Pikselleri eğitim kümesinin ortalaması ve standart sapmasıyla normalleştirdik. 12 dönem eğittik ve doğrulama doğruluğunun en yüksek olduğu dönemin ağırlıklarını sakladık. Karşılaştırma için iki lojistik regresyon modeli kurduk: biri görüntü başına altı el yapımı özellikle (ortalama, standart sapma, yüzde 5'lik parlaklık, koyu piksel oranı, Sobel kenar şiddetinin ortalaması ve yüzde 99'luk değeri), diğeri 16×16'ya küçültülmüş 256 pikselle.
7. Çalıştırılabilir kod
Betik yedi bölümden oluşuyor: veri üretimi, NumPy ile evrişim, temel modeller, CNN tanımı ve eğitimi, test ölçütleri, örtme duyarlılığı ve grafikler. Bu makinede CPU'da bir buçuk–üç dakika sürdü. Evrişimlerde toplama sırası işlemciye ve iş parçacığı sayısına göre değişebildiği için sizin sayılarınız son basamaklarda, eğitim boyunca birikerek de bir–iki puan farklı çıkabilir.
"""Ders 13 — Evrişimli sinir ağları ile çatlak tespiti.

Önce evrişimi NumPy ile sıfırdan yazıp Sobel kenar filtrelerini sentetik bir çatlak görüntüsüne
uyguluyoruz. Sonra 64×64 piksellik gri tonlu "beton yüzeyi" görüntülerinde çatlak olup olmadığını
küçük bir evrişimli sinir ağıyla (CNN) sınıflandırıyor, iki basit lojistik regresyon modeliyle
karşılaştırıyoruz. Veri tamamen sentetiktir ve betikte üretilir: yumuşatılmış gürültü dokusu,
agrega taneleri, lekeler; çatlaklı görüntülerde rastgele yürüyüşle çizilen koyu bir kırık çizgi,
çatlaksız görüntülerde ise dikkat dağıtıcılar (düz derz çizgileri, lekeler, kısa çizikler).
Gerçek fotoğraf değildir; ışık, kamera ve yüzey çeşitliliği gerçek verideki kadar geniş değildir.

Çalıştır:  python d13_cnn_catlak.py
Gerekenler: numpy, scipy, scikit-learn, matplotlib, torch  (Python 3.12+; CPU yeterli)
Süre:      yaklaşık 1–3 dk
Çıktılar:  terminale sayılar, aynı klasöre dört PNG grafiği
"""
import copy
from pathlib import Path

import numpy as np
from scipy.ndimage import gaussian_filter
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.metrics import confusion_matrix, precision_score, recall_score

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent
rng = np.random.default_rng(42)
torch.manual_seed(42)
N = 64                                          # görüntü kenarı (piksel)
yy, xx = np.mgrid[0:N, 0:N].astype(float)


# %% 1. Sentetik beton yüzeyi görüntüleri
def doku(rng):
    """Taban gri ton + iki ölçekli yumuşatılmış gürültü + ışık eğimi + agrega taneleri/gözenekler."""
    img = rng.uniform(0.45, 0.70) + rng.normal(0, 0.015, (N, N))
    for olcek, genlik in [(6.0, 0.05), (1.0, 0.03)]:
        g = gaussian_filter(rng.normal(size=(N, N)), olcek, mode="wrap")
        img += genlik * g / g.std()
    aci = rng.uniform(0, 2 * np.pi)
    img += rng.uniform(0, 0.10) * (np.cos(aci) * (xx - 32) + np.sin(aci) * (yy - 32)) / 45
    for _ in range(rng.integers(6, 20)):
        cx, cy, r = rng.uniform(0, N), rng.uniform(0, N), rng.uniform(0.8, 2.8)
        genlik = rng.uniform(0.04, 0.12) * rng.choice([-1, 1], p=[0.4, 0.6])
        us = np.clip(((xx - cx)**2 + (yy - cy)**2 - r**2) / (0.6 * r), -50, 50)
        img += genlik / (1 + np.exp(us))                         # yumuşak kenarlı disk
    return img


def leke(img, rng):
    cx, cy = rng.uniform(0, N, 2)
    sx, sy = rng.uniform(5, 14, 2)
    return img - rng.uniform(0.06, 0.16) * np.exp(-((xx - cx)**2 / (2 * sx**2) + (yy - cy)**2 / (2 * sy**2)))


PIKSEL = np.stack([xx.ravel(), yy.ravel()], axis=1)            # (4096, 2) piksel merkezleri


def cizgi_ciz(img, noktalar, genislik, koyuluk):
    """Kırık çizgiyi yumuşak kenarlı çiz: her pikselin en yakın doğru parçasına uzaklığı."""
    A = np.asarray(noktalar[:-1], dtype=float)                   # parça başlangıçları (S, 2)
    V = np.asarray(noktalar[1:], dtype=float) - A                # parça vektörleri
    D = PIKSEL[:, None, :] - A[None]                             # (4096, S, 2)
    s = np.clip((D * V).sum(-1) / ((V * V).sum(-1) + 1e-12), 0, 1)
    d = np.linalg.norm(D - s[..., None] * V[None], axis=-1).min(axis=1)
    return img - koyuluk * np.clip(0.5 + genislik / 2 - d.reshape(N, N), 0, 1)


def rastgele_yuruyus(x, y, yon, adim_sayisi, rng, sapma=0.25):
    pts = [(x, y)]
    for _ in range(adim_sayisi):
        yon += rng.normal(0, sapma) + (rng.choice([-0.7, 0.7]) if rng.random() < 0.08 else 0.0)
        x, y = x + 2.0 * np.cos(yon), y + 2.0 * np.sin(yon)
        pts.append((x, y))
        if not (-3 < x < N + 3 and -3 < y < N + 3):
            break
    return pts


def catlak(img, rng):
    """Kenardan başlayan, yönünü koruyan rastgele yürüyüş (+ olası dal); genişlik 1–2,2 px, koyu."""
    while True:
        kenar, s = rng.integers(4), rng.uniform(6, 58)
        x, y = [(s, 0.0), (64.0, s), (s, 64.0), (0.0, s)][kenar]
        yon = [np.pi / 2, np.pi, -np.pi / 2, 0.0][kenar] + rng.uniform(-0.7, 0.7)
        pts = rastgele_yuruyus(x, y, yon, 45, rng)
        icerde = sum(0 <= px < N and 0 <= py < N for px, py in pts)
        if icerde >= 12:
            break
    gen, koyu = rng.uniform(1.0, 2.2), rng.uniform(0.15, 0.32)
    img = cizgi_ciz(img, pts, gen, koyu)
    if rng.random() < 0.35:                                       # dal
        i = rng.integers(len(pts) // 4, max(len(pts) // 4 + 1, 3 * len(pts) // 4))
        yon = rng.uniform(0, 2 * np.pi)
        img = cizgi_ciz(img, rastgele_yuruyus(*pts[i], yon, rng.integers(6, 16), rng), 0.7 * gen, koyu)
    return img


def derz(img, rng):
    """Düz derz çizgisi: yatay, dikey ya da eğik; çatlaktan geniş (2,8–4,5 px), benzer koyulukta."""
    if rng.random() < 0.5:
        c = rng.uniform(8, 56)
        pts = [(0.0, c), (64.0, c)] if rng.random() < 0.5 else [(c, 0.0), (c, 64.0)]
    else:
        aci, c = rng.uniform(0, np.pi), rng.uniform(16, 48)
        pts = [(32 - 50 * np.cos(aci), c - 50 * np.sin(aci)), (32 + 50 * np.cos(aci), c + 50 * np.sin(aci))]
    return cizgi_ciz(img, pts, rng.uniform(2.8, 4.5), rng.uniform(0.10, 0.22))


def cizik(img, rng):
    """Kısa, ince, düz çizik."""
    x, y, aci, L = rng.uniform(10, 54), rng.uniform(10, 54), rng.uniform(0, np.pi), rng.uniform(6, 16)
    pts = [(x, y), (x + L * np.cos(aci), y + L * np.sin(aci))]
    return cizgi_ciz(img, pts, rng.uniform(1.0, 1.4), rng.uniform(0.08, 0.16))


def goruntu(etiket, rng):
    """Görüntüyü ve hangi dikkat dağıtıcıların eklendiğini döndürür."""
    var = {"derz": False, "leke": False, "çizik": False}
    img = doku(rng)
    if rng.random() < 0.4:
        img, var["leke"] = leke(img, rng), True
    p_derz = 0.3 if etiket == 1 else 0.6                         # derz çatlaksızlarda daha sık
    if rng.random() < p_derz:
        img, var["derz"] = derz(img, rng), True
    if rng.random() < 0.25:
        img, var["çizik"] = cizik(img, rng), True
    if etiket == 1:
        img = catlak(img, rng)
    elif rng.random() < 0.3:                                      # çatlaksızlara ikinci leke şansı
        img, var["leke"] = leke(img, rng), True
    return np.clip(img, 0, 1), var


n_toplam = 3000
y_tum = rng.permutation(np.repeat([0, 1], n_toplam // 2))
uretim = [goruntu(e, rng) for e in y_tum]
X_tum = np.stack([u[0] for u in uretim]).astype(np.float32)
dikkat = {k: np.array([u[1][k] for u in uretim]) for k in ("derz", "leke", "çizik")}
eg, dog, te = np.arange(2000), np.arange(2000, 2500), np.arange(2500, 3000)
koyu_oran = (X_tum < X_tum.mean(axis=(1, 2), keepdims=True) - 0.12).mean(axis=(1, 2))
print("=== 1. Sentetik veri ===")
print(f"{n_toplam} görüntü ({N}×{N}, gri ton), çatlaklı oranı %{100*y_tum.mean():.0f}; "
      f"eğitim/doğrulama/test = {len(eg)}/{len(dog)}/{len(te)}")
print("Dikkat dağıtıcı içeren görüntü oranı (çatlaklı / çatlaksız): " + ", ".join(
    f"{k} %{100*v[y_tum == 1].mean():.0f} / %{100*v[y_tum == 0].mean():.0f}" for k, v in dikkat.items()))
print(f"Koyu piksel oranı (ortalamadan 0.12 koyu): çatlaklı %{100*koyu_oran[y_tum == 1].mean():.1f} "
      f"± {100*koyu_oran[y_tum == 1].std():.1f}, çatlaksız %{100*koyu_oran[y_tum == 0].mean():.1f} "
      f"± {100*koyu_oran[y_tum == 0].std():.1f}")


# %% 2. Evrişim sıfırdan: NumPy ile çapraz korelasyon ve Sobel filtreleri
def evrisim2d(img, K, adim=1, dolgu=0, kip="constant"):
    """Y[i, j] = Σ_u Σ_v X[i·s + u, j·s + v] · K[u, v]  (derin öğrenmedeki 'evrişim').
    kip="constant": sıfır dolgu; kip="edge": kenar piksellerini tekrarla."""
    if dolgu:
        img = np.pad(img, dolgu, mode=kip)
    k = K.shape[0]
    H = (img.shape[0] - k) // adim + 1                          # = ⌊(n + 2p − k)/s⌋ + 1
    W = (img.shape[1] - k) // adim + 1
    Y = np.empty((H, W))
    for i in range(H):
        for j in range(W):
            Y[i, j] = np.sum(img[i * adim:i * adim + k, j * adim:j * adim + k] * K)
    return Y


SOBEL_X = np.array([[-1.0, 0.0, 1.0], [-2.0, 0.0, 2.0], [-1.0, 0.0, 1.0]])
SOBEL_Y = SOBEL_X.T
# Hem derz hem çatlak içeren örnek görüntü; katmanları ayrı çizdiğimiz için maskeleri biliyoruz.
rng_o = np.random.default_rng(3)
k0 = doku(rng_o)
k1 = derz(k0, rng_o)
k2 = catlak(k1, rng_o)
maske_derz, maske_catlak = (k0 - k1) > 0.05, (k1 - k2) > 0.05
ornek = np.clip(k2, 0, 1)
Gx = evrisim2d(ornek, SOBEL_X, dolgu=1, kip="edge")
Gy = evrisim2d(ornek, SOBEL_Y, dolgu=1, kip="edge")
Gbuyukluk = np.hypot(Gx, Gy)
Gx_s2 = evrisim2d(ornek, SOBEL_X, adim=2, dolgu=1)
Gx_sifir = evrisim2d(ornek, SOBEL_X, dolgu=1)
torch_sonuc = nn.functional.conv2d(torch.tensor(ornek)[None, None], torch.tensor(SOBEL_X)[None, None], padding=1)
fark = np.abs(torch_sonuc[0, 0].numpy() - Gx_sifir).max()
print("\n=== 2. Evrişim sıfırdan (NumPy) ===")
print(f"3×3 Sobel, dolgu 1: adım 1 → {Gx.shape[0]}×{Gx.shape[1]}, adım 2 → {Gx_s2.shape[0]}×{Gx_s2.shape[1]} "
      f"[⌊(64 + 2 − 3)/2⌋ + 1 = {(64 + 2 - 3) // 2 + 1}]")
print(f"NumPy döngüsü ile torch.nn.functional.conv2d arasındaki en büyük fark: {fark:.1e}")
tam_bagli = f"{64 * 64 * 16 * 64 * 64 + 16 * 64 * 64:,}".replace(",", ".")
print(f"Parametre: 3×3 evrişim, 1→16 kanal: {16 * 9 + 16}; "
      f"aynı 16×64×64 çıktıyı üreten tam bağlantılı katman: {tam_bagli}")
print(f"Örnek görüntüde ortalama |G|: çatlak piksellerinde {Gbuyukluk[maske_catlak].mean():.2f}, "
      f"derz piksellerinde {Gbuyukluk[maske_derz & ~maske_catlak].mean():.2f}, "
      f"diğer piksellerde {Gbuyukluk[~maske_catlak & ~maske_derz].mean():.2f}")
assert fark < 1e-12 and Gx_s2.shape == (32, 32)

# %% 3. Temel modeller: lojistik regresyon
def evrisim_toplu(X, K):
    """Aynı işlemin döngüsüz hâli: (n, 64, 64) yığın, sıfır dolgu 1, adım 1."""
    pencere = np.lib.stride_tricks.sliding_window_view(np.pad(X, ((0, 0), (1, 1), (1, 1))), (3, 3), axis=(1, 2))
    return np.einsum("nijuv,uv->nij", pencere, K)


assert np.allclose(evrisim_toplu(ornek[None], SOBEL_X)[0], Gx_sifir)


def el_ozellikleri(X):
    """Görüntü başına 6 sayı: ortalama, std, %5'lik değer, koyu piksel oranı, Sobel ortalaması ve %99'u."""
    g = np.hypot(evrisim_toplu(X, SOBEL_X), evrisim_toplu(X, SOBEL_Y)).reshape(len(X), -1)
    duz = X.reshape(len(X), -1)
    ort = duz.mean(axis=1, keepdims=True)
    return np.column_stack([duz.mean(1), duz.std(1), np.percentile(duz, 5, axis=1),
                            (duz < ort - 0.12).mean(1), g.mean(1), np.percentile(g, 99, axis=1)])


def kucult(X, b=4):
    return X.reshape(len(X), N // b, b, N // b, b).mean(axis=(2, 4)).reshape(len(X), -1)


print("\n=== 3. Temel modeller (lojistik regresyon) ===")
F_tum = el_ozellikleri(X_tum.astype(float))
temel = {}
for ad, F in [("El yapımı 6 özellik", F_tum), ("16×16 küçültülmüş pikseller", kucult(X_tum))]:
    lr = make_pipeline(StandardScaler(), LogisticRegression(max_iter=5000))
    lr.fit(F[eg], y_tum[eg])
    tahmin = lr.predict(F[te])
    temel[ad] = (np.mean(tahmin == y_tum[te]), precision_score(y_tum[te], tahmin),
                 recall_score(y_tum[te], tahmin))
    print(f"{ad:28s}: test doğruluğu %{100*temel[ad][0]:.1f}, kesinlik %{100*temel[ad][1]:.1f}, "
          f"duyarlılık %{100*temel[ad][2]:.1f}")


# %% 4. Evrişimli sinir ağı
class CatlakAgi(nn.Module):
    """3 × (Conv 3×3 – BatchNorm – ReLU – MaxPool 2×2) + küresel ortalama havuzlama + doğrusal çıkış."""
    def __init__(self, kanallar=(8, 16, 32)):
        super().__init__()
        katmanlar, c_g = [], 1
        for c in kanallar:
            katmanlar += [nn.Conv2d(c_g, c, 3, padding=1, bias=False), nn.BatchNorm2d(c),
                          nn.ReLU(), nn.MaxPool2d(2)]
            c_g = c
        self.govde = nn.Sequential(*katmanlar)
        self.cikis = nn.Linear(c_g, 1)

    def forward(self, x):                      # x: (N, 1, 64, 64)
        h = self.govde(x)                      # (N, 32, 8, 8)
        h = h.mean(dim=(2, 3))                 # küresel ortalama havuzlama → (N, 32)
        return self.cikis(h).squeeze(1)        # logit


def artir(xb, g):
    """Veri artırma: her örneğe rastgele 90°'lik dönme, ayna ve parlaklık/karşıtlık değişimi."""
    k = torch.randint(0, 4, (len(xb),), generator=g)
    out = torch.empty_like(xb)
    for r in range(4):
        m = k == r
        if m.any():
            out[m] = torch.rot90(xb[m], r, dims=(2, 3))
    ayna = torch.rand(len(xb), generator=g) < 0.5
    out[ayna] = torch.flip(out[ayna], dims=(3,))
    c = 0.8 + 0.4 * torch.rand(len(xb), 1, 1, 1, generator=g)
    b = 0.3 * (torch.rand(len(xb), 1, 1, 1, generator=g) - 0.5)
    return out * c + b


ort, std = X_tum[eg].mean(), X_tum[eg].std()                  # piksel normalleştirmesi (eğitimden)
T = lambda idx: torch.tensor((X_tum[idx] - ort) / std)[:, None]
Xe, Xd, Xt = T(eg), T(dog), T(te)
ye, yd = torch.tensor(y_tum[eg], dtype=torch.float32), torch.tensor(y_tum[dog], dtype=torch.float32)

torch.manual_seed(42)
model = CatlakAgi()
n_param = sum(p.numel() for p in model.parameters())
alici = 1
sicrama = 1
for _ in range(3):                                            # conv 3×3 (s=1) ve maxpool 2×2 (s=2)
    alici += 2 * sicrama
    alici += 1 * sicrama
    sicrama *= 2
print("\n=== 4. CNN ===")
parca = [sum(p.numel() for p in model.govde[4 * i:4 * i + 4].parameters()) for i in range(3)]
parca.append(sum(p.numel() for p in model.cikis.parameters()))
print(f"Mimari: 3 × (Conv3×3–BN–ReLU–MaxPool) + küresel ortalama havuzlama + Linear; "
      f"parametre: {' + '.join(map(str, parca))} = {n_param}; son katmanın alıcı alanı {alici}×{alici} piksel")
DONEM = 12
kayip_fn = nn.BCEWithLogitsLoss()
opt = torch.optim.Adam(model.parameters(), lr=3e-3)
planlayici = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=DONEM)   # öğrenme hızı kosinüsle azalır
yukleyici = DataLoader(TensorDataset(Xe, ye), batch_size=64, shuffle=True,
                       generator=torch.Generator().manual_seed(42))
g_artir = torch.Generator().manual_seed(42)
gecmis = {"egitim": [], "dogrulama": [], "dog_dogruluk": []}
en_iyi, en_iyi_durum = -1.0, None
for donem in range(DONEM):
    model.train()
    toplam = 0.0
    for xb, yb in yukleyici:
        opt.zero_grad()
        kayip = kayip_fn(model(artir(xb, g_artir)), yb)
        kayip.backward()
        opt.step()
        toplam += kayip.item() * len(xb)
    model.eval()
    with torch.no_grad():
        z = model(Xd)
        L_d = kayip_fn(z, yd).item()
        dogruluk = ((z > 0).float() == yd).float().mean().item()
    planlayici.step()
    gecmis["egitim"].append(toplam / len(Xe))
    gecmis["dogrulama"].append(L_d)
    gecmis["dog_dogruluk"].append(dogruluk)
    if dogruluk > en_iyi:
        en_iyi, en_iyi_durum, en_iyi_donem = dogruluk, copy.deepcopy(model.state_dict()), donem
    print(f"Dönem {donem + 1:2d}: eğitim kaybı {gecmis['egitim'][-1]:.3f}, doğrulama kaybı {L_d:.3f}, "
          f"doğrulama doğruluğu %{100*dogruluk:.1f}")
model.load_state_dict(en_iyi_durum)
model.eval()

# %% 5. Test sonuçları
with torch.no_grad():
    p_test = torch.sigmoid(model(Xt)).numpy()
y_test = y_tum[te]
tahmin = (p_test > 0.5).astype(int)
km = confusion_matrix(y_test, tahmin)
dog_cnn = np.mean(tahmin == y_test)
print(f"\n=== 5. Test sonuçları (en iyi doğrulama dönemi: {en_iyi_donem + 1}) ===")
print(f"CNN: doğruluk %{100*dog_cnn:.1f}, kesinlik %{100*precision_score(y_test, tahmin):.1f}, "
      f"duyarlılık %{100*recall_score(y_test, tahmin):.1f}")
print(f"Karışıklık matrisi [gerçek sağlam: TN {km[0, 0]}, FP {km[0, 1]}] "
      f"[gerçek çatlak: FN {km[1, 0]}, TP {km[1, 1]}]")
yanlis = np.flatnonzero(tahmin != y_test)
print(f"Yanlış sınıflanan {len(yanlis)} görüntü: {km[0, 1]} yanlış alarm, {km[1, 0]} kaçırılan çatlak")
assert dog_cnn > max(v[0] for v in temel.values())

# %% 6. Ağ neye bakıyor? Örtme (occlusion) duyarlılığı
# 2. bölümdeki derz + çatlak görüntüsü (eğitimde yok); maskeleri biliniyor
ornek_o = ornek.astype(np.float32)
x0 = torch.tensor((ornek_o - ort) / std)[None, None]
bulanik = torch.tensor((gaussian_filter(ornek_o, 3.0) - ort) / std)   # ince çizgileri silen yumuşak dolgu
boy, kayma = 8, 4
konum = list(range(0, N - boy + 1, kayma))
ortulu, yama_catlak, yama_derz = [], [], []
for i in konum:
    for j in konum:
        x = x0.clone()
        x[0, 0, i:i + boy, j:j + boy] = bulanik[i:i + boy, j:j + boy]   # yamayı bulanık hâliyle ört
        ortulu.append(x)
        yama_catlak.append(maske_catlak[i:i + boy, j:j + boy].any())
        yama_derz.append(maske_derz[i:i + boy, j:j + boy].any())
with torch.no_grad():
    z0 = model(x0).item()
    z_ort = model(torch.cat(ortulu)).numpy()
dusus = (z0 - z_ort).reshape(len(konum), len(konum))       # logit düşüşü: büyükse o yama önemli
yc, yd_ = np.array(yama_catlak), np.array(yama_derz) & ~np.array(yama_catlak)
print("\n=== 6. Örtme duyarlılığı (2. bölümdeki derz + çatlak görüntüsü) ===")
print(f"p = {1 / (1 + np.exp(-z0)):.3f} (logit {z0:.2f}); 8×8 yama bulanıklaştırılınca ortalama logit düşüşü: "
      f"çatlağa değen {yc.sum()} yamada {(z0 - z_ort)[yc].mean():.2f}, yalnız derze değen {yd_.sum()} yamada "
      f"{(z0 - z_ort)[yd_].mean():.2f}, diğer {(~yc & ~yd_).sum()} yamada {(z0 - z_ort)[~yc & ~yd_].mean():.2f}")
W1 = model.govde[0].weight.detach().numpy()[:, 0]              # (8, 3, 3) birinci katman filtreleri
print("1. katman filtrelerinde Σw/Σ|w| (0'a yakınsa fark, ±1'e yakınsa ortalama parlaklık algılayıcı): "
      + ", ".join(f"{w.sum() / np.abs(w).sum():+.2f}" for w in W1))

# Kontrollü sınama: aynı dokuya derz ekleyip çıkarmak (örtme haritasının söyleyemediğini sınar)
rng_k = np.random.default_rng(5)
ciftler = []
for _ in range(600):
    t0 = doku(rng_k)
    cl = catlak(np.zeros((N, N)), rng_k)                        # yalnız çatlak katmanı (koyulaştırma)
    dl = derz(np.zeros((N, N)), rng_k)                          # yalnız derz katmanı
    ciftler += [t0 + cl, t0 + cl + dl, t0, t0 + dl]
Xk = np.clip(np.stack(ciftler), 0, 1).astype(np.float32)
with torch.no_grad():
    zk = model(torch.tensor((Xk - ort) / std)[:, None]).numpy().reshape(-1, 4)
print(f"Kontrollü sınama, 600 doku: çatlaklıda 'çatlak' kararı derzsiz %{100*np.mean(zk[:, 0] > 0):.1f}, "
      f"derzli %{100*np.mean(zk[:, 1] > 0):.1f} "
      f"(derz eklemenin logit etkisi medyanı {np.median(zk[:, 1] - zk[:, 0]):+.2f}); "
      f"çatlaksızda yanlış alarm derzsiz %{100*np.mean(zk[:, 2] > 0):.1f}, derzli %{100*np.mean(zk[:, 3] > 0):.1f}")

# %% 7. Grafikler
fig, ax = plt.subplots(1, 4, figsize=(10, 3.1), layout="constrained")
s = np.abs(Gx).max()
paneller = [(ornek, "Görüntü", "gray", (0, 1)), (Gx, "Gx (yatay türev)", "RdBu_r", (-s, s)),
            (Gy, "Gy (düşey türev)", "RdBu_r", (-s, s)),
            (Gbuyukluk, "|G| (kenar şiddeti)", "Blues", (0, Gbuyukluk.max()))]
for a, (img, baslik, cmap, sinir) in zip(ax, paneller):
    a.imshow(img, cmap=cmap, vmin=sinir[0], vmax=sinir[1], interpolation="nearest")
    a.set_title(baslik, fontsize=10)
    a.set_xticks([]), a.set_yticks([])
    a.grid(False)
fig.savefig(KLASOR / "d13_cnn_catlak_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
d = np.arange(1, DONEM + 1)
ax[0].plot(d, gecmis["egitim"], color=RENK[0], label="Eğitim kaybı (artırılmış veri)")
ax[0].plot(d, gecmis["dogrulama"], color=RENK[1], label="Doğrulama kaybı")
ax[0].set(xlabel="Dönem", ylabel="İkili çapraz entropi", title="Eğitim eğrileri", xticks=d)
ax[0].legend(loc="upper right")
ax[1].imshow(km, cmap="Blues")
for (i, j), v in np.ndenumerate(km):
    ax[1].text(j, i, str(v), ha="center", va="center", fontsize=14,
               color="white" if v > km.max() / 2 else MUREKKEP)
ax[1].set(xticks=[0, 1], yticks=[0, 1], xticklabels=["sağlam", "çatlak"], yticklabels=["sağlam", "çatlak"],
          xlabel="Tahmin", ylabel="Gerçek", title=f"Test karışıklık matrisi (doğruluk %{100*dog_cnn:.1f})")
ax[1].grid(False)
fig.savefig(KLASOR / "d13_cnn_catlak_2.png", dpi=160)
plt.close(fig)

secim = list(yanlis[:8])
dogrular = np.flatnonzero(tahmin == y_test)
secim += list(np.random.default_rng(0).choice(dogrular, 24 - len(secim), replace=False))
secim = sorted(secim)
fig, axs = plt.subplots(3, 8, figsize=(10, 4.6), layout="constrained")
for a, i in zip(axs.ravel(), secim):
    a.imshow(X_tum[te][i], cmap="gray", vmin=0, vmax=1, interpolation="nearest")
    hata = tahmin[i] != y_test[i]
    a.set_title(f"{'çatlak' if y_test[i] else 'sağlam'} · p={p_test[i]:.2f}", fontsize=7.5,
                color=RENK[1] if hata else MUREKKEP, fontweight="bold" if hata else "normal")
    if hata:
        for kenar in a.spines.values():
            kenar.set_visible(True); kenar.set_color(RENK[1]); kenar.set_linewidth(2.5)
    a.set_xticks([]), a.set_yticks([])
    a.grid(False)
fig.savefig(KLASOR / "d13_cnn_catlak_3.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 3, figsize=(10, 3.6), layout="constrained")
mozaik = np.full((2 * 4 - 1, 4 * 4 - 1), np.nan)
for k in range(len(W1)):
    r, c = divmod(k, 4)
    mozaik[r * 4:r * 4 + 3, c * 4:c * 4 + 3] = W1[k] / np.abs(W1[k]).max()
ax[0].imshow(mozaik, cmap="RdBu_r", vmin=-1, vmax=1, interpolation="nearest")
ax[0].set_title("1. katmanın 8 filtresi (3×3)", fontsize=10)
ax[1].imshow(ornek_o, cmap="gray", vmin=0, vmax=1, interpolation="nearest")
ax[1].set_title(f"Derz + çatlak (p = {1 / (1 + np.exp(-z0)):.2f})", fontsize=10)
s = np.abs(dusus).max()
merkez = np.array(konum) + boy / 2
alt_s, ust_s = merkez[0] - kayma / 2, merkez[-1] + kayma / 2      # haritanın piksel sınırları
im = ax[2].imshow(dusus, cmap="RdBu_r", vmin=-s, vmax=s, interpolation="nearest",
                  extent=(alt_s, ust_s, ust_s, alt_s))
ax[2].contour(maske_catlak.astype(float), levels=[0.5], colors=MUREKKEP, linewidths=0.8)
ax[2].set(xlim=(alt_s, ust_s), ylim=(ust_s, alt_s))
ax[2].set_title("Örtülünce logit düşüşü", fontsize=10)
fig.colorbar(im, ax=ax[2], shrink=0.8)
for a in ax:
    a.set_xticks([]), a.set_yticks([])
    a.grid(False)
fig.savefig(KLASOR / "d13_cnn_catlak_4.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d13_cnn_catlak_1.png, _2.png, _3.png, _4.png")=== 1. Sentetik veri ===
3000 görüntü (64×64, gri ton), çatlaklı oranı %50; eğitim/doğrulama/test = 2000/500/500
Dikkat dağıtıcı içeren görüntü oranı (çatlaklı / çatlaksız): derz %30 / %59, leke %41 / %58, çizik %23 / %25
Koyu piksel oranı (ortalamadan 0.12 koyu): çatlaklı %6.2 ± 2.3, çatlaksız %5.7 ± 2.5
=== 2. Evrişim sıfırdan (NumPy) ===
3×3 Sobel, dolgu 1: adım 1 → 64×64, adım 2 → 32×32 [⌊(64 + 2 − 3)/2⌋ + 1 = 32]
NumPy döngüsü ile torch.nn.functional.conv2d arasındaki en büyük fark: 4.4e-16
Parametre: 3×3 evrişim, 1→16 kanal: 160; aynı 16×64×64 çıktıyı üreten tam bağlantılı katman: 268.500.992
Örnek görüntüde ortalama |G|: çatlak piksellerinde 0.56, derz piksellerinde 0.47, diğer piksellerde 0.22
=== 3. Temel modeller (lojistik regresyon) ===
El yapımı 6 özellik : test doğruluğu %74.2, kesinlik %76.3, duyarlılık %72.5
16×16 küçültülmüş pikseller : test doğruluğu %47.8, kesinlik %49.4, duyarlılık %46.5
=== 4. CNN ===
Mimari: 3 × (Conv3×3–BN–ReLU–MaxPool) + küresel ortalama havuzlama + Linear; parametre: 88 + 1184 + 4672 + 33 = 5977; son katmanın alıcı alanı 22×22 piksel
Dönem 1: eğitim kaybı 0.579, doğrulama kaybı 0.582, doğrulama doğruluğu %69.8
Dönem 2: eğitim kaybı 0.428, doğrulama kaybı 0.425, doğrulama doğruluğu %84.2
Dönem 3: eğitim kaybı 0.330, doğrulama kaybı 0.289, doğrulama doğruluğu %91.8
Dönem 4: eğitim kaybı 0.246, doğrulama kaybı 0.324, doğrulama doğruluğu %86.4
Dönem 5: eğitim kaybı 0.206, doğrulama kaybı 0.183, doğrulama doğruluğu %92.6
Dönem 6: eğitim kaybı 0.184, doğrulama kaybı 0.169, doğrulama doğruluğu %93.6
Dönem 7: eğitim kaybı 0.150, doğrulama kaybı 0.134, doğrulama doğruluğu %95.8
Dönem 8: eğitim kaybı 0.135, doğrulama kaybı 0.148, doğrulama doğruluğu %98.0
Dönem 9: eğitim kaybı 0.131, doğrulama kaybı 0.122, doğrulama doğruluğu %96.0
Dönem 10: eğitim kaybı 0.125, doğrulama kaybı 0.122, doğrulama doğruluğu %96.2
Dönem 11: eğitim kaybı 0.124, doğrulama kaybı 0.127, doğrulama doğruluğu %94.4
Dönem 12: eğitim kaybı 0.120, doğrulama kaybı 0.115, doğrulama doğruluğu %97.8
=== 5. Test sonuçları (en iyi doğrulama dönemi: 8) ===
CNN: doğruluk %98.0, kesinlik %98.8, duyarlılık %97.3
Karışıklık matrisi [gerçek sağlam: TN 239, FP 3] [gerçek çatlak: FN 7, TP 251]
Yanlış sınıflanan 10 görüntü: 3 yanlış alarm, 7 kaçırılan çatlak
=== 6. Örtme duyarlılığı (2. bölümdeki derz + çatlak görüntüsü) ===
p = 1.000 (logit 8.52); 8×8 yama bulanıklaştırılınca ortalama logit düşüşü: çatlağa değen 61 yamada 0.21, yalnız derze değen 45 yamada -0.36, diğer 119 yamada -0.13
1. katman filtrelerinde Σw/Σ|w| (0'a yakınsa fark, ±1'e yakınsa ortalama parlaklık algılayıcı): +0.84, +0.72, -0.02, +0.02, +0.38, -0.03, +0.01, +0.01
Kontrollü sınama, 600 doku: çatlaklıda 'çatlak' kararı derzsiz %95.5, derzli %94.8 (derz eklemenin logit etkisi medyanı -0.07); çatlaksızda yanlış alarm derzsiz %0.0, derzli %4.3
Grafikler kaydedildi: d13_cnn_catlak_1.png, _2.png, _3.png, _4.pngPyTorch eğitimlerinde son basamaklar işlemciye, iş parçacığı sayısına ve kitaplık sürümüne göre biraz farklı çıkabilir; eğilimler ve sonuçlar aynı kalır.
8. Sonuçları yorumlayın
| Model | Parametre | Doğruluk | Kesinlik | Duyarlılık |
|---|---|---|---|---|
| Lojistik regresyon, 16×16 piksel | 257 | %47,8 | %49,4 | %46,5 |
| Lojistik regresyon, 6 el yapımı özellik | 7 | %74,2 | %76,3 | %72,5 |
| CNN (3 blok + küresel ortalama havuzlama) | 5977 | %98,0 | %98,8 | %97,3 |
Piksellerle kurulan lojistik regresyon yazı turadan iyi değil (yüzde 47,8). Bu beklenen bir sonuç: çatlak her görüntüde başka bir yerde olduğu için hiçbir pikselin ağırlığı tek başına anlamlı değil. El yapımı özellikler yüzde 74,2'ye çıkıyor; kenar şiddeti istatistikleri çatlağın varlığı hakkında bir şey söylüyor, ama derzleri ve çizikleri çatlaktan ayıramıyor. CNN ise yüzde 98,0 doğruluğa ulaşıyor.
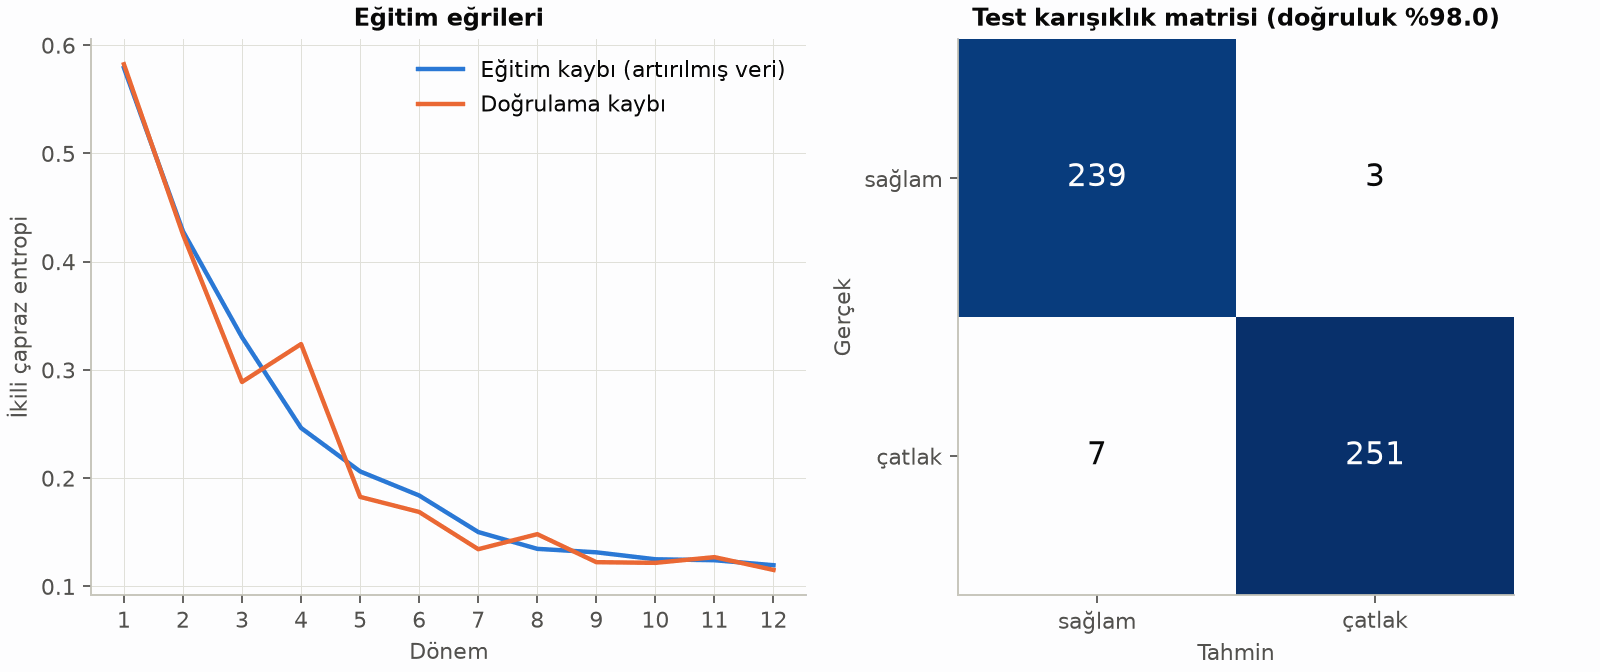
Eğitim ve doğrulama kayıpları birlikte iniyor; aşırı uyum belirtisi yok. Doğrulama doğruluğu 8. dönemde yüzde 98,0 ile en yüksek değerine ulaştı ve test sonuçları o dönemin ağırlıklarıyla hesaplandı. Ara dönemlerdeki dalgalanmalar (ör. 4. dönemde yüzde 86,4) küçük yığınlarla eğitilen, toplu normalleştirmeli ağlarda olağandır; kosinüs azaltma son dönemleri sakinleştiriyor. Test kümesindeki 500 görüntünün 10'unda hata var: 3 yanlış alarm ve 7 kaçırılan çatlak.
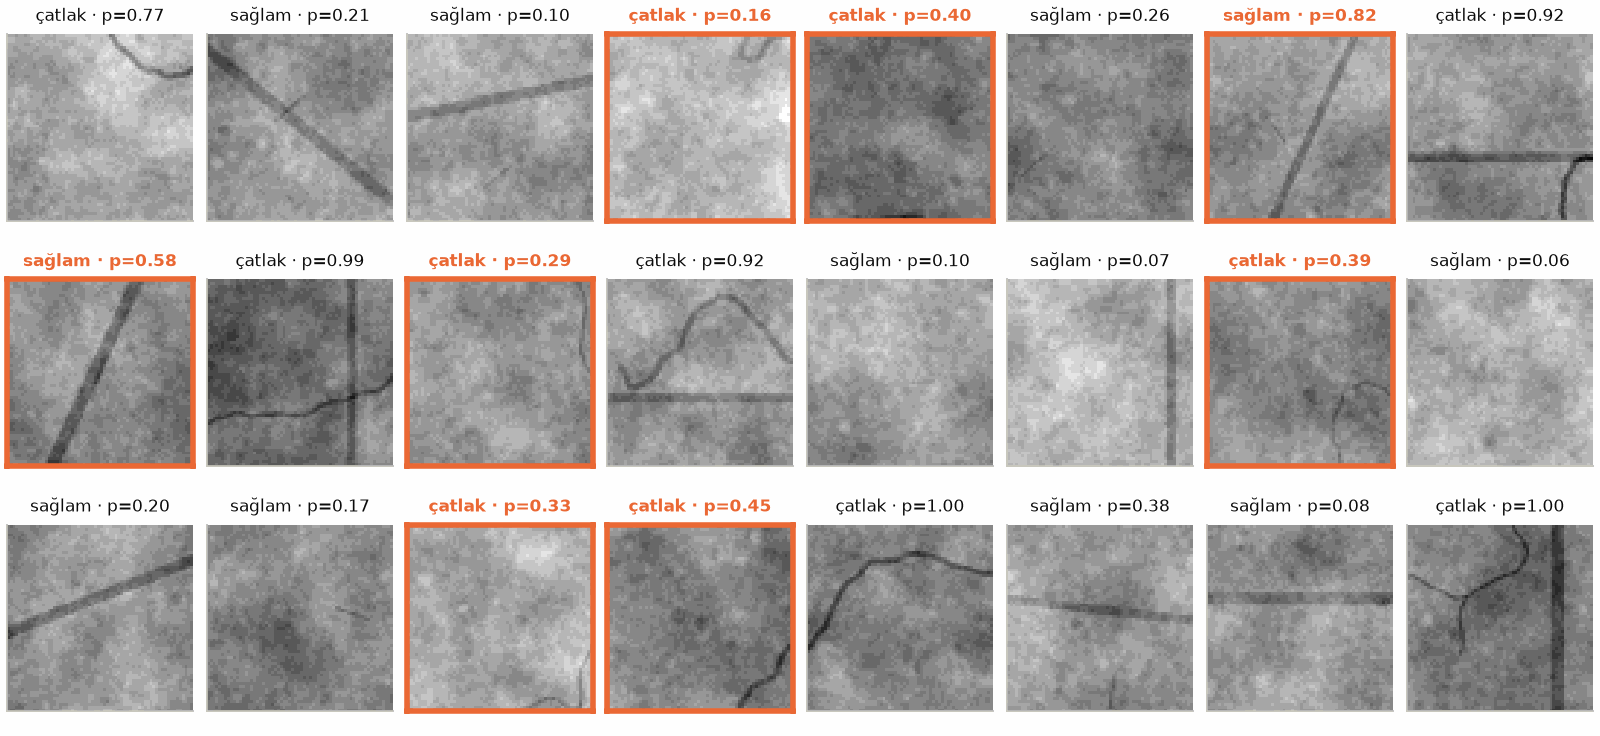
Hatalara tek tek bakmak, toplu ölçütlerin söylemediğini söyler. Kaçırılan çatlakların çoğu görüntüye kenardan yalnızca kısa bir parçasıyla giriyor ya da çok soluk. Bunlar bir insanın da kolayca gözden kaçırabileceği örnekler; komşu görüntü parçalarıyla birlikte değerlendirildiğinde (gerçek bir muayene sisteminde olduğu gibi) yakalanma şansları artar. Şekildeki iki yanlış alarm ise eğik birer derz içeriyor: ağ, düz ve geniş bir çizgiyi bazen çatlak sanıyor.
Ağ neye bakıyor?
Bir modelin doğru cevabı doğru nedenle verdiğinden emin olmak için ne gördüğüne bakmak gerekir. Bunun en basit yollarından biri örtme duyarlılığıdır (occlusion sensitivity; Zeiler ve Fergus, 2014): görüntünün küçük bir bölgesini örtüp modelin çıktısının ne kadar değiştiğine bakılır. Biz 8×8'lik yamaları 4 piksel aralıklarla kaydırdık ve her yamayı görüntünün bulanıklaştırılmış hâliyle değiştirdik; böylece ince çizgiler silinir ama yapay keskin kenarlar oluşmaz. Ölçü olarak, olasılık 1'e çok yakın olduğunda duyarsızlaşan $p$ yerine logitteki düşüşü kullandık.
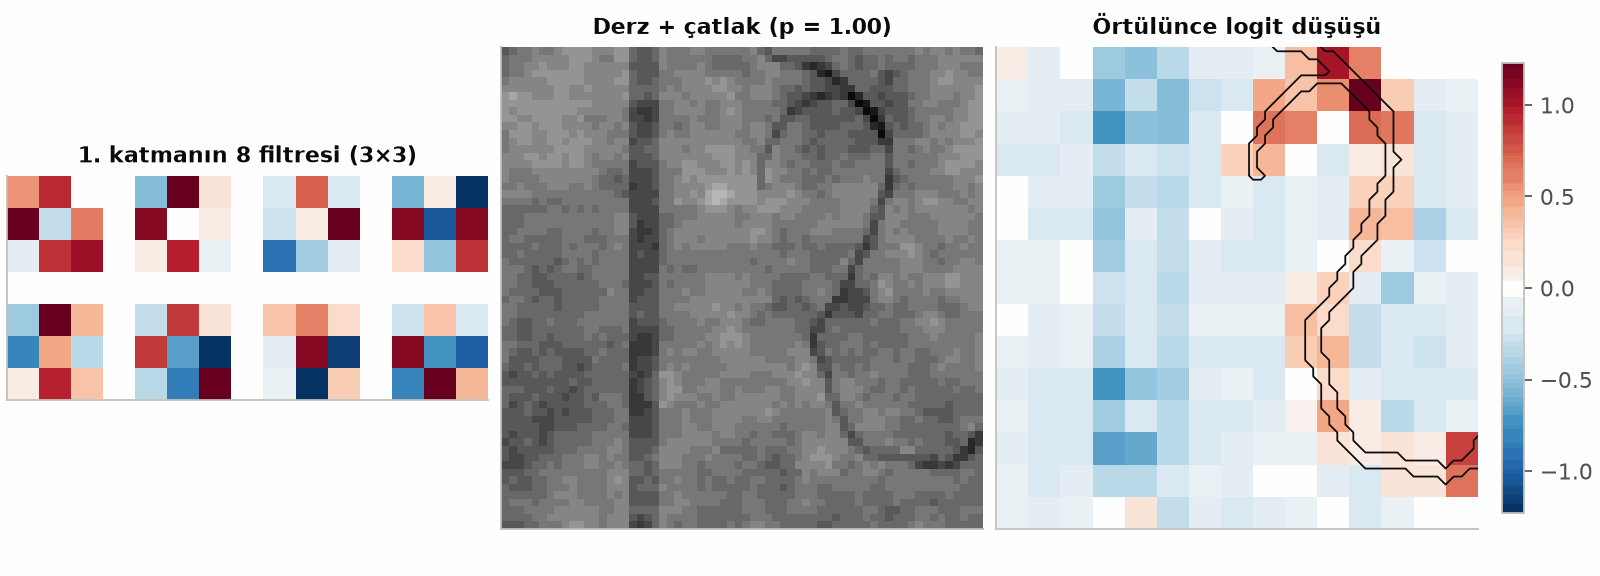
Model bu görüntüyü $p = 1{,}000$ ile (logit 8,52) çatlaklı buldu. Çatlağa değen 61 yamada logit ortalama 0,21 düşüyor: kararı taşıyan çatlak. Tek yamalık etkilerin küçük olması da anlamlıdır; çatlak uzun olduğu için bir parçası örtülse bile geri kalanı kararı taşıyor. Yalnız derze değen 45 yamada ise logit ortalama 0,36 artıyor. Bunu “derz çatlağa karşı kanıttır” diye okumak yanlış olur. Bulanık yama tarafsız bir örtü değildir: çatlağa ve derze değmeyen 119 yamada bile logiti ortalama 0,13 artırıyor. Ayrıca derzin bir parçasını silmek, düz çizgiyi uçları görüntünün içinde kalan parçalara böler. Örtme haritası modelin neye duyarlı olduğunu gösterir, nedenini tek başına kanıtlamaz.
Nedeni sınamak için aynı görüntüyü derzli ve derzsiz verdik: 600 rastgele dokunun her birine bir çatlak ve bir derz katmanı ürettik ve dört biçimini (yalnız doku, doku + derz, doku + çatlak, doku + çatlak + derz) modele verdik. Çatlaklı görüntülerde “çatlak” kararı derzsiz yüzde 95,5, derzli yüzde 94,8; derz eklemenin logite etkisinin medyanı −0,07. Yani derz, çatlak bulmayı neredeyse hiç etkilemiyor. Çatlaksız dokularda ise yanlış alarm oranı derzsiz yüzde 0,0'dan derzli yüzde 4,3'e çıkıyor: düz derz bazen çatlak sanılıyor. Model derzi “sağlam” işareti olarak kullanmıyor; ama derzli yüzeylerde yanlış alarm riski var.
Birinci katmanın filtrelerinde ağırlık toplamının mutlak toplamına oranı ($\Sigma w/\Sigma|w|$) beşinde sıfıra yakın (−0,03 ile +0,02 arası): bunlar Sobel gibi parlaklık farklarına, yani kenar ve çizgilere duyarlı. İkisi ise çoğunlukla pozitif (+0,84 ve +0,72), yani yerel ortalama parlaklığı taşıyor; biri arada (+0,38). 3×3'lük filtreleri tek başına yorumlamak zordur; asıl desen tanıma sonraki katmanlarda, bu filtrelerin birleşimiyle olur.
9. Gerçek veriye geçerken
Bu dersteki yüzde 98'lik sonuç, sentetik bir dünyada ve dikkatle seçilmiş bir zorluk düzeyinde elde edildi. Gerçek bir uygulamada şu konular belirleyicidir:
- Gerçek veri kümeleri. Beton çatlakları için yayımlanmış, on binlerce etiketli görüntü parçası içeren açık veri kümeleri vardır; örneğin köprü tabliyesi, duvar ve kaplama görüntülerinden oluşan SDNET2018 (Dorafshan vd., 2018) ve ODTÜ kampüs binalarından toplanan bir veri kümesi (Özgenel ve Gönenç Sorguç, 2018). Yeni bir modeli önce bunlar gibi kümelerde sınamak, sentetik sonuçlardan çok daha anlamlıdır.
- Alan kayması (domain shift). Model, eğitim görüntülerinin ışığına, kamerasına, çözünürlüğüne ve yüzey türüne alışır. Başka bir yapıdan, başka bir mevsimde ya da başka bir kamerayla çekilmiş görüntülerde başarısı belirgin biçimde düşebilir. Alıştırma 6'da bunu kendi modelimizde ölçeceksiniz. Değerlendirmeyi, eğitimde hiç kullanılmamış yapılardan gelen görüntülerle yapın; aynı fotoğraftan kesilmiş parçaları hem eğitime hem teste koymak bir tür veri sızıntısıdır (Ders 03'teki gruplu bölme).
- Etiketleme maliyeti ve belirsizliği. Kıl çatlağını yüzey çiziğinden ya da kalıp izinden ayırmak, rötre çatlağının önemini değerlendirmek uzmanlar arasında bile tartışmalı olabilir. Etiketleme yönergesi yazmak ve birden çok kişinin etiketlerini karşılaştırmak gerekir.
- Sınıf dengesizliği. Gerçek muayenede görüntülerin büyük çoğunluğu sağlamdır. Doğruluk yanıltıcı olur; kesinlik, duyarlılık ve maliyete göre eşik seçimi (Ders 05) öne çıkar. Bir çatlağı kaçırmanın bedeli, yanlış alarmın bedelinden genellikle çok daha büyüktür.
- Sınıflandırmanın ötesi. Yapısal değerlendirme için çatlağın varlığı yetmez; konumu, genişliği ve uzunluğu gerekir. Bu, piksel düzeyinde bölütleme (segmentation) ağlarıyla ve kalibre edilmiş ölçümle yapılır. Model bir ön eleme aracıdır; çatlağın yapısal önemine mühendis karar verir.
10. Sık yapılan hatalar
- Kanal boyutunu unutmak. PyTorch evrişimleri
(N, C, H, W)bekler; gri görüntüde deC = 1boyutu eklenmelidir (x[:, None]). - Etiketi bozan veri artırma. Çatlağı kadrajdan çıkaran kırpma ya da ince çatlağı silen bulanıklaştırma, modele yanlış etiket öğretir.
- Değerlendirmede
model.eval()'u unutmak. Toplu normalleştirme bu durumda test yığınının kendi istatistiklerini kullanır; sonuçlar yığın boyuna göre değişir. - Normalleştirme istatistiklerini bütün veriden hesaplamak. Ortalama ve standart sapma yalnızca eğitim kümesinden alınmalıdır.
- Aynı fotoğrafın parçalarını eğitim ve teste dağıtmak. Test başarısı, modelin göremediği yapılardaki başarısını olduğundan iyi gösterir.
- Yalnızca doğruluğa bakmak. Karışıklık matrisine ve hatalı örneklerin kendisine bakın; kestirme öğrenme çoğu zaman ancak böyle fark edilir.
11. Alıştırmalar
Alıştırma 1KolayÇıktı boyutu ve parametre sayısı
64×64×1'lik bir girdiye 5×5 çekirdekli, 8 çıkış kanallı, adımı 2 ve dolgusu 2 olan bir evrişim uygulanıyor. Çıktının boyutu ve katmanın parametre sayısı nedir? Ardından 8 kanallı bu çıktıya 16 kanallı bir 3×3 evrişim eklenirse kaç parametre gelir?
Çözümü göster
Çıktı kenarı $\lfloor(64 + 2\cdot2 - 5)/2\rfloor + 1$ $= \lfloor 63/2\rfloor + 1 = 32$; çıktı 8×32×32. Parametre: $8\cdot1\cdot5^2 + 8 = 208$. İkinci katman: $16\cdot8\cdot3^2 + 16 = 1168$ parametre. Görüntü boyutunun hiçbir formülde yer almadığına dikkat edin.
Alıştırma 2KolayAlıcı alanı büyütmek
Modelimize dördüncü bir blok (3×3 evrişim + 2×2 havuzlama) eklenirse son katmanın alıcı alanı ve harita boyutu ne olur? Aynı alıcı alanı tek bir büyük çekirdekle elde etmeye çalışmak neden kötü bir fikirdir?
Çözümü göster
Üç bloğun sonunda $r = 22$, $j = 8$. Dördüncü blokta evrişim $r = 22 + 2\cdot8 = 38$, havuzlama $r = 38 + 1\cdot8 = 46$ verir; harita 4×4'e iner. 46×46'lık bir alıcı alanı tek katmanda elde etmek için 46×46'lık bir çekirdek gerekirdi: tek kanalda bile 2116 ağırlık ve tek bir doğrusal işlem. Küçük çekirdekleri art arda dizmek (VGG'nin fikri) aynı alanı çok daha az parametreyle ve katmanlar arasındaki doğrusal olmayan aktivasyonlarla elde eder.
Alıştırma 3OrtaVeri artırmanın katkısı
artir fonksiyonunu eğitim döngüsünden çıkarın (model(xb)) ve modeli aynı ayarlarla yeniden eğitin. Test doğruluğu, kesinlik ve duyarlılık nasıl değişir?
Çözümü göster
Artırma olmadan en iyi doğrulama dönemi 12 oldu. Test kümesinde doğruluk %97,8 (artırmayla %98,0), kesinlik %99,6 (%98,8), duyarlılık %96,1 (%97,3). Fark küçük; bunun iki nedeni var. Birincisi, 2000 görüntü bu sentetik problem için az değil. İkincisi, görüntülerimiz zaten her yönde ve benzer ışık koşullarında üretildi; dönme ve parlaklık artırması, eğitim kümesinde olmayan bir çeşitliliği getirmiyor. Artırmanın asıl katkısı, test koşulları eğitimden farklı olduğunda ortaya çıkar (Alıştırma 6). Aynı dağılımdan gelen bir test kümesi bu katkıyı ölçemez.
Alıştırma 4OrtaKüresel ortalama havuzlama yerine düzleştirme
Küresel ortalama havuzlamayı kaldırın; son 32×8×8'lik haritayı düzleştirip (flatten) 2048 girdili bir doğrusal katmana verin. Parametre sayısı ve test doğruluğu nasıl değişir? Sonucu öteleme değişmezliği açısından yorumlayın.
Çözümü göster
Yeni çıkış katmanının 2048 + 1 = 2049 parametresi var (eskisinin 33); toplam 7993. Test doğruluğu %99,0 (kesinlik %99,6, duyarlılık %98,4), yani bu test kümesinde küresel ortalama havuzlamalı modelden (%98,0) biraz daha iyi.
Nedeni verimizin bir özelliği: her çatlak görüntünün kenarından başlıyor. Düzleştirilmiş model kenara yakın konumlar için ayrı ağırlıklar öğrenebildiği için bu konum bilgisini kullanıyor; küresel ortalama havuzlama ise konumu bilerek atıyor. Konum bilgisinin bir kestirme olup olmadığını görmek için çatlakların görüntünün kenarına hiç değmediği yeni kümeler ürettik: çatlak $[16;\ 48]$ piksel karesinde rastgele bir noktadan başlıyor, yürüyüş kenara 4 pikselden fazla yaklaşınca duruyor (dallar için de aynı kural); dikkat dağıtıcılar asıl veridekiyle aynı. Farklı tohumlarla üretilen üç 500'lük kümede küresel ortalama havuzlamalı model %95,6–97,6 doğruluk ve %93,6–97,2 duyarlılık, düzleştirilmiş model ise %93,8–95,0 doğruluk ve %89,2–92,4 duyarlılık verdi. (İçeriden başlayıp kenardan çıkan çatlaklarda iki model arasında belirgin fark yok; fark, kenar ipucu tamamen ortadan kalkınca ortaya çıkıyor.) Öteleme değişmezliği, aynı dağılımda küçük bir bedel ödetip dağılım değiştiğinde dayanıklılık kazandırıyor. Bir pratik üstünlüğü daha var: küresel ortalama havuzlamalı ağ her boyuttaki görüntüye doğrudan uygulanabilir, düzleştirilmiş ağ yalnızca 64×64 kabul eder.
Alıştırma 5OrtaKaçırılan çatlak daha pahalıysa
Bir muayene sisteminde çatlak kaçırmak, yanlış alarmdan çok daha pahalıdır. Eşiği doğrulama kümesinde duyarlılık en az yüzde 99 olacak biçimde seçin ve test kümesindeki kesinliği, duyarlılığı ve hata sayılarını bulun.
Çözümü göster
Doğrulama kümesindeki çatlaklı görüntülerin olasılıkları sıralanıp en düşük yüzde 1'lik dilimin sınırı eşik alınınca eşik 0,372 çıkar; doğrulamada duyarlılık %99,2 olur.
pozitif = np.sort(p_dog[y_dog == 1])
esik = pozitif[int(0.01 * len(pozitif))]        # pozitiflerin %99'u bu değerin üstünde
tahmin = (p_test >= esik).astype(int)
Test kümesinde bu eşikle kesinlik %96,6, duyarlılık %98,4; 9 yanlış alarm ve 4 kaçırılan çatlak var. 0,5 eşiğinde bu sayılar 3 ve 7'ydi: kaçırılan çatlak sayısı 7'den 4'e indi, bedeli 6 ek yanlış alarm. Eşik, eğitimden sonra maliyete göre seçilen bir karardır (Ders 05); test kümesinde değil, doğrulama kümesinde belirlenmelidir.
Alıştırma 6ZorAlan kayması: bulanık bir kamera
Eğitilmiş modeli, test görüntülerinin standart sapması 1 piksel olan Gauss çekirdeğiyle bulanıklaştırılmış hâlinde deneyin (odağı kaçmış bir kamerayı taklit eder). Doğruluk ve duyarlılık ne olur? Sonra eğitimde yığınların yarısına aynı bulanıklığı uygulayan bir artırma ekleyip modeli yeniden eğitin ve iki test kümesinde de ölçün.
Çözümü göster
Bulanık test kümesinde (σ = 1 piksel) eğitilmiş modelin doğruluğu %98,0'dan %51,6'ya düşüyor; duyarlılık %98,8, kesinlik %51,6. Kesinliğin test kümesindeki çatlaklı oranına (%51,6) eşit olması, modelin neredeyse bütün görüntüleri çatlaklı saydığını gösteriyor. Bulanıklık dokudaki ince gürültüyü siliyor ve model eğitimde hiç görmediği bu görüntü istatistikleri karşısında şaşırıyor. Her görüntünün karşıtlığını kendi ortalaması çevresinde yarıya indirmek de doğruluğu %79,0'a düşürüyor (kesinlik %71,3).
k1 = np.exp(-0.5 * np.arange(-2, 3) ** 2)                       # σ = 1 piksel
k = torch.tensor(np.outer(k1, k1) / np.outer(k1, k1).sum(), dtype=torch.float32)

def artir2(xb, g):
    x = artir(xb, g)
    sec = torch.rand(len(x), generator=g) < 0.5                  # yığının yarısı
    xbul = nn.functional.conv2d(nn.functional.pad(x, (2, 2, 2, 2), mode="replicate"), k[None, None])
    return torch.where(sec[:, None, None, None], xbul, x)
Bulanıklık artırmasıyla yeniden eğitilen model asıl test kümesinde %96,0 doğruluk (kesinlik %98,8, duyarlılık %93,4), bulanık test kümesinde %87,0 doğruluk (kesinlik %94,9, duyarlılık %79,1) verdi. Bulanık görüntülerdeki doğruluk 35 puan arttı; bedeli asıl kümede 2 puanlık düşüş. Bilinen bir değişim (ör. farklı bir kamera) artırmayla kısmen karşılanabilir. Bilinmeyen değişimlere karşı tek güvence, modeli yeni alandan gelen ve etiketlenmiş bir örneklemle sınamaktır.
Özet
- Evrişim, küçük bir çekirdeği görüntü üzerinde kaydırarak yerel desenleri bulur. Ağırlık paylaşımı parametre sayısını görüntü boyutundan bağımsız kılar ve öteleme eşdeğerliği sağlar.
- Çıktı boyutu $\lfloor(n+2p-k)/s\rfloor + 1$'dir; alıcı alan katman katman büyür. Havuzlama ve küresel ortalama havuzlama konuma karşı değişmezlik ekler.
- 5977 parametreli küçük bir CNN, sentetik çatlak görüntülerinde yüzde 98,0 test doğruluğuna ulaştı; piksellerle lojistik regresyon yüzde 47,8'de, el yapımı özelliklerle yüzde 74,2'de kaldı.
- Örtme duyarlılığı modelin çatlağa duyarlı olduğunu gösterdi; derzli ve derzsiz kontrollü sınama ise derzin çatlak bulmayı neredeyse etkilemediğini ama çatlaksız yüzeylerde yanlış alarmı artırdığını gösterdi. Duyarlılık haritaları neden sorusunu tek başına yanıtlamaz; hatalı örneklere bakmak ve kontrollü sınamalar kestirme öğrenmeyi fark etmenin yollarıdır.
- Gerçek uygulamada alan kayması, etiketleme ve sınıf dengesizliği belirleyicidir; sentetik veri yalnızca yöntemi öğretir.
Sonraki derste uzamsal yapıdan zamansal yapıya geçiyoruz: deprem ivme kayıtlarından yapı tepkisini tahmin eden dizi modellerini (RNN, LSTM ve dikkat) Ders 14'te göreceğiz.
Kaynaklar
- I. Goodfellow, Y. Bengio, A. Courville — Deep Learning, MIT Press, 2016, Bölüm 9 (evrişimli ağlar).
- Y. LeCun, L. Bottou, Y. Bengio, P. Haffner — “Gradient-based learning applied to document recognition”, Proceedings of the IEEE, 1998; K. Simonyan, A. Zisserman — “Very deep convolutional networks for large-scale image recognition”, ICLR 2015, arXiv:1409.1556.
- K. He, X. Zhang, S. Ren, J. Sun — “Deep residual learning for image recognition”, CVPR 2016, arXiv:1512.03385.
- S. Dorafshan, R. J. Thomas, M. Maguire — “SDNET2018: An annotated image dataset for non-contact concrete crack detection using deep convolutional neural networks”, Data in Brief 21, 2018, 1664–1668; Ç. F. Özgenel, A. Gönenç Sorguç — “Performance comparison of pretrained convolutional neural networks on crack detection in buildings”, ISARC 2018, Berlin.
- M. D. Zeiler, R. Fergus — “Visualizing and understanding convolutional networks”, ECCV 2014 (örtme duyarlılığı); PyTorch — torch.nn.Conv2d belgesi.