Bu derste öğrenecekleriniz
- Tahmin anını tanımlamak ve yalnız bilinen geçmişten özellik üretmek
- Zaman serisini sırayı koruyarak bölmek ve dönem sınırlarındaki sızıntıyı önlemek
- XGBoost'u doğrulama dönemine göre erken durdurmayla eğitmek
- Modeli son değer referansıyla ve gürültü sınırıyla karşılaştırmak
- Ağaç modellerinin uç durumlardaki davranışını açıklamak
1. Tahmin anını açıkça tanımlayın
900 adımlık, 100 çevresinde dalgalanan sentetik bir fiyat serisi üretiyoruz. Gerçek hisse senedi verisi kullanılmaz. Tahmin anı $t$ kapanışıdır; hedef $t+1$ değeridir. Bu örnek finansal karar veya işlem stratejisi üretmez. Aynı soru mühendislikte de sık sorulur: bir sensörün bir sonraki saatteki ölçümü, bir binanın yarınki enerji tüketimi. Yöntem ve tuzaklar aynıdır.
Seri, her adımda ortalamaya doğru çekilen bir süreçle (birinci mertebeden otoregresif süreç, AR(1)) üretilir:
$$ x_t = 100 + 0{,}9\,(x_{t-1} - 100) + \varepsilon_t $$$\varepsilon_t$, standart sapması 1 olan bağımsız normal gürültüdür. Bugünkü değer yarınkinin en önemli ipucudur; ama yarına eklenecek yeni gürültüyü hiçbir model bilemez. Bu, sonuçları yorumlarken önemli olacak.
2. Sadece bilinen geçmişten özellik üretin
Girdiler bugünkü kapanış, 1, 2 ve 4 adım önceki değerler ve son 10 adımın ortalamasıdır: $x_t$, $x_{t-1}$, $x_{t-2}$, $x_{t-4}$ ve $\bar x_{t-9:t}$. Ortalama $t$ dahil geçmişten hesaplanır. Yarınki değer yalnızca hedefte yer alır.
times = np.arange(10, len(close)-1)
X = np.array([[close[t], close[t-1], close[t-2], close[t-4],
               close[t-9:t+1].mean()] for t in times])   # t dahil, t+1 yok
y = close[times+1]
Kural basittir ama sık çiğnenir: bir özellik, tahmin anında gerçekten bilinebiliyor olmalıdır. Ortası $t$'de olan bir hareketli ortalama ya da bütün seriden hesaplanmış bir ölçekleme, geleceği girdiye sızdırır.
3. Zaman sırasını ve sınırları koruyun
İlk %60 eğitim, sonraki %20 doğrulama ve son %20 test dönemidir: 532, 177 ve 178 örnek. Test dönemi 722. ile 899. adımlar arasıdır. Rastgele bölme burada yanlış olurdu: komşu günler birbirine çok benzer ve model, testteki bir günü eğitimdeki komşusundan “ezberleyerek” iyi görünürdü.
İleri kaydırılmış hedeflerin dönem sınırını aşmaması için her sınırdan önce bir gözlem dışarıda bırakılır. Bir adım ileri tahminde bu boşluk ihtiyatlıdır; $h$ adım ileri hedeflerde sınırda $h$ gözlem atlanmalıdır. Kod bu ayrımı assert ile ayrıca kontrol eder. Doğrulama düzenlerinin genel mantığı Ders 03'te; zaman serisinde aynı mantık sırayı koruyarak uygulanır.
4. Küçük ağaçlarla başlayın
XGBoost, önceki tahminlerin hatasını azaltacak ağaçları sırayla ekler (Ders 08). Derinlik 2, öğrenme hızı 0,03 seçilmiştir. Doğrulama MAE'si 25 tur boyunca iyileşmezse eğitim erken durur (erken durdurma). eval_set içine test verisi verilmez.
model = XGBRegressor(n_estimators=400, max_depth=2, learning_rate=0.03,
                     objective="reg:squarederror", eval_metric="mae",
                     early_stopping_rounds=25, random_state=42, n_jobs=1)
model.fit(X_train, y_train, eval_set=[(X_val, y_val)], verbose=False)
baseline = X_test[:, 0]  # Yarın da bugünkü kapanış olsun.
Model tek başına değerlendirilmez. Son değer referansı (“yarın da bugünkü değer olur”) hiçbir şey öğrenmeyen, ama zaman serilerinde şaşırtıcı derecede güçlü bir rakiptir. Bir model ondan iyi değilse kullanılmaz.
Bu, her adımda yeni gerçek kapanışın bilindiği bir adım ileri değerlendirmedir. 100 gün sonrasını tek seferde tahmin etmekle aynı görev değildir (Alıştırma 3).
5. Çalıştırılabilir kod
Önce kurulum adımlarını tamamlayın ve requirements.txt ile kütüphaneleri yükleyin. Ardından xgboost_zaman_serisi.py dosyasını ortamınızdaki Python ile çalıştırın. Sonuç grafiği kodun bulunduğu klasöre kaydedilir.
"""Proje 2 — XGBoost ile zaman serisi: bir adım ileri tahmin.

100 çevresinde dalgalanan sentetik bir seride, t anında bilinen geçmişten t+1 değerini tahmin
ediyoruz. Seri birinci mertebeden otoregresif bir süreçle üretilir:
x[t] = 100 + 0,9·(x[t−1] − 100) + gürültü (standart sapma 1). Gerçek piyasa verisi değildir;
finansal karar ya da işlem stratejisi üretmez. Zaman sırası korunur (eğitim → doğrulama → test)
ve model, “yarın da bugünkü değer olur” diyen basit bir referansla karşılaştırılır.

Çalıştır:  python xgboost_zaman_serisi.py
Gerekenler: numpy, scikit-learn, xgboost, matplotlib  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre bir PNG grafiği (xgboost_zaman_serisi.png)
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from xgboost import XGBRegressor
from sklearn.metrics import mean_absolute_error, mean_squared_error

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent

# %% 1. Veri: 900 adımlık sentetik seri
rng = np.random.default_rng(42)
close = np.empty(900)
close[0] = 100
for t in range(1, len(close)):
    close[t] = 100 + 0.9 * (close[t-1] - 100) + rng.normal(0, 1)

# %% 2. Özellikler: tahmin anı t'de bilinenler (t ve öncesi); hedef t+1 değeri
times = np.arange(10, len(close)-1)
X = np.array([[close[t], close[t-1], close[t-2], close[t-4],
               close[t-9:t+1].mean()] for t in times])        # son 10 adımın ortalaması t dahil
y = close[times+1]

# %% 3. Zaman sırasıyla bölme: %60 eğitim, %20 doğrulama, %20 test
a, b = int(0.6 * len(X)), int(0.8 * len(X))
# Sınırda bir gözlemi atla: eğitim hedefi doğrulama dönemine taşmasın.
X_train, y_train = X[:a-1], y[:a-1]
X_val, y_val = X[a:b-1], y[a:b-1]
X_test, y_test = X[b:], y[b:]
assert times[a-2] + 1 < times[a]
assert times[b-2] + 1 < times[b]
print("=== 1. Veri ===")
print(f"Örnek: {len(X)} (eğitim {len(X_train)}, doğrulama {len(X_val)}, test {len(X_test)}); "
      f"test dönemi: adım {times[b]+1}–{times[-1]+1}")

# %% 4. XGBoost: küçük ağaçlar, düşük öğrenme hızı, doğrulamaya göre erken durdurma
model = XGBRegressor(n_estimators=400, max_depth=2, learning_rate=0.03,
                     objective="reg:squarederror", eval_metric="mae",
                     early_stopping_rounds=25, random_state=42, n_jobs=1)
model.fit(X_train, y_train, eval_set=[(X_val, y_val)], verbose=False)   # test verisi burada yok
prediction = model.predict(X_test)
baseline = X_test[:, 0]  # Yarın da bugünkü kapanış olsun.
print("\n=== 2. Test dönemi ===")
print(f"Kullanılan ağaç sayısı: {model.best_iteration + 1}")
for name, values in [("Son değer referansı", baseline), ("XGBoost", prediction)]:
    print(f"{name}: MAE={mean_absolute_error(y_test, values):.3f}, "
          f"RMSE={np.sqrt(mean_squared_error(y_test, values)):.3f}")
assert np.isfinite(prediction).all()

# %% 5. Grafik
fig, ax = plt.subplots(figsize=(9, 4.8), layout="constrained")
ax.plot(times[b:]+1, y_test, color=SOLUK, lw=1.6, label="Gerçek değer (sentetik)")
ax.plot(times[b:]+1, prediction, color=RENK[0], lw=1.6, label="XGBoost")
ax.plot(times[b:]+1, baseline, color=RENK[1], lw=1.4, ls=":", label="Son değer referansı")
ax.set(xlabel="Zaman adımı", ylabel="Sentetik değer (birim)",
       title="Bir adım ileri tahmin, ayrılan test dönemi")
ax.set_ylim(top=y_test.max() + 1.6)                       # lejant için üstte boşluk
ax.legend(loc="upper center", ncols=3)
fig.savefig(KLASOR / "xgboost_zaman_serisi.png", dpi=160)
plt.close(fig)
print("\nGrafik kaydedildi: xgboost_zaman_serisi.png")=== 1. Veri ===
Örnek: 889 (eğitim 532, doğrulama 177, test 178); test dönemi: adım 722–899
=== 2. Test dönemi ===
Kullanılan ağaç sayısı: 171
Son değer referansı: MAE=0.817, RMSE=1.030
XGBoost: MAE=0.899, RMSE=1.127
Grafik kaydedildi: xgboost_zaman_serisi.png6. Sonuçları yorumlayın
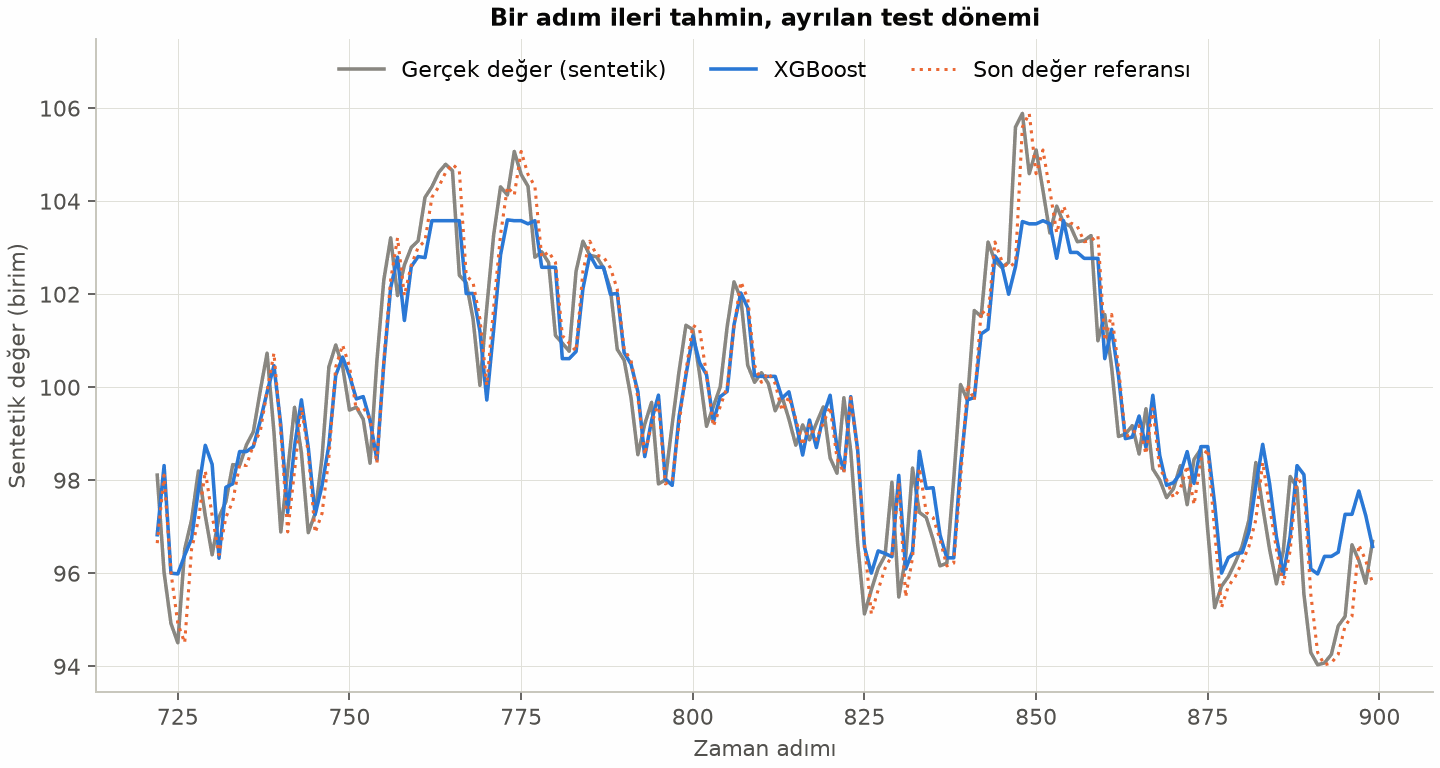
Erken durdurma 196. turda devreye girdi; tahminde doğrulama MAE'sinin en düşük olduğu ilk 171 ağaç kullanılır. Test döneminde XGBoost MAE'si 0,899, son değer referansının MAE'si 0,817 oldu. Daha düşük hata daha iyi olduğundan bu örnekte basit referans kazandı. RMSE değerleri de sırasıyla 1,127 ve 1,030.
Bir modelin karmaşık olması daha iyi tahmin yapacağını garanti etmez. Grafikte yakın görünen iki çizgi yerine, aynı dönemde ölçülen hataları karşılaştırın. Sentetik sonuçlar gerçek piyasa performansına aktarılamaz.
Bu sonuç neden şaşırtıcı değil? Seriyi üreten süreçte yarınki değerin en iyi tahmini $100 + 0{,}9\,(x_t - 100)$ ifadesidir ve bu tahmin bile yeni gürültüyü bilemez. Standart sapması 1 olan normal gürültünün ortalama mutlak değeri $\sqrt{2/\pi} \approx 0{,}798$'dir; hiçbir model bunun belirgin biçimde altına inemez. Son değer referansı bu sınırın yakınında. XGBoost'un kaybettiği yerler de grafikte görülüyor: seri tepe ve dip noktalara ulaştığında mavi çizgi düzleşiyor. Ağaç modellerinin tahmini parça parça sabittir ve her parça, eğitimde o bölgeye düşen örneklerden öğrenilir; uç durumlar eğitimde az olduğu için tahmin ortalamaya doğru çekiliyor (Alıştırma 2 ve 4).
Gerçek piyasa verisine geçerken başka ne kontrol edilir?
Verinin tahmin anında gerçekten yayımlanmış olması, revizyonlar, şirket olayları ve dönem kaymaları önemlidir. Bu küçük örnek bunları kapsamaz; tarih sırasını korumak tek başına tüm veri sızıntısını önlemez. Mühendislik ölçümlerinde karşılıkları gecikmeli gelen veri, sonradan yapılan kalibrasyon düzeltmeleri ve sensör değişimleridir.
7. Sık yapılan hatalar
- Zaman serisini rastgele bölmek. Komşu adımlar eğitim ve teste dağılır, test hatası gerçekte olacağından iyimser çıkar. Zaman sırasını koruyun.
- Geleceği özelliğe sızdırmak. Ortalanmış hareketli ortalama, bütün seriden hesaplanan ölçekleme ya da hedefle aynı anı içeren bir değişken, modeli sahada kullanılamaz hâle getirir.
- Erken durdurmayı test verisiyle yapmak.
eval_set'e test verisi vermek, test verisini model seçimine katmaktır. Doğrulama dönemi ayrı olmalıdır. - Referans olmadan sonuç raporlamak. 0,899 tek başına iyi ya da kötü değildir; son değer referansı 0,817 olduğunda kötüdür.
- Grafiğe bakıp karar vermek. Bir adım geriden gelen bir tahmin, grafikte gerçek seriyi “izliyor” gibi görünür. Karşılaştırmayı aynı dönemde ölçülen hatalarla yapın.
- Bir adım ilerinin başarısını uzun ufka taşımak. Ortalamaya dönen bu tür bir seride ufuk uzadıkça son değer referansı bile ortalamadan kötüleşir (Alıştırma 3); rastgele yürüyüşte ise son değer en iyi tahmin olarak kalır.
8. Alıştırmalar
Alıştırma 1KolayDaha uzun bir pencere
Hareketli ortalama penceresini 10'dan 20'ye çıkarın. Başlangıç indeksini de güncellemeniz gerekir; neden? Modeli seçmek için yalnızca doğrulama dönemini kullanın ve sonucu referansla karşılaştırın.
Çözümü göster
20 adımlık ortalama için $t-19$'a kadar geçmiş gerekir; bu yüzden times = np.arange(20, len(close)-1) ve close[t-19:t+1].mean() yazılır. Başlangıç 10'da kalsaydı $t$ = 10–18 için close[t-19:t+1] dilimi boş kalır ve ortalama nan olurdu. NumPy yalnız bir uyarı verir, XGBoost da nan'ı eksik değer sayıp sessizce devam eder; hata kendini göstermez.
Sonuç: en iyi doğrulama sonucu 86. ağaçta alınır (eğitim 111. turda durur); XGBoost MAE'si 0,931, RMSE 1,167. Son değer referansı MAE 0,806, RMSE 1,018 ile yine kazanır. Dikkat: başlangıç kaydığı için test dönemi de değişti (724–899. adımlar, 176 örnek). Karşılaştırmayı her zaman aynı dönemde, aynı referansla yapın.
Alıştırma 2OrtaSüreci bilseydik
Seriyi üreten süreci bildiğimizi varsayın: test döneminde $\hat x_{t+1} = 100 + 0{,}9\,(x_t - 100)$ tahmininin MAE'si nedir? Sonra yalnız $x_t$'yi kullanan bir doğrusal regresyonu eğitim verisiyle kurun. Eğimi ve test hatası ne çıkar?
Çözümü göster
Süreci bilen tahmin test döneminde MAE 0,795 ve RMSE 1,018 verir; kuramsal sınırlar $\sqrt{2/\pi} \approx 0{,}798$ ve 1'dir. Son değer referansı (0,817) bu sınıra çok yakın, XGBoost (0,899) ise belirgin biçimde uzak.
Yalnız $x_t$ ile eğitilen LinearRegression eğimi 0,881, kesişimi 11,88 bulur (gerçek değerler 0,9 ve 10) ve test MAE'si 0,806 olur: referanstan da iyi. Beş özelliğin hepsini kullanan doğrusal model 0,822 verir; gereksiz özellikler biraz gürültü ekler. Süreç doğrusalken doğru model ailesi doğrusal modeldir. Ağaçlar bir doğruyu ancak basamaklarla yaklaşık temsil edebilir (Ders 07).
Alıştırma 3OrtaBir adım değil, h adım ileri
Test döneminde her $t$ için $x_{t+h}$'yi üç yolla tahmin edin: son değer ($x_t$), süreç ortalaması (100) ve süreci bilen tahmin $100 + 0{,}9^h\,(x_t - 100)$. $h$ = 1, 5 ve 20 için MAE'leri karşılaştırın.
Çözümü göster
| $h$ | Son değer | Ortalama (100) | Süreci bilen |
|---|---|---|---|
| 1 | 0,817 | 2,410 | 0,795 |
| 5 | 1,795 | 2,370 | 1,632 |
| 20 | 3,302 | 2,404 | 2,430 |
Not: $t+h$ en fazla 899 olabildiği için her satırda farklı sayıda örnek var (178, 174 ve 159); “Ortalama (100)” sütununun satırdan satıra değişmesinin nedeni budur.
Bir adımda en iyi basit referans olan son değer, 20 adımda süreç ortalamasından açıkça kötüdür: $0{,}9^{20} \approx 0{,}12$ olduğundan bugünün bilgisi 20 adım sonra neredeyse silinmiştir. Uzun ufukta süreci bilen tahmin bile ortalamaya yaklaşır; aradaki fark (2,430'a karşı 2,404) bu örneklemde gürültü düzeyindedir. Bir adım ileri değerlendirme, uzun ufuk hakkında bir şey söylemez.
Alıştırma 4ZorXGBoost nerede kaybediyor?
Eğitim hedeflerinin aralığını, XGBoost'un test dönemindeki tahminlerinin aralığıyla karşılaştırın. Sonra test örneklerini iki gruba ayırın: $|x_t - 100| > 3$ (uç durumlar) ve geri kalanlar. Her grupta XGBoost'un ve referansın MAE'si nedir?
Çözümü göster
Eğitim hedefleri 94,01–105,54 arasındadır; testteki gerçek değerler 94,03–105,89. XGBoost'un test tahminleri ise yalnız 95,97–103,60 arasında kalır: model uçlara hiç ulaşamaz. Uç durumlar eğitim örneklerinin %14,7'si, test örneklerinin ise %36,5'idir; test dönemi daha oynak geçmiştir.
Uç durumlarda (65 örnek) XGBoost MAE'si 0,935, referansınki 0,743, süreci bilen tahmininki 0,696. Geri kalan 113 örnekte farklar küçüktür: 0,878, 0,859 ve 0,853. Kaybın çoğu uçlardan gelir. Ağaç modelleri girdi uzayını bölgelere ayırır ve her bölgeye, eğitimde oraya düşen örneklerden öğrenilmiş sabit bir değer verir. Az örnekli uç bölgelerde bu değer merkeze doğru çekilir; küçük öğrenme hızı ve erken durdurma da artırmanın uçlara yaklaşmasını sınırlar. Ağaç toplulukları, eğitimde gördükleri hedef aralığının dışına neredeyse hiç çıkamaz (Ders 07'deki dış değer sorunu). Doğrusal bir model ise $0{,}9\,(x_t - 100)$ ilişkisini uçlara da taşır.
Özet
- Tahmin anını tanımlayın: özellikler yalnız $t$ ve öncesinden gelir, hedef $t+1$'dir; geleceği girdiye sızdırmayın.
- Zaman serisinde bölme zaman sırasıyla yapılır; dönem sınırlarında hedefin taşmasına dikkat edilir, erken durdurma yalnız doğrulama dönemiyle yapılır.
- Bu örnekte basit son değer referansı (MAE 0,817) XGBoost'u (0,899) yendi; gürültü sınırı yaklaşık 0,798'dir.
- Ağaç tabanlı modeller uç durumlarda tahmini ortalamaya çeker ve eğitim aralığının dışına neredeyse hiç çıkamaz; süreç doğrusalsa doğrusal model daha uygundur.
Sonraki projede ağaç tabanlı bir modeli, cevabını bildiğimiz bir mühendislik formülüne karşı sınayacağız: Proje 3, kiriş sehimi için vekil model.
Kaynaklar
- scikit-learn — model değerlendirme ve veri sızıntısı.
- XGBoost Python API belgeleri.
- T. Chen, C. Guestrin (2016) — XGBoost: A Scalable Tree Boosting System, KDD.
- R. J. Hyndman, G. Athanasopoulos — Forecasting: Principles and Practice (basit referans tahminleri ve zaman serisinde değerlendirme).