Bu derste öğrenecekleriniz
- Abrams yasası ve yaş katsayısından anlamlı özellikler türetmek; log hedefin rolünü açıklamak
- Ridge, Lasso ve Elastic Net amaç fonksiyonlarını yazmak; Ridge'in kapalı çözümünü ve SVD büzülmesini türetmek
- Lasso'yu koordinat inişi ve yumuşak eşiklemeyle sıfırdan çözmek; seyrekliğin geometrisini açıklamak
- Lasso yolu ve
LassoCVile ceza seçmek; bir-standart-hata kuralını uygulamak - Cezalı modellerde ölçeklemenin neden şart olduğunu göstermek
PipelineveColumnTransformerile eksik değer, ölçekleme ve kategorik kodlamayı sızıntısız kurmak
1. Problem: karışımdan beton dayanımını tahmin etmek
Hazır beton santralinde her reçete için aynı soru sorulur: bu karışım 28 günde, ya da örneğin 7. günde, ne kadar dayanım verecek? Cevabın çoğu tek bir oranda saklıdır. Abrams yasasına göre basınç dayanımı su/çimento oranıyla üstel olarak azalır:
$$ f_{28} = \frac{A}{B^{\,\mathrm{s/b}}} $$$A$ ve $B$ malzemeye bağlı sabitlerdir; s/b ise su/bağlayıcı oranıdır. Cüruf ve uçucu kül çimento kadar etkin değildir. Bu yüzden bağlayıcıya bir etkinlik katsayısıyla katılırlar; EN 206'daki k-değeri kavramı bu fikre dayanır. Yaşın etkisi için EN 1992-1-1 (Bağıntı 3.2) şu katsayıyı verir:
$$ \beta_{cc}(t) = \exp\!\left[s\left(1 - \sqrt{28/t}\right)\right] $$$t$ gün cinsinden yaştır. $s$ çimentonun dayanım kazanma hızına bağlıdır: hızlı (R sınıfı) çimentolarda 0,20, normal (N) çimentolarda 0,25, yavaş (S) çimentolarda 0,38.
Bu derste kursun ortak sentetik beton üreticisini kullanıyoruz. 500 karışımın her birinde çimento, cüruf, uçucu kül, su, süperakışkanlaştırıcı, iri ve ince agrega miktarları (kg/m³), deney yaşı (3, 7, 14, 28, 56 veya 90 gün) ve çimento tipi (CEM I 42,5 R, CEM II/A-LL 42,5 N, CEM III/A 32,5 N) rastgele seçiliyor. Dayanım şöyle üretiliyor:
- Etkin bağlayıcı: çimento + 0,6 × cüruf + 0,4 × uçucu kül; $f_{28} = 96{,}5 / 7^{\,\mathrm{s/b}}$ MPa.
- Çimento tipi iki yerde etkili: dayanım sınıfı çarpanı (1,00; 0,97; 0,88) ve yaş katsayısındaki $s$ (0,20; 0,25; 0,38).
- Süperakışkanlaştırıcı küçük bir katkı yapıyor: kg/m³ başına 0,25 MPa.
- Sonuç $\beta_{cc}(t)$ ile çarpılıyor ve %7'lik log-normal saçılma ekleniyor.
- Agregalar, kalıp numarası ve ortam sıcaklığı dayanımı hiç etkilemiyor. Bunları bilerek koyduk: model onları ne kadar ciddiye alacak?
- Süperakışkanlaştırıcı sütununda satırların yaklaşık yüzde 5'i rastgele silindi; bu örneklemde 30 satır (%6,0) eksik.
Dayanımlar 11,1 ile 63,4 MPa arasında, ortalama 36,6 MPa. Her satır ayrı bir karışım olduğu için rastgele KFold burada doğru seçimdir. Aynı karışımın farklı yaşlardaki küpleri ayrı satırlar olsaydı, Ders 03'teki gibi karışıma göre gruplu doğrulama gerekirdi.
Sentetik veri, yönetmelik hesabı değil
Veri, bilinen bağıntılardan ve varsayımsal katsayılardan üretilmiştir; gerçek bir deney veri kümesi değildir. Sınıf çarpanı ve süperakışkanlaştırıcı katkısı yalnızca anlatım içindir. Gerçek betonda kür koşulları, agrega kalitesi, hava içeriği ve santral farkları gibi burada olmayan etkenler vardır. Beton sınıfı ve uygunluk değerlendirmesi standart deneylerle yapılır; bir regresyon modeli bunların yerine geçmez.
2. Özellik mühendisliği: fiziği modele tanıtmak
Önce hiçbir şey düşünmeden başlayalım: on sayısal sütun ve çimento tipi için iki kukla sütun, sıradan en küçük kareler, hedef MPa. Beş katlı çapraz doğrulamada bu model R² = 0,771, RMSE = 4,63 MPa veriyor. Fena değil ama dayanımın üstel ve çarpımsal yapısını doğrusal bir toplamla taklit etmeye çalışıyor.
Abrams yasasının ve $\beta_{cc}$'nin logaritmasını alalım. Süperakışkanlaştırıcının küçük etkisini ve saçılmayı bir yana bırakırsak:
$$ \begin{aligned} \ln f = {}& \ln A + \ln c_{\text{tip}} \\ & - (\ln B)\,\mathrm{s/b} + s_{\text{tip}}\; g(t) \end{aligned} $$ $$ g(t) = 1 - \sqrt{28/t} $$Bu ifade iki yeni özellikte, s/b ve $g(t)$'de, doğrusaldır. Tek pürüz, $g(t)$'nin katsayısının çimento tipine bağlı olması. Bunu da tip × $g(t)$ etkileşim terimleriyle karşılarız. Hedefi $\ln f$ yapınca saçılma da toplamsal olur ve her yerde aynı büyüklükte kalır. Özellikleri satır satır hesaplayan küçük bir fonksiyon yeter:
def ozellik_ekle(d):
    """Satır satır hesaplanan fiziksel özellikler (veriden parametre öğrenmez → sızıntı yok)."""
    d = d.copy()
    d["sb"] = d.su / (d.cimento + 0.6 * d.curuf + 0.4 * d.ucucu_kul)   # su / etkin bağlayıcı
    d["g_yas"] = 1 - np.sqrt(28 / d.yas_gun)                           # ln β_cc = s · g(t)
    d["g_x_II"] = d.g_yas * (d.cimento_tipi == TIP2)                   # tipe bağlı s için etkileşim
    d["g_x_III"] = d.g_yas * (d.cimento_tipi == TIP3)
return d| Model | MAE (MPa) | RMSE (MPa) | R² |
|---|---|---|---|
| (a) Ham sütunlar + one-hot, hedef MPa | 3,68 ± 0,47 | 4,63 ± 0,52 | 0,771 ± 0,078 |
| (b) s/b, $g(t)$, süperakışkanlaştırıcı + one-hot, hedef $\ln f$ | 2,45 ± 0,26 | 3,09 ± 0,30 | 0,897 ± 0,039 |
| (c) (b) + tip × $g(t)$ etkileşimi | 2,12 ± 0,26 | 2,73 ± 0,32 | 0,920 ± 0,029 |
| (d) Ham sütunların 2. derece polinomu (90 özellik), en küçük kareler | 3,35 ± 0,47 | 4,33 ± 0,63 | 0,801 ± 0,059 |
| (e) (d) + RidgeCV | 3,31 ± 0,47 | 4,30 ± 0,62 | 0,805 ± 0,057 |
| (f) (d) + LassoCV | 3,14 ± 0,23 | 3,97 ± 0,31 | 0,835 ± 0,042 |
| (g) (d) + ElasticNetCV | 3,14 ± 0,21 | 3,98 ± 0,29 | 0,834 ± 0,041 |
Üç fiziksel özellik RMSE'yi 4,63'ten 3,09 MPa'ya, etkileşim terimleri 2,73 MPa'ya indiriyor. (c) modelinin artıkları log ölçekte 0,073 standart sapmalı; üreticideki saçılma 0,07. Model, verideki gürültünün izin verdiği yere neredeyse varmış: yedi katsayılı bir doğrusal model.
(d)–(g) satırları diğer yolu gösteriyor: fizik bilinmiyorsa bütün sütunların karelerini ve ikili çarpımlarını ekleyip esnekliği artırmak. 90 özellikle en küçük kareler 0,801'e çıkıyor. Ridge bunu çok az, Lasso ve Elastic Net biraz daha iyileştiriyor (0,835). Hiçbiri yedi anlamlı özelliğin 0,920'sine yaklaşmıyor. Düzenlileştirme eksik bilginin yerini tutmaz; ama çok sayıda özellikle çalışmak zorunda kaldığınızda modeli dizginler. Bu dersin geri kalanı, bunun nasıl olduğunu anlatıyor.
Log hedeften MPa'ya dönüş
TransformedTargetRegressor(func=np.log, inverse_func=np.exp) modeli $\ln f$ üzerinde eğitir, tahminleri otomatik olarak MPa'ya çevirir; çapraz doğrulama skorları da MPa cinsinden hesaplanır. Bir incelik: $\exp(\widehat{\ln f})$ dağılımın ortalamasını değil medyanını verir. Log-normal saçılmada ortalama/medyan oranı $\exp(\sigma^2/2)$'dir; $\sigma = 0{,}07$ için yaklaşık 1,0025, yani ihmal edilebilir. Saçılma büyükse bu düzeltmeyi unutmayın.
3. Ridge, Lasso ve Elastic Net
Özellik sayısı arttıkça en küçük kareler iki sorunla karşılaşır. Birincisi varyans: model verideki rastlantıları da öğrenir (Ders 03). İkincisi koşul: birbirine benzeyen sütunlar varsa $X^\top X$ neredeyse tekildir ve katsayılar çok büyük, zıt işaretli değerlere savrulabilir. Düzenlileştirme (regularization), kayba katsayıların büyüklüğünü cezalandıran bir terim ekler. scikit-learn'ün kullandığı biçimlerle Ridge (L2 cezası):
$$ \min_{\vect w}\ \lVert \vect y - X\vect w\rVert^2 + \alpha\,\lVert \vect w\rVert_2^2 $$Lasso (L1 cezası):
$$ \min_{\vect w}\ \frac{1}{2n}\lVert \vect y - X\vect w\rVert^2 + \alpha\,\lVert \vect w\rVert_1 $$Elastic Net (ikisinin karışımı):
$$ \begin{aligned} \min_{\vect w}\ & \frac{1}{2n}\lVert \vect y - X\vect w\rVert^2 + \alpha r\,\lVert \vect w\rVert_1 \\ & + \frac{\alpha(1-r)}{2}\lVert \vect w\rVert_2^2 \end{aligned} $$$\lVert \vect w\rVert_2^2 = \sum_j w_j^2$ ve $\lVert \vect w\rVert_1 = \sum_j |w_j|$; $r$, l1_ratio parametresidir. Sabit terim hiçbir zaman cezalandırılmaz: veri merkezlenir, sabit terim ortalamadan bulunur. Ridge ile Lasso'nun ölçeklemesi farklıdır ($1/2n$ çarpanı), bu yüzden aynı $\alpha$ iki modelde aynı şiddeti anlatmaz. $\alpha$ bir hiperparametredir ve çapraz doğrulamayla seçilir; RidgeCV, LassoCV ve ElasticNetCV bunu kendi içlerinde yapar. Tablodaki (e)–(g) satırlarında bu seçim her dış katın içinde ayrıca yapıldı; sonuçlar iç içe doğrulamanın dürüstlüğündedir.
Bayesçi okuma
Gürültü $\mathcal N(0, \sigma^2)$ ve katsayılar için önsel $w_j \sim \mathcal N(0, \tau^2)$ ise, sonsal dağılımın en olası değeri (MAP) tam olarak Ridge çözümüdür ve ceza $\alpha = \sigma^2/\tau^2$ olur. Önsel Laplace dağılımıysa, $p(w_j) \propto e^{-|w_j|/b}$, MAP çözümü Lasso'dur. Ceza, “katsayılar büyük olmamalı” önbilgisinin matematiksel karşılığıdır. Laplace dağılımının sıfırda sivri tepesi, Lasso'nun katsayıları neden tam sıfıra ittiğinin de bir ipucudur.
4. Ridge: kapalı çözüm ve SVD büzülmesi
Ridge kaybı karesel olduğu için gradyanı sıfıra eşitleyip çözebiliriz (Ders 02'deki normal denklemlerle aynı yol):
$$ \nabla L = -2X^\top(\vect y - X\vect w) + 2\alpha\,\vect w = \vect 0 $$ $$ (X^\top X + \alpha I)\,\vect w = X^\top \vect y $$$X^\top X$ yarı pozitif tanımlıdır; $\alpha I$ eklenince bütün özdeğerleri en az $\alpha$ olur. Sistem, sütunlar ne kadar ilişkili olursa olsun her zaman çözülebilir.
SVD ile büzülme
$X = UDV^\top$ tekil değer ayrışımı olsun; $d_j$ tekil değerler, $\vect u_j$ ve $\vect v_j$ sütun vektörleri. $X^\top X + \alpha I = V(D^2 + \alpha I)V^\top$ ve $X^\top\vect y = VDU^\top\vect y$ olduğundan:
$$ \hat{\vect w} = V\,\mathrm{diag}\!\left(\frac{d_j}{d_j^2 + \alpha}\right) U^\top \vect y $$ $$ \hat{\vect y} = X\hat{\vect w} = \sum_j \frac{d_j^2}{d_j^2 + \alpha}\;\vect u_j\,(\vect u_j^\top\vect y) $$En küçük kareler ($\alpha = 0$) her yöndeki bileşeni olduğu gibi alır. Ridge, $j$. yöndeki bileşeni $d_j^2/(d_j^2+\alpha)$ çarpanıyla küçültür. Büyük $d_j$'li yönler, yani verinin bol değiştiği yönler, neredeyse hiç değişmez. Küçük $d_j$'li yönler, yani birbirine benzeyen sütunların farkları, güçlü biçimde bastırılır. Çarpanların toplamı modelin etkin serbestlik derecesidir: $\mathrm{df}(\alpha) = \sum_j d_j^2/(d_j^2+\alpha)$.
def ridge_kapali(X, y, alfa):
    """(XᵀX + αI) w = Xᵀy; X ve y merkezlenmiş varsayılır (sabit terim cezalanmaz)."""
    return np.linalg.solve(X.T @ X + alfa * np.eye(X.shape[1]), X.T @ y)


U, dvals, Vt = np.linalg.svd(Xs, full_matrices=False)
buzulme = dvals**2 / (dvals**2 + alfa_r)                     # her temel yöndeki büzülme çarpanı
w_svd = Vt.T @ (buzulme / dvals * (U.T @ lyc))              # aynı çözüm, SVD ile
Bunu 18 özellikli geniş bir kümede deniyoruz (6. bölümde ayrıntısı var): fiziksel özellikler ve etkileşimleri, ham sütunlar, dört ilgisiz sütun ve iki kare terimi; hepsi standartlaştırılmış, hedef $\ln f$. RidgeCV $\alpha = 1{,}26$ seçiyor. Kapalı biçim, scikit-learn ve SVD çözümü $10^{-14}$ mertebesinde aynı. Tekil değerler 40,7 ile 0,646 arasında. Büzülme çarpanları 0,999 ile 0,249 arasında; etkin serbestlik derecesi 18 yerine 17,0. Katsayı vektörünün normu 0,23'ten 0,21'e iniyor. Bu veri kümesinde 500 satır olduğu için ceza hafif kalıyor; aynı ceza 50 satırlık bir veride çok daha belirleyici olurdu.
5. Lasso: yumuşak eşikleme ve seyreklik
Lasso'nun mutlak değer cezası sıfırda türevlenemez; kapalı bir çözümü yoktur. Ama tek bir katsayı için problem çok basittir ve bu basit çözüm bütün algoritmanın yapı taşıdır.
Tek katsayıda Lasso: yumuşak eşikleme
Standartlaştırılmış tek bir özellik ($\tfrac1n\lVert\vect x\rVert^2 = 1$) ve $\rho = \tfrac1n\vect x^\top\vect y$ için Lasso kaybı, sabitler dışında, şudur:
$$ L(w) = \tfrac12 w^2 - \rho\,w + \alpha\,|w| $$$w > 0$ bölgesinde türev $w - \rho + \alpha$ ve sıfır noktası $w = \rho - \alpha$; bu yalnız $\rho > \alpha$ ise geçerlidir. $w < 0$ bölgesinde benzer biçimde $w = \rho + \alpha$, yalnız $\rho < -\alpha$ ise. $|\rho| \le \alpha$ olduğunda $w = 0$'da alt türev $[-\rho - \alpha,\ -\rho + \alpha]$ sıfırı içerir; minimum sıfırdadır. Üçü birlikte:
$$ w = S(\rho, \alpha) $$ $$ S(\rho, \alpha) = \mathrm{sign}(\rho)\,\max(|\rho| - \alpha,\ 0) $$$S$, yumuşak eşikleme (soft thresholding) fonksiyonudur. Ridge'in tek katsayılı çözümü ise scikit-learn'ün Ridge biçimiyle $\rho/(1+\alpha/n)$'dir: katsayıyı orantılı küçültür ama sıfıra indirmez.
Koordinat inişi (coordinate descent) çok özellikli problemi bu tek katsayılı çözümle halleder. Katsayılar sırayla ele alınır. Her biri için diğerleri sabit tutulur, $j$. özelliğin kısmi artıkla korelasyonu $\rho_j$ hesaplanır ve $w_j = S(\rho_j, \alpha)$ yapılır. Turlar, katsayılar artık değişmeyene kadar sürer. scikit-learn'ün Lasso ve ElasticNet sınıfları da koordinat inişi kullanır.
def yumusak_esik(a, t):
    return np.sign(a) * np.maximum(np.abs(a) - t, 0.0)


def lasso_koordinat(X, y, alfa, tol=1e-10, en_cok=20000):
    """min (1/2n)‖y − Xw‖² + α‖w‖₁ ; X standartlaştırılmış (‖x_j‖²/n = 1), y merkezlenmiş."""
    n, p = X.shape
    w, artik = np.zeros(p), y.copy()                 # artik = y − Xw
    for adim in range(1, en_cok + 1):
        en_buyuk_degisim = 0.0
        for j in range(p):
            eski = w[j]
            rho = X[:, j] @ artik / n + eski         # j. katsayı dışarıdayken korelasyon
            w[j] = yumusak_esik(rho, alfa)
            if w[j] != eski:
                artik -= X[:, j] * (w[j] - eski)
                en_buyuk_degisim = max(en_buyuk_degisim, abs(w[j] - eski))
        if en_buyuk_degisim < tol:
            return w, adim
    return w, en_cok
rho satırındaki + eski terimi, artığa $j$. özelliğin kendi katkısını geri ekler. Standartlaştırma sayesinde $\tfrac1n\lVert\vect x_j\rVert^2 = 1$ olduğu için bu kadar basittir. Aynı 18 özellikli kümede 323 turda yakınsıyor ve scikit-learn'ün sonucuyla $1{,}9\times10^{-9}$ içinde örtüşüyor.
Seyrekliğin geometrik açıklaması da var. Cezalı problem, katsayıların belli bir bölgede kalması koşuluyla kaybı en küçüklemeye eşdeğerdir: L2 için bir daire, L1 için köşeleri eksenlerde olan bir eşkenar dörtgen. Kaybın eş değer eğrileri (elipsler) büyürken bölgeye ilk değdikleri nokta çözümdür. Dairenin köşesi yoktur; temas noktasında iki katsayı da genellikle sıfırdan farklıdır. Eşkenar dörtgenin köşeleri ise sivri ve eksenlerin üzerindedir; elips çoğu zaman önce bir köşeye değer ve orada katsayılardan biri tam sıfırdır. Bir incelik daha: Ridge katsayıları tek tek küçültmez, katsayı vektörünün boyunu küçültür. Özellikler ilişkiliyse bir katsayı büyüyebilir bile; aşağıdaki örnekte $w_2$ öyle.
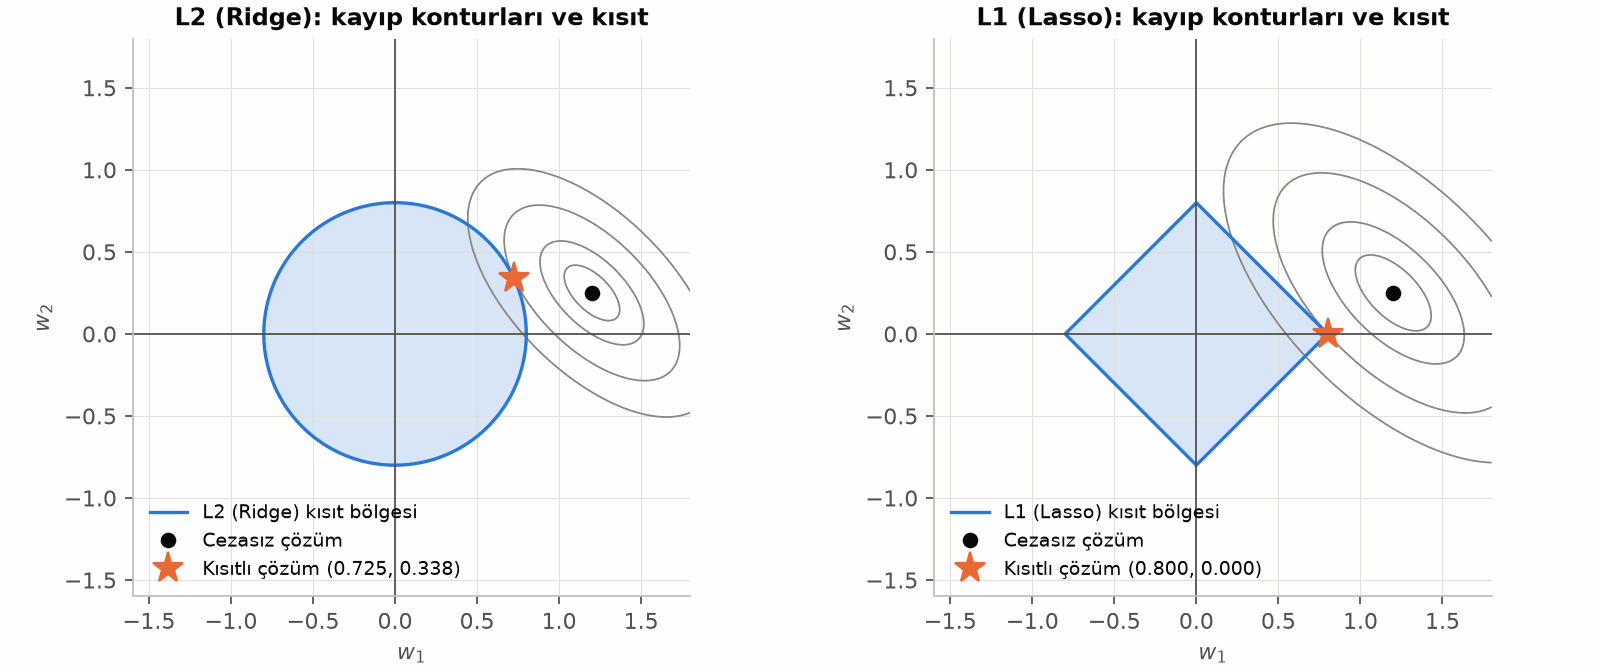
Elastic Net iki cezayı karıştırır. İlişkili özellikler varsa Lasso aralarından birini neredeyse keyfî seçip ötekileri sıfırlayabilir. L2 bileşeni ise ağırlığı ilişkili özellikler arasında paylaştırmaya iter. Bu veride iki yöntem aynı yere vardı (tablodaki (f) ve (g)).
6. Lasso yolu ve cezanın seçimi
Lasso'nun en öğretici çıktısı tek bir model değil, Lasso yoludur (lasso path): $\alpha$ büyükten küçüğe indirilirken her katsayının nasıl değiştiği. Çok büyük $\alpha$'da bütün katsayılar sıfırdır. Ceza azaldıkça özellikler modele birer birer girer. Bunu 18 standart özellikli geniş kümede çalıştırdık:
- Fiziksel özellikler: s/b, $g(t)$, ikisinin kareleri, s/b·$g(t)$ çarpımı, CEM II ve CEM III kuklaları, bunların $g(t)$ ile etkileşimleri ve süperakışkanlaştırıcı.
- Bilgisi zaten s/b'nin içinde olan ham sütunlar: çimento, su, cüruf, uçucu kül.
- Dayanımla hiçbir ilgisi olmayan dört sütun: iri agrega, ince agrega, kalıp no, ortam sıcaklığı.
Kolaylık için bu gösterimde doldurma ve standartlaştırma bütün veriyle yapıldı. Bu, 8. bölümde anlatacağımız türden küçük bir sızıntıdır; burada etkisi ihmal edilebilir.
Giriş sırası: önce s/b·$g(t)$ ve s/b, ardından CEM III·$g(t)$, $g(t)$, CEM III, CEM II·$g(t)$ ve süperakışkanlaştırıcı. İlgisiz sütunlar ancak $\alpha \approx 3{,}2\times10^{-3}$'ün altında giriyor. $\alpha$'yı seçmek için LassoCV her $\alpha$ değerinde 5 katlı CV hatasını hesaplar:
- En küçük CV hatası: $\alpha = 1{,}37\times10^{-3}$. 18 katsayının 16'sı sıfırdan farklı; ilgisiz sütunların en büyük katsayısı 0,0017. Tahmin için iyi ama yorum için kalabalık.
- Bir-standart-hata kuralı: CV hatası en küçük değerden en fazla bir standart hata uzaktaki modellerin en sadesini seçin. Burada $\alpha = 7{,}91\times10^{-3}$; yalnız 7 katsayı kalıyor ve ilgisiz dört sütunun hepsi tam sıfır.
Kalan yedi standart katsayı: s/b −0,196, $g(t)$ +0,126, s/b·$g(t)$ +0,016, CEM III −0,034, CEM II·$g(t)$ +0,027, CEM III·$g(t)$ +0,065, süperakışkanlaştırıcı +0,015. Bu, 2. bölümde fizikten türettiğimiz modelin neredeyse aynısı. Sade modelin CV sonucu RMSE 2,84 MPa, R² 0,914; elle kurulan (c) modeli 0,920. Lasso, verinin içinden fiziğe yakın bir yapıyı kendisi bulmuş.
Lasso'nun seçimi nedensellik değildir
Yolda s/b·$g(t)$ çarpımı modele $g(t)$'den önce giriyor ve bir süre onun yerini tutuyor; $g(t)$ girince geri çekiliyor. İlişkili özelliklerden hangisinin seçileceği, verideki küçük rastlantılara bağlıdır. Lasso'nun bir özelliği sıfırlaması “bu değişken etkisiz” demek değildir; çoğu zaman “bu bilgi başka bir sütunda zaten var” demektir. Çimento ve su bunun örneği: dayanımı belirleyen onlardır, ama bilgileri s/b'nin içinde.
7. Ölçekleme: cezalı modellerin ön şartı
En küçük kareler ölçekten bağımsızdır: bir sütunu 1000'e bölerseniz katsayısı 1000 ile çarpılır, tahminler değişmez. Cezalı modellerde bu artık doğru değildir. Ceza katsayıların sayısal büyüklüğüne bakar ve sayısal büyüklük sütunun birimine bağlıdır. Aynı Ridge cezasını ($\alpha = 1$, hedef $\ln f$) 15 özelliğe ölçeklemeden ve StandardScaler ile uyguladık:
| Girdi | RMSE | R² | s/b | Çimento |
|---|---|---|---|---|
| Ölçeksiz | 3,03 | 0,903 | −0,410 | +0,00170 |
| Ölçekli | 2,76 | 0,919 | −1,733 | +0,00013 |
Abrams yasasına göre s/b'nin log ölçekteki gerçek etkisi $-\ln 7 = -1{,}946$. Standartlaştırılmış model buna yakın bir değer buluyor; ölçeksiz model ise beşte birini. Nedeni birimlerde: s/b'nin standart sapması 0,112, çimentonunki 71,7 kg/m³. s/b ile aynı etkiyi yaratmak için büyük bir katsayı gerekir ve ceza en çok onu bastırır. Model bilgiyi çimento sütunundan toplamaya çalışıyor; çimento katsayısı 13 kat büyüyor. Sonuç hem daha kötü tahmin, hem yanlış bir fiziksel yorum. Standartlaştırma her özelliği aynı ölçeğe getirip cezayı adil yapar.
8. Sızıntısız ön işleme: Pipeline ve ColumnTransformer
Gerçek tablolarda sayısal ve kategorik sütunlar birlikte gelir ve bazı hücreler boştur. Her dönüşüm, eksik değer doldurma, ölçekleme ya da kodlama, verinin bir istatistiğini öğrenir: medyan, ortalama, standart sapma, kategori listesi. Bunlar bütün veriden öğrenilirse doğrulama katlarının bilgisi eğitime sızar (Ders 03). Çözüm, bütün adımları tek bir modelde toplamaktır:
def on_isleme(sayisal, kodlayici=None):
    """Sayısal: eksik doldur + standartlaştır; kategorik: one-hot (varsayılan)."""
    if kodlayici is None:
        kodlayici = OneHotEncoder(drop="first", sparse_output=False)
    sayisal_hat = Pipeline([("doldur", SimpleImputer(strategy="median")), ("olcek", StandardScaler())])
    return ColumnTransformer([
        ("sayisal", sayisal_hat, sayisal),
        ("kategorik", kodlayici, ["cimento_tipi"]),
    ])


def log_hedef(regresor):
    """Model log(dayanım)'ı öğrenir; tahminler exp ile MPa'ya geri döner."""
    return TransformedTargetRegressor(regressor=regresor, func=np.log, inverse_func=np.exp)


model_c = log_hedef(Pipeline([("on_isleme", on_isleme(MUH_C)), ("reg", LinearRegression())]))
cross_validate bu nesneyi her katta yeniden eğitir. Süperakışkanlaştırıcının medyanı da, ölçekleyicinin parametreleri de yalnız o katın eğitim satırlarından hesaplanır. OneHotEncoder(drop="first") üç tipi iki kukla sütunla temsil eder; düşen tip (CEM I) referans olur. Sabit terimli sıradan en küçük karelerde üç kuklanın birden kullanılması tam doğrusal bağımlılık yaratır.
One-hot mı, sıralı kodlama mı? OrdinalEncoder tipleri 0, 1, 2 diye tek bir sütuna yazar. Doğrusal model bunu bir ölçüm gibi okur: tipler sıralıdır ve ardışık tipler arasındaki fark eşittir. Model (b) üzerinde:
- One-hot (iki kukla sütun): RMSE 3,09 MPa, R² 0,897.
- Sıralı, doğal sıra (I < II < III): RMSE 3,18 MPa, R² 0,891. Tipler gerçekten dayanım sınıfına göre sıralı olduğu için kayıp küçük, ama eşit aralık varsayımı doğru değil.
- Sıralı, karışık sıra (II < I < III): RMSE 3,52 MPa, R² 0,867. Anlamsız bir sıra, modele anlamsız bir kısıt dayatıyor.
Doğrusal modellerde sırasız kategoriler için one-hot kullanın. Sıralı kodlama, kategoriler gerçekten sıralı ve etkileri yaklaşık eşit adımlıysa ya da ağaç tabanlı modellerde (Ders 07) makul bir seçenektir.
9. Boyutsuz özellikler ve dış değer
Bu derste kullandığımız iki özellik de boyutsuzdur: s/b bir kütle oranı, $g(t)$ ise $t/28$'in bir fonksiyonu. Bu tesadüf değil. Buckingham π teoremine göre fiziksel olarak anlamlı her bağıntı, değişkenlerin boyutsuz gruplarıyla, hem de daha az sayıda değişkenle yazılabilir. Boyutsuz özellikler modele iki şey kazandırır: girdi sayısı azalır ve öğrenilen ilişki ölçekten bağımsız hâle gelir.
İkincisi dış değer (extrapolation) için önemlidir. Ham değişkenlerde eğitim aralığının dışına çıkan yeni bir durum, boyutsuz gruplarda çoğu zaman aralığın içinde kalır. Örneğin basit mesnetli kirişte $\delta = 5qL^4/(384EI)$ bağıntısı $\delta/L = (5/384)\,qL^3/(EI)$ biçiminde tek bir boyutsuz değişkene iner. Proje 3'teki vekil model $L$, $q$ ve $I$'yı ayrı ayrı alıyor. Aynı modeli bu boyutsuz grupla kurmayı deneyebilirsiniz. Beton için de benzer bir deneyi Alıştırma 5'te yapacaksınız: yalnız 28 güne kadarki verilerle eğitilen modeller 56 ve 90 günü tahmin edecek.
10. Çalıştırılabilir kod
Kod dokuz bölümden oluşur: ortak beton üreticisi (birebir kopya), fiziksel özellikler, yedi modelin çapraz doğrulaması, geniş özellik kümesi, sıfırdan Ridge ve Lasso, Lasso yolu, ölçekleme, kategorik kodlama ve grafikler. Çalışma süresi bilgisayarınıza bağlı olarak 15–30 saniyedir.
"""Ders 04 — Düzenlileştirme ve özellik mühendisliği.

Sentetik beton karışımı verisinden basınç dayanımını tahmin ediyoruz. Veri sentetiktir: dayanım,
Abrams yasası (su/etkin bağlayıcı oranı), EN 1992-1-1'deki yaş katsayısı β_cc(t) = exp(s·(1 − √(28/t)))
ve %7 log-normal saçılmayla üretilir; agregalar, kalıp numarası ve ortam sıcaklığı dayanımı etkilemez.
Gerçek bir deney veri kümesi değildir.

Çalıştır:  python d04_duzenlilestirme.py
Gerekenler: numpy, pandas, scikit-learn, matplotlib  (Python 3.12+)
Süre:      yaklaşık 15–30 s
Çıktılar:  terminale sayılar, aynı klasöre üç PNG grafiği
"""
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from sklearn.compose import ColumnTransformer, TransformedTargetRegressor
from sklearn.impute import SimpleImputer
from sklearn.linear_model import ElasticNetCV, Lasso, LassoCV, LinearRegression, Ridge, RidgeCV, lasso_path
from sklearn.model_selection import KFold, cross_val_predict, cross_validate
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, OrdinalEncoder, PolynomialFeatures, StandardScaler

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent


# %% 1. Veri: sentetik beton karışımları (kurs genelindeki ortak üretici, birebir kopya)
def beton_verisi(n, rng, eksik_oran=0.0):
    """Sentetik beton karışımı verisi (eğitim amaçlı; gerçek deney verisi değildir).

    Dayanım, Abrams yasası (f = 96,5 / 7^(s/b) MPa) ve EN 1992-1-1'deki yaş katsayısı
    β_cc(t) = exp(s·(1 − √(28/t))) ile üretilir; s/b oranında cüruf ve uçucu kül, EN 206'daki
    k-değeri kavramına benzer biçimde 0,6 ve 0,4 etkinlikle bağlayıcıya katılır.
    """
    cimento = rng.uniform(250, 500, n)                                   # kg/m³
    curuf = np.where(rng.random(n) < 0.4, rng.uniform(20, 200, n), 0.0)  # kg/m³
    ucucu_kul = np.where(rng.random(n) < 0.3, rng.uniform(20, 150, n), 0.0)
    su = rng.uniform(150, 210, n)                                        # kg/m³
    super_akiskan = np.where(rng.random(n) < 0.6, rng.uniform(2, 12, n), 0.0)
    iri_agrega = rng.uniform(850, 1100, n)
    ince_agrega = rng.uniform(650, 900, n)
    yas_gun = rng.choice([3, 7, 14, 28, 56, 90], n, p=[.12, .2, .13, .3, .13, .12])
    tipler = np.array(["CEM I 42,5 R", "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"])
    tip_no = rng.choice(3, n, p=[.45, .35, .20])
    s_katsayi = np.array([0.20, 0.25, 0.38])[tip_no]      # EN 1992-1-1, Bağıntı 3.2: R, N, S sınıfı
    sinif_carpani = np.array([1.00, 0.97, 0.88])[tip_no]  # varsayım: dayanım sınıfı etkisi
    kalip_no = rng.integers(1, 21, n)                    # ilgisiz özellik
    ortam_sicakligi = rng.uniform(5, 30, n)              # ilgisiz özellik (bu üreticide)

    sb = su / (cimento + 0.6 * curuf + 0.4 * ucucu_kul)  # su / etkin bağlayıcı
    f28 = 96.5 / 7.0 ** sb * sinif_carpani + 0.25 * super_akiskan
    beta = np.exp(s_katsayi * (1 - np.sqrt(28 / yas_gun)))
    dayanim = f28 * beta * rng.lognormal(0.0, 0.07, n)

    df = pd.DataFrame({
        "cimento": cimento, "curuf": curuf, "ucucu_kul": ucucu_kul, "su": su,
        "super_akiskan": super_akiskan, "iri_agrega": iri_agrega, "ince_agrega": ince_agrega,
        "yas_gun": yas_gun, "cimento_tipi": tipler[tip_no], "kalip_no": kalip_no,
        "ortam_sicakligi": ortam_sicakligi, "dayanim_mpa": dayanim,
    })
    if eksik_oran > 0:
        df.loc[rng.random(n) < eksik_oran, "super_akiskan"] = np.nan
    return df


rng = np.random.default_rng(42)
df = beton_verisi(500, rng, eksik_oran=0.05)
y = df["dayanim_mpa"].to_numpy()
HAM_SAYISAL = ["cimento", "curuf", "ucucu_kul", "su", "super_akiskan", "iri_agrega", "ince_agrega",
               "yas_gun", "kalip_no", "ortam_sicakligi"]
TIP2, TIP3 = "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"
print("=== 1. Veri ===")
print(f"{len(df)} karışım, {df.shape[1] - 1} özellik sütunu; eksik süperakışkanlaştırıcı: "
      f"{df.super_akiskan.isna().sum()} satır (%{100 * df.super_akiskan.isna().mean():.1f})")
print(f"Dayanım {y.min():.1f}–{y.max():.1f} MPa (ortalama {y.mean():.1f}); çimento tipleri: "
      + ", ".join(f"{t.split()[0] + ' ' + t.split()[1].split('/')[0]} {k}"
                  for t, k in df.cimento_tipi.value_counts().items()))


# %% 2. Özellik mühendisliği: su/bağlayıcı oranı, yaş özelliği, log hedef
def ozellik_ekle(d):
    """Satır satır hesaplanan fiziksel özellikler (veriden parametre öğrenmez → sızıntı yok)."""
    d = d.copy()
    d["sb"] = d.su / (d.cimento + 0.6 * d.curuf + 0.4 * d.ucucu_kul)   # su / etkin bağlayıcı
    d["g_yas"] = 1 - np.sqrt(28 / d.yas_gun)                           # ln β_cc = s · g(t)
    d["g_x_II"] = d.g_yas * (d.cimento_tipi == TIP2)                   # tipe bağlı s için etkileşim
    d["g_x_III"] = d.g_yas * (d.cimento_tipi == TIP3)
    return d


dfo = ozellik_ekle(df)


def on_isleme(sayisal, kodlayici=None):
    """Sayısal: eksik doldur + standartlaştır; kategorik: one-hot (varsayılan)."""
    if kodlayici is None:
        kodlayici = OneHotEncoder(drop="first", sparse_output=False)
    sayisal_hat = Pipeline([("doldur", SimpleImputer(strategy="median")), ("olcek", StandardScaler())])
    return ColumnTransformer([
        ("sayisal", sayisal_hat, sayisal),
        ("kategorik", kodlayici, ["cimento_tipi"]),
    ])


def log_hedef(regresor):
    """Model log(dayanım)'ı öğrenir; tahminler exp ile MPa'ya geri döner."""
    return TransformedTargetRegressor(regressor=regresor, func=np.log, inverse_func=np.exp)


def polinom_hatti(regresor):
    """Fizik bilgisi olmadan: ham sayısal sütunların bütün 2. derece terimleri (90 özellik)."""
    return log_hedef(Pipeline([("on_isleme", on_isleme(HAM_SAYISAL)),
                               ("poly", PolynomialFeatures(2, include_bias=False)),
                               ("olcek2", StandardScaler()), ("reg", regresor)]))


MUH_B = ["sb", "g_yas", "super_akiskan"]
MUH_C = MUH_B + ["g_x_II", "g_x_III"]
alfa_izgara = np.logspace(-5, -1, 25)
modeller = {
    "(a) Ham sütunlar + one-hot, MPa": Pipeline([("on_isleme", on_isleme(HAM_SAYISAL)),
                                                  ("reg", LinearRegression())]),
    "(b) s/b, g(t), süperakışkanlaştırıcı + one-hot, log": log_hedef(Pipeline([("on_isleme", on_isleme(MUH_B)),
                                                                     ("reg", LinearRegression())])),
    "(c) (b) + tip × g(t) etkileşimi, log": log_hedef(Pipeline([("on_isleme", on_isleme(MUH_C)),
                                                               ("reg", LinearRegression())])),
    "(d) Ham 2. derece polinom, OLS": polinom_hatti(LinearRegression()),
    "(e) (d) + RidgeCV": polinom_hatti(RidgeCV(alphas=np.logspace(-3, 3, 25))),
    "(f) (d) + LassoCV": polinom_hatti(LassoCV(alphas=alfa_izgara, max_iter=20000)),
    "(g) (d) + ElasticNetCV (l1_ratio 0,5)": polinom_hatti(ElasticNetCV(l1_ratio=0.5, alphas=alfa_izgara,
                                                                         max_iter=20000)),
}
cv = KFold(n_splits=5, shuffle=True, random_state=42)
SKOR = {"MAE": "neg_mean_absolute_error", "RMSE": "neg_root_mean_squared_error", "R2": "r2"}
sonuc = {}
for ad, model in modeller.items():
    r = cross_validate(model, dfo, y, cv=cv, scoring=SKOR)
    sonuc[ad] = {m: (s * r[f"test_{m}"].mean(), r[f"test_{m}"].std())
                 for m, s in [("MAE", -1), ("RMSE", -1), ("R2", 1)]}
tahmin_a = cross_val_predict(modeller["(a) Ham sütunlar + one-hot, MPa"], dfo, y, cv=cv)
tahmin_c = cross_val_predict(modeller["(c) (b) + tip × g(t) etkileşimi, log"], dfo, y, cv=cv)
log_artik_c = np.log(y) - np.log(tahmin_c)
print("\n=== 2. Beş katlı çapraz doğrulama (ortalama ± std) ===")
print(f"{'model':51s}  {'MAE (MPa)':>11s}  {'RMSE (MPa)':>11s}  {'R²':>11s}")
for ad, s in sonuc.items():
    print(f"{ad:51s}  {s['MAE'][0]:5.2f}±{s['MAE'][1]:.2f}  {s['RMSE'][0]:6.2f}±{s['RMSE'][1]:.2f}  "
          f"{s['R2'][0]:.3f}±{s['R2'][1]:.3f}")
print(f"(c) modelinin log ölçekte artık std'si: {log_artik_c.std():.3f} (üreticideki saçılma: 0.07)")


def dilim_artik(tahmin):
    """Artık (gerçek − tahmin) ortalaması, tahminin altı eşit sayılı diliminde: eğrilik göstergesi."""
    sinir = np.quantile(tahmin, np.linspace(0, 1, 7))
    hangi = np.clip(np.searchsorted(sinir, tahmin, side="right") - 1, 0, 5)
    return np.array([np.mean((y - tahmin)[hangi == k]) for k in range(6)])


for ad, tahmin in [("(a)", tahmin_a), ("(c)", tahmin_c)]:
    print(f"{ad} artık ortalaması, tahminin 6 diliminde (küçükten büyüğe, MPa): "
          + " ".join(f"{v:+.2f}" for v in dilim_artik(tahmin)))
assert sonuc["(c) (b) + tip × g(t) etkileşimi, log"]["R2"][0] > sonuc["(a) Ham sütunlar + one-hot, MPa"]["R2"][0]

# %% 3. Geniş özellik kümesi: fizik + ham + ilgisiz sütunlar + kareler ve etkileşimler
d = dfo.copy()
# Not: kolaylık için doldurma ve standartlaştırma burada bütün veriyle yapılıyor. Bu, Pipeline'ın önlediği
# türden küçük bir sızıntıdır (bu veride etkisi ihmal edilebilir); dürüst CV için 2. bölümdeki hatlara bakın.
d["super_akiskan"] = d.super_akiskan.fillna(d.super_akiskan.median())
tip2, tip3 = (d.cimento_tipi == TIP2).astype(float), (d.cimento_tipi == TIP3).astype(float)
genis = pd.DataFrame({
    "s/b": d.sb, "g(t)": d.g_yas, "(s/b)²": d.sb**2, "g(t)²": d.g_yas**2, "s/b·g(t)": d.sb * d.g_yas,
    "CEM II": tip2, "CEM III": tip3, "CEM II·g(t)": d.g_x_II, "CEM III·g(t)": d.g_x_III,
    "süperakışkanlaştırıcı": d.super_akiskan, "çimento": d.cimento, "su": d.su, "cüruf": d.curuf,
    "uçucu kül": d.ucucu_kul, "iri agrega": d.iri_agrega, "ince agrega": d.ince_agrega,
    "kalıp no": d.kalip_no, "ortam sıcaklığı": d.ortam_sicakligi,
})
ILGISIZ = ["iri agrega", "ince agrega", "kalıp no", "ortam sıcaklığı"]
Xg = genis.to_numpy()
Xs = (Xg - Xg.mean(axis=0)) / Xg.std(axis=0)        # standartlaştırılmış (ortalama 0, std 1)
ly = np.log(y)
lyc = ly - ly.mean()                                 # merkezlenmiş hedef: sabit terim ayrı


# %% 4. Sıfırdan Ridge: kapalı biçim ve SVD büzülmesi
def ridge_kapali(X, y, alfa):
    """(XᵀX + αI) w = Xᵀy; X ve y merkezlenmiş varsayılır (sabit terim cezalanmaz)."""
    return np.linalg.solve(X.T @ X + alfa * np.eye(X.shape[1]), X.T @ y)


alfa_r = RidgeCV(alphas=np.logspace(-3, 3, 61)).fit(Xs, ly).alpha_
w_ridge = ridge_kapali(Xs, lyc, alfa_r)
w_ridge_skl = Ridge(alpha=alfa_r).fit(Xs, ly).coef_
assert np.allclose(w_ridge, w_ridge_skl, atol=1e-10)
U, dvals, Vt = np.linalg.svd(Xs, full_matrices=False)
buzulme = dvals**2 / (dvals**2 + alfa_r)                     # her temel yöndeki büzülme çarpanı
w_svd = Vt.T @ (buzulme / dvals * (U.T @ lyc))              # aynı çözüm, SVD ile
assert np.allclose(w_svd, w_ridge, atol=1e-10)
w_ols = np.linalg.lstsq(Xs, lyc, rcond=None)[0]


# %% 5. Sıfırdan Lasso: koordinat inişi ve yumuşak eşikleme
def yumusak_esik(a, t):
    return np.sign(a) * np.maximum(np.abs(a) - t, 0.0)


def lasso_koordinat(X, y, alfa, tol=1e-10, en_cok=20000):
    """min (1/2n)‖y − Xw‖² + α‖w‖₁ ; X standartlaştırılmış (‖x_j‖²/n = 1), y merkezlenmiş."""
    n, p = X.shape
    w, artik = np.zeros(p), y.copy()                 # artik = y − Xw
    for adim in range(1, en_cok + 1):
        en_buyuk_degisim = 0.0
        for j in range(p):
            eski = w[j]
            rho = X[:, j] @ artik / n + eski         # j. katsayı dışarıdayken korelasyon
            w[j] = yumusak_esik(rho, alfa)
            if w[j] != eski:
                artik -= X[:, j] * (w[j] - eski)
                en_buyuk_degisim = max(en_buyuk_degisim, abs(w[j] - eski))
        if en_buyuk_degisim < tol:
            return w, adim
    return w, en_cok


# %% 6. Lasso yolu, LassoCV ve bir-standart-hata kuralı
lasso_cv = LassoCV(alphas=np.logspace(-5, -0.5, 60), cv=cv, max_iter=50000).fit(Xs, ly)
mse_ort = lasso_cv.mse_path_.mean(axis=1)
mse_se = lasso_cv.mse_path_.std(axis=1) / np.sqrt(cv.get_n_splits())
i_min = mse_ort.argmin()
alfa_min = lasso_cv.alphas_[i_min]
alfa_1se = lasso_cv.alphas_[mse_ort <= mse_ort[i_min] + mse_se[i_min]].max()   # en sade iyi model
yol_alfa, yol_katsayi, _ = lasso_path(Xs, lyc, alphas=np.logspace(-5, -0.5, 80), max_iter=50000)
w_lasso, adim_kd = lasso_koordinat(Xs, lyc, alfa_1se)
w_lasso_skl = Lasso(alpha=alfa_1se, tol=1e-12, max_iter=100000).fit(Xs, ly).coef_
assert np.allclose(w_lasso, w_lasso_skl, atol=1e-6)
w_min = Lasso(alpha=alfa_min, max_iter=50000).fit(Xs, ly).coef_
ilgisiz_j = [list(genis.columns).index(c) for c in ILGISIZ]
secilen = [c for c, w in zip(genis.columns, w_lasso) if w != 0]

print("\n=== 3. Sıfırdan Ridge ve Lasso (18 standart özellik, hedef log f) ===")
print(f"Ridge, α = {alfa_r:.3g} (RidgeCV): kapalı biçim = scikit-learn = SVD çözümü "
      f"(en büyük fark {np.abs(w_ridge - w_ridge_skl).max():.1e})")
print(f"Tekil değerler d: {dvals.max():.1f} … {dvals.min():.3f}; büzülme çarpanı d²/(d²+α): "
      f"{buzulme.max():.3f} … {buzulme.min():.3f}; etkin serbestlik derecesi {buzulme.sum():.1f} / {len(dvals)}")
print(f"‖w‖: en küçük kareler {np.linalg.norm(w_ols):.2f}, Ridge {np.linalg.norm(w_ridge):.2f}")
print(f"Lasso koordinat inişi = scikit-learn: en büyük fark {np.abs(w_lasso - w_lasso_skl).max():.1e} "
      f"({adim_kd} tur)")

print("\n=== 4. Lasso yolu ve α seçimi ===")
print(f"LassoCV en küçük CV hatası: α = {alfa_min:.2e}, sıfır olmayan {np.sum(w_min != 0)}/18; "
      f"ilgisiz sütunların en büyük |katsayısı| {np.abs(w_min[ilgisiz_j]).max():.4f}")
print(f"Bir-standart-hata kuralı:   α = {alfa_1se:.2e}, sıfır olmayan {len(secilen)}/18; "
      f"ilgisiz sütunlar: {'hepsi sıfır' if np.all(w_lasso[ilgisiz_j] == 0) else 'sıfır değil'}")
secim_metni = [f"{c} {w:+.3f}" for c, w in zip(genis.columns, w_lasso) if w != 0]
print("Seçilenler: " + ", ".join(secim_metni[:4]) + ",")
print("            " + ", ".join(secim_metni[4:]))
giris = [(yol_alfa[np.abs(yol_katsayi[j]) > 0].max(), c) for j, c in enumerate(genis.columns)]
giris.sort(reverse=True)
print("Giriş sırası (ilk 7): " + ", ".join(c for _, c in giris[:7]) + f"; ilgisiz sütunlar en erken α = "
      f"{max(a for a, c in giris if c in ILGISIZ):.1e}'te")
sade_model = log_hedef(Pipeline([("olcek", StandardScaler()), ("reg", Lasso(alpha=alfa_1se, max_iter=50000))]))
r_1se = cross_validate(sade_model, genis, y, cv=cv, scoring=SKOR)
print(f"Bu sade modelin CV'si (MPa): RMSE {-r_1se['test_RMSE'].mean():.2f}, R² {r_1se['test_R2'].mean():.3f}")

# %% 7. Ölçekleme neden önemli: aynı Ridge cezası, ölçekli ve ölçeksiz
OLCEK_KUME = [c for c in genis.columns if c not in ("(s/b)²", "g(t)²", "s/b·g(t)")]   # kare/çarpım yok
print(f"\n=== 5. Ölçekleme: Ridge(α = 1), {len(OLCEK_KUME)} özellik, hedef log f ===")
olcek_sonuc = {}
for ad, adimlar in [("ölçeksiz", [("reg", Ridge(alpha=1.0))]),
                    ("StandardScaler ile", [("olcek", StandardScaler()), ("reg", Ridge(alpha=1.0))])]:
    model = log_hedef(Pipeline(adimlar))
    r = cross_validate(model, genis[OLCEK_KUME], y, cv=cv, scoring=SKOR)
    model.fit(genis[OLCEK_KUME], y)
    katsayi = model.regressor_.named_steps["reg"].coef_
    if "olcek" in model.regressor_.named_steps:
        katsayi = katsayi / model.regressor_.named_steps["olcek"].scale_     # özgün birimlere çevir
    olcek_sonuc[ad] = katsayi
    print(f"{ad:19s}: CV RMSE {-r['test_RMSE'].mean():.2f} MPa, R² {r['test_R2'].mean():.3f}; "
          f"s/b katsayısı {katsayi[OLCEK_KUME.index('s/b')]:+.3f}, "
          f"çimento katsayısı {katsayi[OLCEK_KUME.index('çimento')]:+.5f} 1/(kg/m³)")
print(f"Gerçek s/b etkisi (Abrams, log ölçek): −ln 7 = {-np.log(7):.3f}; standart sapmalar: "
      f"s/b {genis['s/b'].std():.3f}, çimento {genis['çimento'].std():.1f} kg/m³")

# %% 8. Kategorik kodlama: one-hot ve sıralı
print("\n=== 6. Çimento tipinin kodlanması, model (b) ===")
TIP1 = "CEM I 42,5 R"
for ad, kodlayici in [("one-hot (2 kukla sütun)", None),
                      ("sıralı 0-1-2 (I < II < III)", OrdinalEncoder(categories=[[TIP1, TIP2, TIP3]])),
                      ("sıralı, karışık sıra (II < I < III)", OrdinalEncoder(categories=[[TIP2, TIP1, TIP3]]))]:
    model = log_hedef(Pipeline([("on_isleme", on_isleme(MUH_B, kodlayici)), ("reg", LinearRegression())]))
    r = cross_validate(model, dfo, y, cv=cv, scoring=SKOR)
    print(f"{ad:35s}: RMSE {-r['test_RMSE'].mean():.2f} MPa, R² {r['test_R2'].mean():.3f}")


# %% 9. Grafikler
def tahmin_grafigi(ax, tahmin, renk, baslik):
    ax.scatter(y, tahmin, s=12, color=renk, alpha=.55)
    ax.plot([5, 70], [5, 70], color=MUREKKEP, ls="--", lw=1.2, label="Kusursuz tahmin")
    ax.set(xlim=(5, 70), ylim=(5, 70), xlabel="Gerçek dayanım (MPa)", ylabel="CV tahmini (MPa)", title=baslik)
    ax.set_aspect("equal")
    ax.legend(loc="upper left")


fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
sa, sc = sonuc["(a) Ham sütunlar + one-hot, MPa"], sonuc["(c) (b) + tip × g(t) etkileşimi, log"]
tahmin_grafigi(ax[0], tahmin_a, RENK[1],
               f"(a) Ham sütunlar: RMSE {sa['RMSE'][0]:.2f} MPa, R² {sa['R2'][0]:.3f}")
tahmin_grafigi(ax[1], tahmin_c, RENK[0],
               f"(c) Fiziksel özellikler: RMSE {sc['RMSE'][0]:.2f} MPa, R² {sc['R2'][0]:.3f}")
fig.savefig(KLASOR / "d04_duzenlilestirme_1.png", dpi=160)
plt.close(fig)

# L1 ve L2 kısıt bölgeleri: iki katsayılı bir en küçük kareler probleminin kontur çizgileri
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
A = np.array([[1.0, 0.6], [0.6, 1.0]])                   # kayıp eğriliği (ilişkili iki özellik)
w_hat = np.array([1.2, 0.25])                             # cezasız çözüm
g1, g2 = np.meshgrid(np.linspace(-1.6, 1.8, 300), np.linspace(-1.6, 1.8, 300))
G = np.stack([g1 - w_hat[0], g2 - w_hat[1]], axis=-1)
kayip = np.einsum("...i,ij,...j->...", G, A, G)
t_kisit = 0.8
aci = np.linspace(0, 2 * np.pi, 20001)                    # sınır üzerinde ince ızgara: kısıtlı çözüm
cozumler = {}
for eksen, ad in [(ax[0], "L2 (Ridge)"), (ax[1], "L1 (Lasso)")]:
    if ad.startswith("L2"):
        sinir = np.c_[t_kisit * np.cos(aci), t_kisit * np.sin(aci)]
    else:
        sinir = np.c_[t_kisit * np.sign(np.cos(aci)) * np.cos(aci)**2,     # |w1| + |w2| = t
                      t_kisit * np.sign(np.sin(aci)) * np.sin(aci)**2]
    deger = np.einsum("...i,ij,...j->...", sinir - w_hat, A, sinir - w_hat)
    w_kisitli = sinir[deger.argmin()]
    cozumler[ad] = w_kisitli
    seviye = deger.min() * np.array([0.1, 0.35, 1.0, 2.0])          # 1.0: kısıta değen kontur
    eksen.contour(g1, g2, kayip, levels=seviye, colors=SOLUK, linewidths=0.8)
    eksen.fill(sinir[:, 0], sinir[:, 1], color=RENK[0], alpha=0.18, lw=0)
    eksen.plot(sinir[:, 0], sinir[:, 1], color=RENK[0], lw=1.5, label=f"{ad} kısıt bölgesi")
    eksen.plot(*w_hat, "o", color=MUREKKEP, ms=6, label="Cezasız çözüm")
    eksen.plot(*w_kisitli, "*", color=RENK[1], ms=14,
               label=f"Kısıtlı çözüm ({w_kisitli[0]:.3f}, {w_kisitli[1]:.3f})")
    eksen.axhline(0, color=IKINCIL, lw=0.8)
    eksen.axvline(0, color=IKINCIL, lw=0.8)
    eksen.set(xlim=(-1.6, 1.8), ylim=(-1.6, 1.8), xlabel="$w_1$", ylabel="$w_2$",
              title=f"{ad}: kayıp konturları ve kısıt")
    eksen.set_aspect("equal")
    eksen.legend(loc="lower left", fontsize=8.5)
fig.savefig(KLASOR / "d04_duzenlilestirme_2.png", dpi=160)
plt.close(fig)
w2, w1 = cozumler["L2 (Ridge)"], cozumler["L1 (Lasso)"]
print(f"\nL1/L2 örneği (grafik 2): cezasız ({w_hat[0]:.2f}, {w_hat[1]:.2f}); "
      f"L2 kısıtlı ({w2[0]:.3f}, {w2[1]:.3f}), boy {np.linalg.norm(w2):.3f}; "
      f"L1 kısıtlı ({w1[0]:.3f}, {w1[1]:.3f})")

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
onemli = ["s/b", "g(t)", "CEM III·g(t)", "CEM III", "CEM II·g(t)", "süperakışkanlaştırıcı",
          "s/b·g(t)"]
for j, ad in enumerate(genis.columns):
    if ad in onemli:
        ax[0].plot(yol_alfa, yol_katsayi[j], color=RENK[onemli.index(ad)], lw=1.8, label=ad)
    elif ad in ILGISIZ:
        ax[0].plot(yol_alfa, yol_katsayi[j], color=MUREKKEP, lw=1.0, ls=":")
    else:
        ax[0].plot(yol_alfa, yol_katsayi[j], color=SOLUK, lw=0.8, alpha=.7)
ax[0].plot([], [], color=MUREKKEP, lw=1.0, ls=":", label="İlgisiz 4 sütun")
ax[0].plot([], [], color=SOLUK, lw=0.8, label="Diğer 7 özellik")
for a, ls in [(alfa_min, "--"), (alfa_1se, "-.")]:
    ax[0].axvline(a, color=IKINCIL, ls=ls, lw=1)
ax[0].set_xscale("log")
ax[0].set(xlabel="Lasso cezası α", ylabel="Standart katsayı (log f)",
          title="Lasso yolu: özellikler sırayla giriyor")
ax[0].set_ylim(-0.37, 0.175)                     # alt bant lejant için boş kalsın
ax[0].legend(loc="lower center", fontsize=8, ncol=3, frameon=True, facecolor="white", edgecolor="none",
             framealpha=1)
ax[1].errorbar(lasso_cv.alphas_, mse_ort, yerr=mse_se, color=RENK[0], ecolor=SOLUK, elinewidth=0.8, capsize=0,
               marker="o", ms=3, lw=1.5, label="CV hatası ± 1 standart hata")
ax[1].axvline(alfa_min, color=IKINCIL, ls="--", lw=1, label=f"En küçük CV hatası, α = {alfa_min:.1e}")
ax[1].axvline(alfa_1se, color=IKINCIL, ls="-.", lw=1, label=f"Bir-standart-hata kuralı, α = {alfa_1se:.1e}")
ax[1].set_xscale("log")
ax[1].set_yscale("log")
ax[1].set(xlabel="Lasso cezası α", ylabel="CV MSE (log f)²", title="LassoCV ile α seçimi")
ax[1].legend(loc="upper left", fontsize=8.5, frameon=True, facecolor="white", edgecolor="none", framealpha=1)
fig.savefig(KLASOR / "d04_duzenlilestirme_3.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d04_duzenlilestirme_1.png, _2.png, _3.png")=== 1. Veri ===
500 karışım, 11 özellik sütunu; eksik süperakışkanlaştırıcı: 30 satır (%6.0)
Dayanım 11.1–63.4 MPa (ortalama 36.6); çimento tipleri: CEM I 217, CEM II 188, CEM III 95
=== 2. Beş katlı çapraz doğrulama (ortalama ± std) ===
model MAE (MPa) RMSE (MPa) R²
(a) Ham sütunlar + one-hot, MPa 3.68±0.47 4.63±0.52 0.771±0.078
(b) s/b, g(t), süperakışkanlaştırıcı + one-hot, log 2.45±0.26 3.09±0.30 0.897±0.039
(c) (b) + tip × g(t) etkileşimi, log 2.12±0.26 2.73±0.32 0.920±0.029
(d) Ham 2. derece polinom, OLS 3.35±0.47 4.33±0.63 0.801±0.059
(e) (d) + RidgeCV 3.31±0.47 4.30±0.62 0.805±0.057
(f) (d) + LassoCV 3.14±0.23 3.97±0.31 0.835±0.042
(g) (d) + ElasticNetCV (l1_ratio 0,5) 3.14±0.21 3.98±0.29 0.834±0.041
(c) modelinin log ölçekte artık std'si: 0.073 (üreticideki saçılma: 0.07)
(a) artık ortalaması, tahminin 6 diliminde (küçükten büyüğe, MPa): -0.50 +0.81 +0.00 +0.05 +0.17 -0.52
(c) artık ortalaması, tahminin 6 diliminde (küçükten büyüğe, MPa): +0.01 +0.08 +0.37 +0.22 -0.07 -0.12
=== 3. Sıfırdan Ridge ve Lasso (18 standart özellik, hedef log f) ===
Ridge, α = 1.26 (RidgeCV): kapalı biçim = scikit-learn = SVD çözümü (en büyük fark 1.1e-14)
Tekil değerler d: 40.7 … 0.646; büzülme çarpanı d²/(d²+α): 0.999 … 0.249; etkin serbestlik derecesi 17.0 / 18
‖w‖: en küçük kareler 0.23, Ridge 0.21
Lasso koordinat inişi = scikit-learn: en büyük fark 1.9e-09 (323 tur)
=== 4. Lasso yolu ve α seçimi ===
LassoCV en küçük CV hatası: α = 1.37e-03, sıfır olmayan 16/18; ilgisiz sütunların en büyük |katsayısı| 0.0017
Bir-standart-hata kuralı: α = 7.91e-03, sıfır olmayan 7/18; ilgisiz sütunlar: hepsi sıfır
Seçilenler: s/b -0.196, g(t) +0.126, s/b·g(t) +0.016, CEM III -0.034,
CEM II·g(t) +0.027, CEM III·g(t) +0.065, süperakışkanlaştırıcı +0.015
Giriş sırası (ilk 7): s/b·g(t), s/b, CEM III·g(t), g(t), CEM III, CEM II·g(t), süperakışkanlaştırıcı; ilgisiz sütunlar en erken α = 3.2e-03'te
Bu sade modelin CV'si (MPa): RMSE 2.84, R² 0.914
=== 5. Ölçekleme: Ridge(α = 1), 15 özellik, hedef log f ===
ölçeksiz : CV RMSE 3.03 MPa, R² 0.903; s/b katsayısı -0.410, çimento katsayısı +0.00170 1/(kg/m³)
StandardScaler ile : CV RMSE 2.76 MPa, R² 0.919; s/b katsayısı -1.733, çimento katsayısı +0.00013 1/(kg/m³)
Gerçek s/b etkisi (Abrams, log ölçek): −ln 7 = -1.946; standart sapmalar: s/b 0.112, çimento 71.7 kg/m³
=== 6. Çimento tipinin kodlanması, model (b) ===
one-hot (2 kukla sütun) : RMSE 3.09 MPa, R² 0.897
sıralı 0-1-2 (I < II < III) : RMSE 3.18 MPa, R² 0.891
sıralı, karışık sıra (II < I < III): RMSE 3.52 MPa, R² 0.867
L1/L2 örneği (grafik 2): cezasız (1.20, 0.25); L2 kısıtlı (0.725, 0.338), boy 0.800; L1 kısıtlı (0.800, 0.000)
Grafikler kaydedildi: d04_duzenlilestirme_1.png, _2.png, _3.png11. Sonuçları yorumlayın
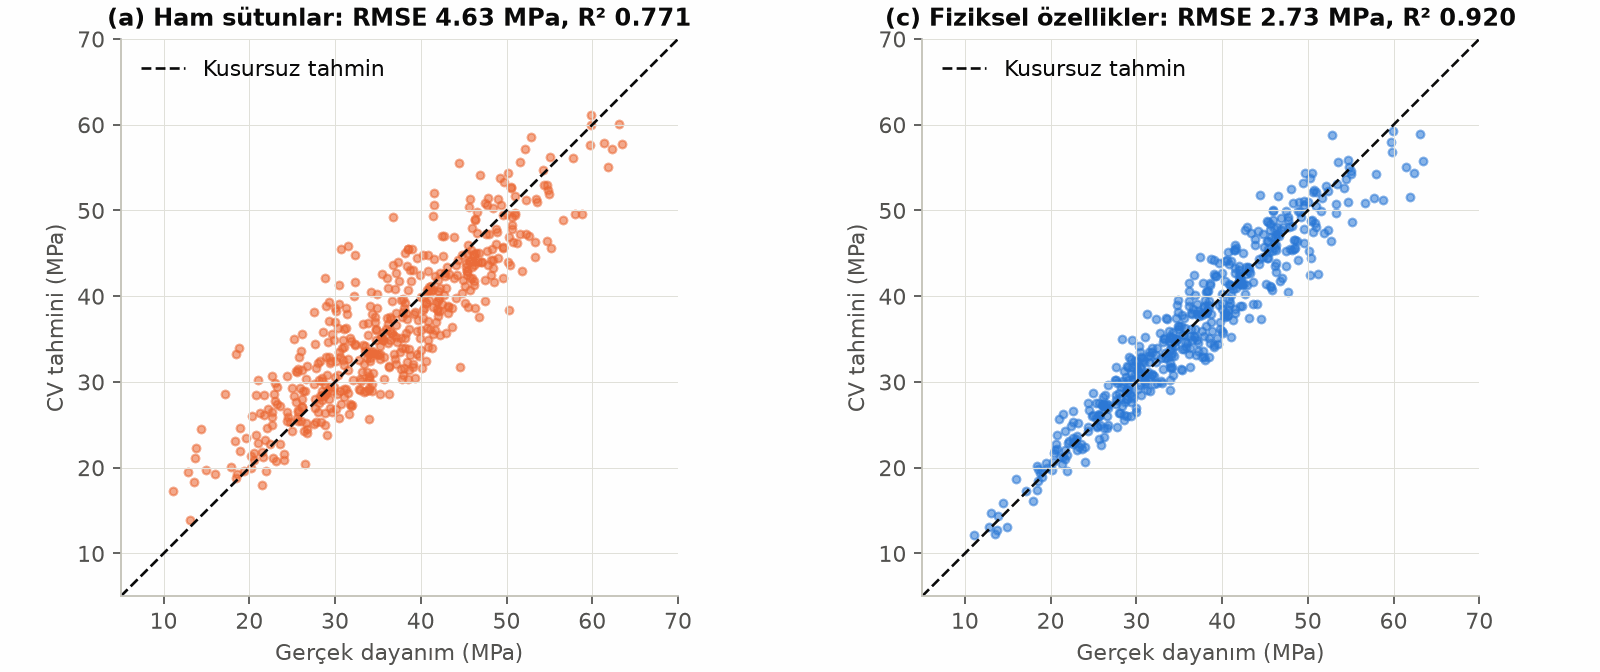
Soldaki bulut geniş. Artıkları tahmin edilen değere göre altı eşit dilime ayırınca bir kavis de görünüyor: dilim ortalamaları iki uçta −0,50 ve −0,52 MPa, ortada +0,81 MPa'ya kadar çıkıyor. Toplamsal bir doğrusal model, çarpımsal ve doygunlaşan bir yapıyı ancak ortalamada yakalayabiliyor. (c) modelinde aynı dilim ortalamaları ±0,4 MPa içinde ve uçlarda sistematik bir sapma yok. Sağdaki noktalar köşegene sıkıca oturuyor ve dağılım dayanımla birlikte orantılı genişliyor. Bu, log-normal saçılmanın beklenen görüntüsü: %7'lik saçılma 20 MPa'da 1,4 MPa, 60 MPa'da 4,2 MPa demek.
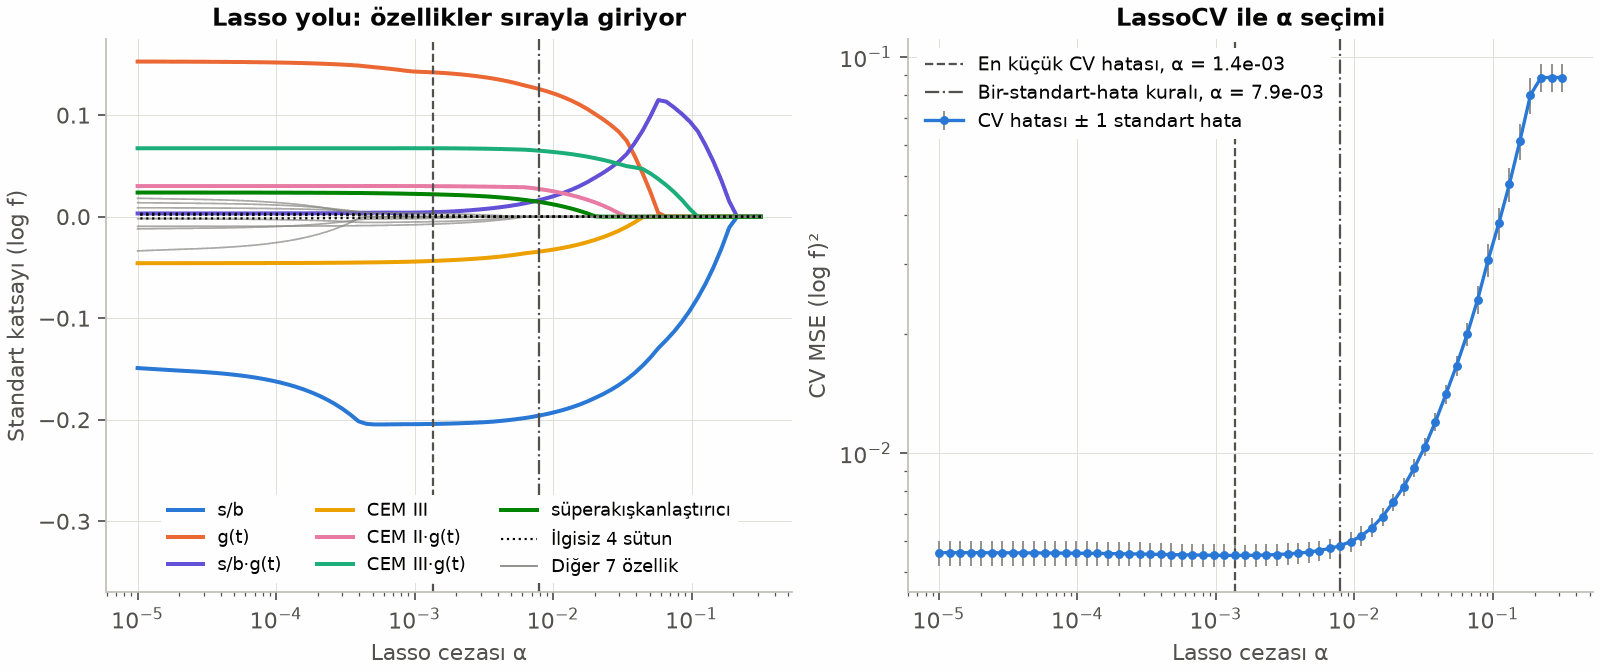
LassoCV'nin CV hatası ve bir standart hatalık çubuklar.Sağdaki CV eğrisi, küçük $\alpha$'larda geniş ve düz bir taban çiziyor. Bu tabanın her yerindeki modeller, hata çubukları içinde aynı derecede iyi. En küçük noktayı seçmek bu gürültüye fazla anlam yüklemek olur. Bir-standart-hata kuralı aynı başarıyı çok daha sade bir modelle veriyor. Soldaki yolda s/b'nin katsayısı küçük $\alpha$'larda yeniden küçülüyor; çünkü ceza zayıfladıkça (s/b)², su ve çimento gibi ilişkili sütunlar aynı bilgiyi paylaşmaya başlıyor. Ceza büyüdükçe $\alpha \approx 0{,}06$ civarında s/b·$g(t)$ (mor) geçici olarak $g(t)$'nin rolünü üstleniyor.
12. Sık yapılan hatalar
- Ölçeklemeden ceza uygulamak. Ceza birimlere göre dağılır; 7. bölümdeki gibi hem tahmin kötüleşir hem katsayılar yanlış yorumlanır.
- Ön işlemeyi bütün veriye bir kez uygulayıp sonra çapraz doğrulama yapmak. Doldurma, ölçekleme ve kodlama da modelin parçasıdır;
Pipelineiçinde olmalıdır. - Lasso'nun sıfırladığı özelliği etkisiz saymak. İlişkili özelliklerden biri seçilir, diğerleri sıfırlanır. Seçim nedensellik değildir.
- Sırasız kategorileri 0, 1, 2 diye kodlamak. Doğrusal model bu sayılara bir sıra ve eşit aralık anlamı yükler.
- Kendi Ridge veya Lasso kodunuzda sabit terimi cezalandırmak. Önce merkezleyin; sabit terimi ayrıca, ortalamadan bulun.
- Eksik bilgiyi cezayla kapatmaya çalışmak. 90 özellikli en iyi cezalı model R² = 0,835'te kaldı; yedi anlamlı özellik 0,920'ye ulaştı. Önce fizik, sonra ceza.
13. Alıştırmalar
Alıştırma 1KolayCezayı on katına çıkarın
Geniş özellik kümesinde Lasso'yu $\alpha = 10 \times 7{,}91\times10^{-3}$ ile eğitin. Hangi özellikler kalıyor? Sonucu “Lasso'nun seçimi nedensellik değildir” notuyla birlikte yorumlayın.
Çözümü göster
w10 = Lasso(alpha=10 * alfa_1se, max_iter=100000).fit(Xs, ly).coef_Yalnız üç özellik kalıyor: s/b −0,109, s/b·$g(t)$ +0,105 ve CEM III·$g(t)$ +0,021. $g(t)$'nin kendisi sıfırlanmış; yaşın etkisini s/b·$g(t)$ çarpımı taşıyor. Güçlü cezada Lasso, iki bilgiyi tek bir sütunda toplayan bu çarpımı “ucuz” buluyor. Fiziksel olarak doğru model $g(t)$'yi tek başına içerir; Lasso'nun seçimini “yaş etkisi yalnız s/b ile birlikte vardır” diye okumak yanlış olur.
Alıştırma 2KolayEksiklik göstergesi
(c) modelindeki SimpleImputer'a add_indicator=True ekleyin. Bu, “süperakışkanlaştırıcı bu satırda eksikti” anlamına gelen ek bir 0/1 sütunu yaratır. CV sonucu değişiyor mu? Neden?
Çözümü göster
Değişmiyor: RMSE iki durumda da 2,727 MPa, R² 0,9204'ten 0,9200'e iniyor. Bu üreticide hücreler tamamen rastgele silindi; eksik olmak, dayanım hakkında hiçbir şey söylemiyor. Gerçek tablolarda durum farklı olabilir: “katkı kullanılmadığı için boş bırakılmış” hücrelerde eksiklik bilgi taşır ve gösterge işe yarar. Burada medyanla doldurmanın da bir zaafı var: medyan 3,61 kg/m³, oysa satırların yüzde 38,4'ünde süperakışkanlaştırıcı hiç yok. Eksikliğin nedenini bilmek, doldurma yönteminden daha önemlidir.
Alıştırma 3OrtaRidge, kılık değiştirmiş en küçük karelerdir
$X$'in altına $\sqrt{\alpha}\,I$ satırlarını, $\vect y$'nin altına aynı sayıda sıfır ekleyin. Bu genişletilmiş problemin sıradan en küçük kareler çözümünün Ridge çözümüyle aynı olduğunu gösterin ve sayısal olarak doğrulayın.
Çözümü göster
Genişletilmiş problemin kaybı iki bloğun toplamıdır:
$$ \begin{aligned} & \left\lVert \begin{bmatrix}\vect y\\ \vect 0\end{bmatrix} - \begin{bmatrix}X\\ \sqrt{\alpha}\,I\end{bmatrix}\vect w \right\rVert^2 \\ & \qquad = \lVert\vect y - X\vect w\rVert^2 + \alpha\lVert\vect w\rVert^2 \end{aligned} $$Xa = np.vstack([Xs, np.sqrt(alfa_r) * np.eye(Xs.shape[1])])
ya = np.r_[lyc, np.zeros(Xs.shape[1])]
wa = np.linalg.lstsq(Xa, ya, rcond=None)[0] # Ridge çözümüyle fark ≈ 4e-15Fark $4\times10^{-15}$ mertebesinde. Yorum: Ridge, her katsayı için “bu katsayı sıfır olmalı” diyen $\sqrt\alpha$ ağırlıklı sahte birer gözlem eklemek gibidir. $\alpha$ büyüdükçe bu sahte gözlemler gerçek veriye baskın çıkar. Genişletilmiş matris her zaman tam sütun ranklıdır; Ridge'in her zaman çözülebilmesinin bir başka açıklaması budur.
Alıştırma 4OrtaCezanın ima ettiği önsel
scikit-learn'ün Ridge kaybı $\lVert\vect y - X\vect w\rVert^2 + \alpha\lVert\vect w\rVert^2$'dir. Gürültü $\mathcal N(0, \sigma^2)$ ve önsel $w_j \sim \mathcal N(0, \tau^2)$ ise $\alpha = \sigma^2/\tau^2$ olduğunu gösterin. (c) modelinin log ölçekteki artık standart sapmasını $\sigma$ alarak, RidgeCV'nin seçtiği $\alpha = 1{,}26$'nın ima ettiği $\tau$'yu hesaplayın ve Ridge katsayılarıyla karşılaştırın.
Çözümü göster
Negatif log sonsal, sabitler dışında $\lVert\vect y - X\vect w\rVert^2/(2\sigma^2) + \lVert\vect w\rVert^2/(2\tau^2)$'dir. $2\sigma^2$ ile çarpınca Ridge kaybı çıkar ve $\alpha = \sigma^2/\tau^2$ olur. $\sigma = 0{,}073$ ile $\tau = 0{,}073/\sqrt{1{,}26} \approx 0{,}065$. Yani ceza, her standart katsayının önsel olarak ±0,13 (iki standart sapma) civarında kalmasını bekliyor. Ridge katsayılarının mutlak değerlerinin medyanı 0,022, en büyüğü 0,144. Önsel, katsayıların neredeyse hepsine rahat yer bırakıyor; bu yüzden büzülme hafif kaldı.
Alıştırma 5ZorYaşta dış değer
(a) ve (c) modellerini yalnız 28 gün ve daha genç numunelerle eğitin (385 satır). 56 ve 90 günlük numuneleri (115 satır) tahmin edin ve her yaş için RMSE'yi ve ortalama hatayı (tahmin − gerçek) hesaplayın. Sonucu modellerin yaşı nasıl gördüğüyle açıklayın.
Çözümü göster
egit = dfo.yas_gun <= 28
for ad in ["(a) Ham sütunlar + one-hot, MPa", "(c) (b) + tip × g(t) etkileşimi, log"]:
    m = modeller[ad].fit(dfo[egit], y[egit])
    tahmin = m.predict(dfo[~egit])
(a) modeli 56 günde RMSE 12,08 MPa (ortalama hata +11,52), 90 günde 26,21 MPa (+25,81) veriyor; dayanımı sistematik olarak çok fazla tahmin ediyor. (c) modeli ise 2,77 ve 3,69 MPa (ortalama hata −0,55 ve −0,83). (b) modeli arada: 3,56 ve 4,28 MPa.
(a) modeli yaşı gün olarak, doğrusal bir terim hâlinde görür. 3–28 gün arasındaki hızlı dayanım kazanımını bir eğim olarak öğrenir ve bu eğimi 90 güne kadar uzatır. (c) modeli ise yaşı $g(t)$ üzerinden görür. $g(t)$ büyüyen $t$ için 1'e yaklaşır, $\beta_{cc}$ de $e^{s}$'ye; dayanım kazanımı doğru biçimde yavaşlar. Fizikten gelen özellik, eğitim aralığının dışında da doğru biçimi taşır. (c)'nin 90 gündeki 3,69 MPa'lık RMSE'sinin büyük kısmı saçılmadır: %7'lik log-normal saçılma bu yaştaki dayanımlarda yaklaşık 3,2 MPa eder (0.07 * np.sqrt(np.mean(y[dfo.yas_gun == 90] ** 2))). Dış değerin asıl izi, −0,83 MPa'lık sistematik sapmadır.
Özet
- Fizikten gelen birkaç anlamlı özellik (s/b, $g(t)$, etkileşimler, log hedef) modeli gürültü tabanına taşıdı: R² 0,771'den 0,920'ye.
- Ridge her zaman çözülebilir; katsayıları SVD yönlerinde farklı oranlarda, en çok küçük tekil değerli yönlerde küçültür. Lasso yumuşak eşiklemeyle katsayıları tam sıfıra indirir.
- Cezanın şiddeti çapraz doğrulamayla seçilir; bir-standart-hata kuralı, aynı başarıda daha sade bir model verir.
- Cezalı modellerde ölçekleme şarttır. Doldurma, ölçekleme ve kodlama bir
Pipelineiçinde, her katta yeniden öğrenilmelidir. - Sırasız kategorilerde one-hot kodlama kullanın. Boyutsuz ve fiziksel özellikler, eğitim aralığının dışında da daha güvenilirdir.
Sıradaki Proje 1'de polinom derecesini doğrulama verisiyle seçerek (Ridge cezası sabit, $\alpha$ = 0,1) sıcaklık–nem ilişkisini modelleyecek, ardından Ders 05'te bir sayı yerine bir olasılık tahmin edeceksiniz.
Kaynaklar
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 3.4 (Ridge, Lasso, büzülme) ve 7.10 (bir-standart-hata kuralı).
- A. E. Hoerl, R. W. Kennard (1970) — Ridge regression: biased estimation for nonorthogonal problems, Technometrics 12(1), 55–67.
- R. Tibshirani (1996) — Regression shrinkage and selection via the lasso, Journal of the Royal Statistical Society B 58(1), 267–288.
- H. Zou, T. Hastie (2005) — Regularization and variable selection via the elastic net, Journal of the Royal Statistical Society B 67(2), 301–320.
- scikit-learn — Linear Models ve Pipelines and composite estimators belgeleri.