Bu derste öğrenecekleriniz
- Lojistik modeli olasılık, bahis oranı (odds) ve sigmoid üzerinden yazmak
- Bernoulli olabilirliğinden ikili çapraz entropiyi ve gradyanını türetmek; gradyan inişini sıfırdan yazmak
- Özellik mühendisliğiyle doğrusal bir modele eğri bir karar sınırı öğretmek
- Karışıklık matrisi, kesinlik, duyarlılık, F1, ROC–AUC, PR eğrisi ve log-kaybı yorumlamak
- Karar eşiğini hata maliyetlerine göre seçmek ve sınıf dengesizliğini ele almak
1. Problem: kolon burkulur mu?
Eksenel basınç taşıyan bir çelik kolon için sorulan temel soru evet ya da hayır cevaplıdır: kolon bu yükü burkulmadan taşır mı? Mühendislikte bu sorunun cevabı yönetmeliğin dayanım formülünden gelir. Bu derste aynı soruyu veriden öğrenen bir sınıflandırıcı kuracağız. Amaç formülün yerine geçmek değil. Cevabını bildiğimiz bir problem üzerinde sınıflandırmanın kavramlarını (olasılık, karar sınırı, hata türleri, eşik) ölçülebilir biçimde görmek istiyoruz.
EN 1993-1-1:2005 (madde 6.3.1.2), eksenel basınç altındaki bir elemanın eğilmeli burkulma dayanımını, kesitin plastik dayanımını bir azaltma katsayısıyla çarparak verir: $N_{b,Rd} = \chi A f_y/\gamma_{M1}$. Azaltma katsayısı $\chi$, boyutsuz narinlik $\bar\lambda$'ya bağlıdır:
$$ \Phi = 0{,}5\,\big[1 + \alpha(\bar\lambda - 0{,}2) + \bar\lambda^2\big] $$ $$ \chi = \frac{1}{\Phi + \sqrt{\Phi^2 - \bar\lambda^2}} \le 1 $$$\alpha$ kusur katsayısıdır. Hangi burkulma eğrisinin kullanılacağı kesit tipine, üretim biçimine ve burkulma eksenine bağlıdır; biz eğri b'yi ($\alpha = 0{,}34$) kullanıyoruz. Kodun ilk satırları formülü denetler: $\bar\lambda$ = 0,5; 1,0 ve 2,0 için $\chi$ = 0,8842; 0,5970 ve 0,2095 çıkıyor. Bunlar tasarım kılavuzlarındaki eğri b tablolarıyla aynı değerlerdir.
Kullanım oranını $n = N_{Ed}/(A f_y)$ diye tanımlayalım. Kısmi güvenlik katsayısını bir kenara bırakırsak kolonun yeterli olması için $n \le \chi(\bar\lambda)$ gerekir. $(\bar\lambda, n)$ düzleminde bu sınır, narinlik arttıkça hızla alçalan eğri bir çizgidir.
Sentetik “deney” verisi
Gerçek kolonlar bu eğriye tam oturmaz: akma dayanımı, başlangıç eğriliği ve artık gerilmeler kolondan kolona değişir. Bunu kabaca temsil etmek için her sanal kolona bir dayanım saçılım katsayısı $R$ verdik ve deneyin sonucunu şöyle tanımladık:
$$ y = 1 \iff n > \chi(\bar\lambda)\,R $$$y = 1$ “yetersiz” (kolon burkuldu), $y = 0$ “yeterli” demektir. $R$ lognormal dağılımlıdır: ortancası 1, $\ln R$'nin standart sapması 0,10, yani yaklaşık yüzde 10 değişkenlik. Narinlik $[0{,}2;\ 2{,}5]$, kullanım oranı $[0{,}05;\ 1{,}2]$ aralığından düzgün dağılımla çekildi. 600 sanal kolonun yüzde 63,7'si yetersiz çıktı. Verinin yüzde 70'ini (420 kolon) eğitime, yüzde 30'unu (180 kolon) teste ayırdık. İki kümede sınıf oranları aynı kalsın diye bölmeyi tabakalı (stratified) yaptık.
Bu veri neyi temsil etmez?
$R$'nin dağılımı ve parametreleri bizim varsayımımızdır. Burkulma eğrileri deneylerden ve sayısal analizlerden güvenli tarafta kalacak biçimde türetilmiştir; gerçek deneylerin çoğu eğrinin üzerinde kalır ve saçılım kesit tipine göre değişir. Tasarımda ise kısmi güvenlik katsayısı $\gamma_{M1}$ ile $N_{Ed} \le N_{b,Rd}$ kontrolü yapılır. Bu derste kurduğumuz modeller bir tasarım aracı değildir. Veriyi üreten kuralı bildiğimiz için, modelin neyi öğrendiğini ve nerede yanıldığını tam olarak görebiliyoruz; dersin değeri buradan gelir.
2. Olasılık modeli: sigmoid ve bahis oranı
Sınıflandırmada hedef 0 ya da 1'dir. Doğrusal regresyonu doğrudan bu hedefe uydurmak iki sorun doğurur: tahminler $[0, 1]$ aralığının dışına taşar ve sınırdan çok uzaktaki noktalar doğruyu kendine çeker. Bunun yerine modelin bir olasılık tahmin etmesini isteriz:
$$ P(y = 1 \mid \vect x) = \sigma(\vect w^\top \vect x + b) $$$\sigma$, sigmoid (lojistik) fonksiyondur ve her gerçel sayıyı $(0, 1)$ aralığına taşır:
$$ \sigma(t) = \frac{1}{1 + e^{-t}} $$$t = 0$ için $\sigma = 0{,}5$'tir; $t$ büyüdükçe 1'e, küçüldükçe 0'a yaklaşır. Doğrusal kısım $t = \vect w^\top\vect x + b$'ye logit denir.
Modelin neyi doğrusal varsaydığını görmek için olasılığı bahis oranına (odds) çevirelim: $p/(1-p)$. Olasılık 0,8 ise bahis oranı 4'tür; olay, olmamasından dört kat daha olasıdır. Sigmoidi ters çevirince şunu buluruz:
$$ \ln\frac{p}{1-p} = \vect w^\top\vect x + b $$Lojistik regresyon, bahis oranının logaritmasını özelliklerin doğrusal bir fonksiyonu olarak modeller. Bu yorum katsayıları anlamlı kılar: diğer özellikler sabitken $x_j$ bir birim artınca bahis oranı $e^{w_j}$ katına çıkar.
Karar vermek için bir eşik gerekir. Varsayılan eşik 0,5'tir: $p \ge 0{,}5$ ise “yetersiz” deriz. $p = 0{,}5$ ancak $\vect w^\top\vect x + b = 0$ olduğunda sağlanır. Bu bir hiperdüzlemdir; iki özellikte bir doğrudur. Yani lojistik regresyonun karar sınırı (decision boundary), kullandığı özelliklerde doğrusaldır. Bizim gerçek sınırımız $n = \chi(\bar\lambda)$ ise eğri. Bu gerilimi 6. bölümde çözeceğiz.
3. Kayıp fonksiyonu: olabilirlikten çapraz entropiye
Model her örnek için bir olasılık $p_i$ veriyor. Gözlenen sonucun bu modele göre olasılığı Bernoulli dağılımıyla yazılır:
$$ P(y_i \mid \vect x_i) = p_i^{\,y_i}\,(1 - p_i)^{\,1 - y_i} $$$y_i = 1$ ise bu ifade $p_i$'ye, $y_i = 0$ ise $1 - p_i$'ye eşittir. Örnekler bağımsızsa bütün verinin olabilirliği bu terimlerin çarpımıdır. Çarpımın logaritmasını alıp işaretini değiştirirsek her örnek için bir kayıp terimi elde ederiz:
$$ \begin{aligned} \ell_i = -\big[\,&y_i \ln p_i \\ &+ (1 - y_i)\ln(1 - p_i)\,\big] \end{aligned} $$Toplam kayıp bu terimlerin ortalamasıdır. Bu derste örnek sayısını $m$ ile gösteriyoruz; $n$ harfi kullanım oranına ayrıldı:
$$ L(\vect w) = \frac{1}{m}\sum_{i=1}^{m} \ell_i $$Bu kayba ikili çapraz entropi (binary cross-entropy) denir; test verisinde hesaplandığında aynı büyüklüğe log-kayıp (log-loss) diyeceğiz. Olabilirliği en büyüklemek ile çapraz entropiyi en küçüklemek aynı iştir. Ders 02'de normal dağılımlı gürültü varsayımının MSE'ye götürdüğünü görmüştük (türetmesi Hazırlık 2'de); burada Bernoulli varsayımı çapraz entropiye götürüyor.
Bu kayıp, emin olunan yanlışları çok ağır cezalandırır. Gerçekte yetersiz olan bir kolona $p = 0{,}01$ verirsek bu örneğin kaybı $-\ln 0{,}01 \approx 4{,}6$'dır; $p = 0{,}5$ verseydik $0{,}69$ olurdu. Model gerektiğinde “emin değilim” demeyi öğrenir, ama “kesinlikle değil” deyip yanılmaktan kaçınır.
Gradyan ve Hessyen
Kesişimi, $\vect x_i$'ye eklenen bir 1 ile $\vect w$'nin içine alalım: $t_i = \vect w^\top\vect x_i$, $p_i = \sigma(t_i)$. $\ln p_i = -\ln(1 + e^{-t_i})$ ve $\ln(1 - p_i) = -\ln(1 + e^{t_i})$ eşitliklerini kullanınca tek bir örneğin kaybı $\ell_i$ daha kısa bir biçim alır:
$$ \ell_i = \ln\big(1 + e^{t_i}\big) - y_i\,t_i $$Logite göre türev:
$$ \frac{\partial \ell_i}{\partial t_i} = \frac{e^{t_i}}{1 + e^{t_i}} - y_i = p_i - y_i $$$\partial t_i/\partial\vect w = \vect x_i$ olduğundan, örneklerin ortalaması gradyanı verir:
$$ \nabla L(\vect w) = \frac{1}{m}\,X^\top(\vect p - \vect y) $$Ders 02'deki MSE gradyanı (orada örnek sayısı $n$ idi) $\frac{2}{m}X^\top(X\vect w - \vect y)$ biçimindeydi. Biçim aynıdır: $X^\top$ çarpı (tahmin − gerçek). Tek fark, tahminin artık $\vect p = \sigma(X\vect w)$ olmasıdır.
Bir kez daha türev almak için sigmoidin türevi gerekir: $\sigma'(t) = \sigma(t)\,\big(1 - \sigma(t)\big)$. Buradan Hessyen $H = \frac{1}{m}X^\top S X$ çıkar; $S$, köşegeninde $p_i(1 - p_i)$ bulunan köşegen matristir. Her $\vect v$ için $z_i = \vect x_i^\top\vect v$ dersek
$$ \vect v^\top H\vect v = \frac1m\sum_i p_i(1-p_i)\,z_i^2 \ge 0 $$olduğundan kayıp dışbükeydir: yerel minimum tuzağı yoktur. Ayrıca $p_i(1 - p_i) \le 1/4$ olduğu için eğrilik hiçbir yerde $X^\top X/(4m)$'yi aşamaz.
Kodda kaybı yukarıdaki $\ln(1 + e^{t}) - y\,t$ biçiminde, np.logaddexp(0, t) ile hesaplıyoruz. $p$ 0'a ya da 1'e çok yaklaştığında $\ln p$ terimi sayısal olarak taşabilir; bu biçim taşmaz.
4. Sıfırdan gradyan inişi ve scikit-learn
Lojistik regresyonun normal denklemler gibi kapalı bir çözümü yoktur: $\nabla L = 0$ denklemi $\vect w$'de doğrusal değildir. Bu yüzden yinelemeli bir yöntem gerekir. En basiti Ders 02'deki gradyan inişidir ve değişen tek satır tahminin hesaplandığı satırdır.
def sigmoid(t):
    return 1.0 / (1.0 + np.exp(-t))

def lojistik_gd(A, y, ogrenme_hizi, adim):
    w = np.zeros(A.shape[1])
    for _ in range(adim):
        p = sigmoid(A @ w)
        w -= ogrenme_hizi * A.T @ (p - y) / len(y)    # ∇L = Xᵀ(p − y)/m, m = örnek sayısı
    return w
A tasarım matrisidir: standartlaştırılmış $\bar\lambda$ ve $n$ sütunlarına birlerden oluşan bir sütun ekledik. Öğrenme hızını yine eğrilik belirler. Türetme kutusundaki üst sınırın en büyük özdeğeri bizim verimizde 0,252'dir; Ders 02'deki kararlılık kuralı buradan $\eta < 2/\lambda_{\max} \approx 7{,}95$ sınırını verir. Biz $\eta = 4$ seçtik.
5.000 adımdan sonra katsayılar $\vect w = [6{,}6637;\ 8{,}0927]$, $b = 3{,}7263$, eğitim kaybı 0,10328 oluyor. scikit-learn'ün LogisticRegression sınıfı aynı sonuca lbfgs çözücüsüyle 17 iterasyonda ulaşıyor; iki çözüm arasındaki en büyük katsayı farkı $1{,}8\times10^{-5}$. lbfgs, gradyanların geçmişinden eğriliği tahmin eden yarı-Newton bir yöntemdir. Düz gradyan inişinin binlerce adımda yaptığını birkaç düzine adımda yapar.
scikit-learn varsayılan olarak düzenlileştirir
LogisticRegression kayba kendiliğinden bir L2 cezası ekler. Gücünü C parametresi belirler; varsayılan C=1'dir ve küçük C güçlü ceza demektir. Sıfırdan yazdığımız cezasız gradyan inişiyle karşılaştırmak için C=1e6 verdik; kursun kullandığı scikit-learn 1.9 sürümünde C=np.inf tamamen cezasız bir model verir. Ceza özelliklerin ölçeğine bağlı olduğu için lojistik regresyonda da özellikleri standartlaştırmak iyi bir alışkanlıktır (Ders 04).
Standartlaştırılmış katsayıları ham birimlere geri çevirince (Ders 02'deki dönüşümün aynısı) ham özelliklerle kurulan modelin karar sınırı açık bir doğru olarak çıkıyor: $n = 1{,}038 - 0{,}425\,\bar\lambda$. Bu doğrunun $\chi$ eğrisiyle karşılaştırması bir sonraki adım.
5. Çalıştırılabilir kod
Kod yedi bölümden oluşur: veri üretimi, sıfırdan gradyan inişi, üç özellik kümesinin karşılaştırılması, sınıflandırma ölçütleri, maliyete göre eşik seçimi, sınıf dengesizliği ve grafikler. # %% işaretleri her bölümü ayrı bir hücre olarak çalıştırmanızı sağlar. Kurulum için Ders 01'deki adımları izleyin.
"""Ders 05 — Lojistik regresyon ve sınıflandırma ölçütleri.

Çelik bir kolonun eğilmeli burkulmasını sınıflandırma problemi olarak kuruyoruz. Girdiler boyutsuz
narinlik λ̄ ve kullanım oranı n = N_Ed/(A·f_y); çıktı "yetersiz" (1) ya da "yeterli" (0).

Veri sentetiktir. Azaltma katsayısı χ(λ̄), EN 1993-1-1 §6.3.1.2'deki formülle burkulma eğrisi b
(α = 0.34) için hesaplanır. Sanal "deney sonucu", n > χ(λ̄)·R ise yetersizdir. R, ortancası 1 ve
logaritmik standart sapması 0.10 olan lognormal bir dayanım saçılımıdır. Bu bir varsayımdır;
gerçek kolon deneylerindeki saçılımı tam temsil etmez. Tasarımda yönetmelik kontrolü kullanılır,
bu model değil: amaç sınıflandırmayı öğrenmektir.

Çalıştır:  python d05_lojistik_regresyon.py
Gerekenler: numpy, scipy, scikit-learn, matplotlib  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre üç PNG grafiği
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D
from scipy.stats import norm
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (accuracy_score, average_precision_score, brier_score_loss, confusion_matrix,
                             f1_score, log_loss, precision_recall_curve, precision_score, recall_score,
                             roc_auc_score, roc_curve)
from sklearn.model_selection import StratifiedKFold, cross_val_predict, train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent


def chi(lam, alfa=0.34):
    """EN 1993-1-1 azaltma katsayısı: Φ = 0.5[1 + α(λ̄ − 0.2) + λ̄²], χ = 1/(Φ + √(Φ² − λ̄²)) ≤ 1."""
    phi = 0.5 * (1 + alfa * (lam - 0.2) + lam**2)
    return np.minimum(1.0, 1.0 / (phi + np.sqrt(phi**2 - lam**2)))


def sigmoid(t):
    return 1.0 / (1.0 + np.exp(-t))


# %% 1. Veri: sanal kolon deneyleri
rng = np.random.default_rng(42)
N = 600
SIGMA_R = 0.10                                   # ln R'nin standart sapması (varsayım)
lam = rng.uniform(0.2, 2.5, N)                   # boyutsuz narinlik λ̄
n = rng.uniform(0.05, 1.2, N)                    # kullanım oranı N_Ed/(A·f_y)
R = rng.lognormal(0.0, SIGMA_R, N)               # dayanım saçılımı, ortanca 1
y = (n > chi(lam) * R).astype(int)               # 1 = yetersiz (burkuldu), 0 = yeterli
X = np.column_stack([lam, n])
X_eg, X_te, y_eg, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)
u_eg = X_eg[:, 1] / chi(X_eg[:, 0])              # fizik özelliği u = n/χ(λ̄)
u_te = X_te[:, 1] / chi(X_te[:, 0])
print("=== 1. Veri ===")
print(f"Örnek: {N} (eğitim {len(y_eg)}, test {len(y_te)}), yetersiz oranı: {y.mean():.3f}")
print("χ kontrolü (eğri b): " + ", ".join(f"λ̄={v:.1f} → {chi(v):.4f}" for v in (0.5, 1.0, 2.0, 2.5)))

# %% 2. Sıfırdan gradyan inişi ve scikit-learn (ham özellikler λ̄, n; standartlaştırılmış)
ort, ss = X_eg.mean(axis=0), X_eg.std(axis=0)
A = np.column_stack([(X_eg - ort) / ss, np.ones(len(y_eg))])   # son sütun: kesişim için birler


def bce(w, A, y):
    """Ortalama ikili çapraz entropi; log(1 + e^t) − y·t biçimi taşmaya karşı kararlıdır."""
    t = A @ w
    return np.mean(np.logaddexp(0.0, t) - y * t)


def lojistik_gd(A, y, ogrenme_hizi, adim):
    w = np.zeros(A.shape[1])
    for _ in range(adim):
        p = sigmoid(A @ w)
        w -= ogrenme_hizi * A.T @ (p - y) / len(y)    # ∇L = Xᵀ(p − y)/m, m = örnek sayısı
    return w


L_egrilik = np.linalg.eigvalsh(A.T @ A / len(y_eg)).max() / 4   # Hessyen ≤ XᵀX/(4m)
w_gd = lojistik_gd(A, y_eg, ogrenme_hizi=4.0, adim=5000)
skl = LogisticRegression(C=1e6, tol=1e-8, max_iter=1000).fit(A[:, :2], y_eg)  # C büyük: cezasız gibi
w_skl = np.r_[skl.coef_[0], skl.intercept_]
w_ham = w_gd[:2] / ss                                              # ham birimlere geri çevir
b_ham = w_gd[2] - np.sum(w_gd[:2] * ort / ss)
print("\n=== 2. Sıfırdan gradyan inişi ve scikit-learn ===")
print(f"Eğrilik üst sınırı λmax(XᵀX/m)/4 = {L_egrilik:.3f} → η = 4 güvenli (η < {2 / L_egrilik:.2f})")
print(f"GD (η=4, 5000 adım)    : w = [{w_gd[0]:.4f}, {w_gd[1]:.4f}], b = {w_gd[2]:.4f}, "
      f"kayıp = {bce(w_gd, A, y_eg):.5f}")
print(f"sklearn (C=1e6, lbfgs) : w = [{w_skl[0]:.4f}, {w_skl[1]:.4f}], b = {w_skl[2]:.4f}, "
      f"kayıp = {bce(w_skl, A, y_eg):.5f}, {skl.n_iter_[0]} iterasyon")
print(f"En büyük katsayı farkı: {np.abs(w_gd - w_skl).max():.1e}")
print(f"Doğrusal karar sınırı (ham birimler): n = {-b_ham / w_ham[1]:.3f} − {w_ham[0] / w_ham[1]:.3f}·λ̄")
assert np.abs(w_gd - w_skl).max() < 1e-3

# %% 3. Özellik mühendisliği: aynı algoritma, üç farklı özellik kümesi
model_A = make_pipeline(StandardScaler(), LogisticRegression(C=1e6, tol=1e-8)).fit(X_eg, y_eg)
model_B = make_pipeline(PolynomialFeatures(2, include_bias=False), StandardScaler(),
                        LogisticRegression(C=1e6, tol=1e-8, max_iter=5000)).fit(X_eg, y_eg)
model_C = LogisticRegression(C=1e6, tol=1e-8).fit(u_eg.reshape(-1, 1), y_eg)
p_A = model_A.predict_proba(X_te)[:, 1]
p_B = model_B.predict_proba(X_te)[:, 1]
p_C = model_C.predict_proba(u_te.reshape(-1, 1))[:, 1]
p_gercek = norm.cdf(np.log(u_te) / SIGMA_R)       # veriyi üreten olasılık P(R < u)
u_yildiz = -model_C.intercept_[0] / model_C.coef_[0, 0]
print("\n=== 3. Özellik seçimi: üç model (test kümesi) ===")
print("Model                          doğruluk  log-kayıp    AUC")
for ad, p in [("(A) λ̄, n doğrusal", p_A), ("(B) λ̄, n 2. derece polinom", p_B),
              ("(C) fizik özelliği u = n/χ", p_C), ("(*) gerçek olasılık P(R < u)", p_gercek)]:
    print(f"{ad:31s} {accuracy_score(y_te, p >= 0.5):6.3f}   {log_loss(y_te, p):7.4f}  "
          f"{roc_auc_score(y_te, p):.4f}")
print(f"(C) katsayılar: w = {model_C.coef_[0, 0]:.2f}, b = {model_C.intercept_[0]:.2f} → "
      f"sınır u* = {u_yildiz:.3f} (gerçek: 1)")
assert np.allclose(model_A[-1].coef_[0], w_skl[:2], rtol=1e-3)

# %% 4. Sınıflandırma ölçütleri: model C, eşik 0.5, test kümesi
tahmin = (p_C >= 0.5).astype(int)
tn, fp, fn, tp = confusion_matrix(y_te, tahmin).ravel()
print("\n=== 4. Ölçütler (model C, eşik 0.5, test) ===")
print(f"Karışıklık matrisi: TN = {tn}, FP = {fp}, FN = {fn}, TP = {tp}")
print(f"Doğruluk {accuracy_score(y_te, tahmin):.3f}, kesinlik {precision_score(y_te, tahmin):.3f}, "
      f"duyarlılık {recall_score(y_te, tahmin):.3f}, F1 {f1_score(y_te, tahmin):.3f}")
print(f"ROC AUC {roc_auc_score(y_te, p_C):.4f}, ortalama kesinlik (PR) "
      f"{average_precision_score(y_te, p_C):.4f}, log-kayıp {log_loss(y_te, p_C):.4f}, "
      f"Brier {brier_score_loss(y_te, p_C):.4f}")
assert tp + fn == y_te.sum() and tn + fp + fn + tp == len(y_te)

# %% 5. Maliyete göre eşik: kaçan göçme (FN) yanlış alarmın (FP) 20 katı
MALIYET_FN, MALIYET_FP = 20.0, 1.0
kfold = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
p_oof = cross_val_predict(LogisticRegression(C=1e6, tol=1e-8), u_eg.reshape(-1, 1), y_eg, cv=kfold,
                          method="predict_proba")[:, 1]   # her örnek, görmediği katın modeliyle


def maliyet(y_gercek, p, esik):
    t = p >= esik
    fn_ = int(np.sum((y_gercek == 1) & ~t))
    fp_ = int(np.sum((y_gercek == 0) & t))
    return fn_, fp_, (MALIYET_FN * fn_ + MALIYET_FP * fp_) / len(y_gercek)


esikler = np.round(np.arange(0.01, 0.991, 0.005), 3)
maliyetler = np.array([maliyet(y_eg, p_oof, e)[2] for e in esikler])
esik_iyi = esikler[np.argmin(maliyetler)]
print("\n=== 5. Maliyete göre eşik (FN = 20 × FP; eğitim kümesi, 5 katlı CV tahminleri) ===")
print("eşik    FN   FP   maliyet/örnek  duyarlılık  kesinlik")
for e in sorted({0.5, 0.3, 0.2, 0.1, 0.05, 0.02, float(esik_iyi)}, reverse=True):
    fn_, fp_, c = maliyet(y_eg, p_oof, e)
    t = p_oof >= e
    print(f"{e:5.3f}  {fn_:3d}  {fp_:3d}   {c:8.3f}        {recall_score(y_eg, t):.3f}      "
          f"{precision_score(y_eg, t):.3f}" + ("   ← en düşük maliyet" if e == esik_iyi else ""))
print(f"Kuramsal eşik (kalibre olasılık için): 1/(1+20) = {1 / 21:.3f}")
for e in (0.5, esik_iyi):
    fn_, fp_, c = maliyet(y_te, p_C, e)
    print(f"Test, eşik {e:.3f}: FN = {fn_}, FP = {fp_}, maliyet/örnek = {c:.3f}")

# %% 6. Sınıf dengesizliği: çoğu yönetmeliğe göre boyutlandırılmış 2000 kolon
M = 2000
u_tas = rng.uniform(0.30, 1.05, M)                 # tasarım kullanım oranı n/χ
y_tas = (u_tas > rng.lognormal(0.0, SIGMA_R, M)).astype(int)
u1, u2, y1, y2 = train_test_split(u_tas.reshape(-1, 1), y_tas, test_size=0.3, random_state=42,
                                  stratify=y_tas)
print("\n=== 6. Sınıf dengesizliği (tasarlanmış 2000 kolon) ===")
print(f"Yetersiz oranı: {y_tas.mean():.3f}; u > 1 olan kolon: {np.sum(u_tas > 1)}; "
      f"test kümesi: {len(y2)} kolon, {y2.sum()} yetersiz")
hep_sifir = np.zeros_like(y2)                      # her kolona "yeterli" diyen tembel model
print(f"'Hepsi yeterli' tahmini     : doğruluk {accuracy_score(y2, hep_sifir):.3f}, "
      f"duyarlılık {recall_score(y2, hep_sifir):.3f}")
for ad, cw in [("Lojistik, ağırlıksız", None), ("Lojistik, class_weight='balanced'", "balanced")]:
    m = LogisticRegression(C=1e6, tol=1e-8, class_weight=cw).fit(u1, y1)
    t = m.predict(u2)
    print(f"{ad:34s}: doğruluk {accuracy_score(y2, t):.3f}, duyarlılık {recall_score(y2, t):.3f}, "
          f"kesinlik {precision_score(y2, t):.3f}, sınır u* = {-m.intercept_[0] / m.coef_[0, 0]:.3f}")

# %% 7. Grafikler
# Şekil 1: veri ve 0.5 karar sınırları; u ekseninde sigmoid
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].scatter(X_eg[y_eg == 0, 0], X_eg[y_eg == 0, 1], s=14, facecolors="none", edgecolors=SOLUK, lw=0.8)
ax[0].scatter(X_eg[y_eg == 1, 0], X_eg[y_eg == 1, 1], s=14, marker="x", color=SOLUK, lw=0.8)
LL, NN = np.meshgrid(np.linspace(0.2, 2.5, 300), np.linspace(0.0, 1.25, 300))
izgara = np.column_stack([LL.ravel(), NN.ravel()])
p_iz_C = model_C.predict_proba((izgara[:, 1] / chi(izgara[:, 0])).reshape(-1, 1))[:, 1]
for p_iz, renk in [(model_A.predict_proba(izgara)[:, 1], RENK[1]),
                   (model_B.predict_proba(izgara)[:, 1], RENK[2]), (p_iz_C, RENK[0])]:
    ax[0].contour(LL, NN, p_iz.reshape(LL.shape), levels=[0.5], colors=[renk], linewidths=2)
ll = np.linspace(0.2, 2.5, 200)
ax[0].plot(ll, chi(ll), color=MUREKKEP, ls="--", lw=1.4)
tutamak = [Line2D([], [], marker="o", ls="none", mfc="none", mec=SOLUK, label="Yeterli (eğitim)"),
           Line2D([], [], marker="x", ls="none", color=SOLUK, label="Yetersiz (eğitim)"),
           Line2D([], [], color=RENK[1], label="(A) doğrusal sınır"),
           Line2D([], [], color=RENK[2], label="(B) 2. derece polinom"),
           Line2D([], [], color=RENK[0], label="(C) u = n/χ özelliği"),
           Line2D([], [], color=MUREKKEP, ls="--", lw=1.4, label="Gerçek sınır n = χ(λ̄)")]
ax[0].legend(handles=tutamak, loc="upper center", ncol=2, fontsize=8)   # üstteki boş şeritte
ax[0].set(xlabel="Boyutsuz narinlik λ̄", ylabel="Kullanım oranı n = N/(A·fy)", ylim=(0, 1.6),
          yticks=np.arange(0, 1.21, 0.2), title="Karar sınırları (p = 0.5)")
uu = np.linspace(0.02, 2.5, 300)
titresim = rng.uniform(-0.03, 0.03, len(y_eg))
ax[1].scatter(u_eg, y_eg + titresim, s=10, color=SOLUK, alpha=0.6, label="Eğitim verisi (0/1, titretilmiş)")
ax[1].plot(uu, model_C.predict_proba(uu.reshape(-1, 1))[:, 1], color=RENK[0], label="(C) lojistik model")
ax[1].plot(uu, norm.cdf(np.log(uu) / SIGMA_R), color=MUREKKEP, ls="--", lw=1.4, label="Gerçek olasılık")
ax[1].axvline(1.0, color=IKINCIL, ls=":", lw=1.2)
ax[1].set(xlim=(0, 2.5), xlabel="u = n/χ(λ̄)", ylabel="P(yetersiz)", title="Fizik özelliği boyunca sigmoid")
ax[1].legend(loc="center right", fontsize=8)
fig.savefig(KLASOR / "d05_lojistik_regresyon_1.png", dpi=160)
plt.close(fig)

# Şekil 2: ROC ve kesinlik–duyarlılık eğrileri (test)
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
for ad, p, renk in [("(A) doğrusal", p_A, RENK[1]), ("(B) polinom", p_B, RENK[2]),
                    ("(C) u özelliği", p_C, RENK[0])]:
    fpr, tpr, _ = roc_curve(y_te, p)
    ax[0].plot(fpr, tpr, color=renk, drawstyle="steps-post",
               label=f"{ad}: AUC = {roc_auc_score(y_te, p):.3f}")
    kes, duy, _ = precision_recall_curve(y_te, p)
    ax[1].plot(duy, kes, color=renk, drawstyle="steps-post",
               label=f"{ad}: ort. kesinlik = {average_precision_score(y_te, p):.3f}")
for e, isaret in [(0.5, "o"), (esik_iyi, "s")]:
    t = p_C >= e
    ax[0].plot(np.mean(t[y_te == 0]), np.mean(t[y_te == 1]), marker=isaret, ms=8, mfc="white",
               mec=MUREKKEP, ls="none", label=f"(C) eşik {e:.3f}")
ax[0].set(xlim=(-0.01, 0.4), ylim=(0.6, 1.01), xlabel="Yanlış alarm oranı FP/(FP+TN)",
          ylabel="Duyarlılık TP/(TP+FN)", title="ROC eğrisi (yakınlaştırılmış)")
ax[0].legend(loc="lower right", fontsize=8)
ax[1].set(xlim=(0.6, 1.01), ylim=(0.6, 1.01), xlabel="Duyarlılık", ylabel="Kesinlik TP/(TP+FP)",
          title="Kesinlik–duyarlılık eğrisi (yakınlaştırılmış)")
ax[1].legend(loc="lower left", fontsize=8)
fig.savefig(KLASOR / "d05_lojistik_regresyon_2.png", dpi=160)
plt.close(fig)

# Şekil 3: eşiğe göre beklenen maliyet, kesinlik ve duyarlılık (eğitim, CV tahminleri)
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].plot(esikler, maliyetler, color=RENK[0], drawstyle="steps-post", label="Beklenen maliyet (CV)")
ax[0].axvline(1 / 21, color=MUREKKEP, ls="--", lw=1.2, label="Kuramsal eşik 1/21")
ax[0].axvline(0.5, color=IKINCIL, ls=":", lw=1.2, label="Varsayılan eşik 0.5")
ax[0].plot(esik_iyi, maliyetler.min(), marker="*", ms=13, color=MUREKKEP, ls="none",
           label=f"En düşük maliyet: eşik {esik_iyi:.3f}")
ax[0].set(xscale="log", xlabel="Eşik (log ölçek)", ylabel="Maliyet / örnek (FP = 1 birim)",
          title="FN = 20 × FP iken eşik seçimi")
ax[0].legend(loc="upper left", fontsize=8, frameon=True, framealpha=1, edgecolor="white")
tahminler = p_oof[None, :] >= esikler[:, None]             # her satır bir eşik
tp_e = (tahminler & (y_eg == 1)).sum(axis=1)
duy_e = tp_e / y_eg.sum()
kes_e = tp_e / tahminler.sum(axis=1)
ax[1].plot(esikler, duy_e, color=RENK[0], drawstyle="steps-post", label="Duyarlılık")
ax[1].plot(esikler, kes_e, color=RENK[1], drawstyle="steps-post", label="Kesinlik")
ax[1].axvline(esik_iyi, color=MUREKKEP, ls="--", lw=1.2, label=f"Seçilen eşik {esik_iyi:.3f}")
ax[1].set(xscale="log", xlabel="Eşik (log ölçek)", ylabel="Oran", ylim=(0.80, 1.005),
          title="Eşik düşerken duyarlılık artar, kesinlik düşer")
ax[1].legend(loc="lower center", ncol=3, fontsize=8, frameon=True, framealpha=1, edgecolor="white")
fig.savefig(KLASOR / "d05_lojistik_regresyon_3.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d05_lojistik_regresyon_1.png, _2.png, _3.png")=== 1. Veri ===
Örnek: 600 (eğitim 420, test 180), yetersiz oranı: 0.637
χ kontrolü (eğri b): λ̄=0.5 → 0.8842, λ̄=1.0 → 0.5970, λ̄=2.0 → 0.2095, λ̄=2.5 → 0.1397
=== 2. Sıfırdan gradyan inişi ve scikit-learn ===
Eğrilik üst sınırı λmax(XᵀX/m)/4 = 0.252 → η = 4 güvenli (η < 7.95)
GD (η=4, 5000 adım) : w = [6.6637, 8.0927], b = 3.7263, kayıp = 0.10328
sklearn (C=1e6, lbfgs) : w = [6.6637, 8.0927], b = 3.7263, kayıp = 0.10328, 17 iterasyon
En büyük katsayı farkı: 1.8e-05
Doğrusal karar sınırı (ham birimler): n = 1.038 − 0.425·λ̄
=== 3. Özellik seçimi: üç model (test kümesi) ===
Model doğruluk log-kayıp AUC
(A) λ̄, n doğrusal 0.944 0.1216 0.9897
(B) λ̄, n 2. derece polinom 0.961 0.0834 0.9956
(C) fizik özelliği u = n/χ 0.967 0.0711 0.9969
(*) gerçek olasılık P(R < u) 0.961 0.0700 0.9969
(C) katsayılar: w = 18.20, b = -17.71 → sınır u* = 0.973 (gerçek: 1)
=== 4. Ölçütler (model C, eşik 0.5, test) ===
Karışıklık matrisi: TN = 62, FP = 3, FN = 3, TP = 112
Doğruluk 0.967, kesinlik 0.974, duyarlılık 0.974, F1 0.974
ROC AUC 0.9969, ortalama kesinlik (PR) 0.9983, log-kayıp 0.0711, Brier 0.0229
=== 5. Maliyete göre eşik (FN = 20 × FP; eğitim kümesi, 5 katlı CV tahminleri) ===
eşik FN FP maliyet/örnek duyarlılık kesinlik
0.500 8 8 0.400 0.970 0.970
0.300 4 11 0.217 0.985 0.960
0.200 2 13 0.126 0.993 0.953
0.100 1 19 0.093 0.996 0.933
0.080 0 19 0.045 1.000 0.934 ← en düşük maliyet
0.050 0 30 0.071 1.000 0.899
0.020 0 40 0.095 1.000 0.870
Kuramsal eşik (kalibre olasılık için): 1/(1+20) = 0.048
Test, eşik 0.500: FN = 3, FP = 3, maliyet/örnek = 0.350
Test, eşik 0.080: FN = 0, FP = 14, maliyet/örnek = 0.078
=== 6. Sınıf dengesizliği (tasarlanmış 2000 kolon) ===
Yetersiz oranı: 0.096; u > 1 olan kolon: 133; test kümesi: 600 kolon, 57 yetersiz
'Hepsi yeterli' tahmini : doğruluk 0.905, duyarlılık 0.000
Lojistik, ağırlıksız : doğruluk 0.932, duyarlılık 0.614, kesinlik 0.648, sınır u* = 0.992
Lojistik, class_weight='balanced' : doğruluk 0.848, duyarlılık 0.895, kesinlik 0.375, sınır u* = 0.879
Grafikler kaydedildi: d05_lojistik_regresyon_1.png, _2.png, _3.png6. Özellikler ve karar sınırı
Aynı algoritmayı üç farklı özellik kümesiyle eğittik:
- (A) Ham özellikler $\bar\lambda$ ve $n$. Karar sınırı bir doğrudur.
- (B) İkinci derece polinom özellikler: $\bar\lambda$, $n$, $\bar\lambda^2$, $\bar\lambda n$, $n^2$. Model bu beş özellikte hâlâ doğrusaldır, ama $(\bar\lambda, n)$ düzleminde sınır bir koniğe (elips, parabol ya da hiperbol parçası) dönüşür.
- (C) Fizik özelliği $u = n/\chi(\bar\lambda)$. Bu, yönetmelik kontrolündeki kullanım oranının ta kendisidir. Gerçek sınır $u = 1$ olduğu için tek bir özellik yeter.
| Model | Doğruluk | Log-kayıp | ROC AUC |
|---|---|---|---|
| (A) $\bar\lambda$, $n$ doğrusal | 0,944 | 0,1216 | 0,9897 |
| (B) 2. derece polinom | 0,961 | 0,0834 | 0,9956 |
| (C) $u = n/\chi(\bar\lambda)$ | 0,967 | 0,0711 | 0,9969 |
| (*) Gerçek olasılık $P(R < u)$ | 0,961 | 0,0700 | 0,9969 |
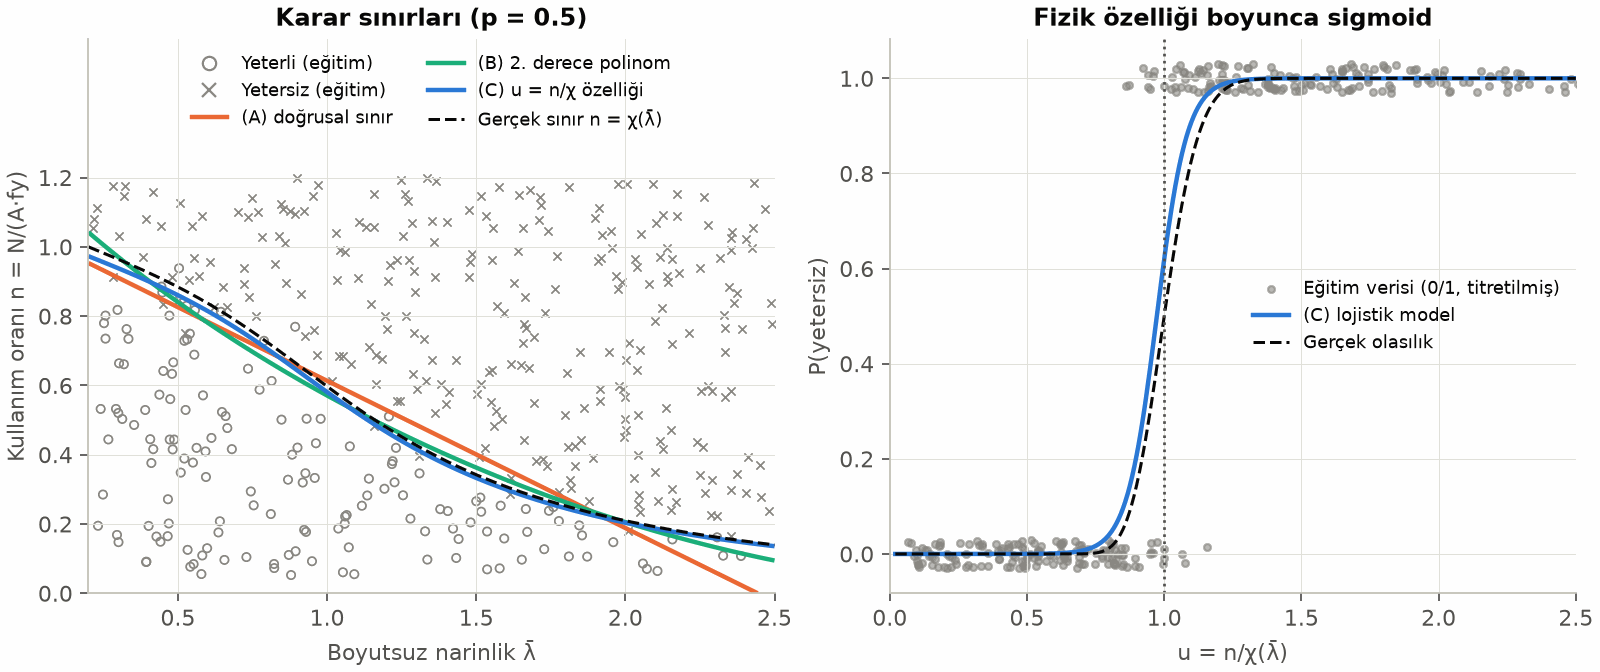
Soldaki grafikte doğrusal sınır orta narinliklerde gerçek eğriye yakın geçiyor, iki uçta ise ayrılıyor. $n = 1{,}038 - 0{,}425\,\bar\lambda$ doğrusu $\bar\lambda = 1{,}038/0{,}425 \approx 2{,}44$'te sıfıra iniyor; yani model bu narinliğin ötesindeki her kolonu, yükü ne kadar küçük olursa olsun yetersiz sayıyor. Gerçek sınır ise orada $\chi(2{,}5) = 0{,}1397$ düzeyinde. Polinom sınır eğriyi daha iyi izliyor; $u$ özelliğiyle kurulan sınır neredeyse üzerine oturuyor.
Tablo aynı hikâyeyi sayılarla anlatıyor: doğruluk 0,944'ten 0,967'ye çıkıyor, log-kayıp 0,1216'dan 0,0711'e iniyor. Model C'nin katsayıları $w = 18{,}20$, $b = -17{,}71$; öğrendiği sınır $u^* = -b/w = 0{,}973$, gerçek değer ise 1. Aradaki yaklaşık yüzde 3'lük fark, 420 gürültülü örnekten kestirim yapmanın doğal belirsizliğidir.
İyi özellik, karmaşık modelden iyidir
Üç modelde de algoritma aynı: logiti doğrusal olan bir model. Farkı yaratan, ona ne verdiğimiz. Mühendislik bilgisi ($\chi$ formülü) özelliğin içine gömülünce tek parametreli bir model bile neredeyse en iyi sonucu veriyor. Polinom özellikler aynı eğriyi “körlemesine” yakalamaya çalışır; işe yarar ama daha çok parametre ve veri ister, veri aralığının dışında da güvenilmezdir. Bu, Ders 04'teki su/bağlayıcı oranı fikrinin sınıflandırmadaki karşılığıdır.
Tablonun son satırı öğreticidir. “(*)” satırı, veriyi üreten gerçek olasılık $P(R < u)$'yu bir model gibi kullanıyor; ortalamada hiçbir model bundan iyi olamaz. Yine de bu test kümesinde doğruluğu (0,961) model C'ninkinden (0,967) düşük. Fark tek bir kolondur: 180 örnekte bir kolon doğruluğu yaklaşık 0,006 değiştirir. Küçük test kümelerinde doğruluk farklarını yorumlarken bu ayrık yapıyı aklınızda tutun. Log-kayıp ise beklendiği gibi en küçük değerini gerçek olasılıkta alıyor (0,0700). İki model de kolonları $u$'ya göre aynı sırayla dizdiği için ROC AUC değerleri de aynı (0,9969); AUC yalnızca sıralamayı ölçer.
Sağdaki grafik model C'yi tek eksende gösteriyor. Sigmoid, $u = 1$ çevresinde 0'dan 1'e geçiyor ve gerçek olasılık eğrisini yakından izliyor. Model eğrisi biraz sola kaymış ($u^* = 0{,}973$) ve kuyruklarda gerçek eğriden ayrılıyor. İkinci fark yapısaldır: veriyi lognormal bir saçılım üretti, model ise lojistik bir eğri varsayıyor. Bunu Alıştırma 5'te inceleyeceksiniz.
7. Sınıflandırma ölçütleri
Model C'nin test kümesindeki olasılıklarını 0,5 eşiğiyle sınıflara çevirelim. Dört olası sonuç vardır ve bunlar karışıklık matrisinde (confusion matrix) toplanır:
| Gerçek sınıf | Tahmin: yeterli | Tahmin: yetersiz |
|---|---|---|
| Yeterli | TN = 62 | FP = 3 |
| Yetersiz | FN = 3 | TP = 112 |
“Pozitif” sınıf, aradığımız olaydır: yetersiz kolon. Doğru pozitif (true positive, TP) yetersiz bir kolonu yakaladığımız, yanlış pozitif (FP) yeterli bir kolon için boşuna alarm verdiğimiz, yanlış negatif (FN) yetersiz bir kolonu kaçırdığımız durumdur. TN de yeterli bir kolona doğru olarak “yeterli” demektir. Mühendislik açısından iki hata türü eşit değildir: FP gereksiz bir güçlendirme ya da ek inceleme demektir; FN ise yük altında burkulacak bir kolonu “yeterli” saymaktır.
Matristen türetilen başlıca ölçütler şunlardır:
- Doğruluk (accuracy): $(TP + TN)/m = 174/180$ $= 0{,}967$. Bütün kararların ne kadarı doğru?
- Kesinlik (precision): $TP/(TP + FP) = 112/115$ $= 0{,}974$. “Yetersiz” dediğimiz kolonların ne kadarı gerçekten yetersiz?
- Duyarlılık (recall): $TP/(TP + FN) = 112/115$ $= 0{,}974$. Gerçekten yetersiz olan kolonların ne kadarını yakaladık? Güvenlik açısından en önemli soru budur.
- F1: kesinlik ($K$) ve duyarlılığın ($D$) harmonik ortalaması, $F_1 = 2KD/(K + D) = 0{,}974$. İkisinden biri küçükse F1 de küçük çıkar.
Bu modelde FP ve FN sayıları eşit (3'er) olduğu için kesinlik ve duyarlılık da eşit çıktı; bu bir rastlantıdır. Genelde biri artarken diğeri azalır ve aralarındaki dengeyi eşik belirler.
Eşikten bağımsız bakış: ROC ve PR eğrileri
Yukarıdaki ölçütlerin hepsi tek bir eşiğe bağlıdır. Eşiği 1'den 0'a doğru indirdikçe daha çok kolona “yetersiz” deriz: duyarlılık artar, ama yanlış alarmlar da artar. ROC eğrisi bu yolculuğu çizer: yatay eksende yanlış alarm oranı $FP/(FP + TN)$, düşey eksende duyarlılık vardır. Rastgele karar veren bir sınıflandırıcı köşegen üzerinde kalır; kusursuz bir sınıflandırıcı sol üst köşeden geçer.
Eğrinin altındaki alan, AUC, eşikten bağımsız tek bir sayıdır ve güzel bir olasılık yorumu vardır: rastgele seçilen bir yetersiz kolonun, rastgele seçilen bir yeterli kolondan daha yüksek olasılık alma olasılığıdır. Rastgele bir sınıflandırıcı için 0,5, kusursuz bir sınıflandırıcı için 1'dir. Model C için AUC = 0,9969.
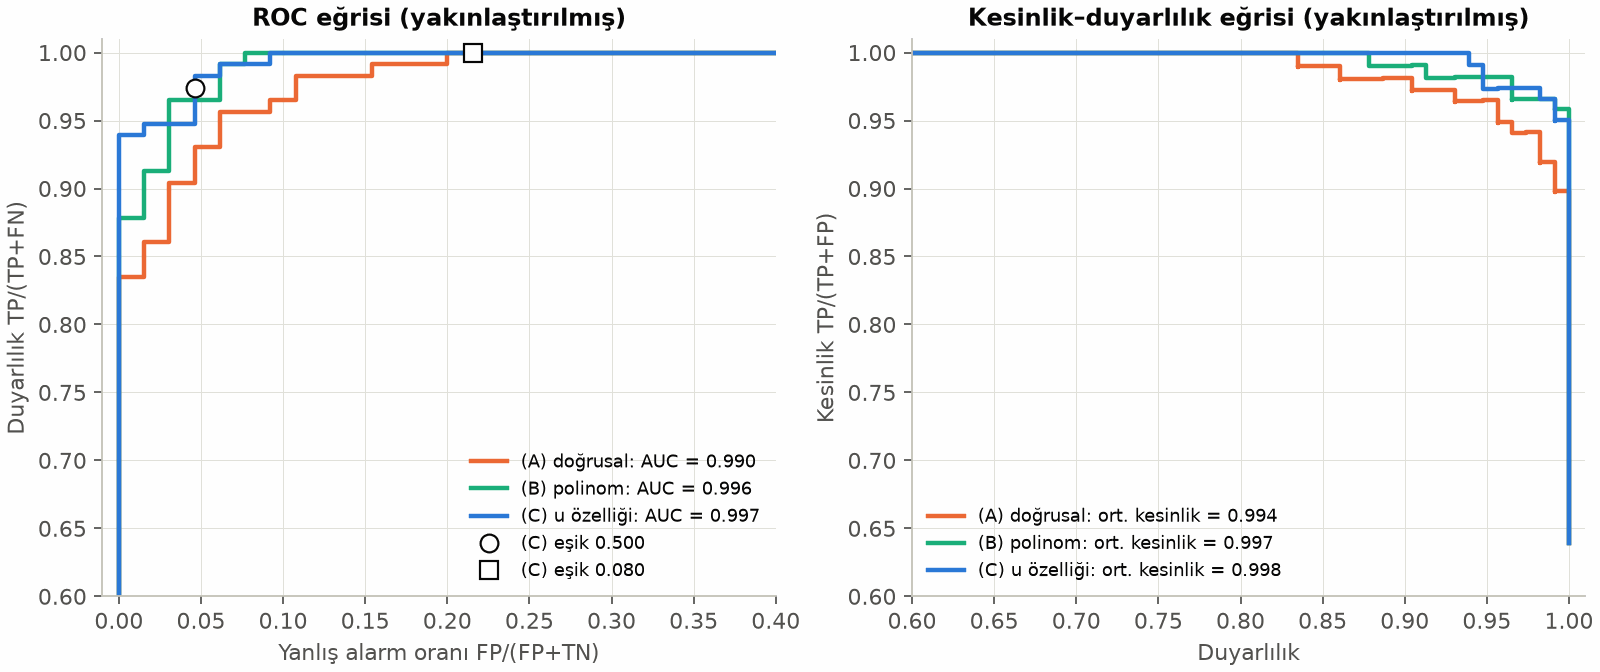
Kesinlik–duyarlılık (PR) eğrisi aynı eşik taramasını başka bir gözle gösterir. Pozitif sınıf seyrek olduğunda ROC eğrisi iyimser görünebilir, çünkü çok sayıdaki doğru negatif yanlış alarm oranını küçük tutar. PR eğrisi doğru negatifleri hiç kullanmaz; bu yüzden seyrek olayların (hasar, göçme, arıza) tespitinde daha bilgilendiricidir. Özeti ortalama kesinliktir (average precision); model C için 0,9983. Üç modelin sıralaması iki grafikte de tablodakiyle aynı: doğrusal model, yüksek duyarlılık bölgesinde kesinliği en erken kaybeden model.
Soldaki grafikteki iki işaret, eşiğin etkisini gösteriyor: daire 0,5 eşiğini, kare 8. bölümde seçeceğimiz 0,080 eşiğini temsil ediyor. Eşik düşünce çalışma noktası sağa ve yukarı kayıyor: duyarlılık 1'e çıkıyor, yanlış alarm oranı da artıyor.
Olasılığın kendisini ölçmek: log-kayıp, Brier skoru ve kalibrasyon
Doğruluk ve AUC olasılığın değerine bakmaz. Doğruluk yalnızca olasılığın eşiğin hangi yanında kaldığına, AUC yalnızca sıralamaya bakar. Oysa eşiği maliyete göre seçeceksek olasılığın kendisinin doğru olması gerekir. Bunu ölçen iki ölçüt:
- Log-kayıp: test kümesindeki çapraz entropi; model C için 0,0711. Emin olunan yanlışları ağır cezalandırır.
- Brier skoru: olasılık ile sonuç arasındaki farkın karelerinin ortalaması, $\frac{1}{m}\sum_i (p_i - y_i)^2$; model C için 0,0229.
Bir model “yüzde 20” dediği kolonların gerçekten yaklaşık yüzde 20'si yetersiz çıkıyorsa kalibre (calibrated) demektir. Sentetik veride gerçek olasılığı bildiğimiz için bunu doğrudan görebiliyoruz (Şekil 1, sağ). Gerçek projelerde test tahminleri olasılık aralıklarına ayrılır ve her aralıkta gözlenen oran tahminle karşılaştırılır (sklearn.calibration.calibration_curve). Kalibrasyonu bozuk bir model CalibratedClassifierCV ile sonradan düzeltilebilir. Lojistik regresyon doğrudan log-kaybı en küçüklediği için çoğu zaman iyi kalibredir; sınıf ağırlıkları ya da güçlü düzenlileştirme bu özelliği bozabilir.
8. Eşiği maliyete göre seçmek
0,5 eşiği iki hatanın eşit maliyetli olduğunu varsayar. Kolon örneğinde bu varsayım gerçekçi değil. Bir varsayım yapalım: kaçan bir göçme (FN), boşa verilen bir alarmın (FP) 20 katı maliyetli olsun. Olasılığı $p$ olan bir kolona “yetersiz” dersek beklenen maliyet $(1 - p)\,c_{FP}$, “yeterli” dersek $p\,c_{FN}$ olur. Ucuz olanı seçeriz; yani “yetersiz” demek şu durumda daha ucuzdur:
$$ p\,c_{FN} > (1 - p)\,c_{FP} $$Bunu $p$ için çözünce eşik çıkar:
$$ p > t^* = \frac{c_{FP}}{c_{FP} + c_{FN}} = \frac{1}{21} \approx 0{,}048 $$Olasılıklar kalibre ise bu kural beklenen maliyeti en küçükleyen karardır (Bayes karar kuralı). Kuramsal eşik 0,5'in çok altında: göçmeyi kaçırmak pahalı olduğu için yüzde 5'lik bir olasılık bile alarm vermeye yeter.
Olasılıklara tam güvenmiyorsak eşiği veriyle de seçebiliriz. Ama bunu test kümesinde yapmamalıyız: eşik de bir hiperparametredir ve test kümesinde seçilirse test sonucu iyimser olur. Bunun yerine eğitim kümesinde 5 katlı çapraz doğrulama yaptık (Ders 03). Her kolonun olasılığını, o kolonu eğitimde görmemiş modelden aldık; bunlara katın dışında kalan (out-of-fold) tahminler denir. Sonra 0,01 ile 0,99 arasındaki eşikleri taradık:
| Eşik | FN | FP | Maliyet/örnek | Duyarlılık | Kesinlik |
|---|---|---|---|---|---|
| 0,500 | 8 | 8 | 0,400 | 0,970 | 0,970 |
| 0,300 | 4 | 11 | 0,217 | 0,985 | 0,960 |
| 0,200 | 2 | 13 | 0,126 | 0,993 | 0,953 |
| 0,100 | 1 | 19 | 0,093 | 0,996 | 0,933 |
| 0,080 | 0 | 19 | 0,045 | 1,000 | 0,934 |
| 0,050 | 0 | 30 | 0,071 | 1,000 | 0,899 |
| 0,020 | 0 | 40 | 0,095 | 1,000 | 0,870 |
Maliyet en küçük değerine 0,080 eşiğinde iniyor: bütün yetersiz kolonlar yakalanıyor (FN = 0), bedeli 19 yanlış alarm. Eşiği daha da düşürmek yalnızca yanlış alarm ekliyor. Bulunan eşik kuramsal değere (0,048) yakın ama aynı değil. 420 örnekte maliyet eğrisi basamaklıdır ve en düşük noktasını sınıra yakın birkaç kolon belirler.
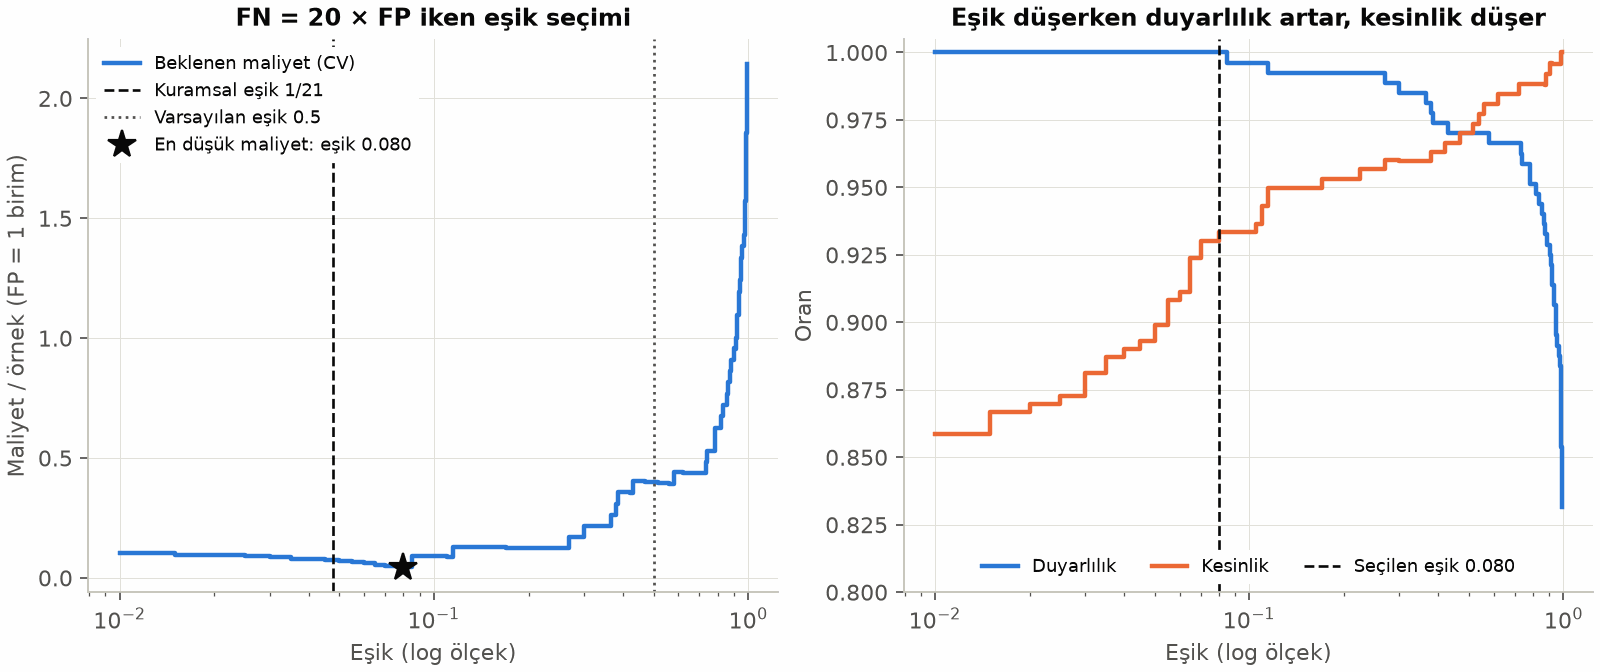
Seçilen eşiği test kümesine uyguladığımızda sonuç şu: 0,5 eşiğinde 3 FN ve 3 FP vardı ve örnek başına maliyet 0,350'ydi. 0,080 eşiğinde FN sıfıra iniyor, FP 14'e çıkıyor ve maliyet 0,078'e düşüyor. Doğruluk ise azalıyor (Alıştırma 2), çünkü doğruluk iki hatayı eşit sayar. Hata maliyetleri farklıysa doğru soru “kaç hata yaptık?” değil, “hatalar bize kaça mal oldu?” sorusudur.
scikit-learn'de TunedThresholdClassifierCV, bu taramayı çapraz doğrulamayla kendisi yapar. Maliyeti make_scorer ile tanımladığınız bir puanlama fonksiyonu olarak verebilirsiniz. Elle yazdığımız döngü, sınıfın içinde ne olduğunu görmek içindi.
9. Sınıf dengesizliği
Ana veri kümesinde kolonların yüzde 63,7'si yetersizdi, çünkü yükü ve narinliği geniş aralıklardan rastgele seçtik. Gerçek bir yapı stokunda durum tersidir: kolonların çoğu yönetmeliğe göre boyutlandırılmıştır ve yetersiz olanlar azdır. Bunu taklit etmek için 2.000 “tasarlanmış” kolon ürettik. Tasarım kullanım oranları $u$, $[0{,}30;\ 1{,}05]$ aralığından seçildi; 2.000 kolondan yalnızca 133'ünde (yaklaşık yüzde 7) $u > 1$, yani geri kalanların hepsi yönetmelik kontrolünü geçiyor. Saçılım yine aynı. Bu kümede yetersiz oranı yüzde 9,6; test kümesindeki 600 kolonun 57'si yetersiz. Böyle, bir sınıfın diğerinden çok daha seyrek olduğu duruma sınıf dengesizliği (class imbalance) denir.
| Yaklaşım | Doğruluk | Duyarlılık | Kesinlik | Sınır u* |
|---|---|---|---|---|
| Her kolona “yeterli” de | 0,905 | 0,000 | — | — |
| Lojistik, ağırlıksız | 0,932 | 0,614 | 0,648 | 0,992 |
| Lojistik, dengeli sınıf ağırlığı | 0,848 | 0,895 | 0,375 | 0,879 |
İlk satır doğruluk paradoksudur (accuracy paradox): hiçbir şey öğrenmeyen, her kolona “yeterli” diyen tembel bir kural yüzde 90,5 doğruluk alıyor ve tek bir yetersiz kolonu bile yakalamıyor. Ağırlıksız lojistik model doğrulukta onu yalnızca 0,027 geçiyor ve duyarlılığı 0,614; yani yetersiz kolonların üçte birinden fazlasını kaçırıyor. Sebep modelin kötü olması değil: öğrendiği sınır ($u^* = 0{,}992$) gerçeğe çok yakın. Sorun 0,5 eşiğinde. Yetersiz çıkan tasarlanmış kolonların çoğu $u = 1$'in hemen çevresindedir ve oradaki gerçek göçme olasılıkları 0,5'in pek üstüne çıkmaz. 0,5 eşiği bu kolonların ancak bir kısmını işaretleyebilir.
Tablonun son satırındaki dengeli ağırlık, class_weight="balanced" seçeneğidir. Her sınıfın kayıptaki ağırlığını sıklığıyla ters orantılı yapar:
Burada $K$ sınıf sayısı, $m_k$ ise $k$ sınıfındaki örnek sayısıdır. Seyrek sınıfın her örneği kayba daha çok katkı verir ve sınır güvenli tarafa kayar ($u^* = 0{,}879$). Duyarlılık 0,895'e çıkıyor, kesinlik 0,375'e iniyor ve doğruluk düşüyor. Tek özellikli bu modelde ağırlıklandırma, eşiği aşağı çekmekle aynı etkiyi yapar.
Ağırlıklandırma olasılıkları bozar
Ağırlıklı modelin verdiği olasılıklar artık gerçek göçme olasılıkları değildir; seyrek sınıfı yapay olarak büyütmüştür. Olasılığı bir kararın girdisi olarak (örneğin maliyet hesabında) kullanacaksanız, ağırlıksız modeli eğitip eşiği 8. bölümdeki gibi maliyete göre seçmek daha şeffaf bir yoldur. Dengesiz veride değerlendirmeyi doğrulukla değil duyarlılık, kesinlik, PR eğrisi ve maliyetle yapın; veriyi bölerken tabakalı bölme kullanın.
10. İkiden fazla sınıf: softmax
Deney sonucu yalnızca “yeterli / yetersiz” değil de göçme biçimi olabilir: “yeterli”, “eğilmeli burkulma”, “yerel burkulma” gibi. $K$ sınıf için her sınıfa ayrı bir logit $t_k = \vect w_k^\top\vect x + b_k$ tanımlanır ve logitler softmax fonksiyonuyla olasılıklara çevrilir:
$$ P(y = k \mid \vect x) = \frac{e^{t_k}}{\sum_{j=1}^{K} e^{t_j}} $$Olasılıklar pozitiftir ve toplamları 1'dir. $K = 2$ için softmax sigmoide indirgenir: $e^{t_1}/(e^{t_0} + e^{t_1}) = \sigma(t_1 - t_0)$. Kayıp yine olabilirlikten gelir ve her örnek için doğru sınıfa verilen olasılığın logaritmasıdır:
$$ L = -\frac{1}{m}\sum_{i=1}^{m} \ln P(y = y_i \mid \vect x_i) $$Gradyan da tanıdık biçimdedir: $k$ sınıfının ağırlıkları için $\frac{1}{m}X^\top(\vect p_k - \vect y_k)$. Burada $\vect y_k$, “örnek $k$ sınıfında mı?” sorusunun 0/1 cevaplarından oluşan vektördür. scikit-learn'ün LogisticRegression sınıfı, hedefte üç ya da daha fazla sınıf görünce bu çok terimli (multinomial) kaybı kendiliğinden en küçükler. Tek istisna liblinear çözücüsüdür: yalnızca ikili sınıflandırma yapar ve üç ya da daha fazla sınıfta scikit-learn 1.9 hata verir. Aynı softmax, Ders 11'de sinir ağlarının çıkış katmanı olarak yeniden karşımıza çıkacak.
11. Sık yapılan hatalar
- Dengesiz veride doğruluğa bakmak. “Hepsi yeterli” kuralı yüzde 90,5 doğruluk aldı. Duyarlılık, kesinlik ve PR eğrisi olmadan doğruluk yanıltıcıdır.
- 0,5 eşiğini sorgusuz kullanmak. Eşik bir mühendislik kararıdır ve hata maliyetlerinden gelir. Maliyetler farklıysa eşiği ona göre seçin.
- Eşiği test kümesinde ayarlamak. Eşik de bir hiperparametredir. Eğitim kümesindeki çapraz doğrulama tahminleriyle seçin; test kümesini yalnızca son ölçüm için kullanın.
- scikit-learn'ün varsayılan düzenlileştirmesini unutmak.
LogisticRegressionvarsayılan olarakC=1ile L2 cezası uygular. Katsayıları yorumlayacaksanız bunu bilin ve özellikleri ölçekleyin. - Tam ayrılabilir veride katsayılara güvenmek. İki sınıf bir hiperdüzlemle kusursuz ayrılabiliyorsa en çok olabilirlik çözümü sonsuzdadır: ağırlıklar büyümeye devam eder, olasılıklar 0 ve 1'e yapışır (Alıştırma 6). Düzenlileştirme çözümü sonlu tutar.
- Olasılığı, kalibrasyonunu kontrol etmeden bir kararın girdisi yapmak. Sınıf ağırlıkları, aşırı uyum ya da yanlış model biçimi olasılıkları bozar. Kalibrasyon eğrisine bakın.
12. Alıştırmalar
Alıştırma 1KolayBir kolonun olasılığını elle hesaplayın
$\bar\lambda = 1{,}0$ ve $n = 0{,}50$ olan bir kolon için $\Phi$, $\chi$ ve $u$'yu elle hesaplayın. Model C'nin katsayılarıyla ($w = 18{,}20$, $b = -17{,}71$) yetersizlik olasılığını bulun. Kolon 0,5 ve 0,080 eşiklerinde nasıl sınıflandırılır? Sonucu veriyi üreten gerçek olasılıkla karşılaştırın.
Çözümü göster
$\Phi = 0{,}5\,[1 + 0{,}34 \cdot 0{,}8 + 1]$ $= 1{,}136$; $\sqrt{1{,}136^2 - 1} = 0{,}539$; $\chi = 1/(1{,}136 + 0{,}539) = 0{,}597$ (koddaki 0,5970). Kullanım oranı $u = 0{,}50/0{,}597 = 0{,}8375$.
Logit: $18{,}20 \cdot 0{,}8375 - 17{,}71 = -2{,}468$; olasılık $\sigma(-2{,}468) \approx 0{,}078$. Kolon iki eşikte de “yeterli” sınıfına girer, ama 0,080 eşiğinin hemen altında kalır.
Gerçek olasılık $P(R < 0{,}8375)$ ise şudur ($F_N$: standart normal dağılım fonksiyonu):
$$ \begin{aligned} P &= F_N\big(\ln(0{,}8375)/0{,}10\big) \\ &= F_N(-1{,}773) \approx 0{,}038 \end{aligned} $$Model bu kuyrukta gerçek olasılığın yaklaşık iki katını veriyor: sınırı biraz sola kaymış ve lojistik eğrinin kuyruğu lognormal saçılımınkinden farklı. Eşiğe yakın kararlarda modelin bu küçük hataları sonucu değiştirebilir.
Alıştırma 2KolayYeni eşikte karışıklık matrisi
Test kümesinde 0,080 eşiğiyle FN = 0 ve FP = 14 bulundu. Test kümesinde 115 yetersiz ve 65 yeterli kolon var (0,5 eşiğindeki matristen kontrol edin). Karışıklık matrisini tamamlayın; doğruluk, kesinlik, duyarlılık ve F1'i hesaplayıp 0,5 eşiğindeki değerlerle karşılaştırın.
Çözümü göster
TP = 115 − 0 = 115, TN = 65 − 14 = 51. Doğruluk $(115 + 51)/180 = 0{,}922$, kesinlik $115/129 = 0{,}891$, duyarlılık $115/115 = 1$, F1 $= 2 \cdot 0{,}891/(0{,}891 + 1) = 0{,}943$.
0,5 eşiğinde bu değerler 0,967; 0,974; 0,974 ve 0,974'tü. Duyarlılık dışındaki bütün ölçütler düştü, ama aynı eşik örnek başına maliyeti 0,350'den 0,078'e indirdi. Hangi ölçütün “daha iyi” olduğu, neyin pahalı olduğuna bağlıdır.
Alıştırma 3OrtaMaliyet oranı değişince
Koddaki MALIYET_FN değerini 20 yerine 5 ve 100 yapın. Kuramsal eşikler nedir, çapraz doğrulamayla bulunan eşikler nedir? Sonra oranı 1 yapın (iki hata eşit maliyetli) ve çapraz doğrulamanın seçtiği eşikle 0,5 eşiğini test kümesindeki maliyetle karşılaştırın. Ne gözlüyorsunuz?
Çözümü göster
Kuramsal eşikler $1/6 = 0{,}167$ ve $1/101 = 0{,}0099$'dur. Çapraz doğrulama ise iki durumda da (20'de olduğu gibi) 0,080 eşiğini seçer. Sebebi verinin ayrık yapısı: eğitim kümesinde CV olasılığı en düşük olan yetersiz kolonun olasılığı 0,085'tir. 0,080 eşiği son FN'yi de sıfırlar ve 0,100'den 0,080'e inerken hiç yeni FP eklenmez. Bu yüzden 5 ile 100 arasındaki her oranda en ucuz nokta burasıdır. Daha aşağısı yalnızca FP ekler.
Oran 1 iken çapraz doğrulama 0,725 eşiğini seçer (CV maliyeti 0,029). Test kümesinde bu eşik 6 FN ve 2 FP verir, maliyet 0,044 olur. Kuramsal eşik 0,5 ise 3 FN ve 3 FP ile 0,033 verir, yani daha iyidir. 420 örnekle seçilen eşik gürültüye uyum sağlamıştır: eşik de aşırı uyuma uğrayabilir. Olasılıklar kalibre ise kuramsal eşik güçlü bir başlangıç noktasıdır; veriyle seçilen eşik ondan çok uzaklaşıyorsa nedenini sorgulayın.
Alıştırma 4OrtaDurdurma toleransı ve yatık minimum
Kodun 2. hücresindeki (# %% 2) LogisticRegression(C=1e6, tol=1e-8, max_iter=1000) satırından tol=1e-8'i silin; varsayılan değer tol=1e-4'tür. Katsayılar, iterasyon sayısı ve eğitim kaybı nasıl değişir? Nedenini Hessyenin özdeğerleriyle açıklayın.
Çözümü göster
Çözücü 13 iterasyonda durur ve $\vect w = [6{,}6699;\ 8{,}1033]$, $b = 3{,}7282$ verir. Gradyan inişinin sonucundan farkı ikinci ondalıkta, en çok 0,0105'tir. Eğitim kaybı ise altı basamağa kadar aynıdır: 0,103275.
Minimumda Hessyenin özdeğerleri 0,00094; 0,0335 ve 0,0454'tür (koşul sayısı 48,5). Örneklerin çoğu sınırdan uzak olduğu için $p_i(1 - p_i) \approx 0$'dır ve kayıp yüzeyi minimum çevresinde çok yatıktır. En yatık yönde katsayıları değiştirmek kaybı neredeyse hiç değiştirmez; gradyana bakan durdurma ölçütü katsayılar yakınsamadan sağlanır. Yalnızca tahmin yapacaksanız fark önemsizdir; katsayıları yorumlayacak ya da yöntemleri karşılaştıracaksanız toleransı sıkılaştırın.
Alıştırma 5ZorLogit mi, probit mi?
Veriyi üreten olasılık $F_N(\ln u/0{,}10)$ biçimindedir ($F_N$: standart normal dağılım fonksiyonu). Model C'yi $u$ yerine $\ln u$ özelliğiyle yeniden eğitin. Katsayı ne çıkar? $F_N(z) \approx \sigma(1{,}702\,z)$ yaklaşımını kullanarak beklenen katsayıyı hesaplayın ve karşılaştırın. Test log-kaybı değişir mi?
Çözümü göster
m = LogisticRegression(C=1e6, tol=1e-8).fit(np.log(u_eg).reshape(-1, 1), y_eg)
print(m.coef_, m.intercept_)      # w ≈ 17.75, b ≈ 0.588
Model $w = 17{,}75$, $b = 0{,}588$ verir; sınır $u^* = e^{-0{,}588/17{,}75} = 0{,}967$. Yaklaşıma göre $F_N(\ln u/0{,}10) \approx \sigma(17{,}02\,\ln u)$ olmalıdır; beklenen katsayı $1{,}702/0{,}10 = 17{,}02$. Kestirim bundan yaklaşık yüzde 4 uzakta; bu, 420 örnekten gelen örnekleme belirsizliğidir. Test log-kaybı 0,0712 çıkar, $u$ ile kurulan modelinkiyle (0,0711) neredeyse aynı.
$F_N(z)$ ile $\sigma(1{,}702\,z)$ arasındaki fark bütün $z$ değerlerinde 0,0095'ten küçüktür. Yani lojistik (logit) ve normal (probit) bağlantılar pratikte neredeyse aynı eğrileri verir. Logitin tercih edilmesinin üç sebebi vardır: sigmoidin kapalı bir formülü vardır (normal dağılım fonksiyonunun yoktur); kanonik bağlantı olduğu için gradyan $X^\top(\vect p - \vect y)/m$ gibi sade bir biçim alır; katsayıların da bahis oranı yorumu vardır. Asıl kazanç bağlantı fonksiyonunda değil, özelliğin kendisindedir.
Alıştırma 6ZorTam ayrılabilir veri
Saçılımı olmayan bir dünyayı taklit edin: eğitim etiketlerini y_ayri = (u_eg > 1).astype(int) ile yeniden üretin; artık $u = 1$ iki sınıfı kusursuz ayırıyor. (a) LogisticRegression modelini $u$ üzerinde C=1 ve C=1e6 ile (ikisinde de tol=1e-8) eğitip katsayıları karşılaştırın. (b) Au = np.column_stack([(u_eg - u_eg.mean()) / u_eg.std(), np.ones(len(u_eg))]) matrisiyle lojistik_gd'yi $\eta = 4$ ile 100, 1.000, 10.000 ve 100.000 adım çalıştırın. Ağırlık vektörünün normu ve eğitim kaybı ne yapıyor?
Çözümü göster
(a) C=1: $w = 6{,}39$, $b = -6{,}47$, sınır $u^* = 1{,}012$. C=1e6: $w = 919{,}6$, $b = -919{,}2$, sınır $u^* = 0{,}9996$. Sınırın yeri iki modelde de anlamlı; ama ceza zayıfladıkça eğim devleşiyor.
C=1e6 ile varsayılan tol=1e-4'te ise $w = 498{,}1$, $b = -498{,}3$ ($u^* = 1{,}0004$) çıkar. Eğimin büyüklüğünü artık veri değil, çözücünün ne zaman durduğu belirliyor: ayrılabilir veride en çok olabilirlik çözümü sonsuzdadır ve çözücü bu yolda nerede durursa orada kalır. C=1 ise iki toleransta da aynı sonucu verir, çünkü ceza çözümü sonlu ve tek bir noktaya bağlar.
(b) Ağırlık normu 10,35; 24,22; 52,40 ve 109,63; eğitim kaybı 0,113; 0,048; 0,021 ve 0,0094. Kayıp sıfıra yaklaşıyor ama hiç ulaşmıyor; ağırlıkları büyütmek her adımda kaybı biraz daha azaltıyor. En çok olabilirlik çözümü sonsuzdadır ve olasılıklar 0 ile 1'e yapışır. Düzenlileştirme (sonlu C) çözümü sonlu tutar. Gerçek veride tam ayrılabilirlik çoğu zaman az veri, çok özellik ya da veri sızıntısı belirtisidir.
Özet
- Lojistik regresyon logiti doğrusal modeller ve sigmoidle olasılığa çevirir. Kaybı Bernoulli olabilirliğinden gelen ikili çapraz entropidir; dışbükeydir ve gradyanı $X^\top(\vect p - \vect y)/m$'dir.
- Karar sınırı özelliklerde doğrusaldır. Eğri bir sınır için polinom özellikler ya da, daha iyisi, fizikten gelen bir özellik gerekir: $u = n/\chi$ ile tek parametreli model neredeyse en iyi sonucu verdi.
- Doğruluk tek başına yetmez. Karışıklık matrisi, kesinlik, duyarlılık, ROC–AUC, PR eğrisi ve log-kayıp farklı sorulara cevap verir.
- Eşik bir mühendislik kararıdır. FN, FP'den 20 kat pahalıyken kuramsal eşik 1/21'dir; çapraz doğrulamayla seçilen 0,080 eşiği test maliyetini 0,350'den 0,078'e indirdi.
- Dengesiz veride doğruluk paradoksuna dikkat edin. Sınıf ağırlıkları duyarlılığı artırır ama olasılıkları bozar.
Sonraki derste karar sınırını hiç parametrik bir formül yazmadan çizen iki yöntemi göreceğiz: komşulara bakan k-en yakın komşu ve sınıflar arasındaki payı en büyükleyen destek vektör makineleri. Örneğimiz zeminlerde sıvılaşma sınırı olacak.
Kaynaklar
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 4.4 (lojistik regresyon).
- C. M. Bishop — Pattern Recognition and Machine Learning, Bölüm 4.3 (lojistik ve çok sınıflı lojistik regresyon).
- T. Fawcett (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874.
- scikit-learn belgeleri: Logistic regression, model değerlendirme ölçütleri ve olasılık kalibrasyonu; eşik ayarı için
TunedThresholdClassifierCVsınıfının belgesi.