Bu derste öğrenecekleriniz
- Doğrusal modeli ve ortalama kare hata kaybını matris biçiminde yazmak
- Normal denklemleri türetmek ve
np.linalg.lstsqile çözmek - Gradyan inişini sıfırdan yazmak; öğrenme hızının kararlılık sınırını açıklamak
- Ölçeklemenin (birim seçimi, standartlaştırma) yakınsamayı neden hızlandırdığını göstermek
- Artık grafiğiyle yanlış model biçimini fark etmek
1. Problem: çekme deneyinden elastisite modülü
Bir çelik numuneyi çekerken her an iki büyüklük kaydedilir: yük hücresinden kuvvet, ekstansometreden uzama. Kuvveti kesit alanına bölünce gerilme $\sigma$, uzamayı ölçü boyuna bölünce gerinim $\varepsilon$ elde edilir. Elastik bölgede Hooke yasası geçerlidir: $\sigma = E\,\varepsilon$.
$E$'yi tek bir noktadan $\sigma/\varepsilon$ diye hesaplamak, o noktanın gürültüsünü olduğu gibi sonuca taşır. Bütün ölçümlere birlikte bir doğru uydurmak ise gürültüyü ortalar, ölçüm düzenindeki sistematik hataları da görünür kılar. Elastisite modülünü belirleyen deney standartlarında da (ör. ASTM E111) eğim, doğrusal bölgedeki noktalara en küçük kareler doğrusu uydurularak bulunur.
Bu derste 80 ölçümlük sentetik bir veri kümesi kullanıyoruz. Veri, $E = 206$ GPa, 4 MPa'lık bir sıfır kayması ve standart sapması 3 MPa olan ölçüm gürültüsüyle üretildi. Gerçek değerleri bildiğimiz için yöntemin ne kadar iyi çalıştığını doğrudan görebileceğiz.
Modelimiz:
$$ \hat\sigma = w\,\varepsilon + b $$Burada $w$ modelin $E$ tahmini, $b$ ise sıfır kaymasının tahminidir. Makine öğrenmesi dilinde $\varepsilon$ bir özellik, $\sigma$ hedef, $w$ ve $b$ ise veriden öğrenilen parametrelerdir.
Neden $b$ terimini modele katıyoruz?
$\sigma = E\varepsilon$ doğrusu orijinden geçer. Gerçek ölçümlerde ise numunenin çenelere oturması, ön yük veya ekstansometrenin sıfırlanması gibi nedenlerle küçük bir kayma oluşur. Doğruyu orijinden geçmeye zorlarsanız bu kayma eğime yüklenir ve $E$ bozulur. Bunu Alıştırma 2'de deneyeceksiniz.
2. Model ve kayıp fonksiyonu
Genel durumda $n$ gözlem ve $p$ özellik vardır. Her gözlem için tahmin, özelliklerin ağırlıklı toplamıdır:
$$ \hat y_i = w_1 x_{i1} + \dots + w_p x_{ip} + b $$Bütün gözlemleri tek seferde yazmak için $X$ tasarım matrisine birlerden oluşan bir sütun ekleriz. Böylece $b$ de ağırlık vektörünün son elemanı olur ve model $\hat{\vect y} = X\vect w$ biçimini alır. Bizim problemimizde $X$'in her satırı $[\varepsilon_i,\ 1]$, $\vect w = [w,\ b]^\top$'dir.
Bir modelin ne kadar iyi olduğunu tek bir sayıyla ölçen fonksiyona kayıp fonksiyonu denir. Regresyonda en yaygın seçim ortalama kare hatadır (MSE):
$$ \begin{aligned} L(\vect w) &= \frac{1}{n}\sum_{i=1}^{n}\big(\hat y_i - y_i\big)^2 \\ &= \frac{1}{n}\,\lVert X\vect w - \vect y\rVert^2 \end{aligned} $$Karelerin kullanılmasının üç nedeni vardır:
- Kayıp her yerde türevlenebilir. Doğrusal modelde dışbükeydir: yerel minimum tuzağı yoktur; $X$'in sütunları doğrusal bağımsızsa minimum tektir.
- Büyük hatalar küçük hatalardan orantısız biçimde fazla cezalandırılır.
- Gürültü normal dağılımlıysa MSE'yi küçültmek, en çok olabilirlik tahminine eşdeğerdir. Bu bağlantının türetmesi Hazırlık 2'de var.
3. Kapalı biçimli çözüm: normal denklemler
Minimumda gradyan sıfırdır. MSE'nin gradyanı:
$$ \nabla L(\vect w) = \frac{2}{n}\,X^\top\big(X\vect w - \vect y\big) $$Bunu sıfıra eşitlemek normal denklemleri verir:
$$ X^\top X\,\vect w = X^\top \vect y $$Tek özellikli durumda çözüm tanıdık bir biçim alır:
$$ w = \frac{\sum_i (x_i-\bar x)(y_i-\bar y)}{\sum_i (x_i-\bar x)^2} $$ $$ b = \bar y - w\,\bar x $$Normal denklemlerin geometrik bir anlamı da vardır. $X^\top(\vect y - X\vect w) = \vect 0$ eşitliği, artık vektörünün $X$'in bütün sütunlarına dik olduğunu söyler. Tahmin $\hat{\vect y}$, $\vect y$'nin $X$'in sütun uzayına dik izdüşümüdür. Birler sütunu modelde olduğu sürece artıkların toplamı sıfırdır.
X = np.column_stack([eps, np.ones(n)])                     # her satır [ε_i, 1]
(E_ls, b_ls), *_ = np.linalg.lstsq(X, sigma, rcond=None) # XᵀX w = XᵀyNormal denklemleri np.linalg.inv(X.T @ X) @ X.T @ y diye ters matrisle çözmeyin. $X^\top X$'in koşul sayısı $X$'inkinin karesidir, bu yüzden ters alma yuvarlama hatalarını büyütür. lstsq problemi tekil değer ayrışımıyla (SVD) çözer ve hem daha kararlı hem de daha güvenlidir.
4. Gradyan inişi
Kapalı çözüm küçük doğrusal problemlerde idealdir. Ama özellik sayısı çok büyük olduğunda $p \times p$ boyutlu $X^\top X$ sistemini kurup çözmek çok pahalılaşır; kayıp karesel olmadığında ise (lojistik regresyon, sinir ağları) böyle bir formül hiç yoktur. Gradyan inişi bu durumlarda da çalışan genel yöntemdir: bir başlangıç noktasından çıkılır ve her adımda kaybın en hızlı azaldığı yöne, yani gradyanın tersine küçük bir adım atılır.
$$ \vect w_{k+1} = \vect w_k - \eta\,\nabla L(\vect w_k) $$$\eta$ öğrenme hızıdır. Bizim modelimizde iki parametrenin gradyanı:
$$ \frac{\partial L}{\partial w} = \frac{2}{n}\sum_i(\hat y_i - y_i)\,x_i $$ $$ \frac{\partial L}{\partial b} = \frac{2}{n}\sum_i(\hat y_i - y_i) $$def gradyan_inisi(x, y, ogrenme_hizi, adim):
w, b = 0.0, 0.0
for _ in range(adim):
hata = w * x + b - y # ŷ − y
dw = 2 * np.mean(hata * x) # ∂L/∂w
db = 2 * np.mean(hata) # ∂L/∂b
w -= ogrenme_hizi * dw
b -= ogrenme_hizi * db
return w, bÖğrenme hızı çok küçükse yakınsama yavaştır. Çok büyükse adımlar minimumun üzerinden atlar ve kayıp büyüyerek ıraksar. Sınır, kayıp yüzeyinin eğriliğine bağlıdır. MSE için eğrilik matrisi, yani Hessyen sabittir: $H = \tfrac{2}{n}X^\top X$. Gradyan inişi yalnızca
$$ 0 < \eta < \frac{2}{\lambda_{\max}(H)} $$olduğunda yakınsar. Yakınsamanın hızını ise koşul sayısı $\kappa = \lambda_{\max}/\lambda_{\min}$ belirler. En dik yön $\eta$'yı sınırlarken, en yatık yönde ilerleme $\eta\lambda_{\min}$ ile orantılıdır. Kabaca $\kappa$ mertebesinde adım gerekir.
Kendiniz deneyin
Aşağıdaki denemede aynı türden bir veri kümesi tarayıcıda üretilir. Öğrenme hızını büyütüp küçültün ve “Standartlaştır” kutusunu açıp kapatın. Sol grafikte doğrunun veriye nasıl oturduğunu, sağ grafikte kayıp yüzeyindeki yolu izleyin.
Bu etkileşimli deneme için tarayıcıda JavaScript açık olmalıdır.
5. Ölçek neden bu kadar önemli?
Aynı problemi üç farklı ölçekle gradyan inişine verdik. Sonuçlar aşağıdaki tabloda; bütün sayılar kodun çıktısından alındı.
| Ölçek | $\lambda_{\min}$ | $\lambda_{\max}$ | $\kappa$ | $\eta$ sınırı | Sonuç |
|---|---|---|---|---|---|
| (a) Ham: $\varepsilon$ birimsiz, $\sigma$ MPa | 2,86×10⁻⁷ | 2 | 6,99×10⁶ | 1 | $\eta = 0{,}5$ ile 10.000 adımda $E$ = 0,30 GPa; yakınsamadı |
| (b) $\varepsilon$ binde (‰), $\sigma$ MPa | 0,167 | 3,43 | 20,5 | 0,583 | $\eta = 0{,}5$ ile 72 adım |
| (c) Standartlaştırılmış | 2 | 2 | 1 | 1 | $\eta = 0{,}1$ ile 31 adım |
Ham birimlerde gerinim değerleri $10^{-3}$ mertebesindedir. $w$ yönündeki gradyan bu yüzden çok küçüktür. Kayıp yüzeyinin eğriliği bir yönde diğerinden yaklaşık yedi milyon kat büyüktür; eşit kayıp elipsleri bu yüzden $\sqrt{\kappa} \approx 2.600$ kat uzun, dar bir vadi çizer. Öğrenme hızını dik yön ($b$) sınırladığı için $w$ neredeyse hiç ilerleyemez. Model 10.000 adım sonra hâlâ $E \approx 0{,}3$ GPa'dadır.
İki çare vardır:
- Birim seçimi. Mühendislikte sayıları 1 mertebesine getiren birimler seçilir. Gerinimi ‰ cinsinden yazınca eğim doğrudan GPa çıkar ve $\kappa$ 20'ye iner.
- Standartlaştırma. Makine öğrenmesinde her sütundan ortalaması çıkarılıp standart sapmasına bölünür: $z = (x-\bar x)/s_x$. Özellik standartlaştırılınca $H = 2I$ olur ve kayıp yüzeyi tam bir çanağa döner. Hedefi de standartlaştırmak $H$'yi değiştirmez; yalnız parametreleri 1 mertebesine getirir.
Standartlaştırılmış modelin parametreleri asıl birimlere şöyle geri çevrilir:
$$ E = w_s\,\frac{s_\sigma}{s_\varepsilon} $$ $$ b = \bar\sigma - E\,\bar\varepsilon + s_\sigma\,b_s $$$H = 2I$ olduğunda $\eta = 0{,}5$ tek adımda minimuma ulaştırır. (c) satırında yolu görebilmek için bilerek daha küçük bir $\eta = 0{,}1$ seçtik. Gerçek projelerde ölçekleyicinin ortalama ve standart sapması yalnızca eğitim verisinden hesaplanmalıdır; aksi hâlde test bilgisi modele sızar (Ders 01).
6. Çalıştırılabilir kod
Kod beş bölümden oluşur: veri üretimi, kapalı çözüm, üç ölçekte gradyan inişi, yanlış model denemesi ve grafikler. # %% işaretleri, VS Code veya Spyder'da her bölümü ayrı bir hücre olarak çalıştırmanızı sağlar. Kurulum için Ders 01'deki adımları izleyin.
"""Ders 02 — Doğrusal regresyon ve gradyan inişi.

Çelik bir çekme numunesinin elastik bölge ölçümlerinden elastisite modülünü (E)
tahmin ediyoruz. Veri sentetiktir: E = 206 GPa, sıfır kayması 4 MPa ve
ölçüm gürültüsüyle üretilir. Gerçek bir deney kaydı değildir.

Çalıştır:  python d02_dogrusal_regresyon.py
Gerekenler: numpy, scipy, scikit-learn, matplotlib  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre üç PNG grafiği
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from scipy import stats
from sklearn.linear_model import LinearRegression

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent

# %% 1. Veri: elastik bölgede gerinim ve gerilme ölçümleri
rng = np.random.default_rng(42)
E_GERCEK = 206_000.0       # MPa (206 GPa)
B_GERCEK = 4.0             # MPa, yükleme başındaki sıfır kayması
n = 80
eps = np.sort(rng.uniform(0.10e-3, 1.50e-3, n))          # gerinim (birimsiz)
sigma = E_GERCEK * eps + B_GERCEK + rng.normal(0, 3.0, n)  # gerilme (MPa)
print("=== 1. Veri ===")
print(f"Örnek sayısı: {n}, gerinim aralığı: {eps.min()*1e3:.2f}–{eps.max()*1e3:.2f} ‰, "
      f"gerilme aralığı: {sigma.min():.0f}–{sigma.max():.0f} MPa")

# %% 2. Kapalı biçimli çözüm: en küçük kareler (normal denklemler)
# Tasarım matrisi: her satır [ε_i, 1]. Model: σ ≈ E·ε + b
X = np.column_stack([eps, np.ones(n)])
(E_ls, b_ls), *_ = np.linalg.lstsq(X, sigma, rcond=None)   # (XᵀX)⁻¹Xᵀy'yi kararlı biçimde çözer
skl = LinearRegression().fit(eps.reshape(-1, 1), sigma)
tahmin = X @ np.array([E_ls, b_ls])
artik = sigma - tahmin
rmse = np.sqrt(np.mean(artik**2))
r2 = 1 - np.sum(artik**2) / np.sum((sigma - sigma.mean())**2)

# Eğim için standart hata ve %95 güven aralığı (klasik doğrusal regresyon varsayımları)
s2 = np.sum(artik**2) / (n - 2)
se_E = np.sqrt(s2 / np.sum((eps - eps.mean())**2))
t_kritik = stats.t.ppf(0.975, df=n - 2)
print("\n=== 2. Kapalı biçimli çözüm ===")
print(f"NumPy lstsq       : E = {E_ls/1000:.2f} GPa, b = {b_ls:.2f} MPa")
print(f"scikit-learn      : E = {skl.coef_[0]/1000:.2f} GPa, b = {skl.intercept_:.2f} MPa")
print(f"Gerçek (üretilen) : E = {E_GERCEK/1000:.2f} GPa, b = {B_GERCEK:.2f} MPa")
print(f"RMSE = {rmse:.2f} MPa, R² = {r2:.5f}")
print(f"E için %95 güven aralığı: {(E_ls - t_kritik*se_E)/1000:.2f} – {(E_ls + t_kritik*se_E)/1000:.2f} GPa")
assert np.isclose(E_ls, skl.coef_[0]) and np.isclose(b_ls, skl.intercept_)


# %% 3. Gradyan inişi: aynı problemi adım adım çözmek
def gradyan_inisi(x, y, ogrenme_hizi, adim):
    """L(w, b) = ortalama[(w·x + b − y)²] kaybını gradyan inişiyle küçültür."""
    w, b = 0.0, 0.0
    kayiplar, yol = [], [(w, b)]
    for _ in range(adim):
        hata = w * x + b - y                  # ŷ − y
        kayiplar.append(np.mean(hata**2))
        dw = 2 * np.mean(hata * x)            # ∂L/∂w
        db = 2 * np.mean(hata)                # ∂L/∂b
        w -= ogrenme_hizi * dw
        b -= ogrenme_hizi * db
        yol.append((w, b))
    return w, b, np.array(kayiplar), np.array(yol)


print("\n=== 3. Gradyan inişi ===")
# (a) Ham birimler: ε ~ 0.001, σ ~ 100 MPa → kayıp yüzeyi aşırı basık bir vadi
w_a, b_a, L_a, _ = gradyan_inisi(eps, sigma, 0.5, 10_000)
durum = "yakınsadı" if abs(w_a - E_ls) < 0.01 * E_ls else "yakınsamadı"
print(f"(a) Ham birimler, η=0.5, 10000 adım : E = {w_a/1000:8.2f} GPa  ({durum})")

# (b) Birim seçimi: gerinimi ‰ (binde) cinsinden yazınca eğim doğrudan GPa olur
eps_pm = eps * 1e3
w_b, b_b, L_b, yol_b = gradyan_inisi(eps_pm, sigma, 0.5, 10_000)
print(f"(b) Gerinim ‰ cinsinden, η=0.5       : E = {w_b:8.2f} GPa, b = {b_b:.2f} MPa")

# (c) Standartlaştırma: ortalamayı çıkar, standart sapmaya böl
mx, sx, my, sy = eps.mean(), eps.std(), sigma.mean(), sigma.std()
xs, ys = (eps - mx) / sx, (sigma - my) / sy
w_c, b_c, L_c, yol_c = gradyan_inisi(xs, ys, 0.1, 10_000)
E_c = w_c * sy / sx                      # ölçekli eğimi MPa'ya geri çevir
b_cg = my + sy * b_c - E_c * mx
print(f"(c) Standartlaştırılmış, η=0.1        : E = {E_c/1000:8.2f} GPa, b = {b_cg:.2f} MPa")


def ilk_yakinsama(kayip, hedef):
    idx = np.nonzero(kayip <= hedef)[0]
    return str(idx[0]) if idx.size else "hiç (10000 adımda olmadı)"


# Kayıp yüzeyinin eğriliği: Hessyen H = (2/n)·AᵀA, A = [x, 1]
print("Hessyen özdeğerleri (kayıp yüzeyinin en dik ve en yatık yönü):")
for ad, x in [("(a) ham", eps), ("(b) ‰", eps_pm), ("(c) standart", xs)]:
    A = np.column_stack([x, np.ones_like(x)])
    lam = np.linalg.eigvalsh(2 * A.T @ A / len(x))
    print(f"   {ad:13s}: λ_min = {lam[0]:.3g}, λ_max = {lam[1]:.3g}, "
          f"koşul sayısı κ = {lam[1]/lam[0]:.3g}, kararlılık sınırı η < {2/lam[1]:.3g}")

# yakınsama ölçütü: kayıp, en iyi kaybın %0.1 üstüne inince
L_en_iyi = np.mean(artik**2)
L_c_hedef = np.mean(((xs * (E_ls * sx / sy)) + (b_ls - my + E_ls * mx) / sy - ys)**2)
print(f"En iyi MSE (kapalı biçim)            : {L_en_iyi:.3f} MPa²")
print(f"Kaybın en iyinin %0.1 üstüne indiği adım: (a) {ilk_yakinsama(L_a, 1.001*L_en_iyi)}, "
      f"(b) {ilk_yakinsama(L_b, 1.001*L_en_iyi)}, (c) {ilk_yakinsama(L_c, 1.001*L_c_hedef)}")
assert abs(w_b - E_ls / 1000) < 0.01 and abs(E_c - E_ls) < 10

# %% 4. Yanlış model: akma sonrası ölçümleri de doğruya katmak
eps_p = np.linspace(1.9e-3, 6.0e-3, 25)                        # akma sonrası (sentetik)
sigma_p = 360 + 2_000 * (eps_p - 1.75e-3) + rng.normal(0, 3.0, eps_p.size)
eps_t = np.concatenate([eps, eps_p])
sigma_t = np.concatenate([sigma, sigma_p])
E_t, b_t = np.polyfit(eps_t, sigma_t, 1)
artik_t = sigma_t - (E_t * eps_t + b_t)
print("\n=== 4. Yanlış model ===")
print(f"Elastik + plastik tüm noktalara doğru: E = {E_t/1000:.1f} GPa (elastik bölgeden: {E_ls/1000:.1f} GPa)")

# %% 5. Grafikler
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].scatter(eps * 1e3, sigma, s=18, color=SOLUK, alpha=.8, label="Ölçüm (sentetik)")
xx = np.linspace(0, 1.6e-3, 50)
ax[0].plot(xx * 1e3, E_ls * xx + b_ls, color=RENK[0], label=f"En küçük kareler: E = {E_ls/1000:.1f} GPa")
ax[0].plot(xx * 1e3, 210_000 * xx, color=MUREKKEP, ls="--", lw=1.2, label="Nominal 210 GPa (b = 0)")
ax[0].set(xlabel="Gerinim ε (‰)", ylabel="Gerilme σ (MPa)", title="Elastik bölgeye doğru uydurma")
ax[0].legend(loc="upper left")
ax[1].axhline(0, color=MUREKKEP, lw=1)
ax[1].scatter(eps * 1e3, artik, s=18, color=RENK[0])
ax[1].set(xlabel="Gerinim ε (‰)", ylabel="Artık σ − σ̂ (MPa)", title="Artıklar: belirgin bir desen yok")
fig.savefig(KLASOR / "d02_dogrusal_regresyon_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
it = np.arange(1, 10_001)
ax[0].loglog(it, L_a, color=RENK[1], label="(a) ham birimler")
ax[0].loglog(it, L_b, color=RENK[0], label="(b) gerinim ‰")
ax[0].loglog(it, L_c * sy**2, color=RENK[2], label="(c) standartlaştırılmış")
ax[0].axhline(L_en_iyi, color=MUREKKEP, ls=":", lw=1.2, label="En iyi MSE")
ax[0].set(xlabel="Adım", ylabel="MSE (MPa²)", title="Aynı problem, farklı ölçek")
ax[0].legend(loc="center right")
W, B = np.meshgrid(np.linspace(-10, 240, 200), np.linspace(-90, 130, 200))
Z = ((W[..., None] * eps_pm + B[..., None] - sigma)**2).mean(axis=-1)
ax[1].contour(W, B, Z, levels=np.geomspace(Z.min() * 1.05, Z.max(), 16), colors=SOLUK, linewidths=.7)
ax[1].plot(yol_b[:80, 0], yol_b[:80, 1], "-o", ms=3, color=RENK[0], label="Gradyan inişi (b), η=0.5, ilk 80 adım")
ax[1].plot(w_b, b_b, marker="*", ms=13, color=MUREKKEP, ls="none", label="Minimum (en küçük kareler)")
ax[1].set(xlabel="Eğim w = E (GPa)", ylabel="Kesişim b (MPa)", title="Kayıp yüzeyi (gerinim ‰): uzun bir vadi")
ax[1].legend(loc="lower left")
fig.savefig(KLASOR / "d02_dogrusal_regresyon_2.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].scatter(eps_t * 1e3, sigma_t, s=16, color=SOLUK, label="Ölçüm (sentetik)")
xx = np.linspace(0, 6.2e-3, 50)
ax[0].plot(xx * 1e3, E_t * xx + b_t, color=RENK[1], label=f"Tüm noktalar: E = {E_t/1000:.0f} GPa")
ax[0].plot(xx[:15] * 1e3, (E_ls * xx + b_ls)[:15], color=RENK[0], label=f"Yalnız elastik: E = {E_ls/1000:.0f} GPa")
ax[0].set(xlabel="Gerinim ε (‰)", ylabel="Gerilme σ (MPa)", title="Model biçimi yanlışsa")
ax[0].legend(loc="lower right")
ax[1].axhline(0, color=MUREKKEP, lw=1)
ax[1].scatter(eps_t * 1e3, artik_t, s=16, color=RENK[1])
ax[1].set(xlabel="Gerinim ε (‰)", ylabel="Artık (MPa)", title="Artıklarda sistematik desen")
fig.savefig(KLASOR / "d02_dogrusal_regresyon_3.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d02_dogrusal_regresyon_1.png, _2.png, _3.png")=== 1. Veri ===
Örnek sayısı: 80, gerinim aralığı: 0.11–1.47 ‰, gerilme aralığı: 29–309 MPa
=== 2. Kapalı biçimli çözüm ===
NumPy lstsq : E = 206.82 GPa, b = 2.96 MPa
scikit-learn : E = 206.82 GPa, b = 2.96 MPa
Gerçek (üretilen) : E = 206.00 GPa, b = 4.00 MPa
RMSE = 2.78 MPa, R² = 0.99874
E için %95 güven aralığı: 205.17 – 208.48 GPa
=== 3. Gradyan inişi ===
(a) Ham birimler, η=0.5, 10000 adım : E = 0.30 GPa (yakınsamadı)
(b) Gerinim ‰ cinsinden, η=0.5 : E = 206.82 GPa, b = 2.96 MPa
(c) Standartlaştırılmış, η=0.1 : E = 206.82 GPa, b = 2.96 MPa
Hessyen özdeğerleri (kayıp yüzeyinin en dik ve en yatık yönü):
(a) ham : λ_min = 2.86e-07, λ_max = 2, koşul sayısı κ = 6.99e+06, kararlılık sınırı η < 1
(b) ‰ : λ_min = 0.167, λ_max = 3.43, koşul sayısı κ = 20.5, kararlılık sınırı η < 0.583
(c) standart : λ_min = 2, λ_max = 2, koşul sayısı κ = 1, kararlılık sınırı η < 1
En iyi MSE (kapalı biçim) : 7.733 MPa²
Kaybın en iyinin %0.1 üstüne indiği adım: (a) hiç (10000 adımda olmadı), (b) 72, (c) 31
=== 4. Yanlış model ===
Elastik + plastik tüm noktalara doğru: E = 59.3 GPa (elastik bölgeden: 206.8 GPa)
Grafikler kaydedildi: d02_dogrusal_regresyon_1.png, _2.png, _3.png7. Sonuçları yorumlayın
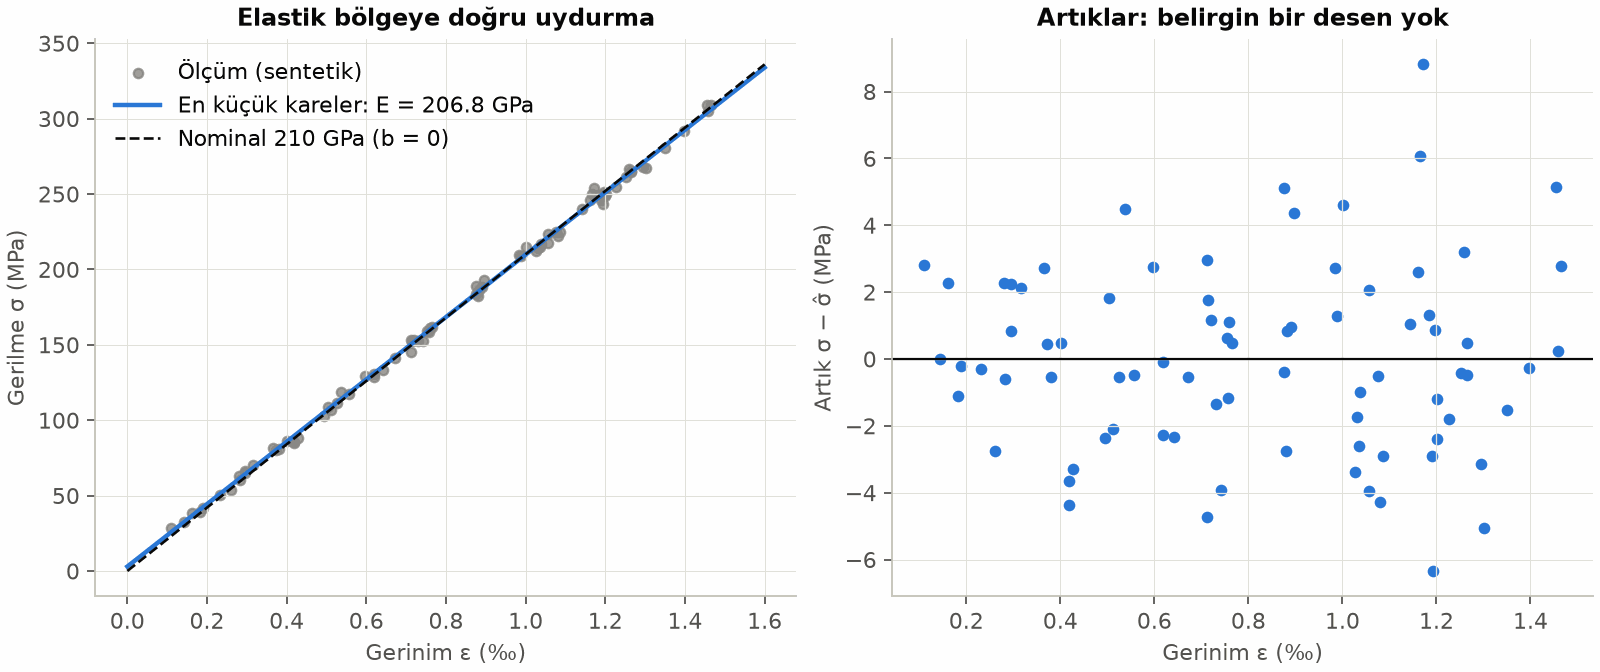
Kapalı çözüm ve scikit-learn aynı sonucu veriyor: $E$ = 206,82 GPa, $b$ = 2,96 MPa. Üretimde kullanılan değerler 206 GPa ve 4 MPa idi; eğimdeki fark yüzde 0,4. Artıkların karekök ortalaması (RMSE) 2,78 MPa ile gürültünün standart sapmasına (3 MPa) yakın. Bu, modelin gürültünün ötesinde bir yapıyı kaçırmadığına işaret eder.
Eğimin belirsizliğini artıklardan tahmin edebiliriz. Gürültü bağımsız ve normal dağılımlıysa eğimin standart hatası
$$ \mathrm{SE}(\hat E) = \frac{s}{\sqrt{\sum_i (\varepsilon_i - \bar\varepsilon)^2}} $$ $$ s^2 = \frac{1}{n-2}\sum_i r_i^2 $$olur ($r_i$ artıklar; paydadaki $n-2$, veriden iki parametre tahmin ettiğimiz içindir). %95 güven aralığı $\hat E \pm t\cdot\mathrm{SE}$'dir. Gürültünün standart sapmasını bilmeyip veriden tahmin ettiğimiz için 1,96 yerine $n - 2 = 78$ serbestlik dereceli t-dağılımının katsayısı kullanılır: $t \approx 1{,}99$.
Eğim için %95 güven aralığı 205,17–208,48 GPa ve üretimde kullanılan 206 GPa bu aralığın içinde. Tasarımda kullanılan 210 GPa ise aralığın dışında kalıyor. Yorumu şudur: bu numune için 210 GPa ölçümlerle uyumlu değil. Bu bir tasarım değerinin yanlış olduğu anlamına gelmez; tek bir numunenin modülü nominal değerden birkaç yüzde sapabilir.
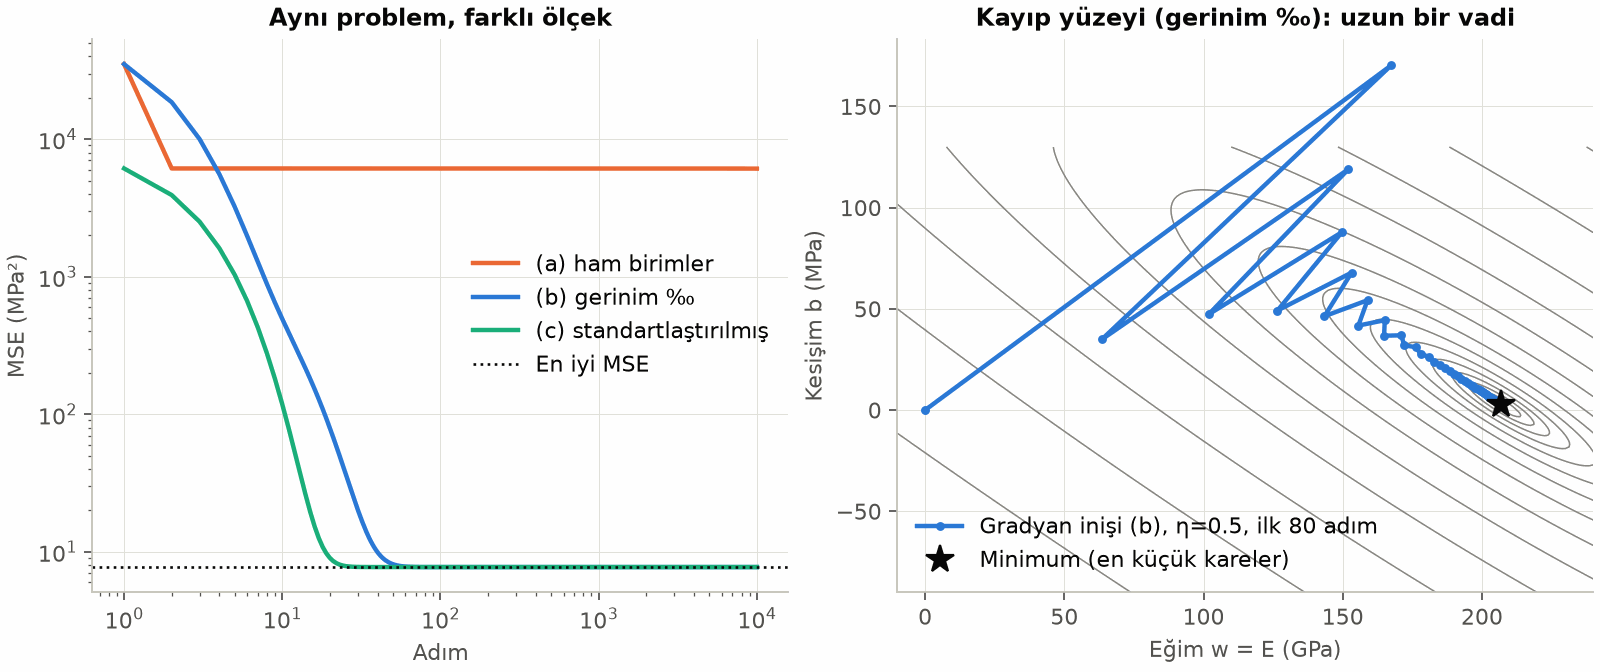
Sağdaki grafik, öğrenme hızının kararlılık sınırına yakın seçilmesinin bedelini gösteriyor. Dik yönde her adım minimumu aşıyor ama genliği her seferinde biraz küçülüyor. Yatık yönde ise yol sabırla ilerliyor. $\eta$'yı 0,583'ün üzerine çıkarırsanız zikzak büyür ve kayıp sonsuza gider; bunu Alıştırma 1'de deneyeceksiniz.
8. Model biçimi yanlışsa: artıkları okuyun
Akma sonrası 25 ölçümü de veriye katıp aynı doğruyu uydurduğumuzda eğim 59,3 GPa çıkıyor; elastik bölgeden bulunan değerin üçte birinden azı. Burada sorun algoritmada değil, model biçimindedir: tek bir doğru, elastik ve plastik davranışı birlikte temsil edemez.
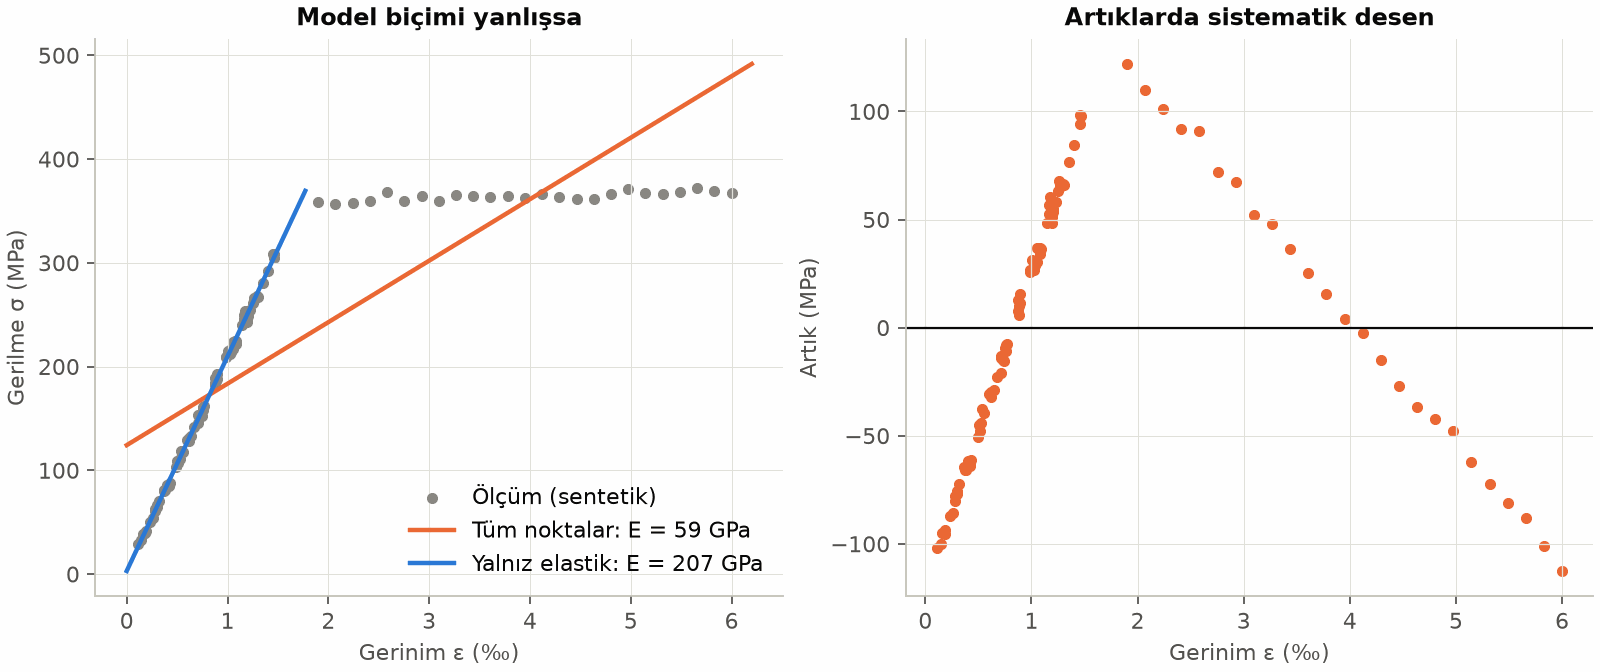
Kayıp değeri tek başına bu hatayı göstermez. Artık grafiği ise hemen gösterir: artıklar sıfır çevresinde rastgele dağılmak yerine sistematik bir desen çizer. Kural basittir: artıklarda desen varsa, modelin kaçırdığı bir yapı vardır. Çözüm ya veri aralığını modelin geçerli olduğu bölgeyle sınırlamak ya da daha uygun bir model biçimi seçmektir. Örneğin akma sonrası için ikinci bir doğru, ya da Ramberg–Osgood gibi bir bünye ilişkisi kullanılabilir.
9. Sık yapılan hatalar
- Ölçeklemeden gradyan inişi çalıştırmak. Kod hata vermez, ama sessizce yanlış sonuç üretir (tablodaki (a) satırı).
- Yüksek $R^2$'yi modelin doğruluğunun kanıtı saymak. $R^2$ yalnızca açıklanan varyans oranıdır. Model biçimini artık grafiğiyle kontrol edin.
- Ters matris almak.
lstsqveyaLinearRegressionkullanın. - Modeli geçerli olduğu aralığın dışında kullanmak. Elastik bölgeden öğrenilen doğru, akma sonrasında hiçbir şey söylemez.
- Özellikteki ölçüm hatasını unutmak. En küçük kareler, hatanın yalnızca hedefte ($\sigma$) olduğunu varsayar. Gerinim de gürültülüyse eğim sistematik olarak küçük tahmin edilir. Bu etkiye regresyon seyrelmesi (regression dilution) denir; sinyal gürültüden çok büyükse ihmal edilebilir.
10. Alıştırmalar
Alıştırma 1KolayIraksama
(b) durumunda öğrenme hızını 0,5'ten 0,6'ya çıkarın. Kayba ne olur? Neden?
Çözümü göster
Kayıp her adımda büyür ve sonunda taşma (inf/nan) oluşur. Kararlılık sınırı $2/\lambda_{\max} = 2/3{,}43 \approx 0{,}583$'tür. $\eta = 0{,}6$ bu sınırın üzerindedir. $\eta\lambda_{\max} = 0{,}6 \cdot 3{,}43 \approx 2{,}06$ olduğundan en dik yönde hata her adımda şu katsayıyla çarpılır:
Katsayı 1'den büyük olduğu için hata her adımda büyür.
Alıştırma 2KolayOrijinden geçen doğru
Modeli $b$ olmadan, yani $\sigma = w\,\varepsilon$ biçiminde kurun (X = eps.reshape(-1, 1)). $E$ nasıl değişir?
Çözümü göster
Tek parametreli en küçük kareler çözümü $w = \sum x_i y_i / \sum x_i^2$ olur ve $E$ = 209,83 GPa çıkar. Doğru orijinden geçmeye zorlanınca 2,96 MPa'lık kayma eğime yüklenmiş ve $E$'yi yüzde 1,5 büyütmüştür. Bu değer, iki parametreli modelin güven aralığının (205,17–208,48 GPa) dışındadır. Ölçümlerde kayma olabileceği biliniyorsa $b$ modelde kalmalıdır.
Alıştırma 3OrtaKapalı formülü elle doğrulayın
3. bölümdeki tek özellikli kapalı formülü ($w$ ve $b$ için) NumPy ile iki satırda yazın ve lstsq sonucuyla karşılaştırın.
Çözümü göster
xm, ym = eps.mean(), sigma.mean()
w = np.sum((eps - xm) * (sigma - ym)) / np.sum((eps - xm) ** 2)
b = ym - w * xm          # w ≈ 206 824 MPa, b ≈ 2,96 MPa
Sonuçlar makine hassasiyetinde aynı çıkar; tek özellikli problemde normal denklemlerin çözümü budur.
Alıştırma 4OrtaGürültü ve güven aralığı
Gürültünün standart sapmasını 3 MPa'dan 12 MPa'ya çıkarın. $E$ tahmini ve %95 güven aralığı nasıl değişir? Ölçüm sayısını 80'den 320'ye çıkarınca ne olur?
Çözümü göster
Güven aralığının genişliği, gürültünün standart sapmasıyla doğru, $\sqrt{n}$ ile ters orantılıdır. Gürültü 12 MPa olunca $E$ = 209,29 GPa ve aralık 202,66–215,92 GPa çıkar: genişlik 3,31'den 13,26 GPa'ya, yani 4 katına çıktı. Aralık artık nominal 210 GPa'yı da içeriyor; gürültülü veriyle bu iki değeri ayırt edemeyiz. Ardından ölçüm sayısını 320'ye çıkarınca (gürültü yine 12 MPa) $E$ = 203,59 GPa, aralık 200,30–206,89 GPa olur; genişlik yarıya indi. Tahminin kendisi gerçek değer çevresinde rastgele oynar: üç çalıştırmada 206,82, 209,29 ve 203,59 GPa bulduk.
Alıştırma 5ZorOptimum öğrenme hızı
Karesel bir kayıpta en kötü yöndeki daralmayı en küçük yapan öğrenme hızı $\eta^* = 2/(\lambda_{\min}+\lambda_{\max})$'tır. (b) durumu için $\eta^*$'ı hesaplayın, bu değerle kodu çalıştırın ve kaybın en iyinin %0,1 üstüne indiği adım sayısını 72 ile karşılaştırın. Sonuç sizi şaşırtabilir; nedenini açıklayın.
Çözümü göster
$\eta^* = 2/(0{,}167 + 3{,}429) \approx 0{,}556$. Bu değerde iki yöndeki daralma oranı eşitlenir:
$$ |1-\eta^*\lambda| = \frac{\kappa-1}{\kappa+1} \approx 0{,}907 $$Yine de ölçüt 79 adımda sağlanır, yani $\eta = 0{,}5$'ten (72 adım) daha geç.
Nedeni şu: $\eta^*$ yalnızca en kötü yöndeki asimptotik hızı en iyiler. Kayıp ise hataları $\lambda$ ile ağırlıklandırır ($L - L^*$, $\tfrac12\lambda_i e_i^2$ terimlerinin toplamıdır) ve başlangıçta dik yöndeki hata baskındır. $\eta = 0{,}5$ dik yöndeki hatayı her adımda 0,714 katına indirir; $\eta^*$ ise yalnızca 0,907 katına. Yatık yönde $\eta = 0{,}5$ biraz daha yavaştır (0,917'ye karşı 0,907); bu fark ancak çok sıkı bir ölçütte öne geçer. Ölçütü %0,1 yerine milyonda bir yaparsak $\eta = 0{,}5$ hâlâ önde (112'ye karşı 115 adım); milyarda birde $\eta^*$ ilk kez öne geçiyor (150'ye karşı 151).
Ders: “optimum” öğrenme hızı tanımı, neyi ölçtüğünüze bağlıdır. Asıl kazanç $\eta$ ayarından değil $\kappa$'yı düşürmekten gelir: (c)'de $\kappa = 1$ olduğundan $\eta = 0{,}5$ ile tek adım yeter.
Özet
- Doğrusal regresyon, ortalama kare hatayı küçülten ağırlıkları bulur. Normal denklemler $X^\top X\vect w = X^\top\vect y$ bu problemi tek adımda çözer.
- Gradyan inişi, kapalı çözümü olmayan modeller için de geçerli olan genel yöntemdir. Öğrenme hızı $2/\lambda_{\max}$'ı aşmamalıdır.
- Yakınsama hızını koşul sayısı belirler. Ölçekleme (anlamlı birimler veya standartlaştırma) çoğu zaman en büyük kazancı sağlar.
- Artık grafiği, kayıp değerinin göstermediği model biçimi hatalarını ortaya çıkarır.
Sonraki derste aynı modelin karmaşıklığını artırınca ne olduğunu göreceğiz: eğitim hatası düşerken görmediği verideki hata neden artmaya başlar ve bunu nasıl dürüstçe ölçeriz?
Kaynaklar
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 3 (doğrusal regresyon).
- S. Boyd, L. Vandenberghe — Introduction to Applied Linear Algebra, Bölüm 12–13 (en küçük kareler).
- scikit-learn — Linear Models ve numpy.linalg.lstsq belgeleri.