Bu derste öğrenecekleriniz
- Nöronu, aktivasyon fonksiyonlarını ve doğrusal olmayanlığın neden gerektiğini açıklamak
- İki gizli katmanlı bir ağın ileri yayılımını matris biçiminde yazmak
- Geri yayılımı zincir kuralıyla türetmek ve NumPy ile uygulamak
- Gradyanı merkezi farkla denetlemek ve kırık noktası tuzağını tanımak
- Xavier/He başlatma ve mini-yığın SGD ile bir regresyon ve bir sınıflandırma ağı eğitmek
1. Problem: gerinimden gerilmeyi bulmak
Alüminyum alaşımlarında çelikteki gibi belirgin bir akma platosu yoktur. Gerilme–gerinim eğrisi elastik bölgeden plastik bölgeye yumuşak bir dizle geçer. Bu davranışı tanımlamak için yaygın olarak Ramberg–Osgood ilişkisi kullanılır:
$$ \varepsilon = \frac{\sigma}{E} + 0{,}002\left(\frac{\sigma}{f_{0,2}}\right)^{n} $$İlk terim elastik gerinim, ikincisi plastik gerinimdir. $f_{0,2}$, kalıcı gerinimin %0,2 olduğu gerilmedir (%0,2 dayanımı). $n$ ise pekleşme üssüdür: büyüdükçe diz keskinleşir. Bu derste örnek amaçlı $E = 70$ GPa, $f_{0,2} = 160$ MPa ve $n = 20$ değerlerini kullanıyoruz. Bunlar belirli bir alaşımın tasarım değerleri değildir; yalnızca gerçekçi bir eğri biçimi verirler.
Bağıntı gerilmeden gerinimi doğrudan verir. Ama bir sonlu eleman programında çoğu zaman ters soru sorulur: gerinim belli, gerilme nedir? $\sigma(\varepsilon)$'nın kapalı bir biçimi yoktur. Her gerinim değeri için doğrusal olmayan bir denklemi sayısal olarak (Newton ya da ikiye bölme yöntemiyle) çözmek gerekir. Bu ters ilişkiyi doğrudan veren esnek bir fonksiyon, yani bir vekil model (surrogate) işe yarar. Polinom ya da spline akla ilk gelen seçeneklerdir. Bu derste aynı işi bir sinir ağına yaptıracağız ve ağın nasıl öğrendiğini, yani geri yayılımı, baştan sona kendimiz yazacağız.
Veri sentetiktir. $\varepsilon$ değerlerini $[0;\ 0{,}015]$ aralığında (gerinim %0–1,5) düzgün dağılımla seçtik. Her biri için gerçek $\sigma$'yı ikiye bölme yöntemiyle bulduk ve standart sapması 2 MPa olan normal gürültü ekledik. 200 ölçüm eğitim, 60 ölçüm doğrulama için ayrıldı. Gerçek eğriyi bildiğimiz için modellerin ondan ne kadar saptığını doğrudan ölçebileceğiz.
İkinci örnek mühendislikten değil, geometriden gelecek: iç içe geçmiş iki sarmal koldaki noktaları ayırmak. Bu oyuncak problem, gizli katmanların girdi uzayını nasıl büküp katladığını en açık biçimde gösterir.
2. Nörondan çok katmanlı ağa
Bir yapay nöron iki adımda çalışır. Önce girdilerin ağırlıklı toplamını alır, sonra bu toplamı doğrusal olmayan bir aktivasyon fonksiyonundan geçirir:
$$ z = \vect w^\top \vect x + b $$ $$ a = \varphi(z) $$$\varphi$ basamak fonksiyonu olursa elde edilen modele perseptron denir. $\varphi$ sigmoid olursa, Ders 05'teki lojistik regresyonun ta kendisini elde ederiz. Tek bir nöronun karar sınırı $\vect w^\top\vect x + b = 0$ doğrusudur (çok boyutta bir hiper düzlem). Bu yüzden XOR gibi basit bir problemi bile çözemez: $(0,0)$ ile $(1,1)$ bir sınıfta, $(1,0)$ ile $(0,1)$ öbür sınıftayken bu dört noktayı tek bir doğruyla ayırmak mümkün değildir.
Çözüm nöronları katmanlar hâlinde dizmektir. Bir katmandaki nöronların çıktıları bir sonraki katmanın girdileri olur. Girdi ile çıktı arasında kalan, değerlerini doğrudan gözlemediğimiz katmanlara gizli katman denir. Bu yapıya çok katmanlı perseptron (MLP) ya da ileri beslemeli ağ adı verilir. XOR'u iki gizli nöronla çözmek mümkündür; ağırlıkları Alıştırma 1'de elle bulacaksınız.
Doğrusal olmayan aktivasyon neden şart?
Aktivasyonu kaldırırsak katmanları üst üste koymanın hiçbir faydası kalmaz. İki doğrusal katman tek bir doğrusal katmana eşittir:
$$ \begin{aligned} &(X W_1 + \vect 1\vect b_1^\top)\,W_2 + \vect 1\vect b_2^\top \\ &\quad = X\,W' + \vect 1\,\vect b'^\top \end{aligned} $$Burada $W' = W_1W_2$ ve $\vect b'^\top = \vect b_1^\top W_2 + \vect b_2^\top$'dir. Kaç katman eklersek ekleyelim sonuç yine doğrusal bir modeldir. Doğrusal olmayan $\varphi$, her katmanın girdi uzayını bükmesine izin verir; bükülmüş uzayda bir sonraki katmanın çizdiği doğrusal sınır, asıl uzayda eğri bir sınıra dönüşür.
Kısa bir tarihçe
Perseptronu Frank Rosenblatt 1958'de önerdi. Minsky ve Papert'in 1969 tarihli Perceptrons kitabı tek katmanlı ağların XOR gibi problemlerdeki sınırını gösterdi ve alana olan ilgiyi uzun süre azalttı. Çok katmanlı ağları eğitmenin pratik yolu olan geri yayılım, 1986'da Rumelhart, Hinton ve Williams'ın Nature'daki makalesiyle yaygınlaştı; fikrin kökleri daha eskiye uzanır. Bugünkü derin öğrenmenin hızlanması ise 2010'larda büyük veri kümeleri, grafik işlemciler ve ReLU gibi aktivasyonların birleşmesiyle oldu.
3. Aktivasyon fonksiyonları
Geri yayılımda her katmandan geçen gradyan, o katmanın aktivasyon türeviyle çarpılır. Bu yüzden bir aktivasyon fonksiyonunu tanımak, türevini de tanımak demektir. En sık kullanılan dört fonksiyon:
| Ad | $\varphi(z)$ | $\varphi'(z)$ | Not |
|---|---|---|---|
| Sigmoid | $\dfrac{1}{1+e^{-z}}$ | $\varphi(1-\varphi)$ | Çıktı (0, 1); türev en çok 0,25 |
| tanh | $\tanh z$ | $1-\tanh^2 z$ | Çıktı (−1, 1), sıfır merkezli; türev en çok 1 |
| ReLU | $\max(0, z)$ | $z>0$ ise 1, değilse 0 | Pozitif tarafta doymaz; $z = 0$'da kırık |
| GELU | $z\,\Phi(z)$ | $\Phi(z) + z\,\phi(z)$ | ReLU'nun yumuşak hâli; dönüştürücü (transformer) modellerde yaygın |
GELU satırındaki $\Phi$ standart normal dağılım fonksiyonu, $\phi$ ise yoğunluk fonksiyonudur. Şekil 1 dört fonksiyonu ve türevlerini yan yana gösteriyor.
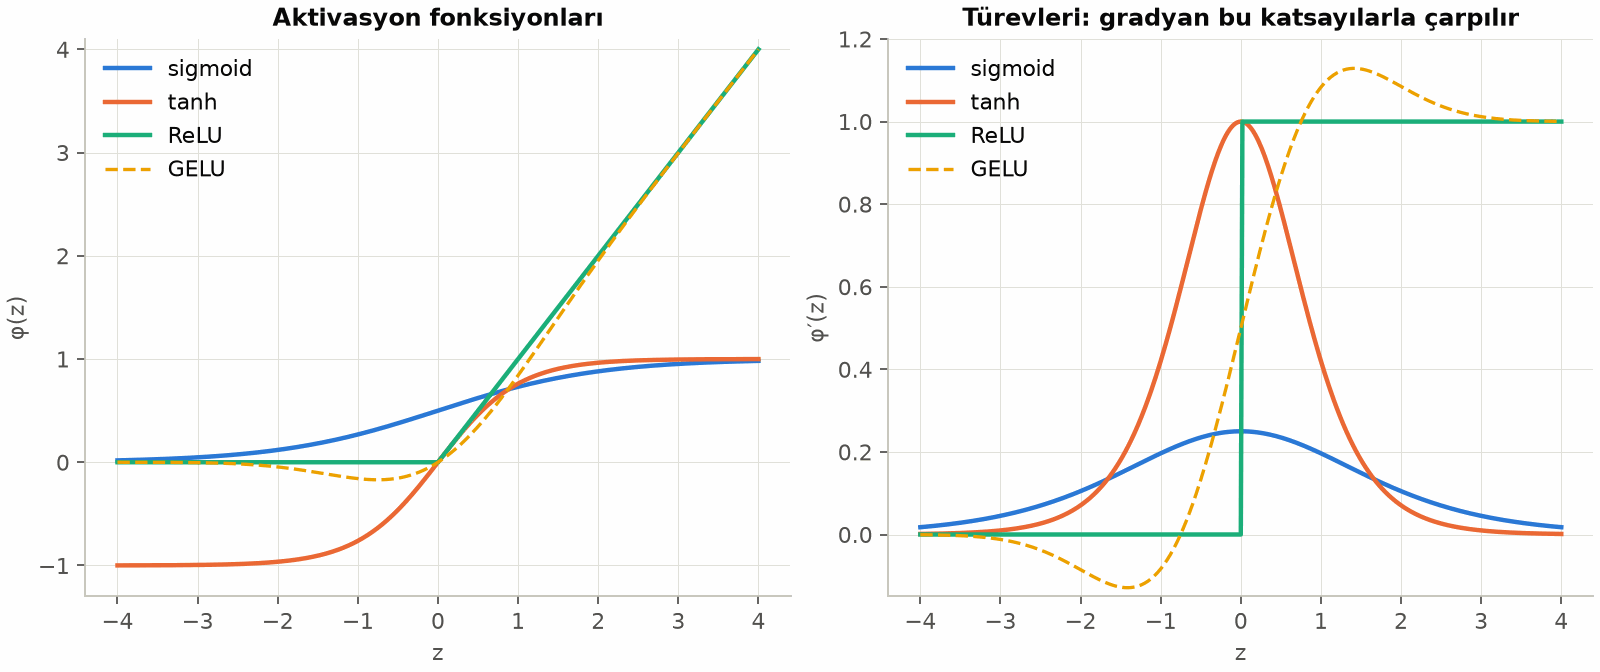
Sağ panel, derin ağların eğitimindeki eski bir sorunu açıklıyor. Gradyan geriye doğru her sigmoid katmanından geçerken aktivasyon türeviyle çarpılır ve bu çarpan en fazla 0,25'tir. Ağırlıklar bunu telafi etmezse on katman sonra aktivasyon türevlerinden gelen çarpan en fazla $0{,}25^{10} \approx 9{,}5\times10^{-7}$ olur ve ilk katmanlar neredeyse hiç öğrenemez. Bu olaya sönen gradyan (vanishing gradient) denir. ReLU pozitif tarafta türevi 1 tuttuğu için derin ağlarda standart seçim hâline geldi. Bedeli, negatif tarafta türevin sıfır olmasıdır: bütün girdiler için negatif bölgeye düşen bir birim bir daha hiç güncellenmez (“ölü ReLU”). Bu dersteki gibi sığ ağlarda tanh da gayet iyi çalışır.
Evrensel yaklaşım teoremi ne söyler, ne söylemez?
Cybenko (1989) sigmoid, Hornik (1991) sınırlı ve sabit olmayan aktivasyonlar için, tek gizli katmanlı bir ağın yeterince nöronla, kapalı ve sınırlı bir bölge üzerindeki her sürekli fonksiyona istenen yakınlıkta yaklaşabileceğini gösterdi. Sonuç daha sonra ReLU dahil polinom olmayan her aktivasyona genişletildi (Leshno vd., 1993). ReLU için sezgisi basittir: her ReLU birimi bir “menteşe” ekler; yeterince menteşeyle her eğriyi parça parça doğrularla izleyebilirsiniz.
Teorem bir varlık sonucudur. Kaç nöron gerektiğini, eğitimin o ağırlıkları bulup bulamayacağını, ne kadar veri gerektiğini ve ağın veri aralığı dışında nasıl davranacağını söylemez. “Sinir ağları her şeyi öğrenir” cümlesi bu teoremin hatalı bir özetidir.
4. İleri yayılım ve kayıp fonksiyonu
Ağı matris biçiminde yazalım. $X \in \R^{n\times p}$ tasarım matrisinin her satırı bir örnektir (Ders 02'deki düzenin aynısı). İki gizli katmanlı ağın ileri yayılımı:
$$ \begin{aligned} Z_1 &= X W_1 + \vect 1\vect b_1^\top \\ A_1 &= \varphi(Z_1) \\ Z_2 &= A_1 W_2 + \vect 1\vect b_2^\top \\ A_2 &= \varphi(Z_2) \\ Z_3 &= A_2 W_3 + \vect 1\vect b_3^\top \end{aligned} $$$\vect 1$ birlerden oluşan sütun vektörüdür; $\vect 1\vect b^\top$ terimi sapma vektörünü her satıra ekler. NumPy bunu yayınlamayla (broadcasting) kendiliğinden yapar. $\varphi$ elemanlar üzerinde tek tek uygulanır. Çıkış katmanında aktivasyon yoktur: regresyonda tahmin $\hat Y = Z_3$'tür, ikili sınıflandırmada $Z_3$ bir logit'tir ve olasılık $P = \sigma(Z_3)$ ile bulunur.
| Büyüklük | Boyut | Büyüklük | Boyut |
|---|---|---|---|
| $X$ | $n\times p$ | $W_1$, $\vect b_1$ | $p\times h_1$, $h_1$ |
| $Z_1$, $A_1$ | $n\times h_1$ | $W_2$, $\vect b_2$ | $h_1\times h_2$, $h_2$ |
| $Z_2$, $A_2$ | $n\times h_2$ | $W_3$, $\vect b_3$ | $h_2\times 1$, 1 |
| $Z_3$, $\hat Y$ | $n\times 1$ | Parametre sayısı | $(p+1)h_1 + (h_1+1)h_2 + h_2 + 1$ |
def ileri(P, X, akt):
    f = AKT[akt][0]
    Z1 = X @ P["W1"] + P["b1"]          # (n, h1)
    A1 = f(Z1)
    Z2 = A1 @ P["W2"] + P["b2"]         # (n, h2)
    A2 = f(Z2)
    Z3 = A2 @ P["W3"] + P["b3"]         # (n, 1): regresyonda ŷ, sınıflandırmada logit
    return Z3, (X, Z1, A1, Z2, A2)
Fonksiyon, tahminin yanında ara sonuçları da döndürüyor. Geri yayılım bunlara ihtiyaç duyacak; ara değerleri saklamak, ileri yayılımın bellek maliyetidir.
Kayıp fonksiyonları önceki derslerden tanıdık. Regresyonda ortalama kare hata (MSE):
$$ L = \frac{1}{n}\sum_{i=1}^{n}\big(\hat y_i - y_i\big)^2 $$İkili sınıflandırmada çapraz entropi (Ders 05). Olasılık $p_i = \sigma(z_i)$ olmak üzere:
$$ \begin{aligned} L = -\frac{1}{n}\sum_{i=1}^{n}\Big[&y_i\log p_i \\ &+ (1-y_i)\log(1-p_i)\Big] \end{aligned} $$Kodda bu ifadeyi olasılık üzerinden değil, doğrudan logit üzerinden hesaplıyoruz. İki biçim matematikte aynıdır:
$$ L = \frac{1}{n}\sum_{i=1}^{n}\Big[\log\big(1+e^{z_i}\big) - y_i z_i\Big] $$Bu biçimin sayısal üstünlüğü büyüktür. $z$ büyük olduğunda $\sigma(z)$ tam 1'e yuvarlanır ve $\log(1-p)$ eksi sonsuz olur. np.logaddexp(0, z) ise $\log(1+e^{z})$'yi taşma olmadan hesaplar.
5. Geri yayılım: zincir kuralı matris biçiminde
Gradyan inişi için kaybın her parametreye göre türevine ihtiyacımız var. Yüzlerce parametre için bunları tek tek türetmek yerine, zincir kuralını katman katman geriye doğru uygulayacağız. Önce her katman için bir hata sinyali tanımlayalım:
$$ \delta_l = \frac{\partial L}{\partial Z_l} $$$\delta_l$, $Z_l$ ile aynı boyutta ($n\times h_l$) bir matristir. $i$. satır $k$. sütundaki eleman, kaybın $i$. örnekteki $k$. birimin ön-aktivasyonuna duyarlılığıdır.
Çıkış katmanı
MSE ile doğrusal çıkışta türev doğrudan yazılır:
$$ \delta_3 = \frac{2}{n}\big(\hat Y - Y\big) $$Çapraz entropi ile sigmoid çıkışta sonuç şaşırtıcı derecede benzerdir. Tek bir örnek için $\ell(z) = \log(1+e^{z}) - yz$ olduğundan $\ell'(z) = \frac{e^{z}}{1+e^{z}} - y = \sigma(z) - y$ çıkar. Bütün örnekler için:
$$ \delta_3 = \frac{1}{n}\big(P - Y\big) $$İki durumda da çıkış hatası “tahmin eksi gerçek” biçimindedir. Bu bir tesadüf değil: çapraz entropi, sigmoid çıkışla eşleşen kayıptır ve sigmoidin doyma etkisini tam olarak sadeleştirir.
Bir katmanın üç kuralı
Her katman $Z = A\,W + \vect 1\vect b^\top$ biçimindedir; $A$ katmanın girdisidir (ilk katmanda $X$). $\delta = \partial L/\partial Z$ bilindiğinde üç türev elde edilir:
$$ \frac{\partial L}{\partial W} = A^\top\delta $$ $$ \frac{\partial L}{\partial \vect b} = \delta^\top\vect 1 $$ $$ \frac{\partial L}{\partial A} = \delta\,W^\top $$İkinci kural, $\delta$'nın sütun toplamıdır (kodda d.sum(axis=0)). Üçüncüsü hatayı bir önceki katmana taşır. $A = \varphi(Z_{\text{önceki}})$ elemanlar üzerinde uygulandığından, aktivasyondan geçerken elemanlar çarpımı ($\odot$) ile $\varphi'$ eklenir:
Kurallar indislerle
Katmanı eleman eleman yazalım: $Z_{ik} = \sum_j A_{ij}W_{jk} + b_k$. $W_{jk}$, $Z$'nin yalnızca $k$. sütununu etkiler; her örnekteki katkıları toplanır:
$$ \begin{aligned} \frac{\partial L}{\partial W_{jk}} &= \sum_i \frac{\partial L}{\partial Z_{ik}}\,\frac{\partial Z_{ik}}{\partial W_{jk}} \\ &= \sum_i \delta_{ik}A_{ij} \end{aligned} $$Bu toplam $(A^\top\delta)_{jk}$'dır. Aynı yolla $\partial Z_{ik}/\partial b_k = 1$ olduğundan $\partial L/\partial b_k = \sum_i\delta_{ik}$ bulunur. $A_{ij}$ ise $Z$'nin $i$. satırındaki bütün elemanları etkiler:
$$ \frac{\partial L}{\partial A_{ij}} = \sum_k \delta_{ik}W_{jk} = \big(\delta W^\top\big)_{ij} $$Son olarak $A_{ij} = \varphi(Z^{\text{önceki}}_{ij})$ yalnız kendi ön-aktivasyonuna bağlıdır, bu yüzden zincir kuralı burada toplam değil tek bir çarpım verir:
$$ \frac{\partial L}{\partial Z^{\text{önceki}}_{ij}} = \frac{\partial L}{\partial A_{ij}}\,\varphi'\big(Z^{\text{önceki}}_{ij}\big) $$İki gizli katmanlı ağın tam geri yayılımı
Kuralları çıkıştan girdiye doğru sırayla uygulayınca bütün gradyanlar çıkar:
$$ \begin{aligned} \frac{\partial L}{\partial W_3} &= A_2^\top\delta_3 \\ \frac{\partial L}{\partial \vect b_3} &= \delta_3^\top\vect 1 \\ \delta_2 &= \big(\delta_3W_3^\top\big)\odot\varphi'(Z_2) \\ \frac{\partial L}{\partial W_2} &= A_1^\top\delta_2 \\ \frac{\partial L}{\partial \vect b_2} &= \delta_2^\top\vect 1 \\ \delta_1 &= \big(\delta_2W_2^\top\big)\odot\varphi'(Z_1) \\ \frac{\partial L}{\partial W_1} &= X^\top\delta_1 \\ \frac{\partial L}{\partial \vect b_1} &= \delta_1^\top\vect 1 \end{aligned} $$def geri(P, onbellek, d3, akt):
X, Z1, A1, Z2, A2 = onbellek
fp = AKT[akt][1]
g = {"W3": A2.T @ d3, "b3": d3.sum(axis=0)}
d2 = (d3 @ P["W3"].T) * fp(Z2)
g["W2"], g["b2"] = A1.T @ d2, d2.sum(axis=0)
d1 = (d2 @ P["W2"].T) * fp(Z1)
g["W1"], g["b1"] = X.T @ d1, d1.sum(axis=0)
return g| Büyüklük | Hesap | Boyut |
|---|---|---|
| $\delta_3$ | $\tfrac{2}{n}(\hat Y - Y)$ | $n\times 1$ |
| $\partial L/\partial W_3$ | $(h_2\times n)(n\times 1)$ | $h_2\times 1$ |
| $\delta_2$ | $(n\times 1)(1\times h_2)\odot(n\times h_2)$ | $n\times h_2$ |
| $\partial L/\partial W_2$ | $(h_1\times n)(n\times h_2)$ | $h_1\times h_2$ |
| $\delta_1$ | $(n\times h_2)(h_2\times h_1)\odot(n\times h_1)$ | $n\times h_1$ |
| $\partial L/\partial W_1$ | $(p\times n)(n\times h_1)$ | $p\times h_1$ |
Suçun geriye dağıtılması
$\delta_1 = (\delta_2W_2^\top)\odot\varphi'(Z_1)$ satırını sözle okuyalım: birinci katmandaki bir birimin “suçu”, beslediği ikinci katman birimlerinin suçlarının, onlara bağlanan ağırlıklarla ağırlıklandırılmış toplamıdır. Bu toplam, birimin o andaki eğimiyle ($\varphi'$) çarpılır. Doymuş bir tanh biriminin eğimi sıfıra yakındır; o birim suçu neredeyse hiç geçirmez.
Geri yayılımın maliyeti, ileri yayılımın kabaca iki katıdır. Bütün türevler tek bir geri geçişle elde edilir. Aynı gradyanı sonlu farklarla hesaplamak ise her parametre için iki ileri geçiş ister: Örnek 1'deki 321 parametreli ağda bu 642 ileri geçiş demektir. Milyonlarca parametreli bir ağda fark, eğitimin mümkün olup olmamasıdır. Geri yayılım, ters modlu otomatik türevin sinir ağlarına uygulanmış hâlidir. Ders 12'de PyTorch bu işi bizim yerimize yapacak.
6. Gradyan kontrolü
Geri yayılım kodundaki bir hata çoğu zaman programı durdurmaz. Ağ yine eğitilir, sadece daha kötü öğrenir ve sebebini bulmak çok zor olur. Bu yüzden elle yazılmış her gradyan, sayısal türevle karşılaştırılmalıdır. Bunun için merkezi fark kullanılır:
$$ \frac{\partial L}{\partial\theta} \approx \frac{L(\theta+h) - L(\theta-h)}{2h} $$$L(\theta+h)$ ve $L(\theta-h)$'nin Taylor açılımları çıkarılınca $L''$'li terimler birbirini götürür. Geriye kalan en büyük terim $\tfrac{h^2}{6}L'''$ olduğundan merkezi farkın hatası $O(h^2)$'dir; tek yönlü farkta $L''$ terimi kalır ve hata $O(h)$ olur. Karşılaştırma için bağıl hata kullanılır:
$$ e = \frac{\lVert g_{\text{analitik}} - g_{\text{sayısal}}\rVert}{\lVert g_{\text{analitik}}\rVert + \lVert g_{\text{sayısal}}\rVert} $$for idx in np.ndindex(A.shape): # A: bir parametre dizisi (ör. W1)
eski = A[idx]
A[idx] = eski + h; L_arti = kayip(...)
A[idx] = eski - h; L_eksi = kayip(...)
A[idx] = eski
G[idx] = (L_arti - L_eksi) / (2 * h)Kodda 3 girdili, 5 ve 4 gizli birimli küçük bir ağı 8 rastgele örnekle denetledik. tanh aktivasyonuyla hem MSE hem çapraz entropi için bütün parametre dizilerinde bağıl hata $3{,}3\times10^{-11}$ ile $6{,}8\times10^{-10}$ arasında çıktı. Kabaca kural şudur: $10^{-7}$'nin altı doğru, $10^{-4}$'ün üstü neredeyse kesinlikle hatalı bir gradyandır.
$h$'nin seçimi de önemlidir. Aynı denetimi $W_1$ için farklı $h$ değerleriyle tekrarladık: $h = 10^{-2}$'de $5{,}9\times10^{-5}$, $h = 10^{-4}$'te $5{,}9\times10^{-9}$, $h = 10^{-6}$'da $6{,}0\times10^{-10}$, $h = 10^{-8}$'de $4{,}8\times10^{-8}$. $h$ 100 kat küçülünce hata önce $10^4$ kat azalıyor; bu, $O(h^2)$ kesme hatasıdır. Çok küçük $h$'de ise iki yakın sayının farkı yuvarlama hatasına boğuluyor ve hata yeniden büyüyor. Kontrolü bu yüzden float64 ile ve $h \approx 10^{-5}$–$10^{-6}$ ile yapın.
ReLU ile kontrol: kırık noktası tuzağı
Aynı denetimi ReLU ile yaptığımızda $\vect b_2$ için bağıl hata $1{,}7\times10^{-1}$ çıktı; diğer bütün dizilerde $10^{-11}$ mertebesindeydi. Hata kodda değil, ReLU'nun kırık noktasında. Bu örnekte bazı girdiler için birinci katmandaki bütün ReLU'lar kapalı; o satırlarda $A_1 = 0$ ve sapmalar sıfırla başladığı için $Z_2$ tam olarak 0. Toplam 12 ön-aktivasyon kırığın tam üstünde duruyor. Merkezi fark, kırığın iki yanındaki eğimlerin ortalamasını ölçer; analitik kod ise $\varphi'(0) = 0$ kabul eder. Gradyan kontrolünü düzgün aktivasyonlarla yapın ya da $|z| < h$ olan ön-aktivasyonları sayıp bu durumu ayıklayın.
7. Başlatma ve mini-yığın SGD
Simetriyi bozmak
Bütün ağırlıkları aynı değerle başlatırsak ne olur? Aynı katmandaki bütün birimler aynı girdiyi aynı ağırlıklarla alır, aynı çıktıyı üretir ve geri yayılımda aynı gradyanı alır. Güncellemeden sonra da aynı kalırlar. Ağ ne kadar geniş olursa olsun, her katman tek bir birim gibi davranır. Kodda bütün ağırlıkları 0,5 ile başlatıp 200 adım eğittik: birinci katmandaki birimler arasındaki en büyük fark tam olarak 0 çıktı. Rastgele (Xavier) başlatmada aynı fark 1,34'tü. Sapmaları sıfırdan başlatmak ise sorun değildir; simetriyi ağırlıklar zaten bozar.
Ölçeği korumak: Xavier ve He
Ağırlıkların büyüklüğü de önemlidir. $z = \sum_j w_j a_j$ toplamında ağırlıklar sıfır ortalamalı ve bağımsızsa ön-aktivasyonun varyansı şöyledir:
$$ \operatorname{Var}(z) = n_g\,\operatorname{Var}(w)\,\E[a^2] $$Burada $n_g$, birime giren bağlantı sayısıdır (fan-in). $\E[a^2]$ bir önceki katmanın varyansıyla orantılı olduğundan, $n_g\operatorname{Var}(w)$ çarpımı uygun değerin altındaysa sinyal her katmanda küçülür, üstündeyse büyür; derin bir ağda bu küçülme ya da büyüme üstel olur. Glorot ve Bengio (2010) tanh gibi sıfır çevresinde doğrusala yakın aktivasyonlar için $\operatorname{Var}(w) = 2/(n_g + n_ç)$ önerdi (Xavier başlatması; $n_ç$ çıkan bağlantı sayısı). ReLU negatif yarıyı sıfırladığı için $\E[a^2] = \operatorname{Var}(z_{\text{önceki}})/2$ olur. Bu kaybı telafi eden He başlatması $\operatorname{Var}(w) = 2/n_g$'dir (He vd., 2015).
Etkiyi kodda 20 katmanlı, katman başına 256 birimli bir ReLU ağında ölçtük. Girdinin standart sapması 1 iken son katmandaki ön-aktivasyonun standart sapması:
| Başlatma | Son katman std | Yorum |
|---|---|---|
| $\mathcal N(0;\ 0{,}01^2)$ | 1,4×10⁻¹⁹ | Sinyal kayboldu; gradyan da kaybolur |
| Xavier, $\operatorname{Var}(w) = 2/(n_g+n_ç)$ | 9,1×10⁻⁴ | Her ReLU katmanında varyans yarıya iniyor |
| He, $\operatorname{Var}(w) = 2/n_g$ | 1,4 | Ölçek korunuyor |
He satırındaki 1,4 değeri, $\sqrt2$'dir. İlk katmanın girdisi ReLU'dan geçmediği için ilk ön-aktivasyonun varyansı 2 olur; sonraki katmanlar bu değeri korur. Xavier satırında ise varyans 19 kez yarıya iniyor: $2^{-19/2} \approx 1{,}4\times10^{-3}$, ölçülen değerle aynı mertebede. Bu derste tanh kullandığımız için Xavier'i seçiyoruz.
Mini-yığın gradyan inişi
Ders 02'deki gradyan inişi her adımda bütün veriyi kullanıyordu. Sinir ağlarında bunun yerine mini-yığın (mini-batch) kullanılır:
- Her dönemin (epoch, verinin bir kez baştan sona geçilmesi) başında örneklerin sırasını karıştırın.
- Veriyi $B$ örneklik yığınlara bölün.
- Her yığın için ileri yayılım, geri yayılım ve güncelleme yapın: $\theta \leftarrow \theta - \eta\,\nabla_\theta L_B$.
Bir yığının gradyanı, bütün verinin gradyanının yansız ama gürültülü bir tahminidir; gürültü kabaca $1/\sqrt B$ ile azalır. Bu gürültü hem işe yarar (eğitimin eyer noktalarında ve düz bölgelerde takılıp kalmasını zorlaştırır) hem de sorun çıkarır (eğitimin sonunda ağırlıklar minimum çevresinde titrer). Titremeyi azaltmak için öğrenme hızını eğitim boyunca düşürüyoruz. Kodda kosinüs biçimli bir azaltma kullandık; $D$ toplam dönem sayısı olmak üzere $d$. dönemde:
$$ \eta_d = \eta_0\,\tfrac12\Big(1+\cos\frac{\pi d}{D}\Big) $$for d in range(donem):
eta = ogrenme_hizi * 0.5 * (1.0 + np.cos(np.pi * d / donem))
sira = rng.permutation(n) # her dönem karıştır
for i in range(0, n, yigin):
j = sira[i:i + yigin]
Z3, onb = ileri(P, X[j], akt)
_, d3 = kayip_ve_delta(Z3, Y[j], tur)
g = geri(P, onb, d3, akt)
for k in P:
P[k] -= eta * g[k]Son bir uyarı: hem girdileri hem de regresyon hedefini standartlaştırıyoruz. Gerinim $10^{-3}$, gerilme $10^2$ mertebesindeyken ham birimlerle eğitmek, Ders 02'de gördüğümüz basık kayıp yüzeyi sorununu sinir ağına da taşır. Ortalama ve standart sapma yalnızca eğitim verisinden hesaplanır.
Kendiniz deneyin
Aşağıdaki denemede aynı fikirleri tarayıcıda, canlı olarak görebilirsiniz. Model listesinde Sinir ağı'nı seçin; gizli katman sayısını (1–2), katman başına nöron sayısını (2–32), aktivasyonu (tanh/ReLU) ve öğrenme hızını değiştirip Eğit düğmesine basın. Arka plan rengi sınıf olasılığını, koyu çizgi $p = 0{,}5$ karar sınırını gösterir. Denemedeki ağ, bu dersteki SGD yerine Ders 12'de göreceğimiz Adam ile eğitilir.
- XOR veri kümesinde tek gizli katman ve 2 nöronla başlayın, sonra 4 nörona çıkın. Hangi durumda karar sınırı dört bölgeyi ayırabiliyor?
- Sarmal'da iki gizli katmanla 2, 8 ve 32 nöronu karşılaştırın; okuma kutusundaki eğitim ve test doğruluğunu Şekil 3 ile kıyaslayın.
- Aynı ağı tanh ve ReLU ile eğitin. ReLU'nun karar sınırının köşeli, tanh'ınkinin yumuşak olduğuna dikkat edin.
- Gürültü'yü artırın ve 32 nöronlu ağı uzun süre eğitin. “Test noktalarını göster” kutusunu açıp eğitim ile test doğruluğu arasındaki farkı izleyin.
Bu etkileşimli deneme için tarayıcıda JavaScript açık olmalıdır.
8. Çalıştırılabilir kod
Betik yalnızca NumPy ve Matplotlib kullanıyor. Yedi bölümden oluşuyor: aktivasyonlar, ağın ileri ve geri yayılımı, gradyan kontrolü, başlatma deneyleri, Ramberg–Osgood regresyonu, sarmal sınıflandırması ve grafikler. Çalışması birkaç on saniye sürer; süre bilgisayarınıza göre değişir. Kurulum için Ders 01'deki adımları izleyin.
"""Ders 11 — Yapay sinir ağları: sıfırdan geri yayılım.
İki gizli katmanlı bir sinir ağını yalnızca NumPy ile kuruyoruz: ileri yayılım, geri yayılım,
merkezi farkla gradyan kontrolü, başlatma ve mini-yığın gradyan inişi (SGD). İki örnek var:
1) Regresyon: bir alüminyum alaşımının Ramberg–Osgood eğrisi ε = σ/E + 0,002·(σ/f0,2)^n
verildiğinde ters ilişki σ(ε)'yi gürültülü örneklerden öğrenmek; polinomla karşılaştırmak.
2) Sınıflandırma: iç içe iki sarmal; gizli katman genişliğinin karar sınırına etkisi.
Veriler sentetiktir. E = 70 GPa, f0,2 = 160 MPa, n = 20 örnek amaçlı seçilmiş değerlerdir;
belirli bir alaşımın tasarım değerleri değildir. Ölçüm gürültüsü normal dağılımla eklenir.
Çalıştır: python d11_sinir_agi_sifirdan.py
Gerekenler: numpy, matplotlib (Python 3.12+)
Süre: yaklaşık 10–40 s (bilgisayara göre)
Çıktılar: terminale sayılar, aynı klasöre üç PNG grafiği
"""
import math
from pathlib import Path
import numpy as np
import matplotlib
matplotlib.use("Agg") # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from matplotlib.colors import LinearSegmentedColormap
# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
"figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
"axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
"axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
"xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
"axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
"axes.spines.top": False, "axes.spines.right": False,
"axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent
rng = np.random.default_rng(42)
# %% 1. Aktivasyon fonksiyonları ve türevleri
def sigmoid(z):
return 1.0 / (1.0 + np.exp(-z))
def gelu(z):
"""GELU(z) = z·Φ(z); Φ standart normal dağılım fonksiyonu."""
Phi = 0.5 * (1.0 + np.vectorize(math.erf)(z / math.sqrt(2.0)))
return z * Phi
AKT = { # ad: (φ(z), φ'(z))
"tanh": (np.tanh, lambda z: 1.0 - np.tanh(z) ** 2),
"relu": (lambda z: np.maximum(z, 0.0), lambda z: (z > 0).astype(float)),
"sigmoid": (sigmoid, lambda z: sigmoid(z) * (1.0 - sigmoid(z))),
}
print("=== 1. Aktivasyon fonksiyonları ===")
print(f"En büyük türevler: sigmoid'(0) = {AKT['sigmoid'][1](0.0):.2f}, tanh'(0) = {AKT['tanh'][1](0.0):.2f}, "
f"ReLU'(z>0) = 1")
print(f"10 sigmoid katmanında aktivasyon türevlerinden gelen çarpan en fazla 0.25^10 = {0.25**10:.1e}")
# %% 2. İki gizli katmanlı ağ: ileri ve geri yayılım (satır = örnek)
def baslat(boyutlar, yontem, rng):
"""boyutlar = [p, h1, h2, 1]. Xavier: Var(w) = 2/(n_g + n_ç) (tanh); He: Var(w) = 2/n_g (ReLU)."""
P = {}
for l, (n_g, n_c) in enumerate(zip(boyutlar[:-1], boyutlar[1:]), start=1):
std = np.sqrt(2.0 / (n_g + n_c)) if yontem == "xavier" else np.sqrt(2.0 / n_g)
P[f"W{l}"] = rng.normal(0.0, std, (n_g, n_c))
P[f"b{l}"] = np.zeros(n_c)
return P
def ileri(P, X, akt):
f = AKT[akt][0]
Z1 = X @ P["W1"] + P["b1"] # (n, h1)
A1 = f(Z1)
Z2 = A1 @ P["W2"] + P["b2"] # (n, h2)
A2 = f(Z2)
Z3 = A2 @ P["W3"] + P["b3"] # (n, 1): regresyonda ŷ, sınıflandırmada logit
return Z3, (X, Z1, A1, Z2, A2)
def kayip_ve_delta(Z3, Y, tur):
"""Kayıp ve δ3 = ∂L/∂Z3. MSE: L = (1/n)Σ(ŷ−y)²; BCE: L = (1/n)Σ[log(1+e^z) − y·z]."""
n = len(Y)
if tur == "mse":
return np.mean((Z3 - Y) ** 2), 2.0 * (Z3 - Y) / n
return np.mean(np.logaddexp(0.0, Z3) - Y * Z3), (sigmoid(Z3) - Y) / n
def geri(P, onbellek, d3, akt):
"""Zincir kuralı, matris biçiminde: dW = Aᵀδ, db = δ'nın sütun toplamı, δ_önceki = (δWᵀ)⊙φ'(Z)."""
X, Z1, A1, Z2, A2 = onbellek
fp = AKT[akt][1]
g = {"W3": A2.T @ d3, "b3": d3.sum(axis=0)}
d2 = (d3 @ P["W3"].T) * fp(Z2)
g["W2"], g["b2"] = A1.T @ d2, d2.sum(axis=0)
d1 = (d2 @ P["W2"].T) * fp(Z1)
g["W1"], g["b1"] = X.T @ d1, d1.sum(axis=0)
return g
def egit(P, X, Y, akt, tur, ogrenme_hizi, yigin, donem, rng):
"""Mini-yığın SGD; öğrenme hızı kosinüs eğrisiyle η0'dan sıfıra iner."""
n = len(X)
for d in range(donem):
    eta = ogrenme_hizi * 0.5 * (1.0 + np.cos(np.pi * d / donem))
    sira = rng.permutation(n)                 # her dönem karıştır
    for i in range(0, n, yigin):
        j = sira[i:i + yigin]
        Z3, onb = ileri(P, X[j], akt)
        _, d3 = kayip_ve_delta(Z3, Y[j], tur)
        g = geri(P, onb, d3, akt)
        for k in P:
            P[k] -= eta * g[k]
return P
def parametre_sayisi(P):
return sum(v.size for v in P.values())
# %% 3. Gradyan kontrolü: analitik gradyan ile merkezi farkı karşılaştır
def sayisal_gradyan(P, X, Y, akt, tur, h=1e-6):
G = {}
for k, A in P.items():
G[k] = np.zeros_like(A)
for idx in np.ndindex(A.shape):
eski = A[idx]
A[idx] = eski + h
L_arti = kayip_ve_delta(ileri(P, X, akt)[0], Y, tur)[0]
A[idx] = eski - h
L_eksi = kayip_ve_delta(ileri(P, X, akt)[0], Y, tur)[0]
A[idx] = eski
G[k][idx] = (L_arti - L_eksi) / (2 * h)
return G
def bagil_hata(a, b):
return np.linalg.norm(a - b) / max(np.linalg.norm(a) + np.linalg.norm(b), 1e-300)
print("\n=== 2. Gradyan kontrolü (merkezi fark, h = 1e-6, float64) ===")
Xk = rng.normal(size=(8, 3))
for akt, tur in [("tanh", "mse"), ("tanh", "bce"), ("relu", "mse")]:
Yk = rng.normal(size=(8, 1)) if tur == "mse" else rng.integers(0, 2, (8, 1)).astype(float)
Pk = baslat([3, 5, 4, 1], "xavier", rng)
Z3, onb = ileri(Pk, Xk, akt)
g_ana = geri(Pk, onb, kayip_ve_delta(Z3, Yk, tur)[1], akt)
g_say = sayisal_gradyan(Pk, Xk, Yk, akt, tur)
hatalar = {k: bagil_hata(g_ana[k], g_say[k]) for k in Pk}
print(f"{akt:4s} + {tur.upper():3s}: " + ", ".join(f"{k} {v:.1e}" for k, v in hatalar.items()))
if akt == "relu": # ReLU'nun z = 0'da kırığı var; orada türev tanımsız
kirik = int(np.sum(np.abs(onb[1]) < 1e-6) + np.sum(np.abs(onb[3]) < 1e-6))
print(f" ReLU: kırık noktasında (|z| < h) duran ön-aktivasyon sayısı = {kirik}")
assert kirik > 0 or max(hatalar.values()) < 1e-7
else:
assert max(hatalar.values()) < 1e-7
if tur == "mse":
Pt, Xt, Yt, gt = Pk, Xk, Yk, g_ana["W1"]
print("h'nin etkisi (tanh + MSE, W1): " + ", ".join(
f"h = {h:.0e}: {bagil_hata(gt, sayisal_gradyan(Pt, Xt, Yt, 'tanh', 'mse', h)['W1']):.1e}"
for h in [1e-2, 1e-4, 1e-6, 1e-8]))
# %% 4. Başlatma: simetri bozma ve katmanlar boyunca ölçek
print("\n=== 3. Başlatma ===")
Xs = rng.uniform(-1, 1, (64, 1))
Ys = np.sin(3 * Xs)
donem_s, yigin_s = 50, 16
adim_s = donem_s * -(-len(Xs) // yigin_s) # dönem × dönem başına yığın sayısı
for ad, P0 in [("hepsi 0.5", {k: (np.full_like(v, 0.5) if k[0] == "W" else v.copy())
for k, v in baslat([1, 8, 8, 1], "xavier", rng).items()}),
("Xavier", baslat([1, 8, 8, 1], "xavier", rng))]:
P0 = egit(P0, Xs, Ys, "tanh", "mse", 0.1, yigin_s, donem_s, rng)
fark = np.abs(P0["W1"] - P0["W1"][:, :1]).max() # gizli birimler birbirinden ne kadar farklı?
print(f"Başlangıç {ad:9s}: {adim_s} adım sonra 1. katman birimleri arasındaki en büyük fark = {fark:.2e}")
Xd = rng.normal(size=(500, 256))
olcek = {}
for ad, std in [("N(0, 0.01²)", 0.01), ("Xavier", np.sqrt(2 / 512)), ("He", np.sqrt(2 / 256))]:
A = Xd
for _ in range(20): # 20 gizli katman, ReLU
Z = A @ rng.normal(0, std, (256, 256))
A = np.maximum(Z, 0)
olcek[ad] = Z.std()
print("20 katmanlı ReLU ağında son katman ön-aktivasyonunun std'si (girdi std = 1): "
+ ", ".join(f"{k}: {v:.1e}" for k, v in olcek.items()))
# %% 5. Örnek 1 — Ramberg–Osgood: σ(ε) regresyonu
E_MOD, F02, N_RO = 70_000.0, 160.0, 20.0 # MPa, MPa, - (örnek değerler)
EPS_UST = 0.015 # eğitim verisinin gerinim üst sınırı (%1,5)
GURULTU = 2.0 # MPa, gerilme ölçüm gürültüsünün std'si
def eps_ro(s):
return s / E_MOD + 0.002 * (s / F02) ** N_RO
def sigma_ro(eps, iterasyon=60):
"""ε(σ) monoton artan → σ(ε)'yı ikiye bölme (bisection) ile bul; kapalı biçimi yok."""
alt, ust = np.zeros_like(eps), np.full_like(eps, 2 * F02)
for _ in range(iterasyon):
orta = 0.5 * (alt + ust)
buyuk = eps_ro(orta) > eps
ust, alt = np.where(buyuk, orta, ust), np.where(buyuk, alt, orta)
return 0.5 * (alt + ust)
n_eg, n_dog = 200, 60
eps = rng.uniform(0, EPS_UST, n_eg + n_dog)
sig = sigma_ro(eps) + rng.normal(0, GURULTU, eps.size)
eg, dog = np.arange(n_eg), np.arange(n_eg, n_eg + n_dog)
izgara = np.linspace(0, EPS_UST, 1001)
sig_izgara = sigma_ro(izgara)
assert np.allclose(eps_ro(sig_izgara), izgara, atol=1e-12)
# standartlaştırma (yalnız eğitim verisinin istatistikleriyle)
mx, sx = eps[eg].mean(), eps[eg].std()
my, sy = sig[eg].mean(), sig[eg].std()
X = ((eps - mx) / sx)[:, None]
Y = ((sig - my) / sy)[:, None]
def ag_tahmin(P, e):
return ileri(P, ((e - mx) / sx)[:, None], "tanh")[0][:, 0] * sy + my
P_ro = baslat([1, 16, 16, 1], "xavier", rng)
P_ro = egit(P_ro, X[eg], Y[eg], "tanh", "mse", 0.2, 16, 2000, rng)
def rmse(a, b):
return np.sqrt(np.mean((a - b) ** 2))
ag = {"eğitim": rmse(ag_tahmin(P_ro, eps[eg]), sig[eg]), "doğrulama": rmse(ag_tahmin(P_ro, eps[dog]), sig[dog]),
"gerçek eğri": rmse(ag_tahmin(P_ro, izgara), sig_izgara)}
hata_ag = ag_tahmin(P_ro, izgara) - sig_izgara
# polinom regresyonu: derece doğrulama RMSE'siyle seçilir (Polynomial.fit girdiyi [-1, 1]'e ölçekler)
pol_sonuc = []
for derece in range(1, 21):
pol = np.polynomial.Polynomial.fit(eps[eg], sig[eg], derece)
pol_sonuc.append((rmse(pol(eps[dog]), sig[dog]), derece, pol))
_, d_en_iyi, pol = min(pol_sonuc, key=lambda s: s[0])
pk = {"eğitim": rmse(pol(eps[eg]), sig[eg]), "doğrulama": rmse(pol(eps[dog]), sig[dog]),
"gerçek eğri": rmse(pol(izgara), sig_izgara)}
hata_pol = pol(izgara) - sig_izgara
print("\n=== 4. Örnek 1: Ramberg–Osgood eğrisini öğrenmek ===")
print(f"Veri: {n_eg} eğitim + {n_dog} doğrulama ölçümü, ε ∈ [0, {EPS_UST}], gürültü std = {GURULTU} MPa; "
f"gerçek σ aralığı 0–{sig_izgara.max():.1f} MPa")
print(f"Eğitim ölçümlerine eklenen gürültünün gerçekleşen RMS'si: {rmse(sig[eg], sigma_ro(eps[eg])):.2f} MPa")
print(f"Ağ 1-16-16-1 (tanh, {parametre_sayisi(P_ro)} parametre), SGD: yığın 16, η0 = 0.2, 2000 dönem")
for ad, s in [("Sinir ağı", ag), (f"Polinom (derece {d_en_iyi})", pk)]:
print(f"{ad:20s}: RMSE eğitim {s['eğitim']:.2f}, doğrulama {s['doğrulama']:.2f}, "
f"gerçek eğriye göre {s['gerçek eğri']:.2f} MPa")
for ad, h in [("Sinir ağı", hata_ag), ("Polinom", hata_pol)]:
i = np.argmax(np.abs(h))
print(f"{ad:20s}: gerçek eğriden en büyük sapma {h[i]:+.2f} MPa (ε = %{izgara[i]*100:.2f})")
buyuk_hata = izgara[np.abs(hata_ag) > 1.0]
print(f"Sinir ağının hatası 1 MPa'yı yalnızca ε < %{buyuk_hata.max()*100:.2f} bölgesinde aşıyor "
f"({len(buyuk_hata)} / {len(izgara)} ızgara noktası)")
dis = np.array([0.0175, 0.02])
print("Aralık dışı ε = %1.75 ve %2: gerçek " + ", ".join(f"{v:.1f}" for v in sigma_ro(dis))
+ " | ağ " + ", ".join(f"{v:.1f}" for v in ag_tahmin(P_ro, dis))
+ " | polinom " + ", ".join(f"{v:.1e}" for v in pol(dis)) + " MPa")
assert ag["gerçek eğri"] < GURULTU
# %% 6. Örnek 2 — Sarmal: gizli katman genişliğinin etkisi
def sarmal(n, rng, gurultu=0.08, tur=1.5):
t = np.sqrt(rng.uniform(0.02, 1.0, n)) # yarıçap; merkezde seyrek
k = rng.integers(0, 2, n) # sınıf
aci = 2 * np.pi * tur * t + np.pi * k # iki kol yarım tur kaydırılmış
X = np.column_stack([t * np.cos(aci), t * np.sin(aci)]) + rng.normal(0, gurultu, (n, 2))
return X, k.astype(float)[:, None]
Xs_eg, ys_eg = sarmal(400, rng)
Xs_te, ys_te = sarmal(400, rng)
m_s, s_s = Xs_eg.mean(axis=0), Xs_eg.std(axis=0) # girdileri standartlaştır (eğitim istatistiği)
print("\n=== 5. Örnek 2: sarmal, iki gizli katman, tanh ===")
sarmal_ag = {}
for h in [2, 4, 8, 32]:
P = baslat([2, h, h, 1], "xavier", rng)
P = egit(P, (Xs_eg - m_s) / s_s, ys_eg, "tanh", "bce", 0.3, 32, 500, rng)
z_eg, z_te = ileri(P, (Xs_eg - m_s) / s_s, "tanh")[0], ileri(P, (Xs_te - m_s) / s_s, "tanh")[0]
d_eg, d_te = np.mean((z_eg > 0) == ys_eg), np.mean((z_te > 0) == ys_te)
L_te = kayip_ve_delta(z_te, ys_te, "bce")[0]
sarmal_ag[h] = (P, d_eg, d_te)
print(f"h = {h:2d} ({parametre_sayisi(P):4d} parametre): "
f"doğruluk eğitim %{d_eg*100:.1f}, test %{d_te*100:.1f}; test çapraz entropisi {L_te:.3f}")
# %% 7. Grafikler
z = np.linspace(-4, 4, 401)
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
egriler = [("sigmoid", sigmoid(z), AKT["sigmoid"][1](z)), ("tanh", np.tanh(z), AKT["tanh"][1](z)),
("ReLU", np.maximum(z, 0), (z > 0).astype(float))]
g_z = gelu(z)
g_t = np.gradient(g_z, z) # GELU türevi (yalnız çizim için sayısal)
for i, (ad, f, fp) in enumerate(egriler):
ax[0].plot(z, f, color=RENK[i], label=ad)
ax[1].plot(z, fp, color=RENK[i], label=ad)
ax[0].plot(z, g_z, color=RENK[3], ls="--", lw=1.5, label="GELU")
ax[1].plot(z, g_t, color=RENK[3], ls="--", lw=1.5, label="GELU")
ax[0].set(xlabel="z", ylabel="φ(z)", title="Aktivasyon fonksiyonları", ylim=(-1.3, 4.1))
ax[1].set(xlabel="z", ylabel="φ′(z)", title="Türevleri: gradyan bu katsayılarla çarpılır", ylim=(-0.15, 1.2))
ax[0].legend(loc="upper left")
ax[1].legend(loc="upper left")
fig.savefig(KLASOR / "d11_sinir_agi_sifirdan_1.png", dpi=160)
plt.close(fig)
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
genis = np.linspace(0, 0.02, 801)
ax[0].axvspan(EPS_UST * 100, 2.0, color="#f1f0eb", lw=0, label="Eğitim aralığı dışı")
ax[0].scatter(eps[eg] * 100, sig[eg], s=10, color=SOLUK, alpha=.7, label="Ölçüm (sentetik)")
ax[0].plot(genis * 100, sigma_ro(genis), color=MUREKKEP, ls="--", lw=1.2, label="Gerçek Ramberg–Osgood")
ax[0].plot(genis * 100, ag_tahmin(P_ro, genis), color=RENK[0], label="Sinir ağı 1-16-16-1")
ax[0].plot(genis * 100, pol(genis), color=RENK[1], ls=":", label=f"Polinom, derece {d_en_iyi}")
ax[0].set(xlabel="Gerinim ε (%)", ylabel="Gerilme σ (MPa)", title="σ(ε) eğrisini öğrenmek", ylim=(-10, 230))
ax[0].legend(loc="lower right")
ax[1].axhspan(-GURULTU, GURULTU, color="#f1f0eb", lw=0, label="± gürültü std (2 MPa)")
ax[1].axhline(0, color=MUREKKEP, lw=1)
ax[1].plot(izgara * 100, hata_ag, color=RENK[0], label=f"Sinir ağı (RMSE {ag['gerçek eğri']:.2f} MPa)")
ax[1].plot(izgara * 100, hata_pol, color=RENK[1], ls=":", label=f"Polinom (RMSE {pk['gerçek eğri']:.2f} MPa)")
ax[1].set(xlabel="Gerinim ε (%)", ylabel="Tahmin − gerçek σ (MPa)",
title="Gerçek eğriden sapma (eğitim aralığı)")
ax[1].legend(loc="upper right")
fig.savefig(KLASOR / "d11_sinir_agi_sifirdan_2.png", dpi=160)
plt.close(fig)
renk_haritasi = LinearSegmentedColormap.from_list("mavi_turuncu", [RENK[0], "#ffffff", RENK[1]])
g1, g2 = np.meshgrid(np.linspace(-1.35, 1.35, 250), np.linspace(-1.35, 1.35, 250))
G = np.column_stack([g1.ravel(), g2.ravel()])
fig, axs = plt.subplots(2, 2, figsize=(8.4, 7.6), layout="constrained") # kare paneller
for a, (h, (P, d_eg, d_te)) in zip(axs.ravel(), sarmal_ag.items()):
p = sigmoid(ileri(P, (G - m_s) / s_s, "tanh")[0][:, 0]).reshape(g1.shape)
a.contourf(g1, g2, p, levels=np.linspace(0, 1, 6), cmap=renk_haritasi, alpha=.55)
a.grid(False)
a.contour(g1, g2, p, levels=[0.5], colors=MUREKKEP, linewidths=1.3)
sinif = ys_eg[:, 0] == 1
a.scatter(*Xs_eg[~sinif].T, s=8, color=RENK[0], linewidths=0, label="Sınıf 0 (eğitim)")
a.scatter(*Xs_eg[sinif].T, s=8, color=RENK[1], linewidths=0, label="Sınıf 1 (eğitim)")
a.set(title=f"h = {h} · eğitim %{d_eg*100:.1f} · test %{d_te*100:.1f}", xlabel="x₁", ylabel="x₂",
aspect="equal", xlim=(-1.35, 1.35), ylim=(-1.35, 1.35))
axs[0, 0].legend(loc="lower left", fontsize=8.5)
fig.savefig(KLASOR / "d11_sinir_agi_sifirdan_3.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d11_sinir_agi_sifirdan_1.png, _2.png, _3.png")=== 1. Aktivasyon fonksiyonları ===
En büyük türevler: sigmoid'(0) = 0.25, tanh'(0) = 1.00, ReLU'(z>0) = 1
10 sigmoid katmanında aktivasyon türevlerinden gelen çarpan en fazla 0.25^10 = 9.5e-07
=== 2. Gradyan kontrolü (merkezi fark, h = 1e-6, float64) ===
tanh + MSE: W1 6.0e-10, b1 1.9e-10, W2 3.6e-10, b2 3.3e-11, W3 5.1e-10, b3 5.4e-11
tanh + BCE: W1 5.9e-10, b1 5.9e-10, W2 6.8e-10, b2 2.6e-10, W3 3.1e-10, b3 1.2e-10
relu + MSE: W1 5.7e-11, b1 3.5e-11, W2 6.1e-11, b2 1.7e-01, W3 2.9e-11, b3 6.4e-11
ReLU: kırık noktasında (|z| < h) duran ön-aktivasyon sayısı = 12
h'nin etkisi (tanh + MSE, W1): h = 1e-02: 5.9e-05, h = 1e-04: 5.9e-09, h = 1e-06: 6.0e-10, h = 1e-08: 4.8e-08
=== 3. Başlatma ===
Başlangıç hepsi 0.5: 200 adım sonra 1. katman birimleri arasındaki en büyük fark = 0.00e+00
Başlangıç Xavier : 200 adım sonra 1. katman birimleri arasındaki en büyük fark = 1.34e+00
20 katmanlı ReLU ağında son katman ön-aktivasyonunun std'si (girdi std = 1): N(0, 0.01²): 1.4e-19, Xavier: 9.1e-04, He: 1.4e+00
=== 4. Örnek 1: Ramberg–Osgood eğrisini öğrenmek ===
Veri: 200 eğitim + 60 doğrulama ölçümü, ε ∈ [0, 0.015], gürültü std = 2.0 MPa; gerçek σ aralığı 0–175.3 MPa
Eğitim ölçümlerine eklenen gürültünün gerçekleşen RMS'si: 1.98 MPa
Ağ 1-16-16-1 (tanh, 321 parametre), SGD: yığın 16, η0 = 0.2, 2000 dönem
Sinir ağı : RMSE eğitim 1.97, doğrulama 2.24, gerçek eğriye göre 0.52 MPa
Polinom (derece 19) : RMSE eğitim 1.93, doğrulama 2.19, gerçek eğriye göre 1.05 MPa
Sinir ağı : gerçek eğriden en büyük sapma +3.22 MPa (ε = %0.00)
Polinom : gerçek eğriden en büyük sapma +16.86 MPa (ε = %0.00)
Sinir ağının hatası 1 MPa'yı yalnızca ε < %0.23 bölgesinde aşıyor (61 / 1001 ızgara noktası)
Aralık dışı ε = %1.75 ve %2: gerçek 176.9, 178.3 | ağ 176.9, 177.9 | polinom 9.2e+04, 6.4e+06 MPa
=== 5. Örnek 2: sarmal, iki gizli katman, tanh ===
h = 2 ( 15 parametre): doğruluk eğitim %75.2, test %77.0; test çapraz entropisi 0.477
h = 4 ( 37 parametre): doğruluk eğitim %91.8, test %87.0; test çapraz entropisi 0.295
h = 8 ( 105 parametre): doğruluk eğitim %98.5, test %95.2; test çapraz entropisi 0.150
h = 32 (1185 parametre): doğruluk eğitim %98.2, test %95.2; test çapraz entropisi 0.107
Grafikler kaydedildi: d11_sinir_agi_sifirdan_1.png, _2.png, _3.png9. Örnek 1: Ramberg–Osgood eğrisini öğrenmek
Ağ 1 girdili, 16'şar tanh birimli iki gizli katmanlı ve tek çıktılıdır (1-16-16-1); toplam 321 parametresi var. Mini-yığın SGD ile $B = 16$, $\eta_0 = 0{,}2$ ve 2000 dönem eğittik. Karşılaştırma için polinom regresyonu kullandık: 1 ile 20 arasındaki dereceleri denedik ve doğrulama RMSE'si en küçük olanı seçtik. Seçilen derece 19 oldu.
| Model | Eğitim | Doğrulama | Gerçek eğri | En büyük sapma |
|---|---|---|---|---|
| Ağ 1-16-16-1 | 1,97 | 2,24 | 0,52 | +3,22 |
| Polinom (19) | 1,93 | 2,19 | 1,05 | +16,86 |
Eğitim ve doğrulama RMSE'leri iki modelde de gürültünün standart sapmasına (2 MPa) yakın. Yeni ölçümlerde (doğrulama) beklenen RMSE gürültünün standart sapmasının altına inemez. Eğitim RMSE'si ise model gürültünün bir kısmını ezberledikçe biraz altına inebilir: eğitim ölçümlerine eklenen gürültünün gerçekleşen RMS'si 1,98 MPa, modellerin eğitim RMSE'leri 1,97 ve 1,93 MPa. Bu yakınlık, iki modelin de büyük ölçüde sinyali öğrendiğine işaret eder. Asıl ayrım, gerçek eğriye göre ölçülen hatada ortaya çıkıyor. Ağın gerçek eğriden RMSE sapması 0,52 MPa, yani gürültünün dörtte biri: model çok sayıda gürültülü noktanın ortalamasını alıyor. Polinomun sapması bunun iki katı.
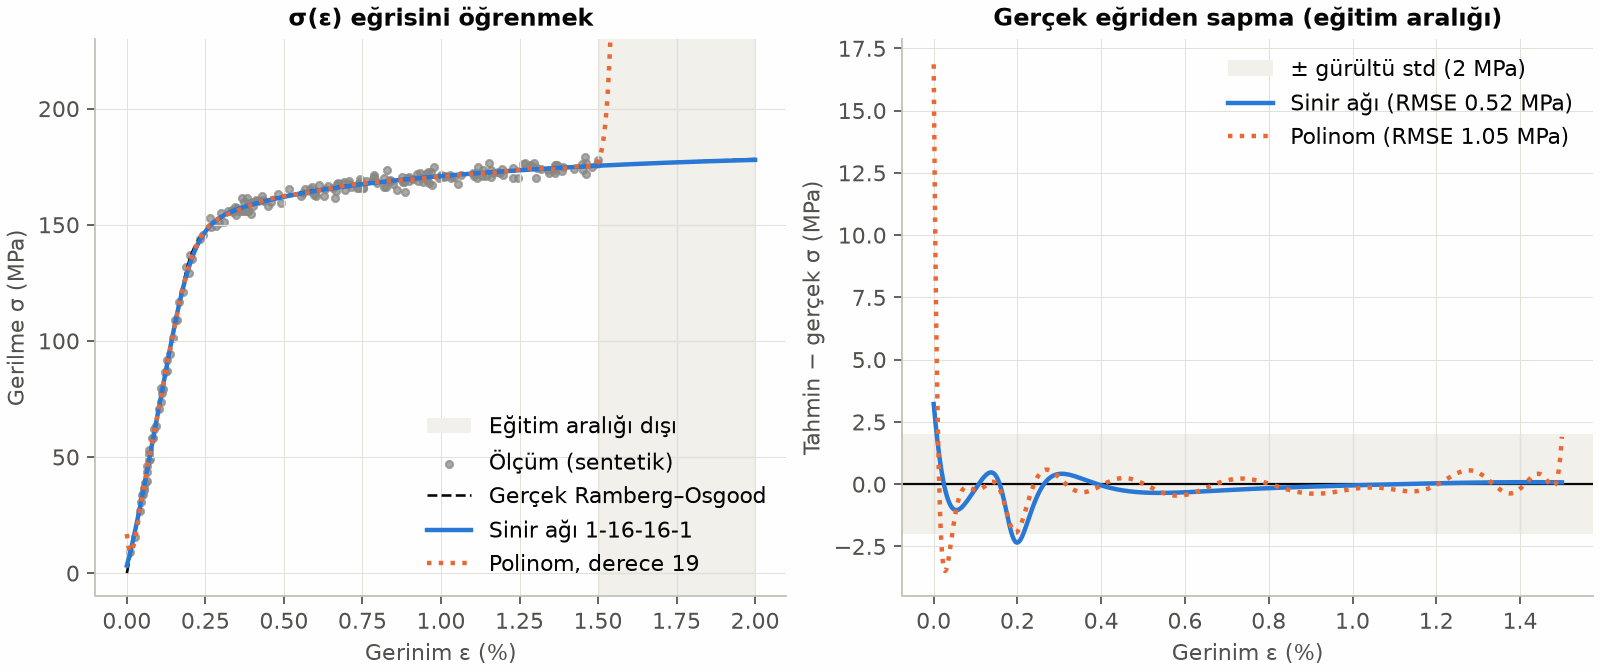
Sağ panel hataların nerede toplandığını gösteriyor. Polinomun en büyük sapması (+16,86 MPa) $\varepsilon = 0$'da, aralığın kenarında. Yüksek dereceli polinomlar veri aralığının uçlarında salınır (Runge olayı). Ağın en büyük sapması da $\varepsilon = 0$'da ama +3,22 MPa ile çok daha küçük. Ağın hataları gerinimin başında, yani elastik bölgede ve dizde toplanıyor: hata 1 MPa'yı yalnızca %0,23'ün altındaki gerinimlerde aşıyor. Ağ, elastik doğrudan plastik eğriye keskin geçişi biraz yuvarlıyor. Veri az olan ve eğriliğin hızla değiştiği yerler, her esnek modelin zayıf noktasıdır.
Eğitim aralığının dışı ise başka bir hikâye. $\varepsilon$ = %1,75 ve %2'de gerçek gerilme 176,9 ve 178,3 MPa. Ağ 176,9 ve 177,9 MPa veriyor; polinom $9{,}2\times10^{4}$ ve $6{,}4\times10^{6}$ MPa. Polinomun patlaması kaçınılmazdır: aralık dışında en yüksek dereceli terim baskın çıkar. Ağın iyi sonucu ise kısmen şanstır. tanh birimleri doyuma ulaştığı için çıktı yataylaşıyor; Ramberg–Osgood eğrisi de bu bölgede neredeyse yatay. Eğri aralık dışında yükselmeye devam etseydi ağ bunu bilemezdi. Ders 12'de aralık dışına çıkınca bozulan bir ağ göreceğiz.
Malzeme modeli olarak kullanmadan önce
Bir sonlu eleman programı yalnız $\sigma$'yı değil, Newton iterasyonları için teğet rijitliği $\dd\sigma/\dd\varepsilon$'yi de ister. Değerleri iyi tahmin eden bir model, türevi kötü tahmin edebilir: Alıştırma 4'te ağın $\varepsilon = 0$'daki eğimini 70 GPa ile karşılaştıracaksınız. Ayrıca gerçek $\sigma(\varepsilon)$ monoton artandır; ne polinom ne de bu ağ monotonluğu garanti eder. Bu tür fiziksel kısıtları modele katmanın yollarını Ders 16 ve Ders 17'de göreceğiz. Bu örnek eğitim amaçlıdır; tasarımda malzeme modeli, ilgili yönetmeliğin ve deney verisinin tanımladığı eğriden alınır.
10. Örnek 2: sarmal ve gizli katman genişliği
İkinci veri kümesinde iki sınıf, yarım tur kaydırılmış iki sarmal kol üzerinde. Kollar 1,5 tur dönüyor ve noktalara standart sapması 0,08 olan gürültü eklendi. 400 eğitim, 400 test noktası var. Aynı ağ yapısını (iki gizli katman, tanh, Xavier) dört farklı genişlikle, sigmoid çıkış ve çapraz entropiyle eğittik: $B = 32$, $\eta_0 = 0{,}3$, 500 dönem.
| $h$ | Parametre | Eğitim | Test | Test kaybı |
|---|---|---|---|---|
| 2 | 15 | %75,2 | %77,0 | 0,477 |
| 4 | 37 | %91,8 | %87,0 | 0,295 |
| 8 | 105 | %98,5 | %95,2 | 0,150 |
| 32 | 1185 | %98,2 | %95,2 | 0,107 |
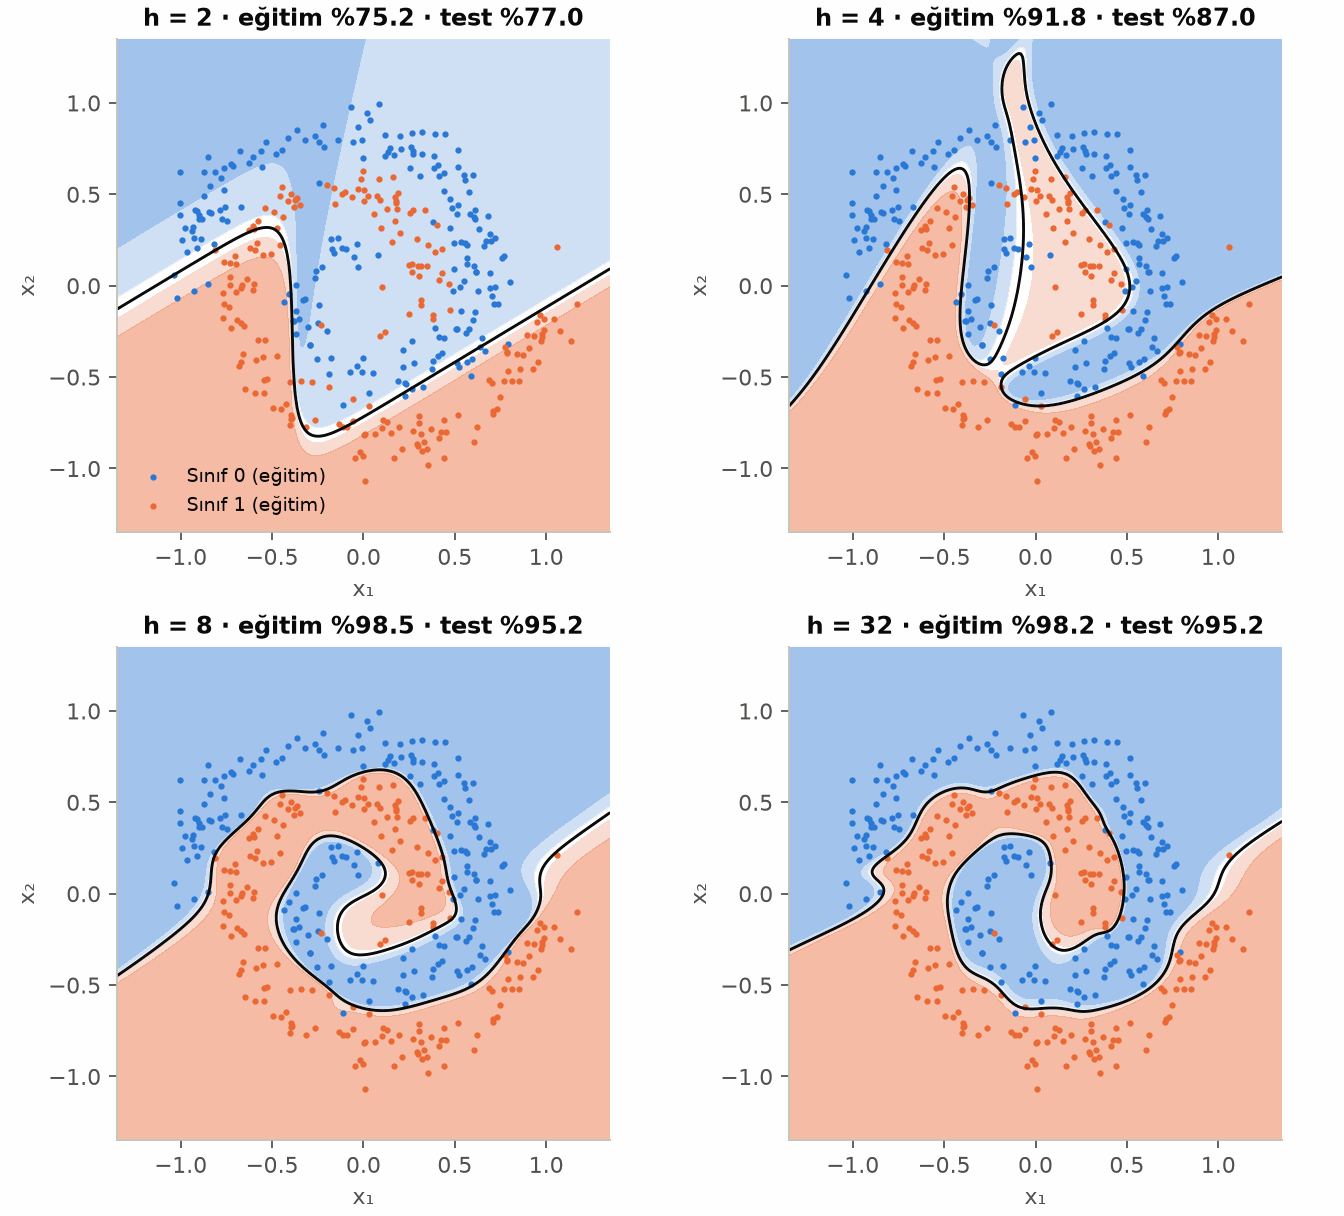
$h = 2$'de birinci katman yalnızca iki yumuşak “basamak” çizebilir; ikinci katman bu iki basamağı birleştirse de sarmalı saracak kıvrımları üretemez. Doğruluk %75–77'de kalıyor. $h = 4$'te sınır kolların bir kısmını izlemeye başlıyor. $h = 8$ ile sınır iki kolu da sarıyor ve test doğruluğu %95,2'ye çıkıyor. $h = 32$'nin test doğruluğu aynı, ama test çapraz entropisi daha düşük (0,107'ye karşı 0,150): olasılık tahminleri daha iyi, yani doğru sınıfa daha yüksek olasılık veriyor. Bu gürültü düzeyinde iki kolun üst üste bindiği noktalar olduğundan %100 doğruluk zaten beklenmez.
Bu tablo tek bir rastgele başlatmanın sonucudur. Farklı bir tohumla sayılar birkaç puan oynar; ama $h = 2$'nin sarmalı çözemediği, $h \ge 8$'in çözdüğü değişmez. Girdileri standartlaştırmanın burada da etkisi büyüktü: ham koordinatlarla yaptığımız ön denemelerde geniş ağ bazen düz bir bölgede takılıp %70 civarında kaldı.
11. Sık yapılan hatalar
- $\varphi'$'yi unutmak ya da yerine $\varphi$ yazmak. Ağ yine öğrenir, sadece kötü öğrenir. Gradyan kontrolü bunu hemen yakalar (Alıştırma 3).
- Hedefin boyutunu karıştırmak. $Z_3$'ün boyutu $(n, 1)$,
y'ninki $(n,)$ iseZ3 - yyayınlamayla $(n, n)$ olur ve kayıp her tahmini her hedefle karşılaştırır. Hata mesajı çıkmayabilir. Hedefi her zamany[:, None]biçiminde tutun. - Ölçeklemeden eğitmek. Ham birimlerdeki girdi ve hedefler kayıp yüzeyini basıklaştırır; öğrenme hızı ya küçük kalır ya da eğitim ıraksar.
- Bütün ağırlıkları sıfır (ya da aynı değer) ile başlatmak. Simetri bozulmaz; geniş ağ tek birimlik ağ gibi davranır.
- Çapraz entropiyi
np.log(sigmoid(z))ile hesaplamak. Büyük $|z|$'delog(0)venanüretir. Logit biçimini (np.logaddexp) kullanın. - Yalnızca eğitim kaybına bakmak. Kaybın düşmesi modelin genellediğini göstermez; doğrulama hatasını izleyin ve aralık dışı davranışı ayrıca sınayın.
12. Alıştırmalar
Alıştırma 1KolayXOR'u elle çözün
İki girdili, iki ReLU gizli birimli ve doğrusal çıkışlı bir ağ için XOR'u tam çözen ağırlıkları bulun. İpucu: birinci birim $x_1 + x_2$'yi, ikinci birim $x_1 + x_2 - 1$'i görsün.
Çözümü göster
Gizli birimler $h_1 = \mathrm{ReLU}(x_1 + x_2)$ ve $h_2 = \mathrm{ReLU}(x_1 + x_2 - 1)$, çıkış $\hat y = h_1 - 2h_2$ olsun. Yani $W_1 = \begin{bmatrix}1 & 1\\ 1 & 1\end{bmatrix}$, $\vect b_1 = (0, -1)$, $W_2 = (1, -2)^\top$, $b_2 = 0$.
- $(0,0)$: $h_1 = 0$, $h_2 = 0$ → $\hat y = 0$
- $(1,0)$ ve $(0,1)$: $h_1 = 1$, $h_2 = 0$ → $\hat y = 1$
- $(1,1)$: $h_1 = 2$, $h_2 = 1$ → $\hat y = 2 - 2 = 0$
İkinci birim yalnızca iki girdi birden 1 olduğunda devreye girip fazlalığı geri alıyor. Tek bir doğrusal birimin yapamadığını iki ReLU'nun birleşimi yapıyor.
Alıştırma 2KolayParametre sayısı
$p$ girdili, $h_1$ ve $h_2$ gizli birimli, tek çıktılı ağın parametre sayısını yazın. Örnek 1'deki ağ ve Örnek 2'deki dört ağ için kodun yazdırdığı sayıları doğrulayın. 1-64-64-1 ağının kaç parametresi olur?
Çözümü göster
Her katmanda ağırlık matrisi ve sapma vektörü vardır: $(p+1)h_1 + (h_1+1)h_2 + (h_2+1)$.
- 1-16-16-1: $2\cdot16 + 17\cdot16 + 17 = 321$.
- 2-$h$-$h$-1: $3h + (h+1)h + h + 1$ $= h^2 + 5h + 1$; $h$ = 2, 4, 8, 32 için 15, 37, 105, 1185.
- 1-64-64-1: $2\cdot64 + 65\cdot64 + 65 = 4353$.
Genişlik iki katına çıkınca orta katmandaki $h_1h_2$ terimi yüzünden parametre sayısı kabaca dört katına çıkar.
Alıştırma 3OrtaHatayı gradyan kontrolü yakalasın
geri fonksiyonunda d1 = (d2 @ P["W2"].T) * fp(Z1) satırını d1 = d2 @ P["W2"].T yapın; yani $\varphi'(Z_1)$ çarpanını unutun. tanh ve MSE için gradyan kontrolünü yeniden çalıştırın. Hangi dizilerde hata büyür, neden yalnızca onlarda?
Çözümü göster
Kodun ilk denetimiyle aynı ağ ve veride $W_1$ için bağıl hata $9{,}9\times10^{-2}$, $\vect b_1$ için $9{,}2\times10^{-2}$ çıkar. $W_2$, $\vect b_2$, $W_3$, $\vect b_3$ değişmez ($3{,}3\times10^{-11}$ – $5{,}1\times10^{-10}$), çünkü onların gradyanları hatalı satırdan önce hesaplanır.
Hatanın yalnızca $10^{-1}$ mertebesinde kalması öğreticidir. Xavier başlatmasıyla $Z_1$ küçük olduğundan $\tanh'(Z_1) = 1 - \tanh^2 Z_1$ değerleri 1'e yakındır; unutulan çarpan sonucu az değiştirir. Böyle bir hatayla ağ eğitilmeye devam eder ve sorun ancak birimler doymaya başladığında belirginleşir. Hatayı eğitim eğrisinden fark etmek çok zordur; gradyan kontrolünden ise hemen.
Alıştırma 4OrtaTeğet modül: türev de doğru mu?
Eğitilmiş ağın girdiye göre türevini geri yayılımla hesaplayın: $\delta_3$ yerine birlerden oluşan bir matris koyup geri yayılımı $X$'e kadar sürdürün ($\partial\hat y/\partial X = \delta_1W_1^\top$). Standartlaştırmayı geri çevirerek $\dd\sigma/\dd\varepsilon$'yi $\varepsilon$ = 0; 0,001; 0,002; 0,005 için bulun ve gerçek teğet modülle karşılaştırın. Gerçek teğet, $\dd\sigma/\dd\varepsilon = 1/(\dd\varepsilon/\dd\sigma)$ ile Ramberg–Osgood'dan hesaplanır.
Çözümü göster
def girdi_turevi(P, X):
    Z3, (X, Z1, A1, Z2, A2) = ileri(P, X, "tanh")
    fp = AKT["tanh"][1]
    d2 = (np.ones_like(Z3) @ P["W3"].T) * fp(Z2)
    d1 = (d2 @ P["W2"].T) * fp(Z1)
    return d1 @ P["W1"].T                       # ∂ŷ/∂x, standart birimde

x0 = np.array([[(0.0 - mx) / sx]])
E0 = girdi_turevi(P_ro, x0)[0, 0] * sy / sx # MPa; ölçek dönüşümü: (s_σ / s_ε)| $\varepsilon$ | Gerçek | Sinir ağı | Polinom (derece 19) |
|---|---|---|---|
| 0 | 70,00 | 51,4 | −149,0 |
| 0,001 | 70,00 | 72,5 | 69,7 |
| 0,002 | 40,89 | 41,2 | 42,9 |
| 0,005 | 2,90 | 2,8 | 2,1 |
Aralığın içinde ağın türevi gerçeğe yakın, ama $\varepsilon = 0$'da 70 GPa yerine 51,4 GPa veriyor. Polinomun eğimi ise orada negatif. Sonuç: değer hatası küçük bir model, kenarlarda ciddi türev hatası yapabilir. Elastik bölgede daha sık örnekleme, ya da $\sigma = E\varepsilon$ terimini modele doğrudan koyup ağa yalnızca sapmayı öğretmek bu sorunu azaltır.
Alıştırma 5OrtaÖğrenme hızını azaltmanın etkisi
Örnek 1'de kosinüs azaltmayı kaldırın ve sabit $\eta = 0{,}2$ ile eğitin. Sonra sabit $\eta = 0{,}02$'yi ve son olarak kosinüs azaltmayla tam yığın ($B = 200$) eğitimi deneyin. Her durumda gerçek eğriye göre RMSE'yi ve son 50 dönemdeki değişimini inceleyin.
Çözümü göster
Aynı başlangıç ağırlıklarıyla, 2000 dönem sonunda gerçek eğriye göre RMSE:
- Kosinüs, $\eta_0 = 0{,}2$, $B = 16$ (betik): 0,52 MPa.
- Sabit $\eta = 0{,}2$, $B = 16$: 1,23 MPa. Son 50 dönemde değer 0,38 ile 3,73 MPa arasında zıplıyor; ağırlıklar mini-yığın gürültüsüyle minimum çevresinde titriyor.
- Sabit $\eta = 0{,}02$, $B = 16$: 1,23 MPa (son 50 dönemde 0,90–1,44). Titreme azalmış ama eğitim yavaşlamış; model henüz yakınsamamış.
- Kosinüs, $\eta_0 = 0{,}2$, $B = 200$: 1,23 MPa. Tam yığında her dönem tek güncelleme var: 2000 güncelleme, $B = 16$'daki 26.000 güncellemenin yanında azdır.
Büyük öğrenme hızı başta hızlı ilerleme, küçük öğrenme hızı sonda ince ayar sağlar. Azaltma takvimi ikisini birleştirir.
Alıştırma 6ZorÜç sınıf: softmax ve çapraz entropi
Ağı $K$ sınıfa genelleyin. Çıkış katmanı $K$ logit üretsin, olasılıklar softmax ile bulunsun: $p_{ik} = e^{z_{ik}}/\sum_m e^{z_{im}}$. Kayıp $L = -\frac1n\sum_i\log p_{i,y_i}$ olsun. (a) Tek-sıcak (one-hot) kodlanmış $Y$ ile $\delta_3 = (P - Y)/n$ olduğunu gösterin. (b) Üç kollu, bir tur dönen bir sarmal üretin (kollar arasında $2\pi/3$ açı; 600 eğitim ve 600 test noktası, gürültü 0,08) ve $h$ = 4 ile 16 için eğitin.
Çözümü göster
(a) Tek örnek için $\ell = -z_y + \log\sum_m e^{z_m}$. Türev alınınca ($[k = y]$, $k = y$ ise 1, değilse 0):
$$ \begin{aligned} \frac{\partial\ell}{\partial z_k} &= -[k = y] + \frac{e^{z_k}}{\sum_m e^{z_m}} \\ &= p_k - y_k \end{aligned} $$Ortalama kayıpta $1/n$ çarpanı gelir. İkili durumdaki “tahmin eksi gerçek” biçimi aynen korunur; geri fonksiyonu hiç değişmez.
def softmax_ce(Z3, Y1):                      # Y1: (n, K) tek-sıcak
    Zk = Z3 - Z3.max(axis=1, keepdims=True)  # taşmayı önle
    logP = Zk - np.log(np.exp(Zk).sum(axis=1, keepdims=True))
    n = len(Y1)
    return -np.sum(Y1 * logP) / n, (np.exp(logP) - Y1) / n

P = baslat([2, h, h, 3], "xavier", rng)      # çıkışta 3 birim
(b) Bu kodla gradyan kontrolünde bütün dizilerde bağıl hata $10^{-9}$ mertebesinde ($3{,}8\times10^{-10}$ – $2{,}9\times10^{-9}$) çıktı. Standartlaştırılmış girdiler, tanh, $B = 32$, $\eta_0 = 0{,}3$ ve 500 dönemle doğruluk: $h = 4$ için eğitim %95,5 ve test %92,2; $h = 16$ için eğitim %98,8 ve test %94,3. Tahmin edilen sınıf Z3.argmax(axis=1) ile bulunur.
Özet
- Sinir ağı, doğrusal katmanlarla doğrusal olmayan aktivasyonların art arda uygulanmasıdır. Aktivasyon olmadan derinlik hiçbir şey katmaz.
- Geri yayılım, zincir kuralının matris biçimidir. Her katmanda üç kural yeter: $\partial L/\partial W = A^\top\delta$, $\partial L/\partial\vect b = \delta^\top\vect 1$, $\delta_{\text{önceki}} = (\delta W^\top)\odot\varphi'$.
- Elle yazılan her gradyan, merkezi farkla ve
float64ile denetlenmelidir. Doğru bir uygulamada bağıl hata $10^{-7}$'nin çok altındadır; ReLU'nun kırık noktası yanıltıcı sonuç verebilir. - Rastgele başlatma simetriyi bozar; Xavier (tanh) ve He (ReLU) ölçeği katmanlar boyunca korur. Mini-yığın SGD, girdi–hedef standartlaştırma ve öğrenme hızı azaltma ile birlikte kullanılır.
- Ağ, Ramberg–Osgood eğrisinin tersini polinomdan daha az hatayla öğrendi; ama kenarlarda, dizde ve türevde hatası büyüdü. Aralık dışındaki davranışı ise hiçbir esnek model garanti etmez.
Sonraki derste aynı ağları PyTorch ile kuracağız: geri yayılımı otomatik türev yapacak, biz de Adam, düzenlileştirme ve erken durdurma gibi araçlarla bir plak sehimi vekil modeli eğiteceğiz.
Kaynaklar
- I. Goodfellow, Y. Bengio, A. Courville — Deep Learning, MIT Press, 2016, Bölüm 6 (ileri beslemeli ağlar ve geri yayılım) ve Bölüm 8 (eğitim).
- D. E. Rumelhart, G. E. Hinton, R. J. Williams — “Learning representations by back-propagating errors”, Nature 323, 1986.
- X. Glorot, Y. Bengio — “Understanding the difficulty of training deep feedforward neural networks”, AISTATS 2010; K. He, X. Zhang, S. Ren, J. Sun — “Delving deep into rectifiers”, ICCV 2015.
- W. Ramberg, W. R. Osgood — “Description of stress-strain curves by three parameters”, NACA Technical Note 902, 1943.