Bu derste öğrenecekleriniz
- Permütasyon önemi, kısmi bağımlılık ve ICE eğrileriyle bir modelin neye dayandığını incelemek
- Shapley değerlerini tanımından, kesin olarak sıfırdan hesaplamak ve toplanabilirliğini doğrulamak
- Monoton kısıtlarla fiziğe aykırı tahminleri önlemek ve etkisini ICE eğrileriyle ölçmek
- Aralık kontrolü, Mahalanobis uzaklığı ve IsolationForest ile dağılım dışı girdileri işaretlemek; ortak değişken kaymasını izlemek
- Modeli tekrarlanabilir ve güvenli biçimde kaydetmek, bir model kartıyla belgelemek
1. Problem: iyi bir test hatası yetmez
Kurs boyunca modelleri çoğunlukla tek bir soruyla değerlendirdik: görmediği veride hatası ne kadar? Bu soru gereklidir ama yeterli değildir. Test kümesinde $R^2$ = 0,90 veren bir model de şunları yapabilir:
- Yanlış nedenle doğru olmak. Kalıp numarası gibi ilgisiz bir sütundan, ya da veri toplama düzenindeki bir rastlantıdan öğrenmiş olabilir.
- Fiziğe aykırı davranmak. Ortalamada iyi olsa da bazı karışımlarda yaş arttıkça dayanımı düşürebilir.
- Sınırının dışında sessizce yanılmak. Eğitimde hiç görmediği bir karışım ya da çimento tipi için de güvenle bir sayı üretir.
- Tekrarlanamamak. Altı ay sonra aynı sonucu kimse üretemez; hangi veriyle, hangi sürümle eğitildiği belli değildir.
Bir mühendis için güvenilir model, neye dayandığı bilinen, fizikle tutarlı, geçerli olduğu aralığı belli, tekrarlanabilir ve belgelenmiş modeldir. Ayrıca kararın sorumluluğunu taşıyan bir mühendisi vardır. Bu derste bu özelliklerin her birini ölçülebilir hâle getireceğiz.
Örnek problem Ders 04'teki beton basınç dayanımı. Veri, kursun ortak sentetik üreticisinden geliyor: dayanım Abrams yasası ($f = 96{,}5/7^{s/b}$ MPa) ve yaşa bağlı kazanım katsayısıyla hesaplanıyor, üzerine %7 mertebesinde çarpımsal gürültü ekleniyor. 2000 karışımın 1500'ü eğitime, 500'ü teste ayrıldı. Model sekiz özellik görüyor: etkin su/bağlayıcı oranı $s/b$ (cüruf ve uçucu kül 0,6 ve 0,4 etkinlikle bağlayıcıya katılır), yaş, süperakışkan miktarı, çimento tipi ve dört bilerek ilgisiz sütun: iri ve ince agrega miktarı, kalıp numarası ve ortam sıcaklığı.
“İlgisiz” yalnız bu üreticide
Gerçek betonda agrega ve kür sıcaklığı dayanımı etkiler. Bu sütunlar yalnız bizim üreticimizde dayanıma girmiyor; böylece bir yorumlama yönteminin ilgisiz özelliği ilgisiz bulup bulmadığını sınayabiliyoruz. Veri eğitim amaçlıdır ve gerçek bir laboratuvar kaydı değildir.
Model, Ders 08'deki gradient boosting'in scikit-learn'deki hızlı sürümü HistGradientBoostingRegressor (300 ağaç, öğrenme hızı 0,05). Test kümesinde RMSE = 3,06 MPa ve $R^2$ = 0,904. Ölçüt olarak fena değil; ama bu sayı yukarıdaki dört sorunun hiçbiri hakkında bilgi vermiyor.
2. Çalıştırılabilir kod
Bu derste önce betiği bir kez çalıştırıp sonra çıktısını bölüm bölüm yorumlayacağız. Betik yalnız scikit-learn kullanıyor, PyTorch gerekmiyor; sürümler requirements.txt dosyasında sabitlendi (kurulum için Ders 01). Ortak veri üreticisi betiğin başına birebir kopyalandı, böylece betik tek başına çalışıyor.
"""Ders 17 — Güvenilir makine öğrenmesi.

Beton basınç dayanımını tahmin eden bir modeli yorumluyoruz (permütasyon önemi, kısmi bağımlılık ve
ICE, sıfırdan kesin Shapley değerleri), fiziğe aykırı davranışı monoton kısıtlarla önlüyoruz, eğitim
verisinden uzak (dağılım dışı) girdileri işaretliyoruz, görülmemiş bir çimento tipiyle ortak değişken
kaymasını gösteriyoruz ve modeli tekrarlanabilir biçimde kaydediyoruz. Veri sentetiktir: kursun ortak
beton üreticisiyle (Abrams yasası, yaşa bağlı dayanım kazanımı ve gürültü) üretilir; gerçek deney
verisi değildir.

Çalıştır:  python d17_guvenilir_ml.py
Gerekenler: numpy, pandas, scipy, scikit-learn, matplotlib  (Python 3.12+; joblib scikit-learn ile gelir)
Çıktılar:  terminale sayılar, aynı klasöre dört PNG grafiği
"""
import hashlib
import itertools
import math
import tempfile
from pathlib import Path

import joblib
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
import sklearn
from scipy import stats
from sklearn.ensemble import HistGradientBoostingRegressor, IsolationForest
from sklearn.inspection import partial_dependence, permutation_importance
from sklearn.metrics import r2_score, root_mean_squared_error

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent


# %% 0. Kursun ortak beton verisi üreticisi (Ders 04 ile aynı, birebir kopya)
def beton_verisi(n, rng, eksik_oran=0.0):
    """Sentetik beton karışımı verisi (eğitim amaçlı; gerçek deney verisi değildir).

    Dayanım, Abrams yasası (f = 96,5 / 7^(s/b) MPa) ve EN 1992-1-1'deki yaş katsayısı
    β_cc(t) = exp(s·(1 − √(28/t))) ile üretilir; s/b oranında cüruf ve uçucu kül, EN 206'daki
    k-değeri kavramına benzer biçimde 0,6 ve 0,4 etkinlikle bağlayıcıya katılır.
    """
    cimento = rng.uniform(250, 500, n)                                   # kg/m³
    curuf = np.where(rng.random(n) < 0.4, rng.uniform(20, 200, n), 0.0)  # kg/m³
    ucucu_kul = np.where(rng.random(n) < 0.3, rng.uniform(20, 150, n), 0.0)
    su = rng.uniform(150, 210, n)                                        # kg/m³
    super_akiskan = np.where(rng.random(n) < 0.6, rng.uniform(2, 12, n), 0.0)
    iri_agrega = rng.uniform(850, 1100, n)
    ince_agrega = rng.uniform(650, 900, n)
    yas_gun = rng.choice([3, 7, 14, 28, 56, 90], n, p=[.12, .2, .13, .3, .13, .12])
    tipler = np.array(["CEM I 42,5 R", "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"])
    tip_no = rng.choice(3, n, p=[.45, .35, .20])
    s_katsayi = np.array([0.20, 0.25, 0.38])[tip_no]      # EN 1992-1-1, Bağıntı 3.2: R, N, S sınıfı
    sinif_carpani = np.array([1.00, 0.97, 0.88])[tip_no]  # varsayım: dayanım sınıfı etkisi
    kalip_no = rng.integers(1, 21, n)                    # ilgisiz özellik
    ortam_sicakligi = rng.uniform(5, 30, n)              # ilgisiz özellik (bu üreticide)

    sb = su / (cimento + 0.6 * curuf + 0.4 * ucucu_kul)  # su / etkin bağlayıcı
    f28 = 96.5 / 7.0 ** sb * sinif_carpani + 0.25 * super_akiskan
    beta = np.exp(s_katsayi * (1 - np.sqrt(28 / yas_gun)))
    dayanim = f28 * beta * rng.lognormal(0.0, 0.07, n)

    df = pd.DataFrame({
        "cimento": cimento, "curuf": curuf, "ucucu_kul": ucucu_kul, "su": su,
        "super_akiskan": super_akiskan, "iri_agrega": iri_agrega, "ince_agrega": ince_agrega,
        "yas_gun": yas_gun, "cimento_tipi": tipler[tip_no], "kalip_no": kalip_no,
        "ortam_sicakligi": ortam_sicakligi, "dayanim_mpa": dayanim,
    })
    if eksik_oran > 0:
        df.loc[rng.random(n) < eksik_oran, "super_akiskan"] = np.nan
    return df


TIPLER = ["CEM I 42,5 R", "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"]
OZ = ["su_baglayici", "yas_gun", "super_akiskan", "cimento_tipi",
      "iri_agrega", "ince_agrega", "kalip_no", "ortam_sicakligi"]          # son dördü bilerek ilgisiz


def hazirla(df):
    """Ders 04'teki anlamlı özellik: etkin su/bağlayıcı oranı. Tamsayı sütunlar PD için float olur."""
    df = df.copy()
    df["su_baglayici"] = df["su"] / (df["cimento"] + 0.6 * df["curuf"] + 0.4 * df["ucucu_kul"])
    df["cimento_tipi"] = pd.Categorical(df["cimento_tipi"], categories=TIPLER)
    df[["yas_gun", "kalip_no"]] = df[["yas_gun", "kalip_no"]].astype(float)
    return df


def hgb(**ayar):
    return HistGradientBoostingRegressor(max_iter=300, learning_rate=0.05, random_state=42, **ayar)


def rmse(y, p):
    return root_mean_squared_error(y, p)


# %% 1. Veri ve temel model
rng = np.random.default_rng(42)
veri = hazirla(beton_verisi(2000, rng))
egitim, test = veri.iloc[:1500], veri.iloc[1500:]
y_test = test["dayanim_mpa"].to_numpy()
model = hgb().fit(egitim[OZ], egitim["dayanim_mpa"])
tahmin = model.predict(test[OZ])
print("=== 1. Veri ve temel model ===")
print(f"{len(veri)} karışım ({len(egitim)} eğitim, {len(test)} test); 8 özellik, son dördü ilgisiz")
print(f"HistGradientBoosting: test RMSE = {rmse(y_test, tahmin):.2f} MPa, "
      f"R² = {r2_score(y_test, tahmin):.3f}")

# %% 2. Permütasyon önemi: bir sütunu karıştırınca test hatası ne kadar artıyor?
pi = permutation_importance(model, test[OZ], y_test, n_repeats=10, random_state=42,
                            scoring="neg_root_mean_squared_error")
sira = np.argsort(-pi.importances_mean)
print("\n=== 2. Permütasyon önemi (test kümesi, 10 tekrar; RMSE artışı, MPa) ===")
for parca in (sira[:4], sira[4:]):
    print("   " + ", ".join(f"{OZ[i]} {pi.importances_mean[i]:.2f}±{pi.importances_std[i]:.2f}"
                            for i in parca))
assert set(np.array(OZ)[sira[:3]]) == {"su_baglayici", "yas_gun", "cimento_tipi"}


# %% 3. Kısmi bağımlılık (PD) ve ICE eğrileri
def ice(m, X, ad, izgara):
    """Her satır için tek özelliği ızgarada gezdir, diğerlerini sabit tut → (satır, ızgara) tahmin matrisi."""
    Z = pd.concat([X.assign(**{ad: v}) for v in izgara], ignore_index=True)
    return m.predict(Z).reshape(len(izgara), -1).T


def ihlal(m, X, yas_izgara, sb_izgara):
    """Yaşla azalan ya da s/b ile artan adımı olan ICE eğrilerinin oranı ve en büyük ihlal (MPa)."""
    d_yas = np.diff(ice(m, X, "yas_gun", yas_izgara), axis=1)
    d_sb = np.diff(ice(m, X, "su_baglayici", sb_izgara), axis=1)
    return (d_yas < -1e-9).any(1).mean(), (d_sb > 1e-9).any(1).mean(), max(0.0, -d_yas.min(), d_sb.max())


X_ice = test[OZ].iloc[:300]
pd_sb = partial_dependence(model, X_ice, ["su_baglayici"], kind="both", grid_resolution=25)
pd_yas = partial_dependence(model, X_ice, ["yas_gun"], kind="both")
YAS = pd_yas["grid_values"][0]                                   # 3, 7, 14, 28, 56, 90
SB = np.linspace(0.30, 0.70, 21)
i_yas, i_sb, i_max = ihlal(model, X_ice, YAS, SB)
print("\n=== 3. Kısmi bağımlılık (PD) ve ICE (300 test karışımı) ===")
g = pd_sb["grid_values"][0]
print(f"PD, s/b: {g[0]:.3f} → {g[-1]:.3f} arasında "
      f"{pd_sb['average'][0, 0]:.1f} → {pd_sb['average'][0, -1]:.1f} MPa")
print("PD, yaş: " + ", ".join(f"{a:.0f} g {v:.2f}" for a, v in zip(YAS, pd_yas["average"][0])) + " MPa")
print(f"ICE: yaşla azalan adımı olan eğri %{i_yas * 100:.0f}, s/b ile artan adımı olan eğri "
      f"%{i_sb * 100:.0f}; en büyük ihlal {i_max:.2f} MPa")


# %% 4. Shapley değerleri: kesin hesap, sıfırdan (4 özellikli küçük model)
def shapley_kesin(f, x, arka_plan):
    """Girişimsel (marjinal) beklenen değerle kesin Shapley değerleri: 2^p koalisyonun hepsi."""
    p = len(x)
    v = {}                                            # koalisyon değeri v(S) = E[f(x_S, X_S̄)]
    for r in range(p + 1):
        for S in itertools.combinations(range(p), r):
            Z = arka_plan.copy()
            Z[:, list(S)] = x[list(S)]                # S'deki özellikler x'ten, diğerleri arka plandan
            v[S] = f(Z).mean()
    phi = np.zeros(p)
    for j in range(p):
        digerleri = [k for k in range(p) if k != j]
        for r in range(p):
            for S in itertools.combinations(digerleri, r):
                agirlik = math.factorial(r) * math.factorial(p - r - 1) / math.factorial(p)
                phi[j] += agirlik * (v[tuple(sorted(S + (j,)))] - v[S])
    return phi, v[()], v[tuple(range(p))]            # φ, E[f], f(x)


OZ4 = ["su_baglayici", "yas_gun", "super_akiskan", "ortam_sicakligi"]
model4 = hgb().fit(egitim[OZ4], egitim["dayanim_mpa"])
arka_plan = egitim[OZ4].to_numpy()[:200]


def f4(Z):
    return model4.predict(pd.DataFrame(Z, columns=OZ4))


print("\n=== 4. Kesin Shapley değerleri (4 özellik, 16 koalisyon, 200 satırlık arka plan) ===")
print(f"Küçük model test RMSE = {rmse(y_test, model4.predict(test[OZ4])):.2f} MPa")
ornekler = {"A": np.array([0.65, 7.0, 0.0, 25.0]), "B": np.array([0.35, 56.0, 8.0, 10.0])}
shap_sonuc = {}
for ad, x in ornekler.items():
    phi, Ef, fx = shapley_kesin(f4, x, arka_plan)
    shap_sonuc[ad] = (phi, Ef, fx)
    print(f"{ad} (s/b {x[0]:.2f}, {x[1]:.0f} g, SA {x[2]:.0f}, {x[3]:.0f} °C): "
          f"f(x) = {fx:.2f}, E[f] = {Ef:.2f} MPa")
    print("   φ (s/b, yaş, SA, sıcaklık) = " + ", ".join(f"{v:+.2f}" for v in phi)
          + f"; Σφ − (f(x) − E[f]) = {phi.sum() - (fx - Ef):.1e}")
    assert abs(phi.sum() - (fx - Ef)) < 1e-9                 # verimlilik (efficiency) özelliği

# %% 5. Fiziksel tutarlılık: monoton kısıtlar, küçük ve gürültülü eğitim kümeleri
KISIT = {"su_baglayici": -1, "yas_gun": 1}      # dayanım: s/b artınca azalır, yaş artınca artar
X_mon = test[OZ].iloc[:200]
sonuc = {"serbest": [], "kısıtlı": []}
ice_ornek = {}
for tohum in range(10):
    kucuk = hazirla(beton_verisi(100, np.random.default_rng(100 + tohum)))
    for ad, kisit in [("serbest", None), ("kısıtlı", KISIT)]:
        m = HistGradientBoostingRegressor(max_iter=200, learning_rate=0.1, min_samples_leaf=5,
                                          monotonic_cst=kisit, random_state=42)
        m.fit(kucuk[OZ], kucuk["dayanim_mpa"])
        sonuc[ad].append([rmse(y_test, m.predict(test[OZ])), *ihlal(m, X_mon, YAS, SB)])
        if tohum == 0:
            ice_ornek[ad] = ice(m, X_mon.iloc[:15], "su_baglayici", SB)
sonuc = {ad: np.array(v) for ad, v in sonuc.items()}
print("\n=== 5. Monoton kısıtlar: 10 küçük eğitim kümesi × 100 karışım (min_samples_leaf = 5) ===")
for ad, s in sonuc.items():
    print(f"{ad:8s}: test RMSE {s[:, 0].mean():.2f} MPa; ICE ihlali yaş %{s[:, 1].mean() * 100:.0f}, "
          f"s/b %{s[:, 2].mean() * 100:.0f}; en büyük ihlal {s[:, 3].max():.2f} MPa")
kazanc = int((sonuc["kısıtlı"][:, 0] < sonuc["serbest"][:, 0]).sum())
print(f"Kısıtlı modelin test RMSE'si daha düşük: 10 kümeden {kazanc}")
assert sonuc["kısıtlı"][:, 1:3].max() == 0

# %% 6. Uygulama alanı: eğitim verisinden uzak girdileri işaretlemek
havuz = hazirla(beton_verisi(4000, rng))
alan_ici = havuz["su_baglayici"].between(0.40, 0.60) & havuz["yas_gun"].isin([7, 14, 28, 56])
dar = havuz[alan_ici].iloc[:800]                 # santralin geçmişi: yalnız olağan karışımlar
dar_model = hgb().fit(dar[OZ], dar["dayanim_mpa"])
yeni = hazirla(beton_verisi(2000, rng))          # yeni sorgular: üreticinin tüm aralığı
y_yeni = yeni["dayanim_mpa"].to_numpy()
hata = dar_model.predict(yeni[OZ]) - y_yeni
buyuk = np.abs(hata) / y_yeni > 0.15             # “büyük hata”: %15'ten fazla


def uzay(df):
    """Uzaklık, modelin önemli bulduğu sayısal özelliklerde ölçülür; yaş logaritmik alınır."""
    return np.column_stack([df["su_baglayici"], np.log(df["yas_gun"]), df["super_akiskan"]])


F_e, F_y = uzay(dar), uzay(yeni)
ort, S_ters = F_e.mean(0), np.linalg.inv(np.cov(F_e, rowvar=False))


def mahalanobis(F):
    d = F - ort
    return np.sqrt(np.einsum("ij,jk,ik->i", d, S_ters, d))


d_yeni = mahalanobis(F_y)
esik = np.quantile(mahalanobis(F_e), 0.99)        # eğitim noktalarının %99'u bu uzaklığın içinde
bayrak = {
    "aralık kontrolü": ((F_y < F_e.min(0)) | (F_y > F_e.max(0))).any(1),
    "Mahalanobis": d_yeni > esik,
    "IsolationForest": IsolationForest(n_estimators=200, contamination=0.01,
                                       random_state=42).fit(F_e).predict(F_y) == -1,
}
ic = (yeni["su_baglayici"].between(0.40, 0.60) & yeni["yas_gun"].isin([7, 14, 28, 56])).to_numpy()
print("\n=== 6. Uygulama alanı ve dağılım dışı girdiler ===")
print(f"Eğitim: s/b 0.40–0.60, yaş 7–56 g ({len(dar)} karışım); yeni girdiler: tüm aralık ({len(yeni)})")
print(f"RMSE: alan içi {np.sqrt(np.mean(hata[ic]**2)):.2f} MPa ({ic.sum()}), alan dışı "
      f"{np.sqrt(np.mean(hata[~ic]**2)):.2f} MPa ({(~ic).sum()}); %15'ten büyük hata: {buyuk.sum()} girdi")
SINIRLAR = [0, 1, 2, 3, 4, 7]
kutular = [(d_yeni >= a) & (d_yeni < b) for a, b in zip(SINIRLAR[:-1], SINIRLAR[1:])]
kutu_rmse = [np.sqrt(np.mean(hata[k]**2)) for k in kutular]
kutu_n = [int(k.sum()) for k in kutular]
print("RMSE, eğitime Mahalanobis uzaklığına göre (MPa): "
      + ", ".join(f"{a}–{b} {r:.2f}" for a, b, r in zip(SINIRLAR[:-1], SINIRLAR[1:], kutu_rmse)))
for ad, b in bayrak.items():
    yakalama = (b & buyuk).sum() / buyuk.sum() * 100
    etiket = f"Mahalanobis > {esik:.2f}" if ad == "Mahalanobis" else ad
    print(f"   {etiket:18s}: işaretli %{b.mean() * 100:4.1f}, büyük hata yakalama %{yakalama:4.1f}; "
          f"RMSE işaretsiz/işaretli {np.sqrt(np.mean(hata[~b]**2)):.2f}/{np.sqrt(np.mean(hata[b]**2)):.2f}")
yas_y = yeni["yas_gun"].to_numpy()
print("Yaşa göre sapma (tahmin − ölçüm, MPa): "
      + ", ".join(f"{a:.0f} g {hata[yas_y == a].mean():+.2f}" for a in YAS))
assert d_yeni.max() < SINIRLAR[-1] and sum(kutu_n) == len(yeni)

# %% 7. Ortak değişken kayması: eğitimde hiç görülmeyen çimento tipi
eski = egitim[egitim["cimento_tipi"] != TIPLER[2]]
kayma_model = hgb().fit(eski[OZ], eski["dayanim_mpa"])
aday = hazirla(beton_verisi(1500, rng))
parti = aday[aday["cimento_tipi"] == TIPLER[2]].iloc[:300]      # yeni tedarikçi: CEM III/A
yeni_kategori = set(parti["cimento_tipi"].unique()) - set(eski["cimento_tipi"].unique())
p_ks = [stats.ks_2samp(eski[s], parti[s]).pvalue for s in ["su_baglayici", "yas_gun", "super_akiskan"]]
sapma = kayma_model.predict(parti[OZ]) - parti["dayanim_mpa"].to_numpy()
erken = parti["yas_gun"].to_numpy() <= 7
print("\n=== 7. Ortak değişken kayması: görülmemiş çimento tipi ===")
print(f"Eğitim: yalnız CEM I ve CEM II ({len(eski)} karışım); yeni parti: {len(parti)} karışım {TIPLER[2]}")
print(f"Şema kontrolü: yeni kategori {sorted(yeni_kategori)} → alarm (model ise sessizce tahmin üretir)")
print("KS testi p değerleri (s/b, yaş, SA): " + ", ".join(f"{p:.2f}" for p in p_ks))
print(f"Ölçümler gelince: ortalama sapma {sapma.mean():+.2f} MPa, RMSE {np.sqrt(np.mean(sapma**2)):.2f} MPa; "
      f"3–7 günde ortalama sapma {sapma[erken].mean():+.2f} MPa")

# %% 8. Tekrarlanabilirlik: sürümler, veri parmak izi, model kaydı
print("\n=== 8. Tekrarlanabilirlik ===")
print(f"Sürümler: numpy {np.__version__}, pandas {pd.__version__}, scikit-learn {sklearn.__version__}, "
      f"joblib {joblib.__version__}")
with tempfile.TemporaryDirectory() as klasor:
    veri_yolu = Path(klasor) / "egitim.csv"
    egitim.to_csv(veri_yolu, index=False)                       # veri sürümü: kaydedilen dosyanın parmak izi
    parmak_izi = hashlib.sha256(veri_yolu.read_bytes()).hexdigest()
    yol = Path(klasor) / "beton_modeli.joblib"
    joblib.dump(model, yol)
    yuklenen = joblib.load(yol)                    # yükleme kod çalıştırabilir: yalnız güvenilir dosya!
    ozdes = bool(np.array_equal(yuklenen.predict(test[OZ]), tahmin))
print(f"Veri parmak izi (CSV, SHA-256, ilk 16): {parmak_izi[:16]}; "
      f"kaydet–yükle sonrası tahminler özdeş: {ozdes}")
assert ozdes

# %% 9. Grafikler
ADLAR = {"su_baglayici": "s/b", "yas_gun": "yaş", "super_akiskan": "süperakışkan",
         "cimento_tipi": "çimento tipi", "iri_agrega": "iri agrega", "ince_agrega": "ince agrega",
         "kalip_no": "kalıp no", "ortam_sicakligi": "ortam sıcaklığı"}
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
s2 = sira[::-1]
ax[0].barh([ADLAR[OZ[i]] for i in s2], pi.importances_mean[s2], xerr=pi.importances_std[s2],
           color=RENK[0], height=0.6, error_kw=dict(ecolor=MUREKKEP, lw=1, capsize=2))
ax[0].axvline(0, color=MUREKKEP, lw=0.8)
ax[0].set(xlabel="Karıştırınca test RMSE artışı (MPa)", title="Permütasyon önemi (10 tekrar)")
konum = np.arange(len(OZ4))
for k, ad in enumerate(["A", "B"]):
    phi, Ef, fx = shap_sonuc[ad]
    ax[1].barh(konum + (0.2 if k == 0 else -0.2), phi, height=0.38, color=RENK[k],
               label=f"{ad}: f(x) = {fx:.1f} MPa")
ax[1].set_yticks(konum, [ADLAR[o] for o in OZ4])
ax[1].invert_yaxis()
ax[1].axvline(0, color=MUREKKEP, lw=0.8)
ax[1].set(xlabel="Shapley değeri φ (MPa)", title=f"Kesin Shapley değerleri (E[f] = {Ef:.1f} MPa)")
ax[1].legend(loc="lower left", fontsize=8.5)
fig.savefig(KLASOR / "d17_guvenilir_ml_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
for k, (sonuc_pd, x_ad) in enumerate([(pd_sb, "Su/bağlayıcı oranı s/b"), (pd_yas, "Yaş (gün, log ölçek)")]):
    gx = sonuc_pd["grid_values"][0]
    for egri in sonuc_pd["individual"][0][:12]:
        ax[k].plot(gx, egri, color=SOLUK, lw=0.7)
    ax[k].plot([], [], color=SOLUK, lw=0.7, label="ICE (12 karışım)")
    ax[k].plot(gx, sonuc_pd["average"][0], color=RENK[0], lw=2.5, label="PD (300 karışım ortalaması)")
    ax[k].set(xlabel=x_ad, ylabel="Tahmini dayanım (MPa)")
    ax[k].legend(loc="upper right" if k == 0 else "upper left")
ax[1].set_xscale("log")
ax[1].set_xticks(YAS, [f"{a:.0f}" for a in YAS])
ax[1].minorticks_off()
ax[0].set_title("s/b artınca dayanım düşüyor")
ax[1].set_title("Yaşla dayanım kazanımı")
fig.savefig(KLASOR / "d17_guvenilir_ml_2.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained", sharey=True)
for k, ad in enumerate(["serbest", "kısıtlı"]):
    egriler = ice_ornek[ad]
    bozuk = (np.diff(egriler, axis=1) > 1e-9).any(1)
    for egri, b in zip(egriler, bozuk):
        ax[k].plot(SB, egri, color=RENK[1] if b else RENK[0], lw=0.8)
    ax[k].plot([], [], color=RENK[0], lw=1, label="monoton azalan")
    ax[k].plot([], [], color=RENK[1], lw=1, label="artan adımı var (fiziğe aykırı)")
    ax[k].set(xlabel="Su/bağlayıcı oranı s/b",
              title=f"{ad.capitalize()} model: {bozuk.sum()}/{len(bozuk)} eğri ihlalli")
    ax[k].legend(loc="upper right", fontsize=8.5)
ax[0].set_ylabel("Tahmini dayanım (MPa)")
fig.savefig(KLASOR / "d17_guvenilir_ml_3.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
b = bayrak["Mahalanobis"]
ax[0].scatter(d_yeni[~b], np.abs(hata[~b]), s=7, color=RENK[0], alpha=0.45, linewidths=0, label="İşaretsiz")
ax[0].scatter(d_yeni[b], np.abs(hata[b]), s=7, color=RENK[1], alpha=0.55, linewidths=0,
              label="İşaretli (dağılım dışı)")
ax[0].axvline(esik, color=MUREKKEP, ls="--", lw=1.2, label=f"Eşik = {esik:.2f}")
ax[0].set(xlabel="Eğitim verisine Mahalanobis uzaklığı", ylabel="|Tahmin − ölçüm| (MPa)",
          title="Uzaklık arttıkça hata büyüyor")
ax[0].legend(loc="upper left", markerscale=2)
etiket = [f"{a}–{b_}" for a, b_ in zip(SINIRLAR[:-1], SINIRLAR[1:])]
cubuk = ax[1].bar(etiket, kutu_rmse, color=RENK[0], width=0.6)
for c, n in zip(cubuk, kutu_n):
    ax[1].text(c.get_x() + c.get_width() / 2, c.get_height() + 0.15, f"n = {n}", ha="center", fontsize=8.5,
               color=IKINCIL)
ax[1].set(xlabel="Mahalanobis uzaklığı aralığı", ylabel="RMSE (MPa)", title="Uzaklık aralığına göre RMSE")
fig.savefig(KLASOR / "d17_guvenilir_ml_4.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d17_guvenilir_ml_1.png, _2.png, _3.png, _4.png")=== 1. Veri ve temel model ===
2000 karışım (1500 eğitim, 500 test); 8 özellik, son dördü ilgisiz
HistGradientBoosting: test RMSE = 3.06 MPa, R² = 0.904
=== 2. Permütasyon önemi (test kümesi, 10 tekrar; RMSE artışı, MPa) ===
su_baglayici 7.12±0.22, yas_gun 6.49±0.27, cimento_tipi 1.24±0.10, super_akiskan 0.19±0.03
ortam_sicakligi 0.03±0.02, kalip_no 0.01±0.01, ince_agrega -0.01±0.01, iri_agrega -0.02±0.03
=== 3. Kısmi bağımlılık (PD) ve ICE (300 test karışımı) ===
PD, s/b: 0.325 → 0.616 arasında 48.3 → 27.4 MPa
PD, yaş: 3 g 24.92, 7 g 31.92, 14 g 36.87, 28 g 40.76, 56 g 43.70, 90 g 45.70 MPa
ICE: yaşla azalan adımı olan eğri %5, s/b ile artan adımı olan eğri %94; en büyük ihlal 0.79 MPa
=== 4. Kesin Shapley değerleri (4 özellik, 16 koalisyon, 200 satırlık arka plan) ===
Küçük model test RMSE = 3.95 MPa
A (s/b 0.65, 7 g, SA 0, 25 °C): f(x) = 20.92, E[f] = 37.06 MPa
φ (s/b, yaş, SA, sıcaklık) = -10.67, -4.66, -1.08, +0.27; Σφ − (f(x) − E[f]) = 0.0e+00
B (s/b 0.35, 56 g, SA 8, 10 °C): f(x) = 55.40, E[f] = 37.06 MPa
φ (s/b, yaş, SA, sıcaklık) = +9.25, +7.64, +1.27, +0.17; Σφ − (f(x) − E[f]) = 0.0e+00
=== 5. Monoton kısıtlar: 10 küçük eğitim kümesi × 100 karışım (min_samples_leaf = 5) ===
serbest : test RMSE 4.36 MPa; ICE ihlali yaş %21, s/b %99; en büyük ihlal 2.89 MPa
kısıtlı : test RMSE 4.13 MPa; ICE ihlali yaş %0, s/b %0; en büyük ihlal 0.00 MPa
Kısıtlı modelin test RMSE'si daha düşük: 10 kümeden 10
=== 6. Uygulama alanı ve dağılım dışı girdiler ===
Eğitim: s/b 0.40–0.60, yaş 7–56 g (800 karışım); yeni girdiler: tüm aralık (2000)
RMSE: alan içi 2.79 MPa (780), alan dışı 6.25 MPa (1220); %15'ten büyük hata: 523 girdi
RMSE, eğitime Mahalanobis uzaklığına göre (MPa): 0–1 2.69, 1–2 2.92, 2–3 4.52, 3–4 6.62, 4–7 9.21
aralık kontrolü : işaretli %61.3, büyük hata yakalama %92.0; RMSE işaretsiz/işaretli 2.79/6.24
Mahalanobis > 2.63: işaretli %45.8, büyük hata yakalama %86.6; RMSE işaretsiz/işaretli 3.26/6.79
IsolationForest : işaretli %10.9, büyük hata yakalama %21.6; RMSE işaretsiz/işaretli 5.08/6.00
Yaşa göre sapma (tahmin − ölçüm, MPa): 3 g +6.50, 7 g -0.78, 14 g -1.71, 28 g -0.38, 56 g -1.25, 90 g -2.58
=== 7. Ortak değişken kayması: görülmemiş çimento tipi ===
Eğitim: yalnız CEM I ve CEM II (1205 karışım); yeni parti: 300 karışım CEM III/A 32,5 N
Şema kontrolü: yeni kategori ['CEM III/A 32,5 N'] → alarm (model ise sessizce tahmin üretir)
KS testi p değerleri (s/b, yaş, SA): 0.89, 1.00, 0.29
Ölçümler gelince: ortalama sapma +5.86 MPa, RMSE 7.17 MPa; 3–7 günde ortalama sapma +9.88 MPa
=== 8. Tekrarlanabilirlik ===
Sürümler: numpy 2.5.3, pandas 3.0.6, scikit-learn 1.9.0, joblib 1.6.0
Veri parmak izi (CSV, SHA-256, ilk 16): d4a8c27b2c6364c5; kaydet–yükle sonrası tahminler özdeş: True
Grafikler kaydedildi: d17_guvenilir_ml_1.png, _2.png, _3.png, _4.png3. Permütasyon önemi: model neye dayanıyor?
Permütasyon önemi (permutation importance) basit bir deneydir. Test kümesinde $j$. sütunu rastgele karıştırırsınız; böylece o sütunun hedefle bağı kopar, dağılımı ise aynı kalır. Model o sütuna dayanıyorsa hata artar. Karıştırma rastgele olduğu için deney $R$ kez tekrarlanır. $L$ test RMSE'si ve $X^{(j,r)}$, $j$. sütunu $r$. kez karıştırılmış test kümesi olmak üzere:
$$ I_j = \frac{1}{R}\sum_{r=1}^{R}\Big[L\big(X^{(j,r)}\big) - L(X)\Big] $$pi = permutation_importance(model, test[OZ], y_test, n_repeats=10, random_state=42,
scoring="neg_root_mean_squared_error")
# pi.importances_mean: karıştırınca RMSE'nin ortalama artışı (MPa); pi.importances_std: tekrarlar arası sapmaSonuç, veriyi nasıl ürettiğimizle uyumlu. Karıştırınca test RMSE'si $s/b$ için 7,12 ± 0,22 MPa, yaş için 6,49 ± 0,27 MPa ve çimento tipi için 1,24 ± 0,10 MPa artıyor. Süperakışkanın etkisi küçük ama belirgin: 0,19 ± 0,03 MPa. Dört ilgisiz sütunun önemi ise −0,02 ile 0,03 MPa arasında, yani tekrarlar arasındaki saçılmayla aynı düzeyde. Negatif değer, karıştırmanın şans eseri hatayı biraz azalttığı anlamına gelir; önem sıfırdır diye okunur.
Permütasyon önemi neyi söylemez?
- Nedensellik. Önem, modelin neye dayandığını söyler, gerçek dünyada neyin neyi etkilediğini değil. Ölçüm düzeninden sızan bir sütun da çok önemli çıkabilir.
- İlişkili özellikler. Su miktarını ve $s/b$'yi birlikte verseydik, model bilgiyi ikisine bölebilirdi ve her biri tek başına olduğundan önemsiz görünebilirdi. Karıştırma ayrıca gerçekte olmayan karışımlar üretir (çok su, çok düşük $s/b$).
- Hangi küme? Önemi test kümesinde hesaplayın. Eğitim kümesinde, modelin ezberlediği gürültü de önemli görünür.
4. Kısmi bağımlılık ve ICE eğrileri
Önem “ne kadar” sorusunu yanıtlar; “nasıl” sorusunu yanıtlamaz. $s/b$ arttıkça model dayanımı düşürüyor mu, ne kadar? Bunun için bireysel koşullu beklenti (ICE) eğrilerini çizeriz: bir karışımı alıp yalnız $x_S$ özelliğini bir ızgara üzerinde gezdiririz, diğer özellikleri ($x_C$) sabit tutarız:
$$ f^{(i)}(x_S) = f\big(x_S,\ x_C^{(i)}\big) $$Bütün karışımların ICE eğrilerinin ortalaması kısmi bağımlılıktır (partial dependence, PD):
$$ \bar f_S(x_S) = \frac{1}{n}\sum_{i=1}^{n} f\big(x_S,\ x_C^{(i)}\big) $$pd_sb = partial_dependence(model, X_ice, ["su_baglayici"], kind="both", grid_resolution=25)
pd_sb["average"] # PD eğrisi: (1, 25)
pd_sb["individual"] # ICE eğrileri: (1, 300, 25)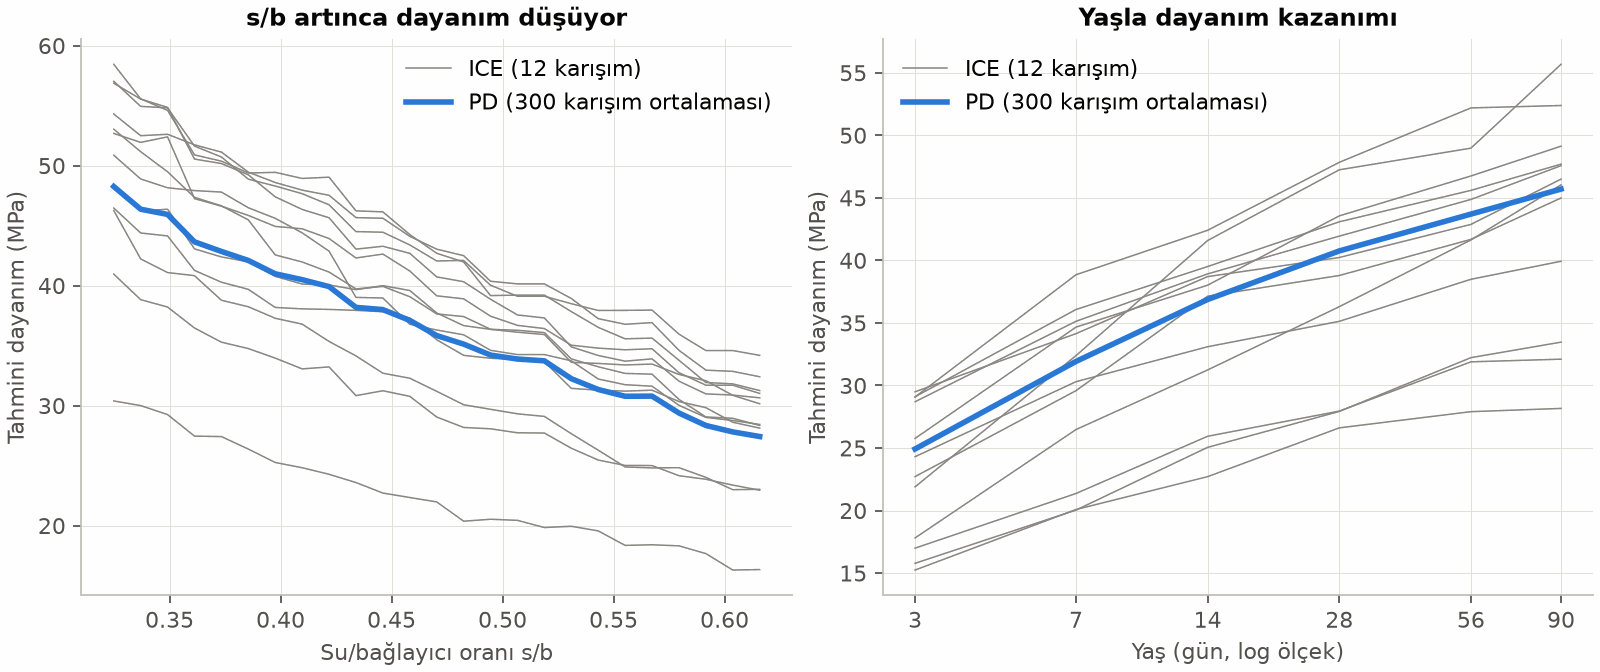
PD eğrilerini veriyi üreten yasalarla karşılaştırabiliriz. $s/b$ 0,325'ten 0,616'ya, yani 0,291 artınca PD 48,3 MPa'dan 27,4 MPa'ya iniyor; oran 0,567. Abrams yasası aynı artış için $7^{-0{,}291} \approx 0{,}568$ katı öngörür. Yaş ekseninde PD 3 günde 24,92, 28 günde 40,76 ve 90 günde 45,70 MPa; 28 günlük değere oranlar 0,61 ve 1,12. EN 1992-1-1'deki $\beta_{cc}(t)$ bağıntısı, $s = 0{,}25$ katsayılı bir çimento için 3 günde yaklaşık 0,60 ve 90 günde 1,12 verir. Model, kimse söylemeden fiziğe çok yakın bir ilişki öğrenmiş.
ICE eğrileri PD'nin gizlediği bir şeyi daha gösteriyor: yaş eğrileri birbirinden açılıyor. Güçlü bir karışım 3 günden 90 güne daha çok MPa kazanıyor. Bu, üreticideki çarpımsal yapının ($f_{28}\cdot\beta_{cc}$) izidir; etkiler toplamsal (additive) olsaydı ICE eğrileri birbirine paralel olurdu.
Ama ICE eğrilerine yakından bakınca küçük kusurlar görünüyor. 300 eğrinin %94'ünde $s/b$ artarken dayanımın arttığı en az bir adım var; yaş eğrilerinin %5'inde yaşla azalan bir adım var. En büyük ihlal 0,79 MPa. Test RMSE'sinin (3,06 MPa) çok altında, ama fiziğe aykırı. 6. bölümde bunu küçük veride büyüyen bir soruna dönüştürüp çözeceğiz.
PD'nin bir varsayımı
PD, $x_S$'yi değiştirirken diğer özellikleri olduğu gibi bırakır. Özellikler güçlü biçimde ilişkiliyse, gerçekte hiç görülmeyen bileşimlerde de tahmin alınır. Bizim üreticimizde $s/b$, yaş ve süperakışkan birbirinden bağımsız üretildiği için sorun yok. İlişkili özelliklerde Apley ve Zhu'nun önerdiği birikimli yerel etki (ALE) grafikleri daha güvenlidir.
5. Shapley değerleri: tek bir tahmini paylaştırmak
PD, modelin ortalama davranışını anlatır. Bir mühendis ise çoğu zaman tek bir tahmini sorgular: “Bu karışım için model neden 20,9 MPa diyor?” Shapley değerleri bu soruya oyun kuramından gelen bir yanıt verir. Özellikler bir oyunun oyuncularıdır; kazanç ise tahminin ortalamadan farkıdır. Her özelliğe, bütün olası katılım sıraları üzerinden ortalama marjinal katkısı kadar pay verilir.
$N$, $p$ özelliğin kümesi ve $S \subseteq N$ bir koalisyon olsun. Koalisyonun değeri, $S$'deki özellikler $x$'ten, diğerleri bir arka plan veri kümesinden ($z^{(1)}, \dots, z^{(m)}$) alındığında modelin ortalama tahminidir:
$$ v(S) = \frac{1}{m}\sum_{i=1}^{m} f\big(x_S,\ z^{(i)}_{\bar S}\big) $$Bu tanıma girişimsel (interventional) ya da marjinal beklenti denir. $j$. özelliğin Shapley değeri, onu içermeyen bütün koalisyonlar üzerinden ağırlıklı marjinal katkıların toplamıdır:
$$ \phi_j = \sum_{S \subseteq N\setminus\{j\}} w(S)\,\big[v(S\cup\{j\}) - v(S)\big] $$ $$ w(S) = \frac{|S|!\,(p-|S|-1)!}{p!} $$Ağırlık $w(S)$, özelliklerin rastgele bir sırayla oyuna girdiği düşünülünce $j$'den önce tam olarak $S$'nin girmiş olma olasılığıdır. Bu tanımın en kullanışlı sonucu verimlilik (efficiency) özelliğidir; SHAP literatüründe yerel doğruluk (local accuracy) adıyla geçer: Shapley değerlerinin toplamı, tahminin arka plan ortalamasından farkına tam olarak eşittir. (Shapley'nin toplanabilirlik aksiyomu başka bir şeydir: iki modelin toplamının Shapley değerleri, ayrı ayrı Shapley değerlerinin toplamına eşittir.) Boş koalisyonun değeri arka plan ortalamasıdır, $v(\varnothing) = \E[f]$:
$$ \sum_{j=1}^{p}\phi_j = f(x) - \E[f] $$Hesap, $2^p$ koalisyonun hepsinin değerini gerektirir. Dört özellik için bu yalnız 16 koalisyondur; kesin hesabı sıfırdan yazabiliriz:
def shapley_kesin(f, x, arka_plan):
    p = len(x)
    v = {}                                            # koalisyon değeri v(S) = E[f(x_S, X_S̄)]
    for r in range(p + 1):
        for S in itertools.combinations(range(p), r):
            Z = arka_plan.copy()
            Z[:, list(S)] = x[list(S)]                # S'deki özellikler x'ten, diğerleri arka plandan
            v[S] = f(Z).mean()
    phi = np.zeros(p)
    for j in range(p):
        digerleri = [k for k in range(p) if k != j]
        for r in range(p):
            for S in itertools.combinations(digerleri, r):
                agirlik = math.factorial(r) * math.factorial(p - r - 1) / math.factorial(p)
                phi[j] += agirlik * (v[tuple(sorted(S + (j,)))] - v[S])
    return phi, v[()], v[tuple(range(p))]            # φ, E[f], f(x)
Bu fonksiyonu dört özellikli küçük bir modele uyguladık: $s/b$, yaş, süperakışkan ve ilgisiz ortam sıcaklığı. Küçük modelin test RMSE'si 3,95 MPa; çimento tipini görmediği için ana modelden zayıf, ama açıklama için yeterli. Arka plan, eğitim kümesinden 200 karışım ve $\E[f]$ = 37,06 MPa.
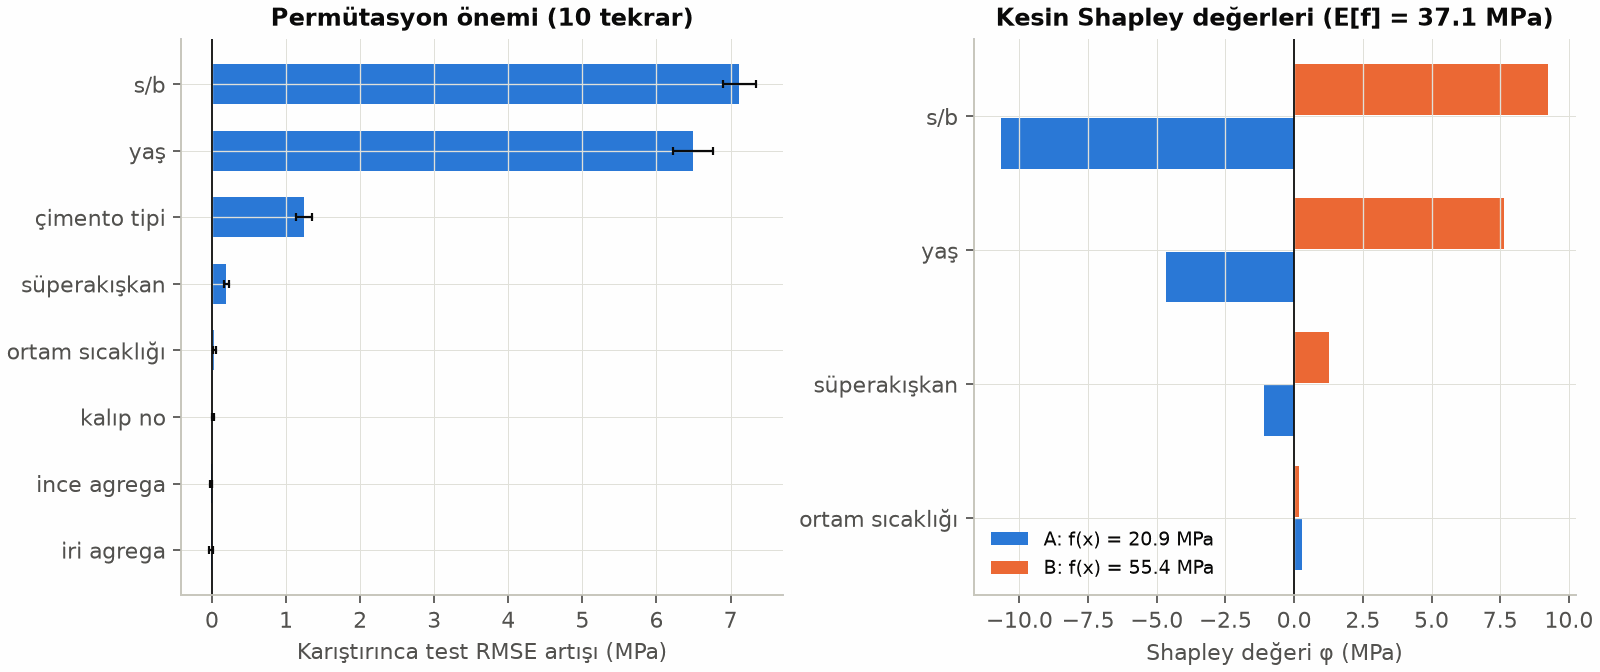
- Karışım A ($s/b$ = 0,65, 7 gün, süperakışkan yok, 25 °C): $f(x)$ = 20,92 MPa. Ortalamadan 16,14 MPa eksiğin −10,67'si yüksek $s/b$'den, −4,66'sı erken yaştan, −1,08'i süperakışkan olmamasından geliyor. Sıcaklığın payı +0,27 MPa.
- Karışım B ($s/b$ = 0,35, 56 gün, 8 kg/m³ süperakışkan, 10 °C): $f(x)$ = 55,40 MPa. Paylar +9,25 ($s/b$), +7,64 (yaş), +1,27 (süperakışkan) ve +0,17 MPa (sıcaklık).
İki karışımda da $\sum_j\phi_j - (f(x) - \E[f])$ farkı sıfır çıkıyor (çıktıda 0.0e+00); verimlilik özelliği kayan nokta duyarlığında sağlanıyor. İlgisiz sıcaklığın payı küçük ama sıfır değil. Model eğitim gürültüsüne biraz uymuş ve Shapley değerleri bunu dürüstçe gösteriyor. Bu tek karışımlık (yerel) bir bulgu; 8 özellikli ana modelde permütasyon önemi ise bu sütunun test doğruluğuna katkısı olmadığını söylüyor. İkisinin neden çelişmediğini Alıştırma 5'te göreceksiniz.
Gerçek modellerde: shap paketi
Kesin hesap $2^p$ koalisyon ister; 30 özellikte bu bir milyarı aşar. Pratikte örneklemeye dayalı yaklaşık yöntemler (permütasyon örneklemesi, KernelSHAP) ya da ağaç modelleri için kesin sonuç veren, polinom zamanlı TreeSHAP kullanılır. Bunların hepsi açık kaynaklı shap paketinde var (Lundberg ve Lee, 2017). Bu kursun sabit paket listesinde değil; kendi projelerinizde kurup kullanabilirsiniz. Hangi aracı seçerseniz seçin iki şeyi unutmayın: sonuç arka plan kümesine bağlıdır (Alıştırma 1) ve Shapley değeri bir katkı paylaştırmasıdır, nedensel etki değildir.
6. Fiziksel tutarlılık: monoton kısıtlar
Basınç dayanımı, diğer her şey sabitken su/bağlayıcı oranı arttıkça azalır ve yaşla artar. Bu, veriden bağımsız bildiğimiz bir şeydir. Ağaç topluluklarına bunu doğrudan söyleyebiliriz: bir özelliğe +1 monoton kısıt verilirse model o özellikte hiçbir yerde azalan, −1 verilirse hiçbir yerde artan tahmin üretemez. +1 kısıt için tanım ($\vect x_{-j}$: sabit tutulan diğer bütün özellikler):
$$ x_j \le x_j' \;\Rightarrow\; f(x_j, \vect x_{-j}) \le f(x_j', \vect x_{-j}) $$Gradient boosting'de kısıt, ağaç büyütülürken uygulanır: kısıtı bozacak bölünmeler reddedilir ve yaprak değerleri sınırlanır. scikit-learn'de tek bir argümandır:
KISIT = {"su_baglayici": -1, "yas_gun": 1}      # s/b ↑ → dayanım ↓; yaş ↑ → dayanım ↑
m = HistGradientBoostingRegressor(max_iter=200, learning_rate=0.1, min_samples_leaf=5,
                                  monotonic_cst=KISIT, random_state=42)
Sorunun gerçekten görünür olduğu yer küçük ve gürültülü veridir. Bir laboratuvarın elinde yalnız 100 deney sonucu olduğunu düşünelim. Üreticiden on farklı 100'lük eğitim kümesi çektik ve her birinde aynı ayarlarla (küçük veriye uygun esnek bir model: min_samples_leaf=5) kısıtsız ve kısıtlı iki model eğittik. İhlali, 200 test karışımının ICE eğrilerinde saydık: yaş ızgarası 3, 7, 14, 28, 56, 90 gün; $s/b$ ızgarası 0,30–0,70 arasında 21 nokta.
| Model | Test RMSE (MPa) | Yaşla azalan ICE | $s/b$ ile artan ICE | En büyük ihlal (MPa) |
|---|---|---|---|---|
| Kısıtsız | 4,36 | %21 | %99 | 2,89 |
| Monoton kısıtlı | 4,13 | %0 | %0 | 0,00 |
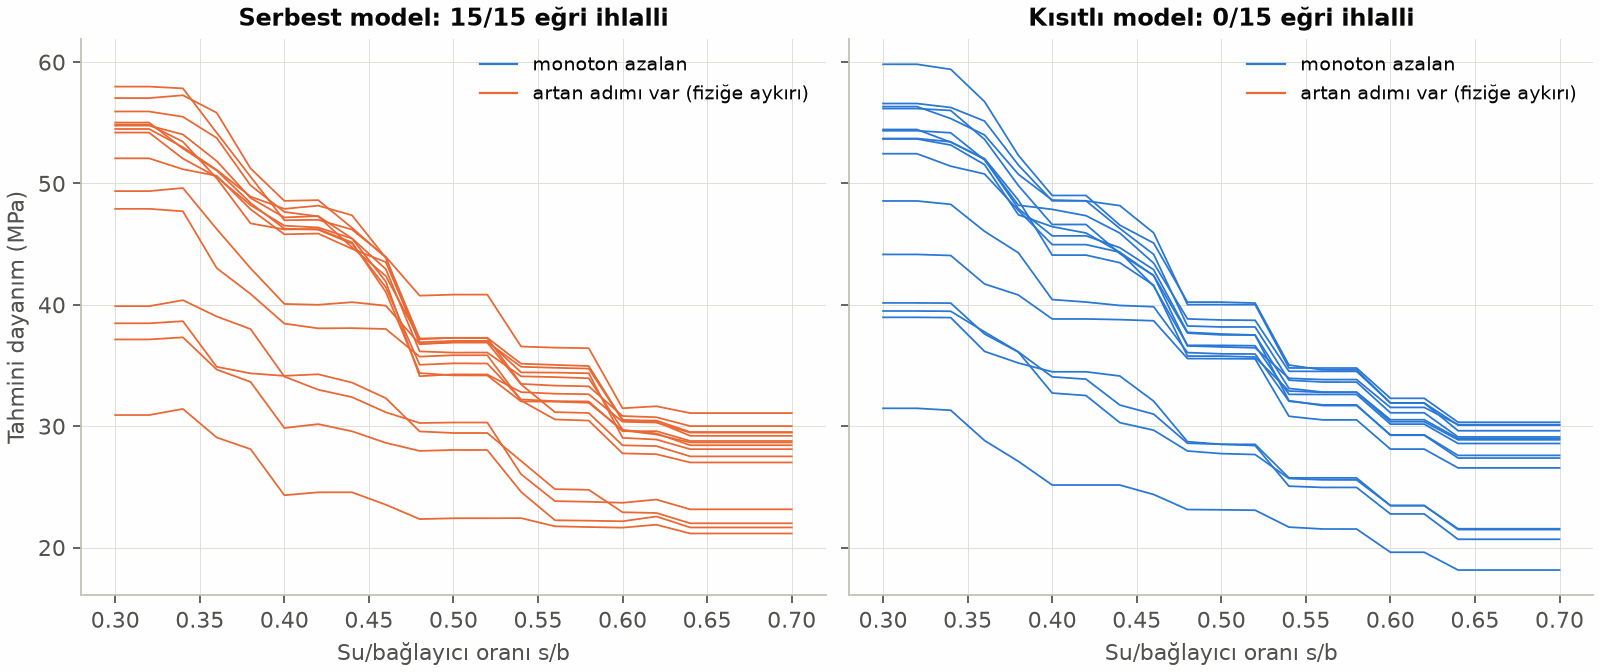
Kısıtsız model, eğrilerin neredeyse hepsinde fiziğe aykırı adımlar içeriyor; en büyüğü 2,89 MPa. Kısıtlı modelde ihlal tanım gereği sıfır. Daha önemlisi kısıt doğruluğu düşürmedi, artırdı: test RMSE'si 4,36'dan 4,13 MPa'ya indi (yaklaşık %5) ve kısıtlı model on kümenin onunda da daha doğruydu. Küçük veride kısıt bir düzenlileştirme gibi çalışır: modelin gürültüye uyabileceği yönleri kapatır. Bu, Ders 16'daki fizik bilgili ağlarla aynı fikrin ağaç modellerindeki karşılığıdır: bildiğiniz fiziği modele doğrudan koyun; modelin onu veriden öğrenmesini beklemeyin.
Kısıt, yanlış fiziği de dayatabilir
Kısıtı yalnız fiziğin gerçekten garanti ettiği yerde kullanın. Örneğin “süperakışkan arttıkça dayanım artar” her zaman doğru değildir; aşırı dozaj ayrışmaya ve dayanım kaybına yol açabilir. Yanlış bir kısıt, veride gerçekten var olan bir ilişkiyi silerek sistematik hata üretir.
7. Uygulama alanı: eğitim verisinden uzak girdiler
Her model, eğitim verisinin kapsadığı bir uygulama alanında (applicability domain) geçerlidir. Ağaç modelleri bu alanın dışında tahmini sabit tutar (Ders 07); sinir ağları bir şekilde uzatır. Hiçbiri “bilmiyorum” demez. Bunu görmek için gerçekçi bir senaryo kurduk: bir hazır beton santralinin geçmiş verisi yalnız olağan karışımları içeriyor ($s/b$ 0,40–0,60, deney yaşı 7–56 gün, 800 karışım). Model şimdi üreticinin tüm aralığından gelen 2000 yeni karışım için kullanılıyor.
Alan içindeki 780 karışımda RMSE 2,79 MPa, alan dışındaki 1220 karışımda 6,25 MPa. 523 karışımda hata %15'i aşıyor. Bir kullanıcı bu girdilerin hangisinin alan dışında olduğunu bilmezse, büyük hatalar sessizce rapora girer. Üç basit dedektör deneyelim:
- Aralık kontrolü. Herhangi bir özellik eğitimdeki en küçük–en büyük aralığın dışındaysa işaretle.
- Mahalanobis uzaklığı. Eğitim verisinin ortalaması $\mu$ ve kovaryansı $\Sigma$ ile, ilişkileri hesaba katan bir uzaklık. Eşik, eğitim noktalarının %99'unu içine alan uzaklıktır.
- IsolationForest. Rastgele ağaçlarla az adımda yalıtılabilen noktaları aykırı sayan bir anomali dedektörü; eşik, eğitim noktalarının %1'ini işaretleyecek biçimde seçildi.
def uzay(df):                      # modelin önemli bulduğu sayısal özellikler; yaş logaritmik
    return np.column_stack([df["su_baglayici"], np.log(df["yas_gun"]), df["super_akiskan"]])

F_e, F_y = uzay(dar), uzay(yeni)
ort, S_ters = F_e.mean(0), np.linalg.inv(np.cov(F_e, rowvar=False))

def mahalanobis(F):
    d = F - ort
    return np.sqrt(np.einsum("ij,jk,ik->i", d, S_ters, d))   # her satır için √(dᵀ Σ⁻¹ d)

d_yeni = mahalanobis(F_y)
esik = np.quantile(mahalanobis(F_e), 0.99)                   # eğitimin %99'u bu uzaklığın içinde
Uzaklığı bilerek modelin önemli bulduğu üç sayısal özellikte ölçtük: $s/b$, yaş ve süperakışkan (permütasyon öneminden biliyoruz; çimento tipi de önemli ama kategorik). Kalıp numarası gibi ilgisiz boyutlar uzaklığa yalnız gürültü ekler. Yaşı logaritmik aldık, çünkü dayanım kazanımı zamanla logaritmik bir hızda yavaşlar: 3 gün ile 7 gün arasındaki fark, 56 gün ile 90 gün arasındakinden çok daha önemlidir. Uzaklığın hangi uzayda ölçüleceği bir mühendislik kararıdır.
| Dedektör | İşaretlenen girdi | Yakalanan büyük hata | RMSE, işaretsiz (MPa) | RMSE, işaretli (MPa) |
|---|---|---|---|---|
| Aralık kontrolü | %61,3 | %92,0 | 2,79 | 6,24 |
| Mahalanobis (eşik 2,63) | %45,8 | %86,6 | 3,26 | 6,79 |
| IsolationForest | %10,9 | %21,6 | 5,08 | 6,00 |
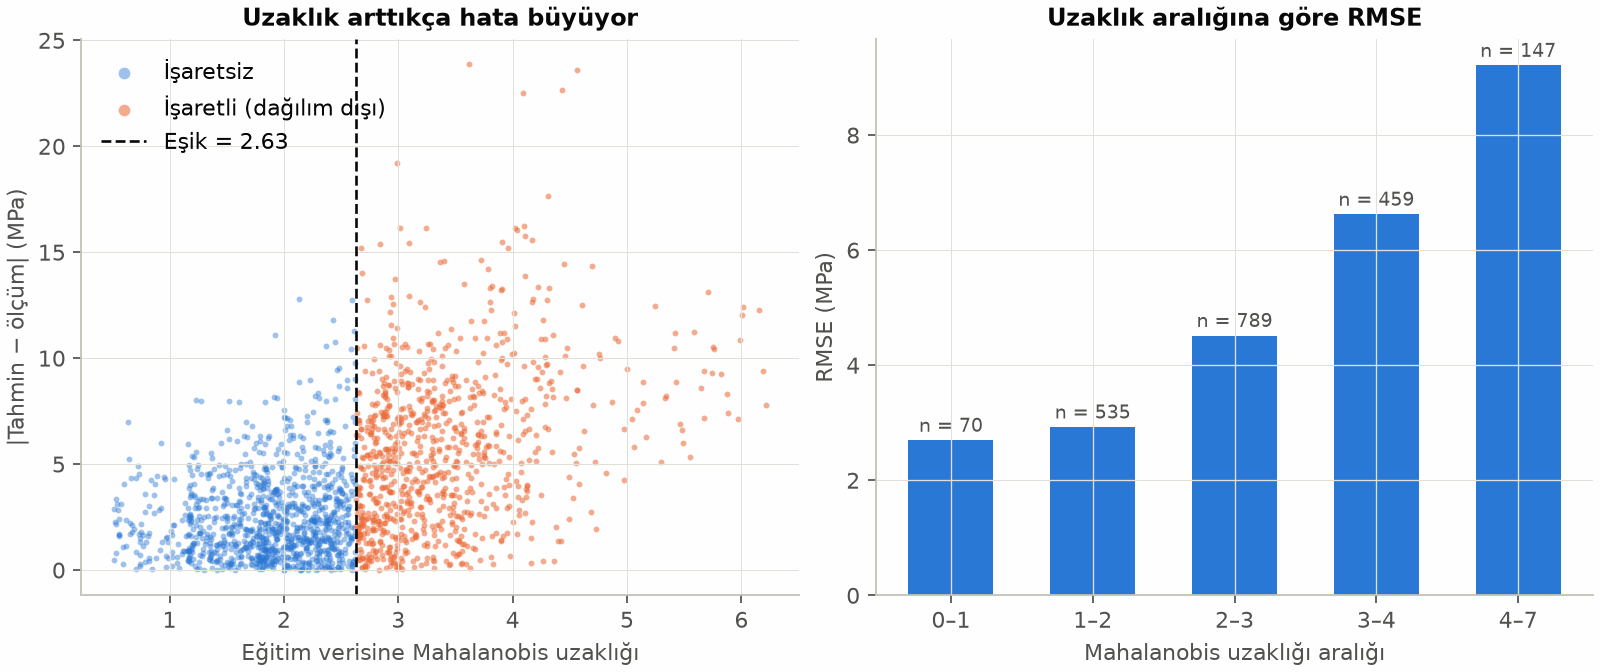
Hata, eğitim verisinden uzaklaştıkça düzenli olarak büyüyor: uzaklığı 1'den küçük karışımlarda RMSE 2,69 MPa; 1–2, 2–3 ve 3–4 aralıklarında 2,92, 4,52 ve 6,62 MPa; 4'ten büyüklerde 9,21 MPa. Basit aralık kontrolü büyük hataların %92'sini yakalıyor; işaretlenmeyen girdilerde RMSE, alan içindekiyle aynı (2,79 MPa). Bu örnekte uygulama alanı bir kutu olduğu için aralık kontrolü doğal olarak çok iyi çalışıyor. Gerçek verilerde alan çoğu zaman kutu değildir: her özellik tek tek aralıkta olsa da bileşimleri hiç görülmemiş olabilir (yüksek çimento ile yüksek su gibi). Mahalanobis uzaklığı bu tür bileşimlere duyarlıdır; ikisini birlikte kullanmak iyi bir başlangıçtır.
IsolationForest büyük hataların yalnız %21,6'sını yakalıyor. Nedeni öğretici: bu yöntem bölünme eşiklerini her düğümdeki verinin en küçük ve en büyük değeri arasından seçer. Bir özelliği eğitim aralığının dışında kalan nokta, o özelliği aralığın ucuna kırpılmış hâliyle aynı yolu izler ve aynı puanı alır: tek boyutta 1,2 ile 10 aynı puanı alır (Alıştırma 3). Yöntem, eğitim verisinin içindeki seyrek bölgeleri bulmakta iyidir, dışarıya taşmayı ölçmekte değil. “Anomali dedektörü” etiketi, her dağılım dışı durumu yakalayacağı anlamına gelmez.
Son olarak yaşa göre ortalama sapmaya bakalım (tahmin − ölçüm): 3 günlük karışımlarda +6,50 MPa, 90 günlüklerde −2,58 MPa. Model 3 günlük dayanımı 7 günlük verisinden uzatıyor ve sistematik olarak fazla tahmin ediyor. Kalıp alma zamanı gibi erken yaş kararlarında bu, güvensiz taraftadır. Dağılım dışı tahmin yalnız daha gürültülü değildir; çoğu zaman yönü de bellidir ve bu yön tehlikeli olabilir.
8. Ortak değişken kayması ve izleme
Model devreye alındıktan sonra da girdiler değişir. Girdi–çıktı ilişkisi aynı kalırken girdilerin dağılımının değişmesine ortak değişken kayması (covariate shift) denir. Senaryomuz: model yalnız CEM I ve CEM II çimentolu 1205 karışımla eğitildi. Santral yeni bir tedarikçiyle çalışmaya başlıyor ve 300 karışımlık yeni bir parti CEM III/A 32,5 N ile üretiliyor. Bu çimento daha yavaş dayanım kazanır.
Üç izleme sinyaline bakalım:
- Şema kontrolü. Eğitimde hiç olmayan bir kategori geldi: CEM III/A 32,5 N. Bu, en ucuz ve en kesin alarmdır. Model ise hata vermiyor: görülmemiş kategoriyi eksik değer gibi işleyip sessizce bir sayı üretiyor.
- Sayısal dağılım testleri. $s/b$, yaş ve süperakışkan için iki örneklemli Kolmogorov–Smirnov testinin p değerleri 0,89, 1,00 ve 0,29. KS testleri kayma göstermiyor. Büyük bir p değeri kaymanın yokluğunu kanıtlamaz; burada üretici bu dağılımları çimento tipinden bağımsız seçtiği için kayma gerçekten yok. Yalnız bunlara bakan bir izleme sistemi hiçbir şey fark etmezdi.
- Artıklar. Deney sonuçları geldikçe hata hesaplanabilir. Yeni partide ortalama sapma +5,86 MPa ve RMSE 7,17 MPa (eğitim dağılımında 3,06 MPa). 3–7 günlük karışımlarda sapma +9,88 MPa: model, yavaş dayanım kazanan çimentonun erken dayanımını ciddi biçimde fazla tahmin ediyor.
Ders şu: izleme yalnız sayısal girdilerin histogramlarına bakmak değildir. Şemayı (sütunlar, kategoriler, birimler, aralıklar), girdi dağılımlarını ve etiketler geldikçe artıkları birlikte izleyin. Artık izlemesi en güvenilir sinyaldir ama gecikmelidir; şema ve dağılım kontrolleri hızlıdır ama her şeyi görmez. Kalıcı bir kayma görülürse yapılacak iş bellidir: yeni koşullardan veri toplamak ve modeli yeniden eğitmek (Alıştırma 4).
9. Tekrarlanabilirlik, kayıt ve model kartı
Bir hesabın denetlenebilmesi için aynı girdilerle aynı sonucun yeniden üretilebilmesi gerekir. Makine öğrenmesinde bunun dört bileşeni var:
- Tohumlar. Kursun bütün betiklerinde
np.random.default_rng(42)verandom_state=42kullandık. PyTorch'tatorch.manual_seed(42)gerekir. Tohum, veriyi bölmeyi, ağaçların rastgeleliğini ve permütasyonları sabitler. Not: çok iş parçacıklı hesaplarda toplamaların sırası değişebileceği için son basamaklar farklı donanımda yine de oynayabilir. - Sürümler. Bu kursun bütün betikleri requirements.txt dosyasındaki sabit sürümlerle test edildi; betik de çalıştığı sürümleri yazdırıyor: numpy 2.5.3, pandas 3.0.6, scikit-learn 1.9.0, joblib 1.6.0. Kütüphanenin yeni bir sürümü, varsayılan bir ayarı değiştirerek sonucu sessizce değiştirebilir.
- Veri sürümü. Model, hangi veriyle eğitildiğiyle birlikte anlamlıdır. Betik eğitim tablosunu bir CSV dosyasına kaydedip dosyanın SHA-256 parmak izini hesaplıyor (ilk 16 karakter: d4a8c27b2c6364c5). Saklanan dosyanın baytlarını özetlemek kalıcı bir parmak izi verir: aynı dosya, hangi kütüphane sürümüyle okunursa okunsun aynı özeti verir. Veri tek bir satırında bile değişse parmak izi tamamen değişir. Büyük projelerde bu iş için veri sürümleme araçları (ör. DVC) kullanılır.
- Model kaydı. scikit-learn modelleri
joblibile kaydedilip yüklenir. Betik modeli geçici bir klasöre kaydedip geri yüklüyor ve tahminlerin bit bit aynı olduğunu doğruluyor.
joblib.dump(model, yol)
yuklenen = joblib.load(yol)        # yükleme kod çalıştırabilir: yalnız güvenilir dosya!
assert np.array_equal(yuklenen.predict(test[OZ]), tahmin)pickle ve joblib dosyaları kod çalıştırabilir
joblib ve pickle dosyaları yüklenirken içlerindeki talimatlar çalıştırılır. Kötü niyetle hazırlanmış bir model dosyası, açtığınız anda bilgisayarınızda istediği komutu çalıştırabilir. Yalnız kendi ürettiğiniz ya da kaynağına güvendiğiniz dosyaları yükleyin; internetten indirilen “hazır model” dosyalarını doğrudan açmayın. Daha güvenli bir seçenek, yalnız izin verilen türleri yükleyen skops biçimidir (scikit-learn'ün model kaydı belgesinde anlatılıyor). Ayrıca bir modeli, eğitildiği kütüphane sürümüyle yükleyin.
Model kartı (model card), bir modelin kimlik belgesidir: ne için yapıldığını, hangi veriyle eğitildiğini, nerede kullanılabileceğini ve nerede kullanılamayacağını tek sayfada söyler. Mitchell ve arkadaşlarının (2019) önerdiği biçimden uyarlanmış bir şablonu, bu dersin ana modeli için doldurduk:
| Amaç | Beton karışımının 3–90 günlük basınç dayanımını ön tahmin etmek; karışım tasarımında deneme sayısını azaltmak için karar desteği. Numune deneyinin ve standartlardaki uygunluk değerlendirmesinin yerine geçmez. |
|---|---|
| Model | HistGradientBoostingRegressor, 300 ağaç, öğrenme hızı 0,05; girdiler: etkin $s/b$, yaş, süperakışkan, çimento tipi (ve dört ilgisiz sütun). |
| Veri | Kursun sentetik beton üreticisi; 1500 eğitim ve 500 test karışımı, tohum 42. Eğitim verisinin (CSV) parmak izi d4a8c27b2c6364c5. |
| Kapsam ve sınırlar | Üreticinin aralıkları: çimento 250–500 kg/m³, su 150–210 kg/m³, yaş 3–90 gün, üç çimento tipi. Bu aralıkların ve bileşimlerin dışındaki girdiler işaretlenmeli (aralık kontrolü ve Mahalanobis uzaklığı). Görülmemiş çimento tiplerinde kullanılamaz. |
| Ölçütler | Test RMSE 3,06 MPa, $R^2$ = 0,904 (500 karışım). Hatanın büyük kısmı üreticinin %7'lik çarpımsal gürültüsünden gelir. |
| Bilinen zayıflıklar | Monotonluk garanti değil: ICE eğrilerinin %94'ünde $s/b$ ile küçük artışlar (en çok 0,79 MPa); kısıtlı sürüm önerilir. Eğitim aralığının (3–90 gün, üreticinin karışım aralıkları) ve görülmemiş bileşimlerin dışında sistematik sapma beklenmeli; 7. bölümde 7–56 günle eğitilen bir model 3 günlük dayanımı ortalama 6,50 MPa fazla tahmin etti. |
| Sorumlu kişi | Modeli geliştiren ve kullanımını onaylayan mühendisin adı, unvanı ve iletişim bilgisi (şablonda boş). |
| Sürüm | 1.0; numpy 2.5.3, pandas 3.0.6, scikit-learn 1.9.0. Her yeniden eğitimde sürüm, veri parmak izi ve ölçütler güncellenir. |
10. Mühendislikte sorumlu kullanım
Bu kursun bütün örneklerinde aynı cümleyi tekrarladık: makine öğrenmesi modeli bir karar destek aracıdır, yönetmelik hesabının ya da deneyin yerine geçmez. Kursu bitirirken bunu somut alışkanlıklara çevirelim:
- Sorumluluk mühendistedir. Bir modelin önerisini kullanarak verilen kararın teknik ve hukuki sorumluluğu, kararı veren mühendistedir. “Model öyle dedi” bir gerekçe değildir.
- Yönetmelik ve standart kontrolleri kalır. Bir taşıyıcı elemanın boyutlandırılması, betonun uygunluk değerlendirmesi ya da bir bağlantının kontrolü ilgili yönetmelik ve standartlardaki kurallarla yapılır. Model en fazla nereden başlanacağını ya da hangi seçeneğin önce deneneceğini söyler.
- Bağımsız sağlama. Her önemli tahmini basit bir mühendislik hesabıyla sağlayın. Bu derste PD eğrisini Abrams yasasıyla, Proje 5'te vekilin bulduğu tasarımı kesin KLT ile karşılaştırdık. Sağlama tutmuyorsa modele değil, hesaba güvenin ve nedenini araştırın.
- Belirsizliği raporlayın. Tek bir sayı yerine bir aralık verin (Ders 15'teki güven bantları ve uyumlu tahmin) ve aralığın neyi kapsamadığını yazın.
- Varsayımları ve sınırları yazın. Model kartı, hesap raporunun bir eki gibi düşünülmelidir: veri, kapsam, ölçütler, bilinen zayıflıklar.
- İnsanı döngüde tutun. Alan dışı ya da beklenmedik girdilerde model kararı vermemeli, bir mühendise devretmelidir. Bu derste gördüğünüz dedektörler tam olarak bu devri tetiklemek içindir.
11. Sık yapılan hatalar
- Test hatasını tek ölçüt saymak. RMSE, modelin neye dayandığını, fiziğe uyup uymadığını ve nerede geçerli olduğunu söylemez.
- Önemi nedensellik sanmak. Permütasyon önemi ve Shapley değerleri modelin davranışını açıklar, dünyanın işleyişini değil. Veri toplama düzeninden sızan bir sütun en önemli özellik çıkabilir.
- Yalnız PD'ye bakmak. Ortalama eğri düzgün görünürken tek tek karışımlarda fiziğe aykırı adımlar olabilir. ICE eğrilerine de bakın.
- Modelin “bilmiyorum” diyeceğini varsaymak. Hiçbir regresyon modeli alan dışında uyarı vermez. Uyarıyı siz kurmalısınız: aralık, uzaklık ve şema kontrolleri.
- Güvenilmeyen bir model dosyasını yüklemek.
joblib.loadvepickle.loadkod çalıştırabilir. - Sürümü, tohumu ve veriyi kaydetmemek. Altı ay sonra “bu sonuç nereden çıktı?” sorusunun yanıtı olmalıdır.
12. Alıştırmalar
Alıştırma 1KolayArka plan seçimi
Kesin Shapley hesabında arka plan kümesini 200 yerine 20 ve 1000 karışımla tekrarlayın (egitim[OZ4].to_numpy()[:20] gibi). Karışım A için $\E[f]$ ve $\phi$ değerleri nasıl değişiyor?
Çözümü göster
$\E[f]$, 20 karışımla 39,90 MPa; 200 ile 37,06 MPa ve 1000 ile 37,07 MPa. Karışım A'da $s/b$'nin payı sırasıyla −12,64, −10,67 ve −10,10 MPa; yaşın payı −4,91, −4,66 ve −5,26 MPa.
Shapley değerleri bir referansa göre tanımlıdır: “ortalamaya göre ne kadar farklı?” Referans (arka plan) değişince paylar da değişir. Çok küçük bir arka plan hem ortalamayı hem payları gürültülü yapar; 200 ile 1000 arasında $\E[f]$ neredeyse aynı, ama tek tek paylar hâlâ 0,6 MPa'ya kadar oynuyor. Bir açıklamayı raporlarken arka planı da yazın.
Alıştırma 2OrtaVarsayılan ayarlarla monoton kısıt
6. bölümdeki deneyi min_samples_leaf argümanını kaldırarak, yani varsayılan değer 20 ile tekrarlayın. İhlal oranları ve doğruluk farkı nasıl değişiyor?
Çözümü göster
Kısıtsız modelde test RMSE 4,93 MPa; yaşla azalan ICE oranı %1, $s/b$ ile artan ICE oranı %40 ve en büyük ihlal 1,97 MPa. Kısıtlı modelde RMSE 4,94 MPa ve ihlal yine sıfır; kısıtlı model on kümenin dördünde daha doğru.
Yapraklar büyüyünce model düzleşir: ihlaller azalır ama kaybolmaz ($s/b$ eğrilerinin %40'ı). Doğruluk farkı da ortadan kalkıyor; iki model aynı düzeyde. Yani kısıt bu ayarda doğruluk kazandırmıyor ama hiçbir şey de kaybettirmiyor ve fiziğe uyumu garanti ediyor. Daha esnek modelde (min_samples_leaf=5) ise hem tutarlılık hem doğruluk kazandırmıştı. Varsayılan ayardaki iki model de (4,93 ve 4,94 MPa), esnek ve kısıtlı modelden (4,13 MPa) belirgin biçimde kötü. En iyi seçenek esnek ve kısıtlı modeldir: esneklik doğruluğu, kısıt fiziksel tutarlılığı sağlar.
Alıştırma 3OrtaIsolationForest neden kaçırıyor?
[0, 1] aralığında düzgün dağılımlı 1000 noktayla tek boyutlu bir IsolationForest(n_estimators=200, contamination=0.01, random_state=42) eğitin (rng = np.random.default_rng(0)). score_samples ile 0,5; 0,99; eğitimin en büyük değeri; 1,2; 2 ve 10 noktalarının puanlarını hesaplayın. Ne görüyorsunuz?
Çözümü göster
Puanlar sırasıyla −0,4941; −0,6113; −0,6555; −0,6555; −0,6555 ve −0,6555 (puan küçüldükçe nokta daha aykırıdır). Eğitimin en büyük değeri, 1,2, 2 ve 10 tıpatıp aynı puanı alıyor.
Nedeni algoritmanın yapısı: her düğümde bölünme eşiği, o düğümdeki verinin en küçük ve en büyük değeri arasından rastgele seçilir. 10 noktası bütün bölünmelerde en büyük eğitim noktasıyla aynı tarafa düşer, aynı yaprakta biter ve aynı yol uzunluğunu alır. IsolationForest “eğitim aralığının ne kadar dışındasın?” sorusunu yanıtlayamaz. Mahalanobis uzaklığı ise eğitim ortalamasından uzaklaştıkça sınırsız büyür; aralık dışı tespit için onunla ya da aralık kontrolüyle birlikte kullanın.
Alıştırma 4OrtaKaymaya karşı: yeni veriyle yeniden eğitmek
8. bölümdeki CEM I/II modeline yeni tedarikçiden gelen az sayıda CEM III karışımı ekleyip modeli yeniden eğitin. Yeni karışımları beton_verisi(1000, np.random.default_rng(7)) çıktısındaki CEM III satırlarından alın; 10, 30 ve 100 karışım deneyin. Yeni partideki sapma ve RMSE nasıl değişiyor?
Çözümü göster
Eklenen CEM III sayısı 10, 30 ve 100 iken ortalama sapma +4,51, +1,58 ve +0,61 MPa; RMSE 5,67, 3,63 ve 3,08 MPa; 3–7 günlük karışımlarda sapma +7,40, +4,29 ve +0,83 MPa. Hiç eklemeden değerler +5,86 MPa, 7,17 MPa ve +9,88 MPa idi.
Otuz kadar karışım sapmayı dörtte birine indiriyor, yüz karışımla model eski doğruluğuna yaklaşıyor. Karşılaştırma için bütün tiplerle eğitilmiş ana modelin bu partideki sapması +0,35 MPa ve RMSE'si 2,60 MPa. Kayma görüldüğünde çare çoğu zaman karmaşık bir yöntem değil, yeni koşullardan hedefli veri toplamaktır. O veri gelene kadar model bu tip için kullanılmamalıdır.
Alıştırma 5ZorSekiz özellikli ana model için kesin Shapley
shapley_kesin fonksiyonunu pandas tablolarıyla çalışacak biçimde uyarlayın (çimento tipi kategorik olduğu için NumPy dizisi yerine DataFrame kullanın) ve ana modelin ilk test karışımını açıklayın. Arka plan yine eğitimden 200 karışım olsun. Kaç model değerlendirmesi gerekiyor? İlgisiz sütunlar sıfır mı alıyor?
Çözümü göster
def shapley_kesin_df(model, x, arka_plan):          # x: tek satır (Series), arka_plan: DataFrame
    p = len(OZ); v = {}
    for r in range(p + 1):
        for S in itertools.combinations(range(p), r):
            Z = arka_plan.copy()
            for j in S:
                Z[OZ[j]] = x[OZ[j]]          # sütun metne döner; HGB kodlayıcısı yine doğru eşler
            v[S] = model.predict(Z).mean()
    ...                                              # φ döngüsü öncekiyle aynı
$2^8 = 256$ koalisyon ve her biri için 200 tahmin, toplam 51.200 model değerlendirmesi gerekir. İlk test karışımı $s/b$ = 0,433, 7 gün, süperakışkansız ve CEM I. Sonuç: $f(x)$ = 34,14 MPa, $\E[f]$ = 36,90 MPa ve verimlilik farkı −8,9×10⁻¹⁶. Paylar: $s/b$ +0,007 (değeri ortalamaya yakın), yaş −4,527, süperakışkan −1,040, çimento tipi +2,173, iri agrega +0,676, ince agrega +0,175, kalıp no −0,440 ve sıcaklık +0,222 MPa.
İlgisiz dört sütunun payları küçük ama sıfır değil; iri agrega bu karışımda 0,68 MPa alıyor. Permütasyon önemi ise aynı sütun için sıfıra yakındı (−0,02 ± 0,03 MPa). Çelişki yok: permütasyon önemi tahminlerin ne kadar oynadığını değil, test hatasının ne kadar arttığını ölçer. Ayrı bir denemede iri agrega sütununu on kez karıştırdık: tahminler ortalama 0,76 MPa standart sapmayla oynuyor, ama bu oynamalar hedefle ilişkisiz olduğu için test RMSE'si neredeyse hiç değişmiyor (ortalama −0,03 MPa). Önemin sıfıra yakın olması, modelin sütunu kullanmadığı anlamına gelmez; yalnız sütunun test doğruluğuna katkısı olmadığını gösterir. Yerel açıklamalar bu yüzden küresel ölçütlerle birlikte okunmalıdır. Özellik sayısı 30 olsaydı kesin hesap $2^{30} \approx 10^9$ koalisyon isterdi; o zaman yaklaşık yöntemler (5. bölümdeki kutu) gerekir.
Özet
- Permütasyon önemi modelin neye dayandığını, PD ve ICE eğrileri nasıl dayandığını gösterir. ICE eğrileri ortalamanın gizlediği fiziğe aykırı adımları ortaya çıkarır.
- Shapley değerleri tek bir tahmini özelliklere paylaştırır ve toplamları tahminin ortalamadan farkına tam olarak eşittir. Sonuç arka plan kümesine bağlıdır; katkı, nedensellik değildir.
- Monoton kısıtlar bilinen fiziği modele koyar. Küçük veride hem fiziksel tutarlılığı garanti eder hem de doğruluğu artırabilir.
- Modeller alan dışında uyarı vermez. Aralık kontrolü, Mahalanobis uzaklığı, şema kontrolü ve artık izlemesiyle sessiz hataları görünür kılın; tek bir anomali dedektörüne güvenmeyin.
- Tohum, sürüm, veri parmak izi ve model kartı bir modeli denetlenebilir yapar. Model dosyalarını yalnız güvenilir kaynaktan yükleyin. Karar ve sorumluluk her zaman mühendistedir.
Sonraki adımlar
Bu ders kursun son sayfası. Doğrusal regresyondan başlayıp sinir ağlarına, Gauss süreçlerine ve fizik bilgili ağlara kadar geldik. Bundan sonrası için birkaç öneri:
Kitaplar ve belgeler
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning. İstatistiksel öğrenmenin temel başvuru kitabı; doğrusal modeller, ağaçlar, boosting ve model değerlendirme.
- C. M. Bishop — Pattern Recognition and Machine Learning. Olasılıkçı bakış: Bayesçi yöntemler, çekirdekler, grafik modeller.
- I. Goodfellow, Y. Bengio, A. Courville — Deep Learning. Derin öğrenmenin matematiği ve pratiği.
- C. E. Rasmussen, C. K. I. Williams — Gaussian Processes for Machine Learning. Belirsizlikli regresyon ve vekil modeller için.
- C. Molnar — Interpretable Machine Learning. Bu dersteki yorumlama yöntemlerinin ayrıntılı ve ücretsiz bir anlatımı.
- Resmî belgeler: scikit-learn kullanıcı kılavuzu ve PyTorch öğreticileri. Bir yöntemin varsayılan ayarlarını ve sınırlarını her zaman belgeden okuyun.
İnşaat ve makine mühendisliği öğrencileri için proje önerileri
- Gerçek beton verisiyle bu dersin akışı. UCI veri arşivindeki beton basınç dayanımı veri kümesiyle (Yeh, 1998) bir model kurun; monoton kısıt ekleyin, uygulama alanını tanımlayın ve bir model kartı yazın. Sentetik veriyle gerçek veri arasındaki farkları not edin.
- Sonlu elemanlarla vekil model ve ters tasarım. Kendi yazdığınız ya da açık kaynaklı bir sonlu eleman koduyla delikli plakların burkulma yükü veya bir bağlantının rijitliği için veri üretin. Ders 15'teki aktif öğrenmeyle az analizle vekil kurun, Proje 5'teki gibi ters tasarım yapıp sonuçları yeniden analizle doğrulayın.
- Yapı sağlığı izleme. Bir köprü ya da bina modelinin (veya bir laboratuvar çerçevesinin) ivme kayıtlarından doğal frekansları çıkarın, sıcaklık etkisini PCA ile ayıklayın ve hasar alarmını bu dersteki kayma izleme fikirleriyle kurun (Proje 4'ün gerçek ölçüme taşınmış hâli).
- Deprem kayıtlarından yapı tepkisi. Açık kuvvetli yer hareketi veri tabanlarından (ör. PEER NGA-West2) seçtiğiniz kayıtlarla doğrusal olmayan tek serbestlik dereceli bir sistemin en büyük ötelemesini tahmin eden bir dizi modeli kurun (Ders 14); belirsizliği ve kayıt seçiminin dağılım dışı etkisini raporlayın.
- Makinelerde arıza teşhisi. Açık rulman titreşim veri kümelerinden spektrogram çıkarıp küçük bir evrişimli ağla arıza türünü sınıflandırın (Ders 13). Modeli farklı devir ve yük koşullarında sınayarak dağılım kaymasının etkisini ölçün.
Hangi projeyi seçerseniz seçin, bu dersin sorularını sorun: model neye dayanıyor, fizikle tutarlı mı, nerede geçerli, nasıl doğruladım, başkası aynı sonucu üretebilir mi? Kurs boyunca eşlik ettiğiniz için teşekkürler.
Kaynaklar
- C. Molnar — Interpretable Machine Learning (permütasyon önemi, PD, ICE, ALE ve Shapley değerleri bölümleri).
- S. M. Lundberg, S.-I. Lee (2017) — “A Unified Approach to Interpreting Model Predictions”, NeurIPS. arXiv:1705.07874
- M. Mitchell vd. (2019) — “Model Cards for Model Reporting”, FAT* konferansı. arXiv:1810.03993
- scikit-learn belgeleri: Inspection (permütasyon önemi, PD/ICE), Ensembles (monoton kısıtlar) ve Model persistence (güvenli kayıt).