Bu derste öğrenecekleriniz
- Tensörleri, otomatik türevi ve
nn.Moduleile model kurmayı kullanmak - Eğitim döngüsünü DataLoader, optimizer ve öğrenme hızı planlayıcısıyla yazmak
- SGD, momentum, Adam ve AdamW güncelleme kurallarını açıklamak
- Erken durdurma, ağırlık sönümü, dropout ve
model.eval()kullanımını uygulamak - Hata ayıklama denetimlerini (başlangıç kaybı, küçük yığını ezberleme, gradyan normu) yapmak
- Vekil modelde girdi–çıktı temsilinin ve eğitim aralığının önemini sınamak
1. Problem: cam levha için vekil model
Bir cephe ya da çatı camının boyutlandırılmasında aynı hesap defalarca tekrarlanır: farklı levha boyutları, kalınlıklar, yük kombinasyonları. Dört kenarından basit mesnetli dikdörtgen bir levha için klasik bir seri çözümü var; daha karmaşık durumlarda sonlu eleman analizi gerekir. Tek bir hesap hızlıdır, ama bir optimizasyon döngüsünde, güvenilirlik analizinde ya da etkileşimli bir araçta binlerce hesap gerektiğinde süre birikir. Vekil model (surrogate), çözücünün girdi–çıktı ilişkisini örneklerden öğrenir ve sonucu mikrosaniyeler içinde verir.
Bu derste “çözücü” olarak tam çözümü bilinen bir problemi seçtik: düzgün yayılı yük altındaki basit mesnetli Kirchhoff plağı. Böylece vekil modelin hatasını kesin olarak ölçebiliriz (Proje 3'teki kiriş örneğiyle aynı fikir). Plağın denge denklemi ve eğilme rijitliği:
$$ D\,\nabla^4 w = q $$ $$ D = \frac{E\,t^3}{12\,(1-\nu^2)} $$Girdiler kısa kenar $a \in [0{,}8;\ 2{,}5]$ m, kenar oranı $b/a \in [1;\ 3]$, kalınlık $t \in [6;\ 19]$ mm ve yük $q \in [0{,}5;\ 3]$ kPa. Çıktılar levha ortasındaki sehim $w_{\max}$ (mm) ve en büyük eğilme gerilmesi $\sigma_{\max}$ (MPa). Cam için tipik değerler olan $E = 70$ GPa ve $\nu = 0{,}22$'yi kullandık (kaynaklarda Poisson oranı için 0,2–0,23 arası değerler geçer). 4000 örneği düzgün dağılımla ürettik: 3000 eğitim, 500 doğrulama, 500 test. Ayrıca eğitim aralığının dışından iki küme daha var: daha kalın camlar ($t \in [19;\ 25]$ mm) ve daha büyük levhalar ($a \in [2{,}5;\ 3{,}2]$ m), 500'er örnek.
Bu derste aynı zamanda PyTorch'u tanıyacağız. Ders 11'de elle yazdığımız geri yayılımı otomatik türev üstlenecek; biz de eğitim döngüsünün geri kalan parçalarına odaklanacağız: veri yükleyiciler, optimizer'lar, öğrenme hızı planlaması, erken durdurma, düzenlileştirme ve hata ayıklama.
Doğrusal plak teorisi gerçek camı temsil etmez
Navier çözümü küçük sehim teorisine dayanır: sehim, kalınlığa göre küçük kabul edilir. Sitedeki cam aracının sayfasında da belirtildiği gibi, dört kenarından mesnetli camlarda sehim kalınlığın yarısını aştığında geometrik doğrusal olmayan teori gerekir. Veri kümemizde $w_{\max}$ 0,062 mm ile 702 mm arasında değişiyor; örneklerin %57'sinde sehim kalınlığın yarısını, %43'ünde kalınlığın kendisini aşıyor (bunlarda $w/t$'nin medyanı 3,3, en büyüğü 108). Sehim kalınlığa yaklaştıkça zar (membran) kuvvetleri önem kazanır ve levhayı rijitleştirir; dört kenarından mesnetli camlarda gerçek sehim ve en büyük gerilme doğrusal çözümün verdiğinden küçük çıkar. Fark $w/t$ büyüdükçe artar ve sehimde gerilmedekinden belirgindir. Doğrusal çözüme göre $\sigma_{\max}$ 279 MPa'ya kadar çıkıyor ve örneklerin %16'sında, tavlanmış float cam için yaygın kullanılan 45 MPa'lık karakteristik dayanımı aşıyor. Buradaki vekil model bir formülü taklit ediyor, gerçek camı değil. Cam boyutlandırması için geometrik doğrusal olmayan analiz yapan cam statik hesabı aracını kullanın; malzeme dayanımı, yük süresi ve yönetmelik kontrolleri de bu dersin kapsamı dışındadır.
2. Navier çözümü ve doğrulama
Navier yöntemi, düzgün yükü çift sinüs serisine açar. Her terim plak denklemini yükün kendi sinüs bileşeni için sağlar ve kenarlarda $w = 0$, eğilme momenti sıfır koşullarını kendiliğinden karşılar. Tek sayılı $m, n$ terimleri yeterlidir:
$$ w(x,y) = \sum_{m,n\ \text{tek}} W_{mn}\,\sin\frac{m\pi x}{a}\,\sin\frac{n\pi y}{b} $$ $$ W_{mn} = \frac{16\,q}{\pi^6 D\, m\,n\,\big[(m/a)^2 + (n/b)^2\big]^2} $$Eğilme momentleri sehimin ikinci türevlerinden gelir: $M_x = -D\,(w_{,xx} + \nu\,w_{,yy})$ ve $M_y = -D\,(w_{,yy} + \nu\,w_{,xx})$. Gerilme, dikdörtgen kesitin elastik mukavemet momentinden bulunur: $\sigma = 6M/t^2$.
Moment serisi ve levha ortasındaki değerler
Serinin türevini terim terim alalım. $\partial^2/\partial x^2$ her terimi $-(m\pi/a)^2$ ile, $\partial^2/\partial y^2$ ise $-(n\pi/b)^2$ ile çarpar. Eksi işaretleri $M_x$ tanımındaki eksiyle sadeleşir:
$$ \begin{aligned} M_x &= \pi^2 D \sum_{m,n} c_{mn}\,W_{mn} \\ &\qquad\times\sin\frac{m\pi x}{a}\,\sin\frac{n\pi y}{b} \\ c_{mn} &= \Big(\frac{m}{a}\Big)^2 + \nu\Big(\frac{n}{b}\Big)^2 \end{aligned} $$$M_y$ için $c_{mn}$'deki terimler yer değiştirir: $\nu(m/a)^2 + (n/b)^2$. Levha ortasında $x = a/2$, $y = b/2$ olduğundan sinüsler işaret çarpanına dönüşür:
$$ \sin\frac{m\pi}{2} = (-1)^{(m-1)/2} $$$\pi^2 D\,W_{mn}$ çarpımında $D$ sadeleşir: momentler $E$'den ve kalınlıktan bağımsızdır; $q$'ya, geometriye ve $\nu$'ye bağlıdır. $b \ge a$ olduğunda büyük moment kısa açıklık yönündeki $M_x$'tir.
Seriyi veri üretiminde kullanmadan önce sonucu bilinen değerlerle karşılaştırmak gerekir. Timoshenko ve Woinowsky-Krieger'in plak kitabında, $\nu = 0{,}3$ için $w_{\max} = \alpha\,q\,a^4/D$, $M_x = \beta\,q\,a^2$ ve $M_y = \beta_1\,q\,a^2$ katsayıları tablo hâlinde verilir. Bizim serimizin sonuçları:
| $b/a$ | $\alpha$ | Tablo | $\beta$ | Tablo | $\beta_1$ | Tablo |
|---|---|---|---|---|---|---|
| 1 | 0,004062 | 0,00406 | 0,04789 | 0,0479 | 0,04789 | 0,0479 |
| 2 | 0,010129 | 0,01013 | 0,10168 | 0,1017 | 0,04635 | 0,0464 |
Bütün farklar tablonun yuvarlama düzeyinde; en büyüğü yüzde 0,11 ($\beta_1$, $b/a = 2$). Serinin yakınsamasını da denetledik. $b/a = 3$'te $m, n \le 49$'dan $m, n \le 99$'a geçince $M_x$ yalnızca $1{,}8\times10^{-5}$, 199'a geçince $1{,}8\times10^{-6}$ oranında değişiyor. Bu yüzden 50×50 = 2500 terim kullandık. Sehim terimleri $1/\{mn[(m/a)^2+(n/b)^2]^2\}$ ile, moment terimleri ise yalnızca $1/\{mn[(m/a)^2+(n/b)^2]\}$ ile söner; momentler bu yüzden daha çok terim ister.
3. PyTorch'un yapı taşları
Tensörler
PyTorch'un temel veri yapısı tensördür: NumPy dizisine çok benzer, ama iki ek yeteneği vardır. GPU'da çalışabilir ve üzerindeki işlemlerin türevini otomatik hesaplayabilir.
T = torch.tensor([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]])
T.shape, T.dtype, T.device           # (2, 3), torch.float32, cpu
A = torch.from_numpy(np.ones(2))     # float64 kalır ve NumPy ile belleği paylaşır
T = T.to("cuda")                     # GPU varsa; bu derste her şey CPU'da
dizi = T.detach().cpu().numpy()      # tekrar NumPy'a
Dikkat edilecek ilk nokta veri tipidir. PyTorch modellerinin ağırlıkları varsayılan olarak float32'dir; NumPy ise float64 üretir. Kodun çıktısında da görüldüğü gibi torch.from_numpy tipi korur. Modele float64 tensör verirseniz tip uyuşmazlığı hatası alırsınız. Bu yüzden kodda dönüşümü torch.tensor(..., dtype=torch.float32) ile açıkça yaptık.
Otomatik türev
requires_grad=True olan bir tensörle yapılan her işlem bir hesap grafiğine kaydedilir. backward() bu grafiği tersten dolaşır, yani Ders 11'de elle yazdığımız geri yayılımı yapar, ve gradyanları .grad alanına yazar:
x = torch.tensor(1.3, dtype=torch.float64, requires_grad=True)
y = x**2 * torch.sin(x)
y.backward()                          # dy/dx → x.grad
analitik = 2 * 1.3 * np.sin(1.3) + 1.3**2 * np.cos(1.3)
İki değer de 2,957324302460 çıkıyor. İki ayrıntı önemlidir. Birincisi, gradyanlar birikir: ileri hesabı yeniden yapıp backward()'u bir kez daha çağırırsanız .grad iki katına çıkar (aynı grafik üzerinde ikinci çağrı ise retain_graph=True verilmedikçe hata verir). Eğitim döngüsünde her adımın başında zero_grad() çağrılmasının nedeni budur. İkincisi, yalnızca tahmin yaparken hesap grafiğine ihtiyaç yoktur; with torch.no_grad(): bloğu grafiği kapatır, bellek ve zaman kazandırır.
Modeller: nn.Module ve nn.Sequential
Katmanları sırayla uygulayan ağlar için nn.Sequential yeterlidir. Modelimiz 4 girdi, 64'er birimli üç gizli katman ve 2 çıktıdan oluşuyor; 8770 parametresi var:
def model_kur():
    model = nn.Sequential(nn.Linear(4, 64), nn.SiLU(), nn.Linear(64, 64), nn.SiLU(),
                          nn.Linear(64, 64), nn.SiLU(), nn.Linear(64, 2))
    for katman in model:
        if isinstance(katman, nn.Linear):
            nn.init.kaiming_normal_(katman.weight, nonlinearity="relu")
            nn.init.zeros_(katman.bias)
    return model
Daha karmaşık yapılarda (dallanma, artık bağlantı, birden çok girdi) nn.Module'den türeyen bir sınıf yazılır: katmanlar __init__ içinde tanımlanır, hesap forward içinde yapılır. Ders 13'te bunu kullanacağız.
Aktivasyon olarak SiLU ($z\,\sigma(z)$, “swish” adıyla da bilinir) seçtik. Öğrenilecek fonksiyon pürüzsüz olduğu için pürüzsüz bir aktivasyon, ReLU'nun parça parça doğrusal yaklaşımından daha az birimle daha iyi sonuç verir; Alıştırma 3'te ikisini karşılaştıracaksınız. Başlatma olarak Ders 11'deki He başlatmasını (kaiming_normal_) açıkça yazdık. ReLU için türetilmiştir ama SiLU'ya da iyi uyar.
Kayıp fonksiyonları
nn.MSELoss: regresyon (bu ders).nn.L1Lossvenn.HuberLossaykırı değerlere daha az duyarlıdır.nn.BCEWithLogitsLoss: ikili sınıflandırma. Girdi olarak olasılık değil logit ister; sigmoid kaybın içinde, sayısal olarak kararlı biçimde uygulanır (Ders 11'dekilogaddexpfikri).nn.CrossEntropyLoss: çok sınıflı sınıflandırma; logit ve tamsayı sınıf etiketi alır, softmax'ı kendisi uygular.
4. Optimizer'lar ve öğrenme hızı planlaması
$\vect g_k$, $k$. adımda mini-yığın üzerinden hesaplanan gradyan olsun. SGD, Ders 11'deki güncellemedir:
$$ \theta_{k+1} = \theta_k - \eta\,\vect g_k $$Momentum, geçmiş gradyanların üstel ağırlıklı toplamıyla ilerler (PyTorch'un yazımı):
$$ \begin{aligned} \vect v_{k+1} &= \mu\,\vect v_k + \vect g_k \\ \theta_{k+1} &= \theta_k - \eta\,\vect v_{k+1} \end{aligned} $$Dar bir vadide gradyanın vadiye dik bileşeni her adımda işaret değiştirir ve ortalamada söner; vadi boyunca olan bileşen ise birikir. Tutarlı bir yönde etkin adım $\eta/(1-\mu)$'ye, $\mu = 0{,}9$ için on katına çıkar.
Adam (Kingma ve Ba, 2015), gradyanın hem birinci hem ikinci momentinin üstel ortalamasını tutar ve her parametrenin adımını ayrı ayrı ölçekler:
$$ \begin{aligned} \vect m_{k} &= \beta_1\vect m_{k-1} + (1-\beta_1)\,\vect g_k \\ \vect v_{k} &= \beta_2\vect v_{k-1} + (1-\beta_2)\,\vect g_k^2 \\ \hat{\vect m}_k &= \vect m_k/(1-\beta_1^k) \\ \hat{\vect v}_k &= \vect v_k/(1-\beta_2^k) \\ \theta_{k} &= \theta_{k-1} - \eta\,\frac{\hat{\vect m}_k}{\sqrt{\hat{\vect v}_k} + \epsilon} \end{aligned} $$Kare ve karekök elemanlar üzerinde alınır. Varsayılan değerler $\beta_1 = 0{,}9$, $\beta_2 = 0{,}999$, $\epsilon = 10^{-8}$'dir (buradaki $\beta_1$ Adam'ın sönüm katsayısıdır; Bölüm 2'deki plak katsayısıyla ilgisi yoktur). $\hat{\vect m}$ ve $\hat{\vect v}$ ilk adımlardaki sıfıra doğru yanlılığı düzeltir. Bölme sayesinde adımın büyüklüğü gradyanın ölçeğinden büyük ölçüde bağımsızdır: her parametre kabaca $\eta$ mertebesinde adım atar. SGD'de gradyanı küçük kalan parametreler neredeyse hiç ilerlemezken Adam'da onlar da ilerler. Adam'ın öğrenme hızı seçimine daha az duyarlı olmasının nedeni budur.
Ağırlık sönümü: Adam mı, AdamW mi?
L2 düzenlileştirmesi kayba $\tfrac{\lambda}{2}\lVert\theta\rVert^2$ ekler, bu da gradyana $\lambda\theta$ terimini katar. SGD'de bu, her adımda ağırlıkları biraz küçültmekle (ağırlık sönümü) aynıdır. Adam'da ise eklenen terim de $\sqrt{\hat{\vect v}}$'ye bölünür ve etkisi parametreden parametreye değişir. AdamW (Loshchilov ve Hutter, 2019) sönümü Adam adımından ayırır ve doğrudan uygular: $\theta \leftarrow \theta - \eta\lambda\theta$. Kodda torch.optim.AdamW ile $\lambda = 10^{-5}$ kullandık. Değer küçük, çünkü veri gürültüsüz ve bol; düzenlileştirmeye pek ihtiyaç yok.
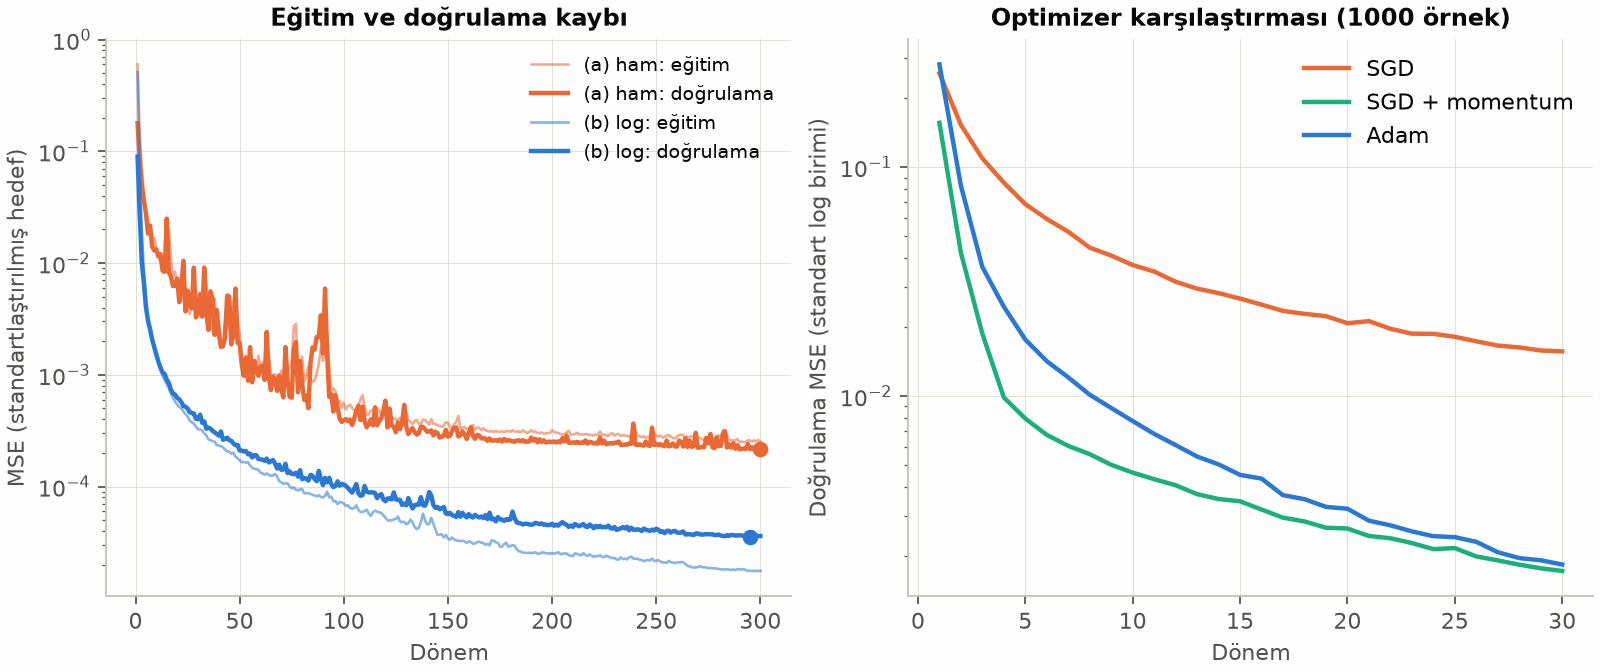
Üç optimizer'ı aynı başlangıç ağırlıklarıyla, 1000 eğitim örneği üzerinde 30 dönem çalıştırdık (Şekil 1, sağ). 30 dönem sonunda doğrulama MSE'si SGD'de ($\eta = 0{,}01$) $1{,}6\times10^{-2}$, momentumlu SGD'de ($\eta = 0{,}01$, $\mu = 0{,}9$) $1{,}7\times10^{-3}$, Adam'da ($\eta = 10^{-3}$) $1{,}8\times10^{-3}$. Momentum ve Adam düz SGD'den yaklaşık on kat düşük kayba indi; bu problemde momentumlu SGD, Adam kadar iyi. Adam'ın asıl üstünlüğü, öğrenme hızı ayarına daha az ihtiyaç duymasıdır; bu yüzden iyi bir varsayılan seçimdir.
Öğrenme hızı planlaması için ReduceLROnPlateau kullandık: doğrulama kaybı 8 dönemden uzun süre iyileşmezse öğrenme hızı yarıya iner. Ana eğitimde 0,005 ile başlayan öğrenme hızı, ham modelde $7{,}8\times10^{-5}$'e, log modelde $1{,}6\times10^{-4}$'e kadar düştü. StepLR (belirli dönemlerde sabit oranda azaltma) ve CosineAnnealingLR (Ders 11'deki kosinüs eğrisi) diğer yaygın seçeneklerdir.
5. Eğitim döngüsü
TensorDataset girdi ve hedef tensörlerini örnek örnek eşler. DataLoader ise her dönemde sırayı karıştırıp veriyi yığınlara böler. Karıştırma sırasının her çalıştırmada aynı olması için kendi rastgele sayı üretecini veriyoruz. Eğitim döngüsünün çekirdeği, hangi model olursa olsun aynı dört adımdır:
yukleyici = DataLoader(TensorDataset(Xe, Ye), batch_size=256, shuffle=True,
                       generator=torch.Generator().manual_seed(42))
opt = torch.optim.AdamW(model.parameters(), lr=5e-3, weight_decay=1e-5)
planlayici = torch.optim.lr_scheduler.ReduceLROnPlateau(opt, factor=0.5, patience=8)
for d in range(donem):
    model.train()
    for xb, yb in yukleyici:
        opt.zero_grad()                     # 1) eski gradyanları sil
        kayip = kayip_fn(model(xb), yb)     # 2) ileri geçiş ve kayıp
        kayip.backward()                    # 3) geri yayılım
        opt.step()                          # 4) güncelleme
    model.eval()
    with torch.no_grad():                   # değerlendirmede hesap grafiği tutma
        L_dog = kayip_fn(model(Xd), Yd).item()
    planlayici.step(L_dog)
    if L_dog < en_iyi:                      # en iyi doğrulama kaybındaki ağırlıkları sakla
        en_iyi, en_iyi_durum, bekleme = L_dog, copy.deepcopy(model.state_dict()), 0
    else:
        bekleme += 1
        if bekleme >= sabir:                # erken durdurma
            break
model.load_state_dict(en_iyi_durum)
model.train() ve model.eval() modelin davranışını değiştirir. Dropout ve toplu normalleştirme (batch normalization) katmanları eğitimde ve değerlendirmede farklı çalışır. Kodda bunu küçük bir denemeyle gösterdik: Dropout katmanı train modunda aynı girdiye iki çağrıda farklı çıktılar verdi, eval modunda ise girdiyi olduğu gibi geçirdi. Değerlendirmeyi eval moduna almayı unutmak, sessiz ve can sıkıcı hataların başında gelir.
Erken durdurma (early stopping), doğrulama kaybının en düşük olduğu ağırlıkları saklar ve kayıp belirli bir sabır süresi (burada 20 dönem) boyunca iyileşmezse eğitimi keser. Sonunda saklanan ağırlıklar geri yüklenir. Bizim ana eğitimimizde iki model de 300 dönemin sonuna kadar gitti; en iyi dönemler 300 ve 295 oldu. Öğrenme hızı azaldıkça doğrulama kaybı yavaş da olsa iyileşmeyi sürdürdü. Veri gürültüsüz ve bol olduğu için aşırı uyum görülmedi. Az ve gürültülü veride ise tablo değişir; Alıştırma 4'te erken durdurmanın devreye girdiğini göreceksiniz.
Düzenlileştirme araçları
- Ağırlık sönümü: yukarıdaki AdamW kutusu.
- Dropout: eğitimde her ileri geçişte birimlerin rastgele bir kısmını ($p$ oranında) sıfırlar, kalanları $1/(1-p)$ ile ölçekler. Ağın tek tek birimlere aşırı güvenmesini önler (Srivastava vd., 2014). Değerlendirmede kapalıdır.
- Toplu normalleştirme (Ioffe ve Szegedy, 2015): her özelliği mini-yığının ortalaması ve standart sapmasıyla normalleştirir, ardından öğrenilen bir ölçek ve kaydırma uygular. Değerlendirmede eğitim boyunca biriktirilen ortalamaları kullanır. Derin ağların eğitimini hızlandırır ve kararlı kılar; Ders 13'teki evrişimli ağda kullanacağız.
Bu dersin regresyon probleminde dropout ve toplu normalleştirmeyi kullanmadık. Gürültüsüz, bol veride hassas bir fonksiyon öğrenirken dropout'un eklediği gürültü yarardan çok zarar getirir.
Kaydetme, yükleme ve tekrarlanabilirlik
Eğitilmiş bir model, ağırlıklarını tutan state_dict sözlüğüyle kaydedilir:
torch.save(model.state_dict(), "plak_vekil.pt")
yeni = model_kur()                            # aynı mimari
yeni.load_state_dict(torch.load("plak_vekil.pt"))
yeni.eval()
Kodda dosya yerine bellekteki bir tampona kaydedip geri yükledik; iki modelin tahminleri arasındaki en büyük fark 0 çıktı. Unutulmaması gereken nokta şu: ölçekleme istatistikleri (ortalama ve standart sapmalar) modelin parçasıdır ve onlar da saklanmalıdır. Aksi hâlde kaydedilen ağırlıklar işe yaramaz. Tekrarlanabilirlik için her model kurulmadan önce torch.manual_seed(42) çağırdık ve DataLoader'a sabit tohumlu bir üreteç verdik. Farklı işlemci, kütüphane sürümü ya da GPU kullanırsanız son basamaklarda küçük farklar görebilirsiniz.
Hata ayıklama listesi
Bir ağ öğrenmiyorsa sorun çoğu zaman veride, ölçeklemede ya da döngüdedir; mimaride değil. Eğitime başlamadan şu denetimleri yapın:
- Başlangıç kaybını kontrol edin. Hedefler standartlaştırıldığında, her zaman sıfır tahmin eden bir modelin MSE'si 1'dir. Yeni başlatılmış modelimizin kaybı 2,41 çıktı; fazlalık, rastgele ağırlıkların ürettiği çıktı varyansıdır. Yüzlerce ya da binlerce görürseniz ölçeklemede hata vardır.
- Küçük bir yığını ezberletin. 32 örneği 300 Adam adımında öğrenen model, bu 32 örnekteki kaybı 2,03'ten $7{,}6\times10^{-5}$'e indirdi. Model 32 örneği bile ezberleyemiyorsa sorun veri miktarında değil, kodun kendisindedir.
- Gradyan normunu izleyin. İlk adımda toplam gradyan normu 9,82'ydi.
nanya da çok büyük değerler öğrenme hızının yüksekliğine veya veride sorun olduğuna, sıfıra yakın değerler ölü birimlere veya sönen gradyana işaret eder.torch.nn.utils.clip_grad_norm_normu hem ölçer hem de gerekirse kırpar. - Boyutları yazdırın.
(N,)ve(N, 1)boyutlu tensörler yayınlamayla(N, N)olur;MSELossbu durumda bir uyarı verir, ama uyarıları okumak gerekir. - Değerlendirmede
model.eval()vetorch.no_grad()kullanın. - Ölçekleyiciyi yalnızca eğitim verisiyle kurun ve tahminlerde ters dönüşümü unutmayın (Ders 01'deki veri sızıntısı).
6. Çalıştırılabilir kod
Betik yedi bölümden oluşuyor: tensör ve otomatik türev denemeleri, Navier çözümü ve doğrulaması, veri kümesi, model ve hata ayıklama, optimizer karşılaştırması ve eğitim, test ve aralık dışı sınama, grafikler. PyTorch'un CPU sürümü yeterlidir; kurulum için requirements-derin.txt dosyasındaki açıklamaya bakın. Betik bu makinede yaklaşık bir buçuk–iki buçuk dakika sürdü; süre bilgisayarınıza göre değişir.
"""Ders 12 — PyTorch ile derin öğrenme: plak sehimi için vekil ağ.

Dört kenarından basit mesnetli, düzgün yayılı yük altındaki dikdörtgen bir cam levhanın orta
noktasındaki sehimi (w_max) ve en büyük eğilme gerilmesini (σ_max) tahmin eden bir sinir ağı
eğitiyoruz. Veri sentetiktir: Kirchhoff plak teorisinin Navier çift seri çözümünden üretilir
(doğrusal, küçük sehim teorisi). Cam için tipik E = 70 GPa ve ν = 0,22 değerleri kullanılır.
Girdiler: kısa kenar a, kenar oranı b/a, kalınlık t, yük q. Aynı ağ iki biçimde eğitilir:
(a) ham büyüklükler, (b) logaritması alınmış büyüklükler; sonra eğitim aralığı dışında sınanır.
Ayrıca tensörler, otomatik türev, eğitim döngüsü, optimizer'lar ve hata ayıklama adımları var.

Çalıştır:  python d12_pytorch_plak.py
Gerekenler: numpy, matplotlib, torch  (Python 3.12+; CPU yeterli)
Süre:      yaklaşık 1–3 dk
Çıktılar:  terminale sayılar, aynı klasöre üç PNG grafiği
"""
import copy
import io
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent
rng = np.random.default_rng(42)
torch.manual_seed(42)
cihaz = "cpu"   # GPU varsa "cuda" yazılabilir; bu ağ CPU'da da hızlı

# %% 1. Tensörler, otomatik türev, train/eval modları
print("=== 1. Tensörler ve otomatik türev ===")
T = torch.tensor([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]])
print(f"Tensör: boyut {tuple(T.shape)}, dtype {T.dtype}, cihaz {T.device}; "
      f"NumPy'dan gelen dizi: {torch.from_numpy(np.ones(2)).dtype}")
x = torch.tensor(1.3, dtype=torch.float64, requires_grad=True)
y = x**2 * torch.sin(x)
y.backward()                                          # dy/dx → x.grad
analitik = 2 * 1.3 * np.sin(1.3) + 1.3**2 * np.cos(1.3)
print(f"d/dx [x² sin x] (x = 1.3): autograd {x.grad.item():.12f}, analitik {analitik:.12f}")
assert abs(x.grad.item() - analitik) < 1e-12
birak = nn.Dropout(p=0.5)
z = torch.ones(1, 8)
birak.train()
farkli = not torch.equal(birak(z), birak(z))
birak.eval()
print(f"Dropout: train modunda iki çağrı farklı = {farkli}; "
      f"eval modunda çıktı = girdi: {torch.equal(birak(z), z)}")


# %% 2. Navier çözümü ve Timoshenko tablosuyla doğrulama
def navier_merkez(a, b, t, q, E, nu, M=99):
    """Basit mesnetli plak, düzgün yük q: orta noktadaki w (m), Mx ve My (N·m/m); SI birimleri.
    m, n = 1, 3, ..., M tek sayılar; a x yönündeki, b y yönündeki kenar."""
    a, b, t, q = (np.atleast_1d(v).astype(float)[:, None, None] for v in (a, b, t, q))
    m = np.arange(1, M + 1, 2, dtype=float)[None, :, None]
    n = np.arange(1, M + 1, 2, dtype=float)[None, None, :]
    D = E * t**3 / (12 * (1 - nu**2))                                   # eğilme rijitliği
    W = 16 * q / (np.pi**6 * D * m * n * ((m / a)**2 + (n / b)**2)**2)  # seri katsayıları
    s = (-1.0)**((m - 1) / 2) * (-1.0)**((n - 1) / 2)                   # sin(mπ/2)·sin(nπ/2)
    w = (W * s).sum(axis=(1, 2))
    Mx = (np.pi**2 * D * W * ((m / a)**2 + nu * (n / b)**2) * s).sum(axis=(1, 2))
    My = (np.pi**2 * D * W * (nu * (m / a)**2 + (n / b)**2) * s).sum(axis=(1, 2))
    return w, Mx, My


def yuzde(x):
    """Türkçe yüzde gösterimi: +%0.06 / −%0.11"""
    return f"{'+' if x >= 0 else '−'}%{abs(x):.2f}"


print("\n=== 2. Navier çözümü: Timoshenko tablosuyla karşılaştırma (ν = 0.3) ===")
TABLO = {1.0: (0.00406, 0.0479, 0.0479), 2.0: (0.01013, 0.1017, 0.0464)}   # α, β, β1
for oran, (al_t, be_t, be1_t) in TABLO.items():
    a_, q_, t_, nu_ = 1.0, 1000.0, 0.01, 0.3
    w_, Mx_, My_ = navier_merkez(a_, oran * a_, t_, q_, 70e9, nu_)
    D_ = 70e9 * t_**3 / (12 * (1 - nu_**2))
    al, be, be1 = w_[0] * D_ / (q_ * a_**4), Mx_[0] / (q_ * a_**2), My_[0] / (q_ * a_**2)
    print(f"b/a = {oran:.0f}: α = {al:.6f} (tablo {al_t}, {yuzde(100*(al/al_t-1))}), "
          f"β = {be:.5f} ({be_t}, {yuzde(100*(be/be_t-1))}), "
          f"β1 = {be1:.5f} ({be1_t}, {yuzde(100*(be1/be1_t-1))})")
    assert max(abs(al / al_t - 1), abs(be / be_t - 1), abs(be1 / be1_t - 1)) < 0.01
_, Mx49, _ = navier_merkez(1.0, 3.0, 0.01, 1000.0, 70e9, 0.3, M=49)
_, Mx99, _ = navier_merkez(1.0, 3.0, 0.01, 1000.0, 70e9, 0.3, M=99)
_, Mx199, _ = navier_merkez(1.0, 3.0, 0.01, 1000.0, 70e9, 0.3, M=199)
print(f"Yakınsama (b/a = 3, Mx): M = 49→99 terimde bağıl değişim {abs(Mx99[0]/Mx49[0]-1):.1e}, "
      f"99→199: {abs(Mx199[0]/Mx99[0]-1):.1e}")

# %% 3. Veri kümesi: cam levhalar
E_CAM, NU_CAM = 70e9, 0.22          # Pa, -  (cam için tipik değerler)
ARALIK = {"a": (0.8, 2.5), "r": (1.0, 3.0), "t": (6.0, 19.0), "q": (0.5, 3.0)}   # m, -, mm, kPa


def ornekle(n, **degisen):
    """Girdiler düzgün dağılımla; çıktılar w_max (mm) ve σ_max = 6·max(Mx, My)/t² (MPa)."""
    ar = {**ARALIK, **degisen}
    a, r, t, q = (rng.uniform(*ar[k], n) for k in ("a", "r", "t", "q"))
    w, Mx, My = navier_merkez(a, r * a, t / 1000, q * 1000, E_CAM, NU_CAM)
    sigma = 6 * np.maximum(Mx, My) / (t / 1000)**2 / 1e6
    return np.column_stack([a, r, t, q]), np.column_stack([w * 1000, sigma])


X, Y = ornekle(4000)
eg, dog, te = np.arange(3000), np.arange(3000, 3500), np.arange(3500, 4000)
X_kalin, Y_kalin = ornekle(500, t=(19.0, 25.0))      # eğitim aralığı dışı: daha kalın cam
X_buyuk, Y_buyuk = ornekle(500, a=(2.5, 3.2))        # eğitim aralığı dışı: daha büyük levha
assert np.all(np.isfinite(Y)) and np.all(Y > 0)
print("\n=== 3. Veri kümesi (cam: E = 70 GPa, ν = 0.22; doğrusal plak teorisi) ===")
print(f"Eğitim/doğrulama/test = {len(eg)}/{len(dog)}/{len(te)}; "
      f"w_max {Y[:, 0].min():.3f}–{Y[:, 0].max():.0f} mm, "
      f"σ_max {Y[:, 1].min():.2f}–{Y[:, 1].max():.0f} MPa")
w_t = Y[:, 0] / X[:, 2]                                       # sehim / kalınlık
print(f"Doğrusal teorinin sınırı: w_max > t/2 olan örnek oranı %{100*np.mean(w_t > 0.5):.0f}, "
      f"w_max > t olan %{100*np.mean(w_t > 1):.0f} (bunlarda w/t medyanı {np.median(w_t[w_t > 1]):.1f}, "
      f"en büyüğü {w_t.max():.0f})")
print(f"σ_max > 45 MPa olan örnek oranı (doğrusal teoriyle): %{100*np.mean(Y[:, 1] > 45):.0f}")
print("Aralık dışı kümeler (500'er): kalın cam t ∈ [19, 25] mm, büyük levha a ∈ [2.5, 3.2] m")

# log-doğrusal referans: ln y = c0 + Σ p_k ln x_k (en küçük kareler)
F = lambda A: np.column_stack([np.ones(len(A)), np.log(A)])
uslu, *_ = np.linalg.lstsq(F(X[eg]), np.log(Y[eg]), rcond=None)
print(f"Log-doğrusal EKK üsleri: w ∝ a^{uslu[1,0]:.3f} (b/a)^{uslu[2,0]:.3f} "
      f"t^{uslu[3,0]:.3f} q^{uslu[4,0]:.3f}; "
      f"σ ∝ a^{uslu[1,1]:.3f} t^{uslu[3,1]:.3f} q^{uslu[4,1]:.3f}")


# %% 4. Model, ölçekleme ve hata ayıklama
def model_kur():
    """4 → 64 → 64 → 64 → 2, SiLU; He (Kaiming) başlatma, sapmalar sıfır."""
    model = nn.Sequential(nn.Linear(4, 64), nn.SiLU(), nn.Linear(64, 64), nn.SiLU(),
                          nn.Linear(64, 64), nn.SiLU(), nn.Linear(64, 2))
    for katman in model:
        if isinstance(katman, nn.Linear):
            nn.init.kaiming_normal_(katman.weight, nonlinearity="relu")
            nn.init.zeros_(katman.bias)
    return model.to(cihaz)


class Olcekleyici:
    """İsteğe bağlı log dönüşümü + standartlaştırma; istatistikler yalnız eğitim verisinden."""
    def __init__(self, A, log):
        self.log = log
        B = np.log(A) if log else A
        self.ort, self.std = B.mean(axis=0), B.std(axis=0)

    def ileri(self, A):
        B = np.log(A) if self.log else A
        return torch.tensor((B - self.ort) / self.std, dtype=torch.float32, device=cihaz)

    def geri(self, Z):
        B = Z.detach().cpu().numpy() * self.std + self.ort
        return np.exp(B) if self.log else B


kayip_fn = nn.MSELoss()
print("\n=== 4. Model ve hata ayıklama ===")
torch.manual_seed(42)
model = model_kur()
print(f"Model 4-64-64-64-2 (SiLU), parametre sayısı: {sum(p.numel() for p in model.parameters())}")
oX, oY = Olcekleyici(X[eg], log=True), Olcekleyici(Y[eg], log=True)
with torch.no_grad():
    L0 = kayip_fn(model(oX.ileri(X[eg])), oY.ileri(Y[eg])).item()
print(f"Başlangıç kaybı (standart hedef, MSE) = {L0:.2f}  "
      "[hedef varyansı 1; çıktı varyansı kadar fazlası beklenir]")

# küçük bir yığını ezberleyebiliyor mu? (model + döngü + kayıp doğru bağlanmış mı?)
kx, ky = oX.ileri(X[:32]), oY.ileri(Y[:32])
with torch.no_grad():
    L32 = kayip_fn(model(kx), ky).item()                     # bu 32 örnekte başlangıç kaybı
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
for adim in range(300):
    opt.zero_grad()
    kayip = kayip_fn(model(kx), ky)
    kayip.backward()
    if adim == 0:
        g0 = torch.nn.utils.clip_grad_norm_(model.parameters(), float("inf")).item()   # yalnız ölçer
    opt.step()
print(f"32 örneği ezberleme: 300 adımda kayıp {L32:.2f} → {kayip.item():.1e}; ilk adımda gradyan normu {g0:.2f}")


# %% 5. Eğitim döngüsü: DataLoader, AdamW, ReduceLROnPlateau, erken durdurma
def egit(model, Xe, Ye, Xd, Yd, donem=300, yigin=256, lr=5e-3, sabir=20):
    yukleyici = DataLoader(TensorDataset(Xe, Ye), batch_size=yigin, shuffle=True,
                           generator=torch.Generator().manual_seed(42))
    opt = torch.optim.AdamW(model.parameters(), lr=lr, weight_decay=1e-5)
    planlayici = torch.optim.lr_scheduler.ReduceLROnPlateau(opt, factor=0.5, patience=8)
    gecmis = {"egitim": [], "dogrulama": []}
    en_iyi, en_iyi_durum, en_iyi_donem, bekleme = np.inf, None, 0, 0
    for d in range(donem):
        model.train()
        toplam = 0.0
        for xb, yb in yukleyici:
            opt.zero_grad()                     # 1) eski gradyanları sil
            kayip = kayip_fn(model(xb), yb)     # 2) ileri geçiş ve kayıp
            kayip.backward()                    # 3) geri yayılım
            opt.step()                          # 4) güncelleme
            toplam += kayip.item() * len(xb)
        model.eval()
        with torch.no_grad():                   # değerlendirmede hesap grafiği tutma
            L_dog = kayip_fn(model(Xd), Yd).item()
        planlayici.step(L_dog)
        gecmis["egitim"].append(toplam / len(Xe))
        gecmis["dogrulama"].append(L_dog)
        if L_dog < en_iyi:
            en_iyi, en_iyi_durum, en_iyi_donem, bekleme = L_dog, copy.deepcopy(model.state_dict()), d, 0
        else:
            bekleme += 1
            if bekleme >= sabir:                # erken durdurma
                break
    model.load_state_dict(en_iyi_durum)         # en iyi doğrulama kaybındaki ağırlıklar
    return gecmis, en_iyi_donem, opt.param_groups[0]["lr"]


# optimizer karşılaştırması: aynı başlangıç, 1000 eğitim örneği, 30 dönem, log model
print("\n=== 5. Optimizer karşılaştırması ve eğitim ===")
alt = eg[:1000]
opt_gecmis = {}
for ad, kur in [("SGD", lambda p: torch.optim.SGD(p, lr=0.01)),
                ("SGD + momentum", lambda p: torch.optim.SGD(p, lr=0.01, momentum=0.9)),
                ("Adam", lambda p: torch.optim.Adam(p, lr=1e-3))]:
    torch.manual_seed(42)
    m_ = model_kur()
    opt = kur(m_.parameters())
    yuk = DataLoader(TensorDataset(oX.ileri(X[alt]), oY.ileri(Y[alt])), batch_size=64, shuffle=True,
                     generator=torch.Generator().manual_seed(42))
    Xd_, Yd_ = oX.ileri(X[dog]), oY.ileri(Y[dog])
    opt_gecmis[ad] = []
    for d in range(30):
        m_.train()
        for xb, yb in yuk:
            opt.zero_grad()
            kayip_fn(m_(xb), yb).backward()
            opt.step()
        m_.eval()
        with torch.no_grad():
            opt_gecmis[ad].append(kayip_fn(m_(Xd_), Yd_).item())
print("30 dönem sonra doğrulama MSE (standart log birimi): "
      + ", ".join(f"{k} {v[-1]:.1e}" for k, v in opt_gecmis.items()))

sonuc = {}
for ad, log in [("(a) ham", False), ("(b) log", True)]:
    oX_, oY_ = Olcekleyici(X[eg], log), Olcekleyici(Y[eg], log)
    torch.manual_seed(42)                                   # iki model aynı başlangıçla
    m_ = model_kur()
    gecmis, en_iyi_donem, son_lr = egit(m_, oX_.ileri(X[eg]), oY_.ileri(Y[eg]),
                                        oX_.ileri(X[dog]), oY_.ileri(Y[dog]))
    m_.eval()
    sonuc[ad] = (m_, oX_, oY_, gecmis)
    print(f"{ad}: {len(gecmis['dogrulama'])} dönem, en iyi dönem {en_iyi_donem + 1}, "
          f"doğrulama MSE {min(gecmis['dogrulama']):.1e}, son öğrenme hızı {son_lr:.1e}")

# state_dict kaydet / yükle (dosya yerine bellekte bir tampon)
m_b, oX_b, oY_b, _ = sonuc["(b) log"]
tampon = io.BytesIO()
torch.save(m_b.state_dict(), tampon)
tampon.seek(0)
yeni = model_kur()
yeni.load_state_dict(torch.load(tampon))
yeni.eval()
with torch.no_grad():
    fark = (yeni(oX_b.ileri(X[te])) - m_b(oX_b.ileri(X[te]))).abs().max().item()
print(f"state_dict kaydet/yükle: tahminler arasındaki en büyük fark = {fark:.1e}")
assert fark == 0.0


# %% 6. Test kümesi ve aralık dışı sınama
def tahmin(ad, A):
    m_, oX_, oY_, _ = sonuc[ad]
    with torch.no_grad():
        return oY_.geri(m_(oX_.ileri(A)))


def bagil(P, Ygercek):
    return np.abs(P / Ygercek - 1)


print("\n=== 6. Test kümesi: bağıl hata |ŷ/y − 1| ===")
print(f"{'':18s}{'w_max: medyan':>14s}{'%95':>9s}{'en büyük':>10s}  "
      f"{'σ_max: medyan':>14s}{'%95':>9s}{'en büyük':>10s}")
hatalar = {}
for ad in ["(a) ham", "(b) log", "log-doğrusal EKK"]:
    P = np.exp(F(X[te]) @ uslu) if ad == "log-doğrusal EKK" else tahmin(ad, X[te])
    h = bagil(P, Y[te])
    hatalar[ad] = h
    olcutler = [np.median, lambda v: np.percentile(v, 95), np.max]
    hucre = [f"%{100*f(h[:, j]):.2f}" for j in range(2) for f in olcutler]
    print(f"{ad:18s}{hucre[0]:>14s}{hucre[1]:>9s}{hucre[2]:>10s}  {hucre[3]:>14s}{hucre[4]:>9s}{hucre[5]:>10s}")

P_ham = tahmin("(a) ham", X[te])[:, 0]
kucuk, buyuk = Y[te, 0] < 1.0, Y[te, 0] > 10.0
print(f"(a) ham, w_max < 1 mm olan {kucuk.sum()} örnekte medyan hata "
      f"%{100*np.median(hatalar['(a) ham'][kucuk, 0]):.1f}, "
      f"w_max > 10 mm olan {buyuk.sum()} örnekte %{100*np.median(hatalar['(a) ham'][buyuk, 0]):.2f}; "
      f"negatif w tahmini: {int(np.sum(P_ham <= 0))}")

# fiziksel tutarlılık: log modelin girdiye göre türevleri (esneklikler) autograd ile
m_b.eval()
Xg = oX_b.ileri(X[te]).requires_grad_(True)
m_b(Xg)[:, 0].sum().backward()                             # her satırın çıktısı yalnız kendi girdisine bağlı
esnek = Xg.grad.numpy() * oY_b.std[0] / oX_b.std           # ∂ln w/∂ln x_k
print("Log model, autograd ile ∂ln w/∂ln x (test): " + ", ".join(
    f"{k} {esnek[:, i].mean():+.3f} [{esnek[:, i].min():+.2f}, {esnek[:, i].max():+.2f}]"
    for i, k in enumerate(["a", "b/a", "t", "q"])) + "  (fizik: a +4, t −3, q +1)")

print("\n=== 7. Eğitim aralığı dışı: w_max bağıl hatası ===")
for ad_kume, Xk, Yk in [("kalın cam t ∈ [19, 25] mm", X_kalin, Y_kalin),
                        ("büyük levha a ∈ [2.5, 3.2] m", X_buyuk, Y_buyuk)]:
    satir = []
    for ad in ["(a) ham", "(b) log"]:
        P = tahmin(ad, Xk)
        h = bagil(P[:, 0], Yk[:, 0])
        satir.append(f"{ad} medyan %{100*np.median(h):.1f}, en büyük %{100*h.max():.0f}, "
                     f"negatif tahmin {int(np.sum(P[:, 0] <= 0))}")
    print(f"{ad_kume}: " + " | ".join(satir))

# ham model kalın camda nasıl bozuluyor? işaretli hata, mutlak hata ve t'ye göre eğilim
P_k, P_te = tahmin("(a) ham", X_kalin)[:, 0], tahmin("(a) ham", X[te])[:, 0]
print(f"(a) ham, kalın cam: gerçek w_max medyanı {np.median(Y_kalin[:, 0]):.1f} mm, "
      f"1 mm'nin altındakiler %{100*np.mean(Y_kalin[:, 0] < 1):.0f}; "
      f"tahmin %{100*np.mean(P_k > Y_kalin[:, 0]):.0f} örnekte büyük, işaretli medyan hata "
      f"{yuzde(100*np.median(P_k / Y_kalin[:, 0] - 1))}")
print(f"(a) ham, mutlak hata medyanı: test {np.median(np.abs(P_te - Y[te, 0])):.2f} mm, "
      f"kalın cam {np.median(np.abs(P_k - Y_kalin[:, 0])):.2f} mm")
artan = []
for A, P0 in [(X[te], P_te), (X_kalin, P_k)]:
    A2 = A.copy()
    A2[:, 2] += 0.5                                           # kalınlığı 0.5 mm artır
    artan.append(np.mean(tahmin("(a) ham", A2)[:, 0] > P0))
print(f"t 0.5 mm artınca tahmini artan örnek oranı (gerçekte sehim hep azalır): "
      f"test %{100*artan[0]:.0f}, kalın cam %{100*artan[1]:.0f}")
ornek_t = np.array([[1.0, 2.0, 19.0, 1.0], [1.0, 2.0, 25.0, 1.0]])   # a, b/a, t, q
w_g = navier_merkez(ornek_t[:, 0], 2.0 * ornek_t[:, 0], ornek_t[:, 2] / 1000, 1000.0, E_CAM, NU_CAM)[0] * 1000
P_h, P_l = tahmin("(a) ham", ornek_t)[:, 0], tahmin("(b) log", ornek_t)[:, 0]
print(f"Örnek: a = 1 m, b/a = 2, q = 1 kPa, t = 19 → 25 mm: gerçek {w_g[0]:.2f} → {w_g[1]:.2f} mm, "
      f"ham {P_h[0]:.2f} → {P_h[1]:.2f} mm, log {P_l[0]:.2f} → {P_l[1]:.2f} mm")

# %% 7. Grafikler
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
for (ad, (_, _, _, gec)), renk in zip(sonuc.items(), [RENK[1], RENK[0]]):
    d = np.arange(1, len(gec["egitim"]) + 1)
    ax[0].semilogy(d, gec["egitim"], color=renk, lw=1.2, alpha=.55, label=f"{ad}: eğitim")
    ax[0].semilogy(d, gec["dogrulama"], color=renk, label=f"{ad}: doğrulama")
    i = int(np.argmin(gec["dogrulama"]))
    ax[0].plot(i + 1, gec["dogrulama"][i], "o", color=renk, ms=6)
ax[0].set(xlabel="Dönem", ylabel="MSE (standartlaştırılmış hedef)", title="Eğitim ve doğrulama kaybı")
ax[0].legend(loc="upper right", fontsize=8.5)
for (ad, gec), renk in zip(opt_gecmis.items(), [RENK[1], RENK[2], RENK[0]]):
    ax[1].semilogy(np.arange(1, 31), gec, color=renk, label=ad)
ax[1].set(xlabel="Dönem", ylabel="Doğrulama MSE (standart log birimi)",
          title="Optimizer karşılaştırması (1000 örnek)")
ax[1].legend(loc="upper right")
fig.savefig(KLASOR / "d12_pytorch_plak_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained", sharex=True, sharey=True)
sinir = [Y[te, 0].min() * 0.5, Y[te, 0].max() * 2]
for a_, ad, renk in zip(ax, ["(a) ham", "(b) log"], [RENK[1], RENK[0]]):
    P = tahmin(ad, X[te])[:, 0]
    pozitif = P > 0
    a_.loglog(sinir, sinir, color=MUREKKEP, ls="--", lw=1, label="ŷ = y")
    a_.fill_between(sinir, [s * 0.9 for s in sinir], [s * 1.1 for s in sinir], color="#f1f0eb", lw=0,
                    label="±%10")
    a_.scatter(Y[te, 0][pozitif], P[pozitif], s=8, color=renk, alpha=.7, linewidths=0, label="Test örneği")
    a_.set(xlabel="Gerçek w_max (mm)", title=f"{ad}: medyan bağıl hata %{100*np.median(hatalar[ad][:, 0]):.2f}")
    if (~pozitif).any():
        a_.text(0.04, 0.92, f"{int((~pozitif).sum())} negatif tahmin çizilemedi", transform=a_.transAxes,
                fontsize=8.5, color=IKINCIL)
ax[0].set(ylabel="Tahmin ŷ (mm)", xlim=sinir, ylim=sinir)
ax[1].legend(loc="lower right")
fig.savefig(KLASOR / "d12_pytorch_plak_2.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained", sharey=True)
for a_, sutun, Xk, Yk, etiket, sinir_ in [(ax[0], 2, X_kalin, Y_kalin, "Kalınlık t (mm)", ARALIK["t"][1]),
                                          (ax[1], 0, X_buyuk, Y_buyuk, "Kısa kenar a (m)", ARALIK["a"][1])]:
    XX, YY = np.vstack([X[te], Xk]), np.vstack([Y[te], Yk])
    a_.axvspan(sinir_, XX[:, sutun].max(), color="#f1f0eb", lw=0, label="Eğitim aralığı dışı")
    for ad, renk in [("(a) ham", RENK[1]), ("(b) log", RENK[0])]:
        h = bagil(tahmin(ad, XX)[:, 0], YY[:, 0])
        a_.scatter(XX[:, sutun], np.clip(h, 1e-5, None), s=6, color=renk, alpha=.6, linewidths=0, label=ad)
    a_.set(xlabel=etiket, yscale="log", ylim=(1e-5, 1e3))
ax[0].set(ylabel="|ŷ/y − 1| (w_max)", title="Kalınlık yönünde dış değer")
ax[1].set(title="Levha boyutu yönünde dış değer")
ax[0].legend(loc="upper left", markerscale=2)
fig.savefig(KLASOR / "d12_pytorch_plak_3.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d12_pytorch_plak_1.png, _2.png, _3.png")=== 1. Tensörler ve otomatik türev ===
Tensör: boyut (2, 3), dtype torch.float32, cihaz cpu; NumPy'dan gelen dizi: torch.float64
d/dx [x² sin x] (x = 1.3): autograd 2.957324302460, analitik 2.957324302460
Dropout: train modunda iki çağrı farklı = True; eval modunda çıktı = girdi: True
=== 2. Navier çözümü: Timoshenko tablosuyla karşılaştırma (ν = 0.3) ===
b/a = 1: α = 0.004062 (tablo 0.00406, +%0.06), β = 0.04789 (0.0479, −%0.03), β1 = 0.04789 (0.0479, −%0.03)
b/a = 2: α = 0.010129 (tablo 0.01013, −%0.01), β = 0.10168 (0.1017, −%0.02), β1 = 0.04635 (0.0464, −%0.11)
Yakınsama (b/a = 3, Mx): M = 49→99 terimde bağıl değişim 1.8e-05, 99→199: 1.8e-06
=== 3. Veri kümesi (cam: E = 70 GPa, ν = 0.22; doğrusal plak teorisi) ===
Eğitim/doğrulama/test = 3000/500/500; w_max 0.062–702 mm, σ_max 0.55–279 MPa
Doğrusal teorinin sınırı: w_max > t/2 olan örnek oranı %57, w_max > t olan %43 (bunlarda w/t medyanı 3.3, en büyüğü 108)
σ_max > 45 MPa olan örnek oranı (doğrusal teoriyle): %16
Aralık dışı kümeler (500'er): kalın cam t ∈ [19, 25] mm, büyük levha a ∈ [2.5, 3.2] m
Log-doğrusal EKK üsleri: w ∝ a^4.002 (b/a)^0.917 t^-2.998 q^0.999; σ ∝ a^2.002 t^-1.998 q^0.999
=== 4. Model ve hata ayıklama ===
Model 4-64-64-64-2 (SiLU), parametre sayısı: 8770
Başlangıç kaybı (standart hedef, MSE) = 2.41 [hedef varyansı 1; çıktı varyansı kadar fazlası beklenir]
32 örneği ezberleme: 300 adımda kayıp 2.03 → 7.6e-05; ilk adımda gradyan normu 9.82
=== 5. Optimizer karşılaştırması ve eğitim ===
30 dönem sonra doğrulama MSE (standart log birimi): SGD 1.6e-02, SGD + momentum 1.7e-03, Adam 1.8e-03
(a) ham: 300 dönem, en iyi dönem 300, doğrulama MSE 2.2e-04, son öğrenme hızı 7.8e-05
(b) log: 300 dönem, en iyi dönem 295, doğrulama MSE 3.6e-05, son öğrenme hızı 1.6e-04
state_dict kaydet/yükle: tahminler arasındaki en büyük fark = 0.0e+00
=== 6. Test kümesi: bağıl hata |ŷ/y − 1| ===
w_max: medyan %95 en büyük σ_max: medyan %95 en büyük
(a) ham %5.17 %86.21 %1337.37 %1.35 %12.21 %34.63
(b) log %0.44 %1.83 %4.85 %0.27 %1.11 %4.25
log-doğrusal EKK %5.95 %12.79 %23.03 %5.25 %11.15 %19.73
(a) ham, w_max < 1 mm olan 56 örnekte medyan hata %75.0, w_max > 10 mm olan 224 örnekte %1.95; negatif w tahmini: 12
Log model, autograd ile ∂ln w/∂ln x (test): a +4.002 [+3.70, +4.35], b/a +0.831 [-0.14, +2.17], t -3.002 [-3.35, -2.69], q +0.999 [+0.87, +1.14] (fizik: a +4, t −3, q +1)
=== 7. Eğitim aralığı dışı: w_max bağıl hatası ===
kalın cam t ∈ [19, 25] mm: (a) ham medyan %128.3, en büyük %49798, negatif tahmin 9 | (b) log medyan %1.9, en büyük %15, negatif tahmin 0
büyük levha a ∈ [2.5, 3.2] m: (a) ham medyan %4.9, en büyük %75, negatif tahmin 0 | (b) log medyan %1.7, en büyük %16, negatif tahmin 0
(a) ham, kalın cam: gerçek w_max medyanı 1.6 mm, 1 mm'nin altındakiler %39; tahmin %89 örnekte büyük, işaretli medyan hata +%116.97
(a) ham, mutlak hata medyanı: test 0.49 mm, kalın cam 2.38 mm
t 0.5 mm artınca tahmini artan örnek oranı (gerçekte sehim hep azalır): test %7, kalın cam %81
Örnek: a = 1 m, b/a = 2, q = 1 kPa, t = 19 → 25 mm: gerçek 0.24 → 0.11 mm, ham 0.15 → 10.77 mm, log 0.24 → 0.10 mm
Grafikler kaydedildi: d12_pytorch_plak_1.png, _2.png, _3.pngPyTorch eğitimlerinde son basamaklar işlemciye, iş parçacığı sayısına ve kitaplık sürümüne göre biraz farklı çıkabilir; eğilimler ve sonuçlar aynı kalır.
7. Sonuçlar: ham büyüklükler mi, logaritma mı?
Navier katsayılarına bakınca çözümün yapısı görülür. Sehim ve gerilme, kenar oranına bağlı birer katsayı dışında, girdilerin kuvvetlerinin çarpımıdır:
$$ w_{\max} = \alpha\!\left(\tfrac{b}{a}\right)\frac{q\,a^4}{D} \propto \alpha\!\left(\tfrac{b}{a}\right)\frac{q\,a^4}{E\,t^3} $$ $$ \sigma_{\max} = 6\,\beta\!\left(\tfrac{b}{a}\right)\frac{q\,a^2}{t^2} $$Logaritma alınca çarpımlar toplama dönüşür:
$$ \begin{aligned} \ln w_{\max} = c &+ \ln q + 4\ln a - 3\ln t \\ &+ \ln\alpha\!\left(\tfrac{b}{a}\right) \end{aligned} $$Yani log uzayında problem üç girdiye göre doğrusaldır; geriye yalnızca $b/a$'nın tek boyutlu, pürüzsüz bir fonksiyonu kalır. Bunu veriyle de doğruladık: log uzayında en küçük kareler (EKK) ile kurulan doğrusal model, sehim için $a^{4{,}002}$, $t^{-2{,}998}$, $q^{0{,}999}$; gerilme için $a^{2{,}002}$, $t^{-1{,}998}$, $q^{0{,}999}$ üslerini buldu. $b/a$'nın üssü 0,917 çıktı; ama $\ln\alpha$ aslında $\ln(b/a)$'ya göre doğrusal olmadığı için bu yalnızca bir ortalama eğimdir. Log-doğrusal modelin hatası bu yüzden yüzde 6 civarında kalıyor.
Aynı ağı iki biçimde eğittik: (a) girdi ve çıktıları doğrudan standartlaştırarak, (b) önce logaritmalarını alıp sonra standartlaştırarak. Test kümesindeki bağıl hatalar:
| Model | $w_{\max}$ medyan | %95 | En büyük | $\sigma_{\max}$ medyan | %95 | En büyük |
|---|---|---|---|---|---|---|
| (a) Ham | %5,17 | %86,21 | %1337 | %1,35 | %12,21 | %34,63 |
| (b) Log | %0,44 | %1,83 | %4,85 | %0,27 | %1,11 | %4,25 |
| Log-doğrusal EKK | %5,95 | %12,79 | %23,03 | %5,25 | %11,15 | %19,73 |
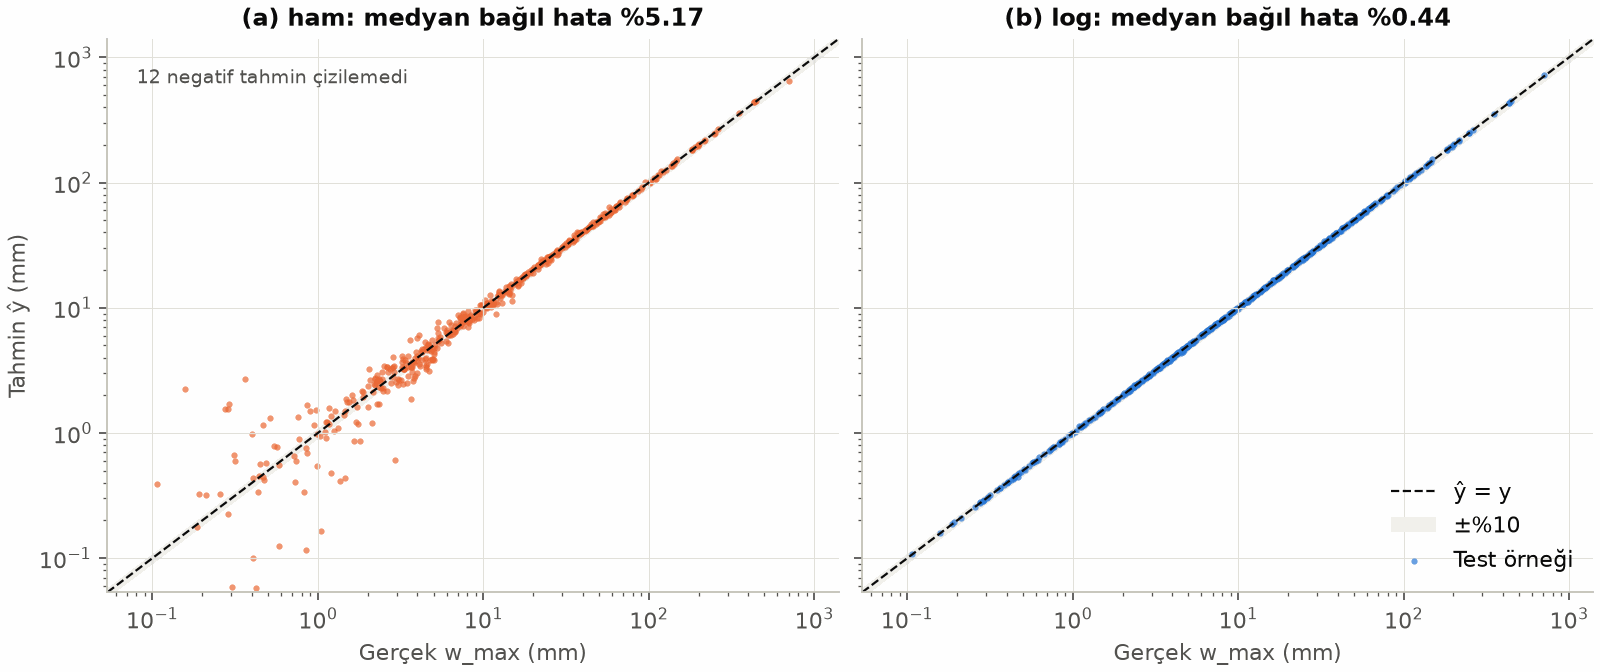
Ham modelin medyan hatası yüzde 5 civarında ama dağılımın kuyruğu çok uzun: test örneklerinin yüzde 5'inde hata yüzde 86'yı aşıyor, en kötü durumda yüzde 1337. Üstelik 12 test örneğinde model negatif sehim tahmin ediyor. Nedeni kayıp fonksiyonudur. Ham uzaydaki MSE mutlak hatayı ölçer: 1 mm'lik hata, sehim ister 700 mm ister 0,1 mm olsun aynı cezayı alır. Çıktılar dört mertebeye yayıldığı için kaybı büyük sehimler belirler ve model küçük sehimleri feda eder. Sayılar bunu açıkça gösteriyor: $w_{\max} < 1$ mm olan 56 test örneğinde medyan hata yüzde 75,0, $w_{\max} > 10$ mm olan 224 örnekte ise yüzde 1,95.
Log uzayında ise $\ln\hat y - \ln y \approx (\hat y - y)/y$ olduğundan MSE kendiliğinden bağıl hatayı ölçer ve model her büyüklükte aynı özeni gösterir. Log modelin medyan hatası sehimde yüzde 0,44, gerilmede yüzde 0,27; en kötü test örneğinde bile yüzde 5'in altında. Aynı ağ, aynı optimizer, aynı veri: farkı yaratan yalnızca temsil.
Türevler fiziğe uyuyor mu?
Otomatik türev yalnızca eğitim için değil, eğitilmiş modeli sorgulamak için de kullanılır. Log modelin çıktısının girdilerine göre türevi, yani $\partial\ln w/\partial\ln x$ esneklikleri, fizikten bilinir: $a$ için 4, $t$ için −3, $q$ için 1. Test kümesindeki 500 nokta için bu türevleri tek bir backward() çağrısıyla hesapladık (her satırın çıktısı yalnız kendi girdisine bağlı olduğu için, çıktıların toplamının gradyanı satır satır türevleri verir):
Xg = oX_b.ileri(X[te]).requires_grad_(True)
m_b(Xg)[:, 0].sum().backward()
esnek = Xg.grad.numpy() * oY_b.std[0] / oX_b.std     # ∂ln w/∂ln x_k
Ortalamalar fiziğe çok yakın: $a$ için +4,002, $t$ için −3,002, $q$ için +0,999. Ama nokta nokta bakınca aralıklar genişliyor: $a$ için [3,70; 4,35], $t$ için [−3,35; −2,69]. Ders 11'deki gözlemin aynısı: model değerleri yüzde 0,4 hatayla bilirken türevleri yüzde 10 mertebesinde saçılabiliyor. Vekil modelin türevine (ör. bir optimizasyonda) güvenecekseniz, türevi ayrıca doğrulayın.
8. Eğitim aralığının dışında
Bir vekil modelin en tehlikeli kullanımı, eğitildiği aralığın dışında sorgulanmasıdır. İki modeli eğitimde görmedikleri iki kümede sınadık:
| Küme | Model | Medyan | En büyük | Negatif tahmin |
|---|---|---|---|---|
| Kalın cam, $t \in [19;\ 25]$ mm | (a) Ham | %128,3 | %49.798 | 9 |
| (b) Log | %1,9 | %15 | 0 | |
| Büyük levha, $a \in [2{,}5;\ 3{,}2]$ m | (a) Ham | %4,9 | %75 | 0 |
| (b) Log | %1,7 | %16 | 0 |
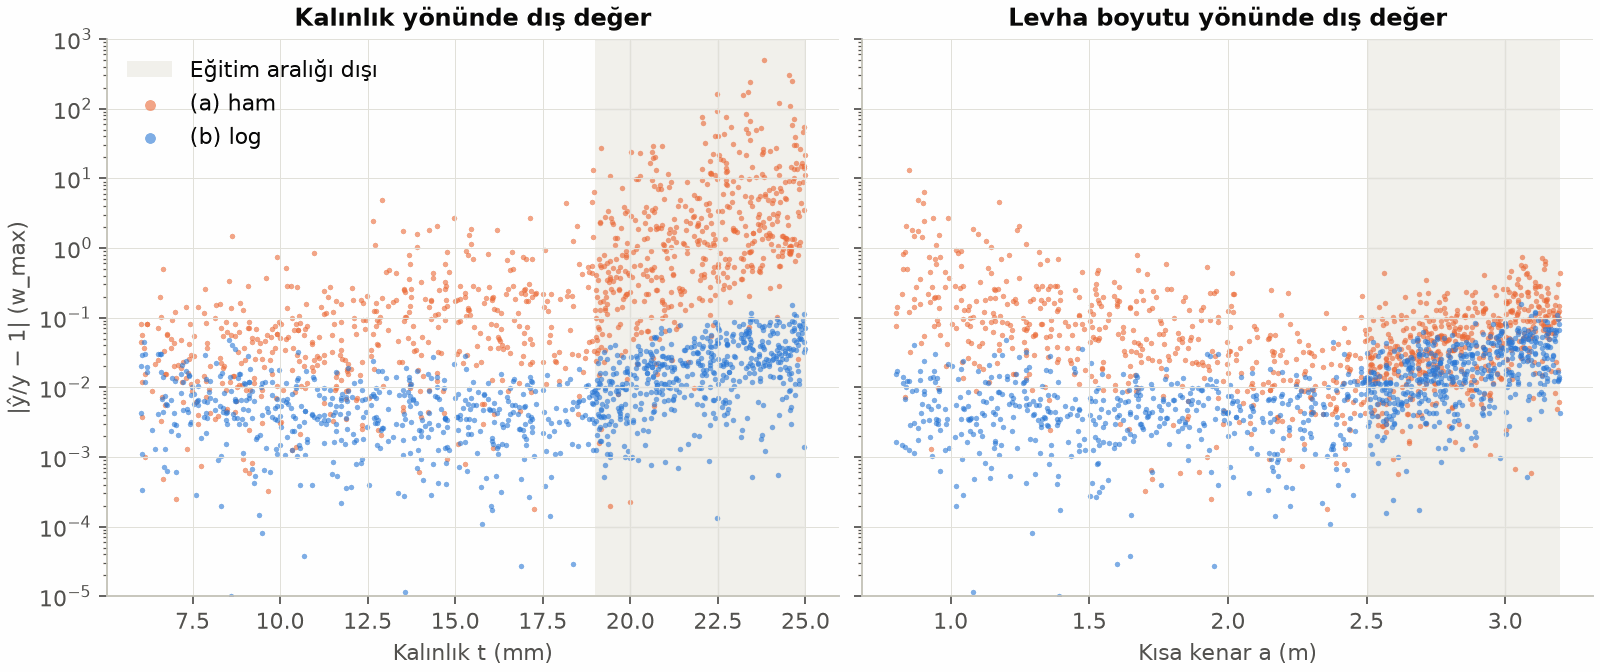
Kalın camlarda ham modelin medyan bağıl hatası yüzde 128 ve 9 levhada sehimi negatif tahmin ediyor. Bunun iki nedeni var. Birincisi, kalın camların sehimi küçüktür: bu kümede gerçek $w_{\max}$'ın medyanı 1,6 mm ve örneklerin yüzde 39'unda sehim 1 mm'nin altında. Ham model ise aralığın içinde bile mutlak hatası yaklaşık yarım milimetre olan bir modeldi (test kümesinde mutlak hata medyanı 0,49 mm). 1 mm'nin altındaki sehimlerde bu, sehimin kendisi kadar bir hatadır ve test kümesinde de 12 negatif tahmine yol açmıştı. Aralığın dışında mutlak hata medyanı 2,38 mm'ye çıkıyor.
İkincisi, tahmin fiziği izlemiyor. Gerçek sehim $t$ büyüdükçe azalır; ham modelin tahmini ise $t$'yi 0,5 mm artırdığımızda kalın camların yüzde 81'inde artıyor (aralığın içinde yalnızca yüzde 7'sinde). Sonuçta sehim çoğunlukla olduğundan büyük tahmin ediliyor: kalın cam kümesinde tahmin, örneklerin yüzde 89'unda gerçek değerden büyük ve işaretli bağıl hatanın medyanı +%117. Tek bir levhada bakalım: $a = 1$ m, $b/a = 2$, $q = 1$ kPa için $t$ 19 mm'den 25 mm'ye çıkınca gerçek sehim 0,24 mm'den 0,11 mm'ye iniyor. Ham model aynı değişimde tahminini 0,15 mm'den 10,77 mm'ye çıkarıyor; log model ise 0,24 mm'den 0,10 mm'ye indiriyor.
Log modelde $\ln w$, $\ln t$'ye göre bir doğrudur ve ağın aralığın hemen dışındaki yaklaşık doğrusal davranışı bu doğruyu uzatır. Yine de log modelin hatası da artıyor: medyan yüzde 0,44'ten 1,9'a, en büyük yüzde 15'e. Doğru temsil dış değer hatasını küçültür, ama ortadan kaldırmaz.
Vekil modeli kullanma kuralları
- Modelin geçerlilik aralığını (her girdinin alt ve üst sınırını) modelle birlikte kaydedin ve aralık dışı girdide uyarı verin. Dağılım dışı girdileri yakalamanın yollarını Ders 17'de göreceğiz.
- Fiziği biliyorsanız kullanın: uygun dönüşümler (burada logaritma) ya da bilinen kısmı modele doğrudan yazmak (Alıştırma 5) hem doğruluğu hem de dış değer davranışını iyileştirir. Ders 16 bu fikri bir adım ileri taşıyor.
- Vekil model, öğrendiği çözücüden daha doğru olamaz. Bu derste çözücü doğrusal plak teorisiydi ve örneklerin yüzde 57'sinde sehim kalınlığın yarısını aştığı için bu teorinin kendisi geçerli değildi.
9. Sık yapılan hatalar
zero_grad()'u unutmak. Gradyanlar birikir ve her adım bütün geçmiş gradyanların toplamıyla atılır (Alıştırma 2).- Değerlendirmede
model.eval()vetorch.no_grad()'u unutmak. Dropout ve toplu normalleştirme yanlış modda çalışır; gereksiz hesap grafiği belleği doldurur. - Kaybı
.item()olmadan toplamak.toplam += kayipher yığının hesap grafiğini bellekte tutar;kayip.item()kullanın. - Logit bekleyen kayba olasılık vermek.
BCEWithLogitsLossveCrossEntropyLosssigmoid/softmax'ı kendileri uygular; önceden uygulamak sessizce yanlış sonuç verir. - Çok mertebeli hedefleri ham hâliyle MSE'ye vermek. Küçük değerler feda edilir; bağıl hata önemliyse log dönüşümü kullanın.
- Modeli kaydedip ölçekleyiciyi kaydetmemek. Ortalama ve standart sapmalar olmadan ağırlıklar kullanılamaz.
10. Alıştırmalar
Alıştırma 1KolayOtomatik türev ve gradyan birikmesi
$f(x) = e^{-x}\cos 3x$ fonksiyonunun $x = 0{,}7$'deki türevini PyTorch ile hesaplayın ve analitik türevle karşılaştırın. Sonra f'yi yeniden hesaplayıp backward()'u bir kez daha çağırın: x.grad ne olur?
Çözümü göster
Analitik türev $f'(x) = -e^{-x}\cos 3x - 3e^{-x}\sin 3x$'tir. İki yol da $-1{,}0352721005$ verir.
x = torch.tensor(0.7, dtype=torch.float64, requires_grad=True)
f = torch.exp(-x) * torch.cos(3 * x)
f.backward()
print(x.grad) # -1.0352721005f'yi yeniden hesaplayıp ikinci kez backward() çağırınca x.grad $-2{,}0705442010$ olur: yeni gradyan eskisinin üstüne eklenmiştir. Eğitim döngüsünde her adımın başında zero_grad() bu yüzden gerekir.
Alıştırma 2Kolayzero_grad olmadan eğitim
Kodun optimizer karşılaştırmasındaki Adam deneyini opt.zero_grad() satırı olmadan tekrarlayın (1000 örnek, 30 dönem). Doğrulama kaybını 1., 5. ve 30. dönemlerde karşılaştırın ve sonucu açıklayın.
Çözümü göster
Doğrulama MSE'si (standart log birimi):
zero_gradile: 1. dönemde 0,281, 5. dönemde 0,0176, 30. dönemde 0,00184.zero_gradolmadan: 1. dönemde 1,26, 5. dönemde 1,00, 30. dönemde 0,384 (en iyi değer 0,242).
Gradyanlar birikince her adımdaki “gradyan”, o ana kadarki bütün yığınların gradyanlarının toplamıdır. Bu toplam ağırlıklar değiştikçe güncelliğini yitirmiş gradyanları da içerir ve ağırlıkları hep aynı yöne iter. Adam adım boyunu normalleştirdiği için eğitim tamamen ıraksamadı, ama 30 dönemde doğru eğitimin 200 katı kayıpta kaldı.
Alıştırma 3OrtaReLU mu, SiLU mu?
model_kur içinde nn.SiLU() yerine nn.ReLU() kullanın ve log modeli aynı ayarlarla yeniden eğitin. Test hatası ve aralık dışı hatalar nasıl değişir?
Çözümü göster
ReLU'lu model 284. dönemde erken durdurmayla durdu (en iyi dönem 264). Karşılaştırma, parantez içinde SiLU'lu ana model:
- Test, $w_{\max}$: medyan %2,06 (%0,44), %95'lik dilim %6,78 (%1,83), en büyük %18,23 (%4,85). $\sigma_{\max}$ medyan %1,41 (%0,27).
- Kalın cam: medyan %4,1 (%1,9), en büyük %33 (%15). Büyük levha: medyan %2,8 (%1,7), en büyük %23 (%16).
ReLU ağı girdilerinin parça parça doğrusal bir fonksiyonudur. Pürüzsüz $\ln\alpha(b/a)$ eğrisini ve girdiler arasındaki etkileşimleri bu parçalarla izlemek için çok daha fazla birim ya da dönem gerekir. Aynı bütçede pürüzsüz SiLU yaklaşık beş kat daha doğru. ReLU sınıflandırmada ve derin ağlarda hâlâ iyi bir varsayılandır; ama pürüzsüz bir fizik fonksiyonunu öğrenen vekil modellerde SiLU, GELU ya da tanh gibi pürüzsüz aktivasyonlar genellikle daha iyi sonuç verir.
Alıştırma 4OrtaErken durdurmayı çalışırken görün
Eğitim kümesini ilk 100 örneğe indirin ve hem eğitim hem doğrulama hedeflerine yüzde 10'luk çarpımsal gürültü ekleyin. Log ölçekleyicileri bu 100 gürültülü örnekle yeniden kurun; log modeli yığın boyu 32 ile, öğrenme hızı planlayıcısı olmadan 400 dönem eğitin ve her dönem doğrulama kaybını kaydedin. Sabır 20 olsaydı erken durdurma ne zaman devreye girerdi? Erken durdurmanın geri yüklediği ağırlıklarla 400. dönemin ağırlıklarını gürültüsüz test değerleri üzerinde karşılaştırın.
Çözümü göster
Bu denemede öğrenme hızı planlayıcısını kullanmadık (sabit 0,005) ki erken durdurmanın etkisi tek başına görülsün. 100 gürültülü örnekle:
rng2 = np.random.default_rng(7)
Xe, Ye = X[eg[:100]], Y[eg[:100]] * np.exp(rng2.normal(0, 0.10, (100, 2)))
Xd, Yd = X[dog], Y[dog] * np.exp(rng2.normal(0, 0.10, (500, 2)))
oX_, oY_ = Olcekleyici(Xe, log=True), Olcekleyici(Ye, log=True) # ölçekleyiciler bu 100 örnekten- 400 dönemin sonunda eğitim kaybı $1{,}23\times10^{-3}$'e iniyor: model 100 örneği, gürültüsüyle birlikte ezberliyor. Doğrulama kaybı ise en düşük değerine ($1{,}63\times10^{-2}$) 54. dönemde ulaşıyor ve 400. dönemde $2{,}13\times10^{-2}$'ye çıkıyor. Bu klasik aşırı uyum tablosudur.
- Sabır 20 ile erken durdurma 74. dönemde devreye girer ve 54. dönemin ağırlıklarını geri yükler.
- Gürültüsüz test değerlerine göre log-MSE, erken durdurulan modelde $1{,}05\times10^{-2}$, 400 dönem eğitilen modelde $1{,}56\times10^{-2}$; sehimin medyan bağıl hatası %8,66'ya karşı %9,48. En kötü yüzde 5'lik dilimde iki model benzer (%31,1 ve %29,7).
Erken durdurma burada hem eğitimi beşte birine kısalttı hem de daha iyi bir model verdi. Dikkat: sabır çok kısa seçilirse gürültülü doğrulama kaybı eğitimi erken kesebilir. Aynı deneyi 200 örnek ve yüzde 5 gürültüyle yaptığımızda sabır 20, 86. dönemde durdurdu; oysa doğrulama kaybının en düşük değeri 249. dönemdeydi.
Alıştırma 5ZorBilinen fiziği modele yazın
Log uzayında sehimin $\ln q + 4\ln a - 3\ln t$, gerilmenin $\ln q + 2\ln a - 2\ln t$ kısmı kesin olarak bilinir. Ağa yalnızca kalan kısmı öğretin: girdisi yalnız $\ln(b/a)$ olan küçük bir ağ (1-32-32-2, SiLU) $\ln y - (\text{bilinen kısım})$ farkını öğrensin; tahminde bilinen kısım geri eklensin. Test kümesinde ve iki aralık dışı kümede hatayı ana log modelle karşılaştırın.
Çözümü göster
US = np.array([[4.0, 0.0, -3.0, 1.0],     # ln w: a, b/a, t, q üsleri
               [2.0, 0.0, -2.0, 1.0]])    # ln σ
fizik = lambda A: np.log(A) @ US.T         # bilinen kısım
R = np.log(Y[eg]) - fizik(X[eg])           # ağın öğreneceği kalan: c + ln α(b/a)
model = nn.Sequential(nn.Linear(1, 32), nn.SiLU(), nn.Linear(32, 32), nn.SiLU(), nn.Linear(32, 2))
# girdi: standartlaştırılmış ln(b/a); tahmin: exp(ağ çıktısı + fizik(A))
1186 parametreli bu küçük ağ (ana modelin yedide biri) aynı eğitim ayarlarıyla şu sonuçları verdi:
- Test: $w_{\max}$ medyan %0,033, %95'lik dilim %0,117, en büyük %0,308; $\sigma_{\max}$ medyan %0,021, en büyük %0,210.
- Kalın cam: $w_{\max}$ medyan %0,036, en büyük %0,336. Büyük levha: medyan %0,036, en büyük %0,369.
Hata ana log modelden on kat küçük ve, daha önemlisi, aralık dışında da aynı. Ağ yalnızca $b/a$'ya bağlı kısmı öğreniyor; kalınlık ve boyut yönündeki davranışı kesin fizik belirliyor. $b/a$ eğitim aralığında kaldıkça dış değer sorunu yok. Bedeli şudur: bilinen kısmın gerçekten doğru olduğunu varsayıyoruz. Geometrik doğrusal olmayan bir camda sehim artık $q$ ile orantılı değildir ve bu yapı yanlış olur.
Özet
- PyTorch'ta model
nn.Module/nn.Sequentialile kurulur, gradyanları otomatik türev hesaplar. Eğitim döngüsü her zaman aynı dört adımdır:zero_grad, ileri geçiş ve kayıp,backward,step. - Momentum ve Adam, düz SGD'den çok daha hızlı yakınsar. AdamW ağırlık sönümünü gradyandan ayrı (decoupled) biçimde uygular; öğrenme hızı planlaması ve erken durdurma doğrulama kaybına bağlanır.
- Değerlendirmede
model.eval()vetorch.no_grad(); başlamadan önce başlangıç kaybı, küçük yığını ezberleme ve gradyan normu denetimleri. - Plak sehimi gibi çok mertebeye yayılan, kuvvet yasasına uyan büyüklüklerde log dönüşümü, sehim hatasının medyanını yüzde 5,17'den yüzde 0,44'e indirdi ve aralık dışı davranışı büyük ölçüde düzeltti.
- Vekil model yalnızca eğitim aralığında ve öğrendiği çözücü kadar güvenilirdir. Burada çözücü doğrusal plak teorisiydi; gerçek cam için geometrik doğrusal olmayan analiz gerekir.
Sonraki derste tam bağlantılı katmanlardan evrişim katmanlarına geçeceğiz: görüntünün uzamsal yapısını kullanan ağlarla beton yüzeyindeki çatlakları ayırt edeceğiz.
Kaynaklar
- PyTorch belgeleri; özellikle torch.optim (optimizer'lar ve öğrenme hızı planlayıcıları).
- D. P. Kingma, J. Ba — “Adam: A Method for Stochastic Optimization”, ICLR 2015, arXiv:1412.6980; I. Loshchilov, F. Hutter — “Decoupled Weight Decay Regularization”, ICLR 2019, arXiv:1711.05101.
- S. Timoshenko, S. Woinowsky-Krieger — Theory of Plates and Shells, 2. baskı, McGraw-Hill, 1959, Bölüm 5 (basit mesnetli dikdörtgen plaklar, Navier çözümü).
- I. Goodfellow, Y. Bengio, A. Courville — Deep Learning, MIT Press, 2016, Bölüm 7 (düzenlileştirme) ve Bölüm 8 (optimizasyon).