Bu derste öğrenecekleriniz
- Vekil model fikrini ve mühendislikte nerede kullanıldığını açıklamak
- Analitik bir çözümden örneklenmiş bir veri kümesi üretmek
- Logaritmik hedefle bir Extra Trees vekil modeli eğitmek
- Ortalama, en büyük ve bağıl hatayı kesin çözüme göre ölçmek
- Ağaç modellerinin eğitim aralığı dışındaki davranışını ve fizik bilgisinin değerini göstermek
1. Mühendislik problemini sınırlayın
Mühendislikte birçok hesap pahalıdır: ayrıntılı bir sonlu eleman modeli dakikalar, bir akışkan analizi saatler sürebilir. Aynı hesabı binlerce kez yapmak gerektiğinde (en iyileme, güvenilirlik analizi, belirsizlik yayılımı) bu hesabın yerine geçen hızlı bir yaklaşık model kurulur. Bu modele vekil model (surrogate) denir. Vekil model, pahalı hesabın seçilmiş girdilerdeki sonuçlarından öğrenilir.
Bu projede vekil model fikrini cevabını bildiğimiz bir problemde sınıyoruz. Basit mesnetli bir kiriş, tüm açıklık boyunca düzgün yayılı yük taşısın. Küçük şekil değiştirme ve doğrusal elastik Euler–Bernoulli kabulüyle orta açıklık sehimi:
$$ \delta = \frac{5\,q\,L^4}{384\,E\,I} $$$q$: N/m, $L$: m, $E$: Pa, $I$: m⁴ kullanıldığında sonuç metredir; kod milimetreye çevirir. Formül elimizde olduğu için modelin her tahminini kesin cevapla karşılaştırabileceğiz.
2. Çözümden bir veri kümesi üretin
1.600 örnekte açıklık 2–6 m, yayılı yük 500–2.500 N/m ve atalet momenti 4×10⁻⁵–12×10⁻⁵ m⁴ arasında düzgün dağılımla seçilir. $E$ sabit 210 GPa'dır. Bu değerler ticari bir projenin verisi değildir. $L$, $q$ ve $I$ birbirinden bağımsız seçildiği için örnekler gerçek bir profil serisini ya da gerilme ve stabilite kontrollerini temsil etmez.
Sehimler 0,0065 mm ile 4,2124 mm arasında, yani yaklaşık 650 kat değişir. 1.280 kiriş eğitim, 320 kiriş test için ayrılır. Pahalı bir hesapta bu 1.600 örneğin her biri ayrı bir analiz demektir; örnek sayısı bu yüzden vekil modellerde değerli bir kaynaktır.
3. Bir vekil model eğitin
Extra Trees, rastgeleleştirilmiş karar ağaçlarının tahminlerini birleştirir (Ders 07, Ders 08). Random Forest'tan iki farkı vardır: bölme eşiklerini de rastgele seçer ve scikit-learn'de varsayılan olarak bootstrap örneklemi yerine bütün eğitim verisini kullanır. Rastgele eşikler varyansı biraz daha azaltır ve eğitimi hızlandırır. Hedef pozitif olduğundan logaritması üzerinde eğitim yapılıp sonuç üstel dönüşümle milimetreye çevrilir. Verinin %20'si test için ayrılır; ayar araması yapılmaz.
model = TransformedTargetRegressor(
    regressor=ExtraTreesRegressor(n_estimators=160, random_state=42, n_jobs=1),
    func=np.log, inverse_func=np.exp)          # log δ üzerinde öğren, exp ile geri çevir
model.fit(X_train, y_train)Neden logaritma?
Sehim 650 kat değiştiğinde 0,01 mm'lik bir hata büyük kirişte önemsiz, en küçük kirişte ise sehimin kendisinden büyüktür (yüzde 150'yi aşar). Ham sehim üzerinde kare hata küçültülürse büyük kirişler kaybı belirler. Logaritmada farklar oran olur: model bağıl hatalara eşit önem verir. Formül de çarpımsaldır; logaritması bir toplama dönüşür: $\ln\delta = \ln\tfrac{5}{384E} + 4\ln L + \ln q - \ln I$. Bu gözlemi Alıştırma 3'te sonuna kadar kullanacaksınız.
4. Çalıştırılabilir kod
Önce kurulum adımlarını tamamlayın ve requirements.txt ile kütüphaneleri yükleyin. Ardından kiris_vekil_model.py dosyasını ortamınızdaki Python ile çalıştırın. Sonuç grafiği kodun bulunduğu klasöre kaydedilir.
"""Proje 3 — Kiriş sehimi için vekil model.

Basit mesnetli, düzgün yayılı yüklü bir kirişin orta açıklık sehimini δ = 5qL⁴/(384EI)
formülünden hesaplayıp 1.600 örneklik sentetik bir veri kümesi üretiyor, bu veriyle bir
Extra Trees vekil modeli eğitiyor ve yaklaşım hatasını ayrılmış test verisinde ölçüyoruz.
Açıklık 2–6 m, yayılı yük 500–2.500 N/m, atalet momenti 4×10⁻⁵–12×10⁻⁵ m⁴, E = 210 GPa sabit.
Bu değerler bir projeden alınmamıştır; kod bir sonlu eleman analizi yapmaz.

Çalıştır:  python kiris_vekil_model.py
Gerekenler: numpy, scikit-learn, matplotlib  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre bir PNG grafiği (kiris_vekil_model.png)
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.ensemble import ExtraTreesRegressor
from sklearn.compose import TransformedTargetRegressor
from sklearn.metrics import mean_absolute_error, mean_squared_error

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent

# %% 1. Veri: analitik çözümden üretilen kirişler
rng = np.random.default_rng(42)
n = 1600
L = rng.uniform(2, 6, n)          # m, açıklık
q = rng.uniform(500, 2500, n)     # N/m, düzgün yayılı yük
E = 210e9                         # Pa, sabit elastisite modülü
I = rng.uniform(4e-5, 12e-5, n)   # m⁴, atalet momenti
X = np.column_stack([L, q, I])
y = 1000 * 5 * q * L**4 / (384 * E * I)  # orta açıklık sehimi, mm (formül metre verir)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=.2, random_state=42)
print("=== 1. Veri ===")
print(f"Örnek: {n} (eğitim {len(X_train)}, test {len(X_test)}); "
      f"sehim aralığı {y.min():.4f}–{y.max():.4f} mm")

# %% 2. Vekil model: logaritmik hedefle Extra Trees (ayar araması yok)
model = TransformedTargetRegressor(
    regressor=ExtraTreesRegressor(n_estimators=160, random_state=42, n_jobs=1),
    func=np.log, inverse_func=np.exp)          # hedef pozitif: log üzerinde öğren, exp ile geri çevir
model.fit(X_train, y_train)
prediction = model.predict(X_test)

# %% 3. Analitik çözümle karşılaştırma (test verisi)
print("\n=== 2. Test ===")
print(f"Ortalama referansı MAE: {mean_absolute_error(y_test, np.full_like(y_test, y_train.mean())):.4f} mm")
print(f"Model MAE: {mean_absolute_error(y_test, prediction):.4f} mm")
print(f"Model RMSE: {np.sqrt(mean_squared_error(y_test, prediction)):.4f} mm")
print(f"En büyük mutlak hata: {np.max(np.abs(y_test-prediction)):.4f} mm")
bagil = 100 * (prediction - y_test) / y_test           # bağıl hata (%)
print(f"Bağıl hata: ortalama mutlak %{np.mean(np.abs(bagil)):.1f}, en büyük %{np.max(np.abs(bagil)):.1f} "
      f"(sehimi {y_test[np.argmax(np.abs(bagil))]:.4f} mm olan kirişte)")
assert np.isfinite(prediction).all() and (prediction > 0).all()

# %% 4. Grafik
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].scatter(y_test, prediction, s=14, color=RENK[0], alpha=.6, label="Test kirişi")
limit = max(y_test.max(), prediction.max())
ax[0].plot([0, limit], [0, limit], color=MUREKKEP, ls="--", lw=1.2, label="Kusursuz eşleşme")
ax[0].set(xlabel="Analitik sehim (mm)", ylabel="Model tahmini (mm)", title="Kiriş sehimi, ayrılan test verisi")
ax[0].legend(loc="upper left")
ax[1].scatter(y_test, bagil, s=14, color=RENK[0], alpha=.6)
ax[1].axhline(0, color=MUREKKEP, lw=1)
ax[1].set_xscale("log")
ax[1].set(xlabel="Analitik sehim (mm, log ölçek)", ylabel="Bağıl hata (%)",
          title="Bağıl hata ve sehim büyüklüğü")
fig.savefig(KLASOR / "kiris_vekil_model.png", dpi=160)
plt.close(fig)
print("\nGrafik kaydedildi: kiris_vekil_model.png")=== 1. Veri ===
Örnek: 1600 (eğitim 1280, test 320); sehim aralığı 0.0065–4.2124 mm
=== 2. Test ===
Ortalama referansı MAE: 0.4525 mm
Model MAE: 0.0210 mm
Model RMSE: 0.0684 mm
En büyük mutlak hata: 0.9129 mm
Bağıl hata: ortalama mutlak %4.3, en büyük %38.1 (sehimi 0.0120 mm olan kirişte)
Grafik kaydedildi: kiris_vekil_model.png5. Bilinen çözümle karşılaştırın
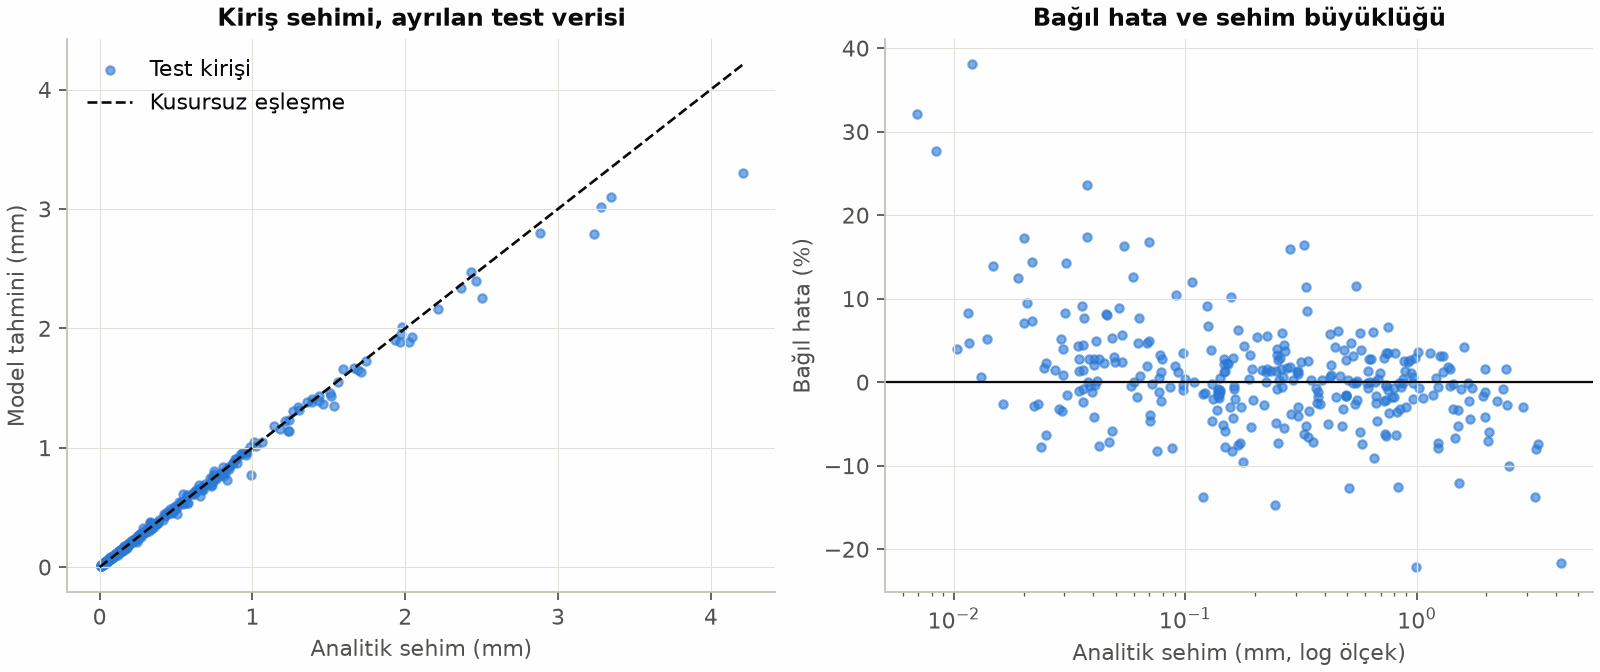
Grafikte her nokta testteki bir kiriştir. Kesikli çizgi kusursuz eşleşmeyi gösterir. Noktanın bu çizgiden uzaklaşması modelin yaklaşım hatasıdır. Ortalama hatanın yanında en büyük mutlak hatayı da ölçün.
Bu çalıştırmada test MAE'si 0,0210 mm, RMSE 0,0684 mm ve en büyük mutlak hata 0,9129 mm oldu. Eğitim ortalamasını kullanan referansın MAE'si 0,4525 mm. Küçük ortalama hata, tekil bir örnekte büyük hata olmayacağı anlamına gelmez. Bağıl hataların ortalaması %4,3, en büyüğü %38,1'dir; bu en büyük bağıl hata, sehimi yalnız 0,0120 mm olan bir kirişte görülür.
Sağdaki grafik hataların nerede toplandığını gösteriyor: en küçük sehimlerde model fazla, en büyük sehimlerde eksik tahmin ediyor. İkisi de girdi uzayının kenar ve köşeleridir (kısa ve rijit kiriş ya da uzun, çok yüklü ve narin kiriş). Ağaçların tahmini komşu eğitim örneklerinin ortalamasıdır; köşede komşuların hepsi bir yanda kaldığı için tahmin içeriye, ortalamaya doğru çekilir. En büyük mutlak hatanın kaynağını Alıştırma 1'de bulacaksınız.
Bu basit problemde analitik formül hızlı ve doğrudan çözümdür. Buradaki amaç formülü değiştirmek değil, daha pahalı simülasyonlarda kullanılan vekil model iş akışını öğrenmektir. Kod sonlu eleman analizi yapmaz.
Grafik ve terminal çıktısı yalnızca belirtilen örnekleme aralığındaki sentetik test verisini değerlendirir. Modelin hatası analitik formüle göredir; formülün gerçek bir yapıyı temsil etme hatasını ölçmez. Bu nedenle yüksek uyum, tasarım doğrulaması anlamına gelmez.
Vekil modelden sonra
Gerçek bir vekil modelde iki soru daha sorulur. Birincisi, model tahmininin ne kadar güvenilir olduğunu kendisi söyleyebilir mi? Gauss süreçleri her tahminle birlikte bir belirsizlik bandı verir ve yeni analizin nerede yapılacağını seçmeye yardım eder (Ders 15). İkincisi, bildiğimiz fiziği modele katabilir miyiz? Fizik bilgili sinir ağları kiriş denklemini doğrudan kayıp fonksiyonuna ekler (Ders 16). Benzetimle eğitilen bir modelin ters yönde, ölçümden nedene doğru kullanımını ise Proje 4'te göreceksiniz.
6. Sık yapılan hatalar
- Yalnız ortalama hataya bakmak. MAE 0,0210 mm iken tek bir kirişte hata 0,9129 mm'dir. Tasarımda önemli olan çoğu zaman en kötü durumdur; en büyük mutlak ve bağıl hatayı da raporlayın.
- Modeli eğitim aralığının dışında kullanmak. Ağaç tabanlı bir vekil model, 6 m'yi aşan açıklıklarda sabit bir değer verir (Alıştırma 2). Kullanım aralığını modelle birlikte kaydedin ve dışına çıkan girdileri reddedin.
- Vekil modelin doğruluğunu tasarımın doğruluğu sanmak. Model yalnız formüle ne kadar yakın olduğunu ölçer. Formülün kabulleri (doğrusal elastik malzeme, küçük şekil değiştirme, kayma deformasyonunun ihmali) ayrıca sorgulanmalıdır.
- Çok geniş aralıklı bir hedefi dönüştürmeden öğrenmek. Ham sehim üzerinde eğitilen model büyük kirişlere odaklanır; küçük kirişlerde bağıl hata büyür (Alıştırma 4).
- Bilinen fiziği görmezden gelmek. İlişkinin biçimi biliniyorsa onu özelliklere katmak, veri miktarını artırmaktan çok daha etkilidir; dış değer için ise model biçiminin de fiziğe uyması gerekir (Alıştırma 3).
7. Alıştırmalar
Alıştırma 1KolayEn büyük hata nerede?
Testte en büyük mutlak hataya sahip kirişi bulun (np.argmax(np.abs(y_test - prediction))). Açıklığı, yükü, atalet momenti ve gerçek sehimi nedir? Bu kirişin sehimi eğitim verisindeki sehimlerle nasıl karşılaştırılır?
Çözümü göster
Kiriş: $L$ = 5,923 m, $q$ = 2.221 N/m, $I$ = 4,024×10⁻⁵ m⁴. Analitik sehim 4,2124 mm, tahmin 3,2995 mm; hata −0,9129 mm, yani −%21,7. Eğitim verisindeki en büyük sehim 3,5507 mm'dir: bu kirişin sehimi eğitimde hiç görülmemiş bir değerdir. Açıklığı eğitim örneklerinin %98'inden büyük, atalet momenti %0,5'inden küçüktür; kiriş girdi uzayının en zorlu köşesindedir. Ağaçların ortalaması eğitimde görülen sehimlerin üstüne çıkamadığı için model bu kirişi kaçınılmaz olarak eksik tahmin eder.
Alıştırma 2Orta8 m açıklık
$q$ = 1.500 N/m ve $I$ = 8×10⁻⁵ m⁴ olan bir kiriş için 4, 6, 8 ve 10 m açıklıklarda model tahminini formülle karşılaştırın. 8 m örneği neden ayrı değerlendirilmelidir?
Çözümü göster
| $L$ (m) | Model | Formül |
|---|---|---|
| 4 | 0,2851 | 0,2976 |
| 6 | 1,3544 | 1,5067 |
| 8 | 1,3544 | 4,7619 |
| 10 | 1,3544 | 11,6257 |
Eğitim açıklıkları 2–6 m arasındadır. 8 m bu aralığın dışında kalır. Ağaç modellerinin aralık dışındaki davranışı fiziksel $L^4$ ilişkisini güvenilir biçimde izlemez; aralık içi test hatası bu durumu açıklamaz. Burada model 6 m'nin ötesinde tamamen sabittir: rastgele eşikler eğitimdeki en büyük açıklığı (5,998 m) aşamadığı için 6 m ve ötesi, aynı $q$ ve $I$ için her ağaçta aynı yaprağa düşer. 8 m'de gerçek sehimin üçte birinden azını, 10 m'de sekizde birinden azını tahmin eder. Aralığın kenarında da (6 m) hata %10'u bulur.
Alıştırma 3OrtaFiziği özelliğe katın
Özellikleri $\ln L$, $\ln q$, $\ln I$, hedefi $\ln\delta$ yapıp bir LinearRegression eğitin. Katsayılar ne çıkar? Test hatası ve 8 m tahmini nedir? Sonra Extra Trees'i tek bir özellikle, $z = 4\ln L + \ln q - \ln I$ ile eğitip 8 m'yi tekrar deneyin.
Çözümü göster
from sklearn.linear_model import LinearRegression
lr = LinearRegression().fit(np.log(X_train), np.log(y_train))
tahmin = np.exp(lr.predict(np.log(X_test)))
Katsayılar tam olarak 4, 1 ve −1, kesişim −23,503823 çıkar; bu, $\ln[1000\cdot 5/(384E)]$'nin ta kendisidir. Model formülü yeniden bulmuştur. Test MAE'si 1,02×10⁻¹⁴ mm (bilgisayarınızda biraz farklı çıkabilir), yani yalnız makine yuvarlaması; 8 m tahmini 4,7619 mm, formülle aynı. Doğru model biçimi aralığın dışında da doğrudur.
Extra Trees tek özellik $z$ ile çok daha iyi öğrenir: test MAE'si 0,0022 mm, bağıl hata ortalaması %0,08. Ama 8 m'de yine 3,5507 mm verir: eğitimdeki en büyük sehim. İyi bir özellik aralık içindeki hatayı on kat azalttı, ağacın dış değer sorununu ise çözmedi. Özellik mühendisliği için Ders 04'e bakın.
Alıştırma 4OrtaLogaritma olmadan
TransformedTargetRegressor'ı kaldırıp aynı ExtraTreesRegressor'ı doğrudan sehim üzerinde eğitin. Mutlak ve bağıl hatalar nasıl değişir?
Çözümü göster
Mutlak hatalar neredeyse aynıdır: MAE 0,0208 mm, RMSE 0,0675 mm, en büyük mutlak hata 0,9197 mm. Bağıl hatalar ise kötüleşir: ortalama %5,2 (logaritmayla %4,3), en büyük %46,1 (logaritmayla %38,1). Ham sehimde ağaçlar bölmeleri büyük sehimlerdeki kare hatayı azaltacak biçimde seçer; küçük kirişler ihmal edilir. Hangi hatanın önemli olduğu soruya bağlıdır; sehim sınırı gibi oransal bir kontrolde bağıl hata daha anlamlıdır.
Alıştırma 5ZorDaha fazla veri her şeyi çözer mi?
Modeli eğitim verisinin ilk 160, 320, 640 ve 1.280 örneğiyle eğitin ve her seferinde aynı test verisinde MAE'yi, ortalama bağıl hatayı ve en büyük mutlak hatayı ölçün. Hangi ölçüt veriyle hızla iyileşiyor, hangisi iyileşmiyor? Neden?
Çözümü göster
| Örnek | MAE (mm) | Bağıl hata ort. | En büyük mutlak hata (mm) |
|---|---|---|---|
| 160 | 0,0570 | %11,8 | 1,1412 |
| 320 | 0,0335 | %7,8 | 1,1111 |
| 640 | 0,0264 | %6,0 | 0,9830 |
| 1.280 | 0,0210 | %4,3 | 0,9129 |
Ortalama hatalar veri arttıkça düzenli azalır; en büyük mutlak hata ise sekiz kat veriyle yalnız %20 kadar iyileşir. En kötü durumlar girdi uzayının köşelerindedir ve düzgün rastgele örnekleme oraya çok az nokta koyar: üç değişkenin üçünün de uçta olduğu bölgeler hacmin küçük bir parçasıdır. Çareler: köşe ve kenarları bilerek örneklemek, modelin belirsiz olduğu yerlere yeni analiz eklemek (aktif örnekleme, Ders 15) ya da fiziği model biçimine katmak (Alıştırma 3).
Özet
- Vekil model, pahalı bir hesabı seçilmiş noktalardaki sonuçlarından öğrenen hızlı bir yaklaşımdır; burada kesin cevabı bilinen bir kiriş formülüyle sınandı.
- Logaritmik hedefle Extra Trees test verisinde MAE 0,0210 mm verdi (referans 0,4525 mm), ama tek bir kirişte hata 0,9129 mm ve bağıl hata %38,1'e kadar çıktı.
- Hatalar girdi uzayının köşelerinde toplanır; ağaç modelleri eğitim aralığının dışında sabit kalır ve fiziksel $L^4$ ilişkisini izlemez.
- Bilinen fizik özelliklere katıldığında aralık içi hata belirgin biçimde azalır; dış değer davranışı ise ancak model biçimi de fiziğe uyduğunda (log-uzayda doğrusal model) düzelir.
Sonraki derste denetimsiz öğrenmeye geçiyoruz: Ders 09'da etiketsiz veride grup bulacağız.
Kaynaklar
- scikit-learn — model değerlendirme ve veri sızıntısı.
- scikit-learn — topluluk yöntemleri (Extra Trees) ve işlem zincirleri ve hedef dönüşümü belgeleri.
- P. Geurts, D. Ernst, L. Wehenkel (2006) — Extremely randomized trees, Machine Learning.
- A. I. J. Forrester, A. Sóbester, A. J. Keane — Engineering Design via Surrogate Modelling: A Practical Guide, Wiley, 2008.