Bu derste öğrenecekleriniz
- İç çarpımı izdüşüm olarak, normları hata ölçütleri olarak yorumlamak
- Koşul sayısının çözüm hatasını nasıl büyüttüğünü göstermek;
solve'u ters matrise tercih etmek - Simetrik matrisin özdeğerleriyle pozitif tanımlılığı ve kuadratik formun biçimini ilişkilendirmek
- Gradyanı, zincir kuralını ve Taylor açılımını kullanmak; gradyanı sayısal olarak kontrol etmek
- Kovaryans, korelasyon ve merkezi limit teoremini açıklamak
- Gauss olabilirliğini en büyütmenin MSE'yi en küçültmeye eşdeğer olduğunu türetmek; Bayes teoremini uygulamak
1. Bu derste ne var?
Bir makine öğrenmesi modelini eğitmek, matematiksel olarak üç işin birleşimidir. Model, özellik vektörlerini sayılara dönüştüren bir fonksiyondur; bu doğrusal cebirdir. Modelin parametreleri, bir kayıp fonksiyonunu küçültecek biçimde ayarlanır; bu türev ve optimizasyondur. Kaybın hangi fonksiyon olacağı ve sonucun ne kadar güvenilir olduğu ise olasılık ve istatistiğin konusudur.
Bu derste üçünü, kursun ilerleyen bölümlerinde tam olarak nerede kullanılacaklarını göstererek tekrar edeceğiz. Amaç ispat değil, sezgi ve doğru kullanım. Önemli sonuçların çoğunu h2_matematik.py betiğiyle sayısal olarak sınadık; metindeki sayılar betiğin çıktısından alındı (kod 13. bölümde). Örnekler küçük ve sentetiktir: bir çubuğa etkiyen kuvvet, bir düzlem gerilme tensörü, Abrams yasası, beton küp sonuçları ve bir hasar alarmı.
Nasıl okumalı?
Bölümler bağımsızdır; bildiğinizi atlayın. Ders 02 için en önemlileri 3–5, 7 ve 11. bölümler; Ders 11'deki geri yayılım için 6 ve 8. bölümlerdir.
2. Vektörler: iç çarpım, norm ve uzaklık
Makine öğrenmesinde bir örnek, özelliklerinden oluşan bir vektördür: $\vect x \in \R^p$. Doğrusal bir modelin ağırlıkları da bir vektördür ve tahmin, ikisinin iç çarpımıdır: $\hat y = \vect w^\top \vect x + b$.
$$ \vect a^\top \vect b = \sum_{i=1}^{p} a_i b_i = \lVert \vect a \rVert\,\lVert \vect b \rVert \cos\theta $$Geometrik anlamı mühendislere tanıdıktır: $\vect e$ birim vektörse $\vect F^\top \vect e$, $\vect F$ kuvvetinin $\vect e$ doğrultusundaki bileşenidir. Betikte $\vect F = [3,\ 4]$ kN'luk bir kuvveti, yatayla 30° yapan bir çubuğun ekseni üzerine izdüşürdük: eksenel bileşen 4,598 kN, kuvvetle çubuk arasındaki açı 23,13°. İzdüşüm vektörünün kendisi $(\vect F^\top \vect e)\,\vect e$'dir.
$\cos\theta$, iki vektörün yönce ne kadar benzediğini ölçer ve vektörlerin uzunluğundan bağımsızdır. Yapı dinamiğinde iki mod şeklini karşılaştıran MAC ölçütü, bu kosinüsün karesidir; mod şekillerini Ders 10'da ölçümlerden geri kazanacağız.
Normlar: bir vektörün büyüklüğü
Bir vektörün “ne kadar büyük” olduğunu ölçmenin birden çok yolu vardır:
$$ \lVert \vect x \rVert_2 = \sqrt{\textstyle\sum_i x_i^2} $$ $$ \lVert \vect x \rVert_1 = \textstyle\sum_i |x_i| $$ $$ \lVert \vect x \rVert_\infty = \max_i |x_i| $$Bu üç norm, uygun ölçekle regresyon hata ölçütlerini verir. $\vect r = \vect y - \hat{\vect y}$ artık vektörü için ortalama mutlak hata $\mathrm{MAE} = \lVert \vect r \rVert_1 / n$, karekök ortalama kare hata $\mathrm{RMSE} = \lVert \vect r \rVert_2 / \sqrt n$, en büyük hata ise $\lVert \vect r \rVert_\infty$'dur. Betikteki beş elemanlı artık vektörü $[1{,}5;\ -2;\ 0{,}5;\ 3;\ -1]$ MPa için $L_1 = 8$, $L_2 = 4{,}062$ ve $L_\infty = 3$; buradan MAE = 1,600 MPa, RMSE = 1,817 MPa ve en büyük hata 3 MPa çıkıyor.
Normlar modelin ağırlıklarına da uygulanır. Ders 04'te kayba $\lambda \lVert \vect w \rVert_2^2$ ekleyen Ridge ile $\lambda \lVert \vect w \rVert_1$ ekleyen Lasso'yu göreceğiz. İkisinin davranışı farklıdır: $L_1$ normunun birim “küresi” köşeli bir karodur ve en iyi nokta sık sık bir köşeye, yani bazı ağırlıkların tam sıfır olduğu bir yere düşer.
Uzaklık ve ölçek
İki örnek arasındaki uzaklık, farklarının normudur: $d(\vect a, \vect b) = \lVert \vect a - \vect b \rVert_2$. k-en yakın komşu, kümeleme ve çekirdek yöntemleri buna dayanır. Ama uzaklık, birimlerin seçimine çok duyarlıdır. Betikte üç karışımı [çimento (kg/m³), su/bağlayıcı] ile tanımladık: $\vect a = [350;\ 0{,}45]$, $\vect b = [360;\ 0{,}60]$, $\vect c = [420;\ 0{,}46]$. Ham birimlerle $d(\vect a, \vect b) = 10$ ve $d(\vect a, \vect c) = 70$; $\vect a$'ya en yakın karışım $\vect b$ görünüyor. Oysa $\vect b$'nin su/bağlayıcı oranı çok farklıdır ve dayanımı en çok etkileyen özellik budur. Her sütunu tipik standart sapmasına (72 kg/m³ ve 0,12) bölünce uzaklıklar 1,26 ve 0,98 olur; artık en yakın komşu $\vect c$'dir. Ham uzaklık, sayıları büyük olan sütunun sesini duyar. Ölçeklemenin neden zorunlu olduğunu Ders 06'da ayrıntılı göreceğiz.
3. Matrisler: modeli bütün örneklere uygulamak
$n$ örneği satır satır üst üste koyunca $n \times p$ boyutlu $X$ matrisi oluşur. Doğrusal modelin bütün örneklere uygulanması tek bir matris–vektör çarpımıdır:
$$ \hat{\vect y} = X\vect w $$Tek bir satır için yazınca
$$ \hat y_i = \sum_{j=1}^{p} X_{ij}\, w_j $$olur; yani $\hat y_i$, $X$'in $i$. satırının $\vect w$ ile iç çarpımıdır. Şekiller zinciri $(n, p)\,(p,) \to (n,)$ biçimindedir (Hazırlık 1). Sık kullanacağımız birkaç kural:
- Devrik (transpose): $(AB)^\top = B^\top A^\top$.
- $X^\top X$ matrisi $p \times p$ boyutludur ve simetriktir. Ayrıca her $\vect v$ için $\vect v^\top X^\top X \vect v = \lVert X\vect v \rVert^2 \ge 0$ olduğundan pozitif yarı tanımlıdır. Ders 02'deki normal denklemler $X^\top X\,\vect w = X^\top \vect y$ bu matrisle kurulur.
- $A\vect x = \vect b$ sistemini çözmek için $A^{-1}$ hesaplanmaz.
np.linalg.solvesistemi LU ayrışımıyla çözer; ters matris hesabı yaklaşık üç kat daha pahalıdır ve aşağıda göreceğimiz gibi daha az doğrudur.
Koşul sayısı
Bir doğrusal sistemin girdisindeki küçük bir hata, çözüme ne kadar büyüyerek yansır? Cevabı koşul sayısı verir: $\kappa(A) = \sigma_{\max}/\sigma_{\min}$, yani $A$'nın en büyük ve en küçük tekil değerlerinin oranı. $A(\vect x + \delta\vect x) = \vect b + \delta\vect b$ ise
$$ \frac{\lVert \delta \vect x \rVert}{\lVert \vect x \rVert} \le \kappa(A)\, \frac{\lVert \delta \vect b \rVert}{\lVert \vect b \rVert} $$Bilgisayardaki float64 sayılar yaklaşık 16 anlamlı basamak taşır; bağıl yuvarlama hatası $\varepsilon \approx 2{,}2 \times 10^{-16}$'dır. Kaba kural şudur: koşul sayısı $10^k$ ise çözümün yaklaşık $k$ basamağını kaybedersiniz.
Bunu ünlü bir kötü koşullu matrisle sınadık. Hilbert matrisinin elemanları $H_{ij} = 1/(i+j-1)$'dir. Gerçek çözümü $\vect x = [1, \dots, 1]$ olan $H\vect x = \vect b$ sistemini hem solve hem de ters matrisle çözdük. “Hata” çözümdeki bağıl hatayı, “artık” ise $\lVert H\hat{\vect x} - \vect b \rVert / \lVert \vect b \rVert$'yi gösteriyor:
| $n$ | $\kappa(H)$ | Hata, solve | Hata, inv | Artık, solve | Artık, inv |
|---|---|---|---|---|---|
| 4 | 1,55×10⁴ | 3,4×10⁻¹⁴ | 1,0×10⁻¹² | 0 | 8,2×10⁻¹⁴ |
| 6 | 1,50×10⁷ | 4,1×10⁻¹¹ | 9,7×10⁻¹⁰ | 1,5×10⁻¹⁶ | 8,1×10⁻¹² |
| 8 | 1,53×10¹⁰ | 6,7×10⁻⁸ | 4,8×10⁻⁷ | 1,6×10⁻¹⁶ | 2,7×10⁻⁸ |
| 10 | 1,60×10¹³ | 1,2×10⁻⁵ | 2,4×10⁻³ | 1,6×10⁻¹⁶ | 3,4×10⁻⁵ |
| 12 | 1,62×10¹⁶ | 1,3×10⁻¹ | 2,7 | 1,1×10⁻¹⁶ | 4,6×10⁻² |
Üç sonuç çıkıyor. Birincisi, hata koşul sayısıyla birlikte büyüyor: $n = 12$'de $\kappa \approx 10^{16}$ ve solve'un sonucu bile yüzde 13 yanlış. Hiçbir algoritma, verinin kendisinde olmayan doğruluğu üretemez. İkincisi, solve'un artığı her durumda $10^{-16}$ mertebesinde: çözdüğü sistem, verilene yuvarlama düzeyinde yakın bir sistemdir. Buna geriye doğru kararlılık (backward stability) denir. Üçüncüsü, ters matrisle çözüm hem daha büyük hata hem de çok daha büyük artık veriyor; $n = 10$'da hata 200 kat büyük.
Hilbert matrisi makine öğrenmesinde nereden çıkar?
$[0, 1]$ aralığında düzgün dağılmış bir $x$ için $1, x, x^2, \dots$ kuvvetlerini özellik olarak kullanalım. $(X^\top X)/n$'nin elemanları $\frac1n\sum_k x_k^{i+j}$'dir ve bu ortalama $\int_0^1 x^{i+j}\,dx = 1/(i+j+1)$'e yaklaşır; sıfırdan başlayan indekslerle bu tam olarak Hilbert matrisidir. Betikte 100.000 noktayla $x^0, \dots, x^5$ özelliklerini kurduk: $(X^\top X)/n$ ile $H_6$ arasındaki en büyük bağıl fark 0,0016 ve koşul sayısı 1,49×10⁷. Ham kuvvetlerle yapılan yüksek dereceli polinom regresyonunun sayısal olarak hassas olmasının nedeni budur (Proje 1). Üstelik $\kappa(X^\top X) = \kappa(X)^2$'dir; Ders 02'de normal denklemleri ters matrisle değil lstsq ile çözmemizin bir nedeni de bu.
4. Özdeğerler, kuadratik formlar ve pozitif tanımlılık
Bir kare matrisin özvektörü, matrisle çarpılınca yalnızca boyu değişen vektördür: $A\vect v = \lambda\vect v$. $\lambda$ ilgili özdeğerdir. Makine öğrenmesinde karşılaştığımız matrislerin çoğu simetriktir ($X^\top X$, kovaryans matrisi, Hessyen) ve simetrik matrislerin iki güzel özelliği vardır: özdeğerleri gerçektir ve özvektörleri birbirine diktir. Bu yüzden her simetrik matris dik bir dönüşüm ile köşegen bir matrise ayrışır:
$$ A = Q\,\Lambda\,Q^\top $$Burada $\Lambda$ özdeğerlerden oluşan köşegen matris, $Q$ ise sütunları birim özvektörler olan dik matristir: $Q^\top Q = I$.
Mühendisler bu ayrışımı zaten bilir. Düzlem gerilme tensörü simetriktir; özdeğerleri asal gerilmeler, özvektörleri asal doğrultulardır. Betikte $\sigma_x = 80$, $\sigma_y = 20$, $\tau_{xy} = 30$ MPa için np.linalg.eigh özdeğerleri 7,57 ve 92,43 MPa olarak verdi; büyük asal gerilmenin doğrultusu 22,50°. Mohr dairesiyle aynı sonuç: $\tan 2\theta_p = 2\tau_{xy}/(\sigma_x - \sigma_y) = 1$, yani $\theta_p = 22{,}5°$. Betik ayrıca $Q\Lambda Q^\top = A$ ve $Q^\top Q = I$ eşitliklerini doğruladı. Farklı gerilme durumlarını düzlem gerilme dönüşümü aracında deneyebilirsiniz.
Kuadratik form
$q(\vect x) = \vect x^\top A \vect x$ ifadesine kuadratik form denir. $\vect x$'i özvektörler cinsinden yazınca ($c_i = \vect q_i^\top \vect x$) biçimi açıkça görünür:
$$ \vect x^\top A \vect x = \sum_i \lambda_i\, c_i^2 $$Bütün özdeğerler pozitifse $q$ sıfır dışındaki her $\vect x$ için pozitiftir; matris pozitif tanımlıdır ve $q$'nun grafiği bir çanaktır. Özdeğerler sıfır da olabiliyorsa matris pozitif yarı tanımlıdır. İşaretleri karışıksa matris belirsizdir (indefinite) ve grafik bir eyerdir. Betikteki ikinci matris $B$'de $\sigma_y$'yi $-20$ MPa yaptık; özdeğerler $-28{,}31$ ve $88{,}31$ çıktı.
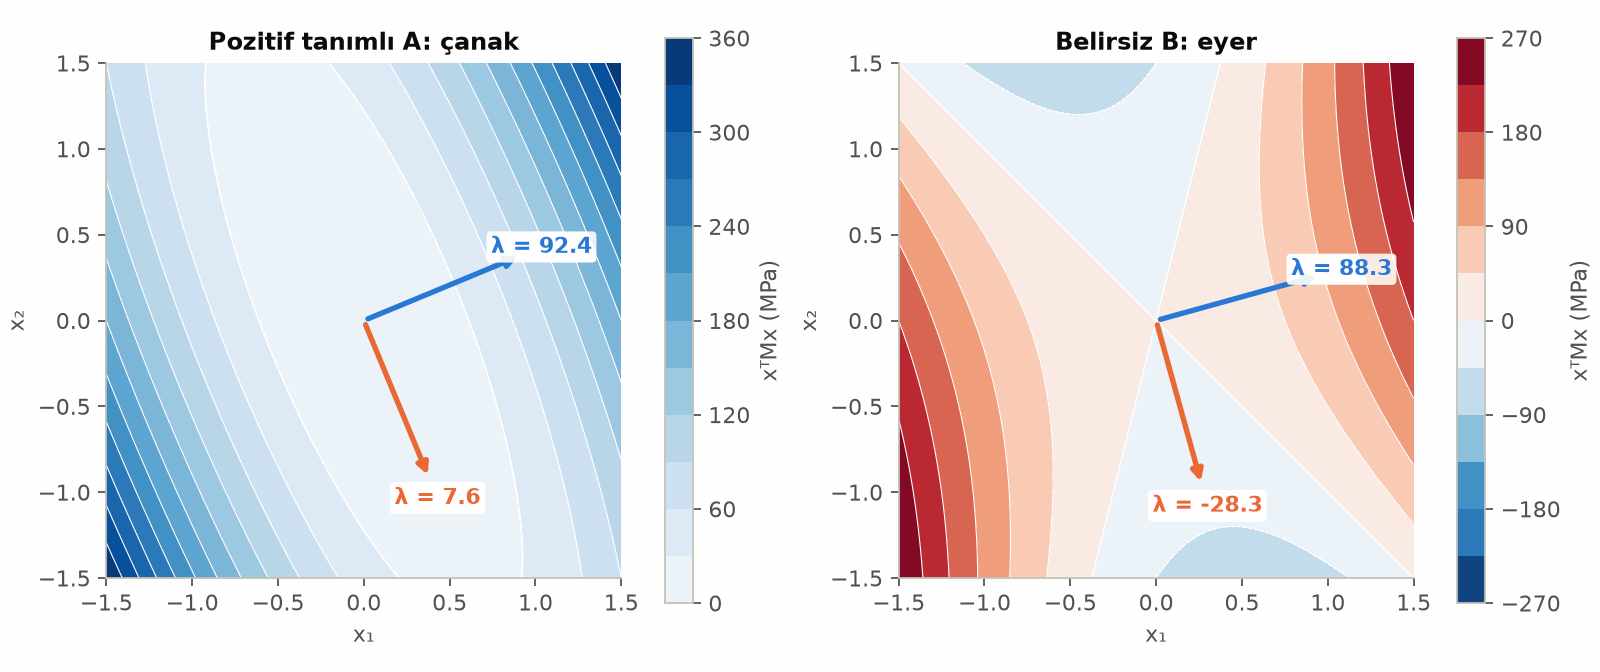
Bu şeklin makine öğrenmesinde üç karşılığı var:
- Kayıp yüzeyi. Doğrusal regresyonda MSE'nin Hessyeni sabittir, $H = \frac{2}{n}X^\top X$, ve kayıp, minimum çevresinde tam olarak böyle bir kuadratik formdur. Kontur elipslerinin eksen boyları $1/\sqrt{\lambda_i}$ ile orantılıdır; uzunluk oranı $\sqrt{\kappa}$'dır. Ders 02'de gördüğümüz uzun vadi, küçük bir $\lambda_{\min}$'in sonucudur; gradyan inişinin kararlılık sınırı ise $2/\lambda_{\max}$'tır.
- Eyer noktaları. Gradyanın sıfır olması minimum için yetmez; Hessyen belirsizse nokta bir eyerdir (sağ panel). Çok parametreli sinir ağlarının kayıp yüzeylerinde bu tür noktalar sık görülür; Ders 11 ve 12'de bunu hatırlayacağız.
- Kovaryans ve PCA. Kovaryans matrisi pozitif yarı tanımlıdır; özvektörleri verinin en çok yayıldığı doğrultulardır. Temel bileşenler analizi tam olarak bu ayrışımdır (Ders 10).
Birim vektör $\vect n$ için $\vect n^\top \sigma\, \vect n$, normali $\vect n$ olan düzlemdeki normal gerilmedir. Bu değer her zaman en küçük ve en büyük özdeğer arasında kalır; asal gerilmelerin “en büyük ve en küçük normal gerilme” olmasının cebirsel ifadesi budur. Benzer biçimde, rijit cisim hareketleri mesnetlerle engellenmiş bir yapının rijitlik matrisi $K$ pozitif tanımlıdır: şekil değiştirme enerjisi $\tfrac12 \vect u^\top K \vect u$ sıfırdan farklı her yer değiştirme için pozitiftir.
Simetrik matris için eigh
Simetrik matrislerde np.linalg.eig yerine np.linalg.eigh kullanın. eigh gerçek ve küçükten büyüğe sıralı özdeğerler ile dik birim özvektörler döndürür; eig ise sıralama garantisi vermez ve yuvarlama yüzünden küçük sanal kısımlar üretebilir. Özvektörün işareti keyfidir: $\vect v$ özvektörse $-\vect v$ de özvektördür.
5. Türev, kısmi türev ve gradyan
Türev, bir fonksiyonun yerel eğimidir:
$$ f'(x) = \lim_{h\to 0} \frac{f(x+h)-f(x)}{h} $$Çok değişkenli bir fonksiyonda her değişkene göre ayrı ayrı alınan türevlere kısmi türev, bunların oluşturduğu vektöre gradyan denir:
$$ \nabla f(\vect w) = \left[ \frac{\partial f}{\partial w_1},\ \dots,\ \frac{\partial f}{\partial w_p} \right]^\top $$Birim vektör $\vect u$ doğrultusundaki yönlü türev, gradyanla iç çarpımdır: $D_{\vect u} f = \nabla f^\top \vect u = \lVert \nabla f \rVert \cos\theta$. Bu ifade $\theta = 0$'da en büyüktür; yani gradyan, fonksiyonun en hızlı arttığı doğrultudur ve o doğrultudaki artış hızı $\lVert \nabla f \rVert$'dir. Gradyana dik doğrultuda değişim sıfırdır: gradyan kontur çizgilerine diktir. Kaybı azaltmak için $-\nabla f$ yönünde adım atmak, gradyan inişinin bütün fikridir.
Betikteki örnek $f(x, y) = x^2 + 3y^2$ ve $(2, 1)$ noktası. Gradyan $[2x,\ 6y] = [4,\ 6]$, büyüklüğü 7,211. Yönlü türev $x$ yönünde 4, gradyan yönünde 7,211, gradyana dik yönde 0 çıkıyor. Bir ayrıntı daha: $-\nabla f$ ile minimuma, yani $(0, 0)$'a giden doğru arasında 29,74° açı var. En dik iniş, minimumu göstermez; uzamış bir çanakta yol bu yüzden zikzak çizer (Ders 02, Şekil 2).
Sık kullanılan gradyanlar
Vektör ve matris ifadelerinin gradyanları birkaç kuralla bulunur ($A$ simetrik):
$$ \nabla_{\vect w}\,(\vect w^\top \vect x) = \vect x $$ $$ \nabla_{\vect w}\,(\vect w^\top A \vect w) = 2A\vect w $$ $$ \nabla_{\vect w}\,\lVert X\vect w - \vect y \rVert^2 = 2X^\top (X\vect w - \vect y) $$Sonuncusu, kareler toplamını açıp ilk iki kuralı uygulayarak bulunur:
$$ \begin{aligned} \lVert X\vect w - \vect y \rVert^2 = {} & \vect w^\top X^\top X \vect w \\ & - 2\vect y^\top X \vect w + \vect y^\top \vect y \end{aligned} $$Ortadaki terim bir sayıdır ve $\vect y^\top X \vect w = \vect w^\top (X^\top \vect y)$ diye yazılabilir; birinci kurala göre gradyanı $X^\top \vect y$'dir. İlk terime ikinci kural ($A = X^\top X$) uygulanır, son terim $\vect w$'ye bağlı değildir. Toplam gradyan $2X^\top X\vect w - 2X^\top \vect y = 2X^\top(X\vect w - \vect y)$ olur. $n$'ye bölünce Ders 02'deki MSE gradyanı $\frac{2}{n}X^\top(X\vect w - \vect y)$ elde edilir. Bu kuralları 8. bölümdeki merkezi fark yöntemiyle kendiniz de kolayca sınayabilirsiniz.
6. Zincir kuralı
Bileşke fonksiyonun türevi, iç içe fonksiyonların türevlerinin çarpımıdır:
$$ \frac{d}{dx}\, f\big(g(x)\big) = f'\big(g(x)\big)\, g'(x) $$Çok değişkenli durumda katkılar toplanır. Kayıp $L$, parametre $w_j$'ye ara değişkenler $z_i$ ve $\hat y_i$ üzerinden bağlıysa:
$$ \frac{\partial L}{\partial w_j} = \sum_{i=1}^{n} \frac{\partial L}{\partial \hat y_i}\, \frac{\partial \hat y_i}{\partial z_i}\, \frac{\partial z_i}{\partial w_j} $$Bunu tek bir yapay nöron üzerinde açalım: $z_i = \vect w^\top \vect x_i + b$, $\hat y_i = \tanh(z_i)$ ve kayıp ortalama kare hata.
Tanh nöronunun gradyanı
Zincirin halkaları tek tek basittir:
- $\partial L/\partial \hat y_i = \frac{2}{n}(\hat y_i - y_i)$, çünkü $L = \frac1n \sum_i (\hat y_i - y_i)^2$.
- $\partial \hat y_i/\partial z_i = 1 - \hat y_i^2$, çünkü $\tanh'(z) = 1 - \tanh^2(z)$.
- $\partial z_i/\partial \vect w = \vect x_i$ ve $\partial z_i/\partial b = 1$.
Çarpıp örnekler üzerinden toplayalım. Kısaltma için $\delta_i = (\hat y_i - y_i)(1 - \hat y_i^2)$ diyelim; bu, $i$. örneğin “hata sinyalidir”:
$$ \nabla_{\vect w} L = \frac{2}{n}\sum_{i=1}^{n} \delta_i\, \vect x_i $$ $$ \frac{\partial L}{\partial b} = \frac{2}{n}\sum_{i=1}^{n} \delta_i $$def gradyan(p): # p = [w1, w2, b]
y_hat = np.tanh(X_n @ p[:2] + p[2])
d = 2 * (y_hat - y_n) / len(y_n) # ∂L/∂ŷ
d = d * (1 - y_hat**2) # ∂ŷ/∂z = 1 − tanh²(z)
return np.append(X_n.T @ d, d.sum()) # ∂z/∂w = x, ∂z/∂b = 1Koddaki sıraya dikkat edin. Önce ileri yönde $z$ ve $\hat y$ hesaplanır ve saklanır. Sonra türevler çıktıdan girdiye doğru, her halkanın yerel türeviyle çarpılarak geriye taşınır. Bu düzenin adı geri yayılımdır (backpropagation). Çok katmanlı bir ağda aynı işlem her katman için tekrarlanır ve bütün gradyan, parametre sayısından bağımsız olarak ileri hesabın küçük bir katı (kabaca 2–3 katı) maliyetle elde edilir. Ders 11'de bunu sıfırdan yazacağız.
7. Taylor açılımı ve dışbükeylik
Yeterince düzgün bir fonksiyon, bir noktanın çevresinde polinomla yaklaşık yazılabilir:
$$ \begin{aligned} f(x_0 + h) = {} & f(x_0) + f'(x_0)\,h \\ & + \tfrac12 f''(x_0)\,h^2 + O(h^3) \end{aligned} $$Örnek olarak Abrams yasasını alalım: 28 günlük dayanım $f(x) = 96{,}5 \cdot 7^{-x}$ MPa, $x$ su/bağlayıcı oranı. $x_0 = 0{,}50$'de $f = 36{,}474$ MPa, $f' = -70{,}974$ MPa ve $f'' = 138{,}110$ MPa (türevler birim su/bağlayıcı oranı başınadır). $x = 0{,}40$'ta gerçek değer 44,309 MPa; birinci dereceden yaklaşım 43,571, ikinci dereceden yaklaşım 44,262 MPa veriyor. $x = 0{,}65$'te sırasıyla 27,240, 25,827 ve 27,381 MPa. Açılım noktasından uzaklaştıkça doğru sapıyor, parabol daha uzun süre yakın kalıyor (aşağıdaki Şekil 2, sol panel).
Bu küçük örnek önemli bir şey söylüyor: doğrusal bir model, gerçek ilişkinin yerel bir doğrusal yaklaşımı gibidir. Tam olarak teğet doğru değildir, çünkü en küçük kareler doğrusu bir aralıktaki bütün noktalara birlikte uydurulur; ama Taylor açılımı gibi dar bir aralıkta iyi çalışır ve aralığın dışında hızla bozulur. Bir modeli eğitildiği aralığın dışında kullanmanın (dış değer, extrapolation) tehlikesi buradan gelir.
Çok değişkenli açılım: optimizasyonun haritası
Çok değişkenli fonksiyonda birinci türevin yerini gradyan, ikinci türevin yerini Hessyen matrisi $H_{jk} = \partial^2 f / \partial w_j \partial w_k$ alır:
$$ \begin{aligned} f(\vect w + \boldsymbol\delta) \approx {} & f(\vect w) + \nabla f^\top \boldsymbol\delta \\ & + \tfrac12\, \boldsymbol\delta^\top H\, \boldsymbol\delta \end{aligned} $$Optimizasyon yöntemlerinin çoğu bu açılımdan okunur:
- Gradyan inişi $\boldsymbol\delta = -\eta\,\nabla f$ adımını atar. Açılıma koyunca kayıptaki değişim $-\eta \lVert \nabla f \rVert^2 + \tfrac12 \eta^2\, \nabla f^\top H \nabla f$ olur. Küçük $\eta$ için birinci terim baskındır ve kayıp azalır. $\nabla f^\top H \nabla f \le \lambda_{\max} \lVert \nabla f \rVert^2$ olduğundan $\eta < 2/\lambda_{\max}$ koşulu azalmayı karesel bir kayıpta garanti eder; Ders 02'deki kararlılık sınırı budur.
- Newton yöntemi karesel yaklaşımın minimumuna doğrudan gider: $H\boldsymbol\delta = -\nabla f$ sistemini çözer. Karesel bir kayıpta tek adımda minimuma ulaşır; ama $p$ parametre için $p \times p$ Hessyeni kurup çözmek gerektiğinden büyük modellerde pahalıdır.
Dışbükeylik
Bir fonksiyonun grafiği üzerindeki herhangi iki noktayı birleştiren doğru parçası grafiğin üstünde kalıyorsa fonksiyon dışbükeydir (convex). İki kez türevlenebilir fonksiyonlarda bu, Hessyenin her yerde pozitif yarı tanımlı olması demektir. Dışbükey bir fonksiyonun her yerel minimumu, genel minimumdur; bu yüzden optimizasyonu güvenlidir. Doğrusal regresyonun MSE'si ($H = \frac2n X^\top X$) ve lojistik regresyonun çapraz entropisi dışbükeydir. Sinir ağlarının kaybı ise dışbükey değildir: birçok yerel minimum ve eyer noktası barındırır. Bu fark, ileri seviyedeki derslerde başlatmanın, öğrenme hızının ve rastgele tohumun neden önem kazandığını açıklar.
8. Sayısal türev ve gradyan kontrolü
Elle türetilen bir gradyanın doğru olup olmadığını nasıl anlarız? Türevi sonlu farklarla yaklaşık hesaplayıp karşılaştırarak. Taylor açılımı iki seçeneğin hatasını da verir:
$$ \begin{aligned} & \frac{f(x+h) - f(x)}{h} \\ & \quad = f'(x) + \tfrac12 f''(x)\,h + O(h^2) \end{aligned} $$ $$ \begin{aligned} & \frac{f(x+h) - f(x-h)}{2h} \\ & \quad = f'(x) + \tfrac16 f'''(x)\,h^2 + O(h^4) \end{aligned} $$İleri farkın kesme hatası $h$ ile, merkezi farkınki $h^2$ ile azalır. Öyleyse $h$'yi olabildiğince küçük seçmek gerekir mi? Hayır. $f(x+h)$ ile $f(x)$ birbirine çok yakın iki sayıdır ve her biri yaklaşık $\varepsilon |f|$ kadar yuvarlama hatası taşır. Farkları $h$'ye bölünce yuvarlama hatası $\varepsilon |f| / h$ olur ve $h$ küçüldükçe büyür. Toplam hata iki terimin toplamıdır:
$$ E_{\text{ileri}}(h) \approx \tfrac12 |f''|\,h + \frac{\varepsilon |f|}{h} $$ $$ E_{\text{merkezi}}(h) \approx \tfrac16 |f'''|\,h^2 + \frac{\varepsilon |f|}{h} $$Betik, Abrams fonksiyonunun $x = 0{,}50$'deki türevini $10^{-16}$ ile $10^{-1}$ arasındaki adımlarla hesapladı. $h$'yi $10^{-2}$'den $10^{-4}$'e indirmek ileri farkın bağıl hatasını $9{,}7\times10^{-3}$'ten $9{,}7\times10^{-5}$'e (100 kat), merkezi farkınkini $6{,}3\times10^{-5}$'ten $6{,}3\times10^{-9}$'a (10.000 kat) indiriyor. En küçük hatalar ileri farkta $h \approx 6\times10^{-9}$ için $1{,}3\times10^{-9}$, merkezi farkta $h \approx 10^{-6}$ için $2{,}1\times10^{-12}$. $h = 10^{-12}$'de ise iki yöntemin hatası da $2{,}6\times10^{-5}$'e çıkıyor: daha küçük adım, daha kötü türev.
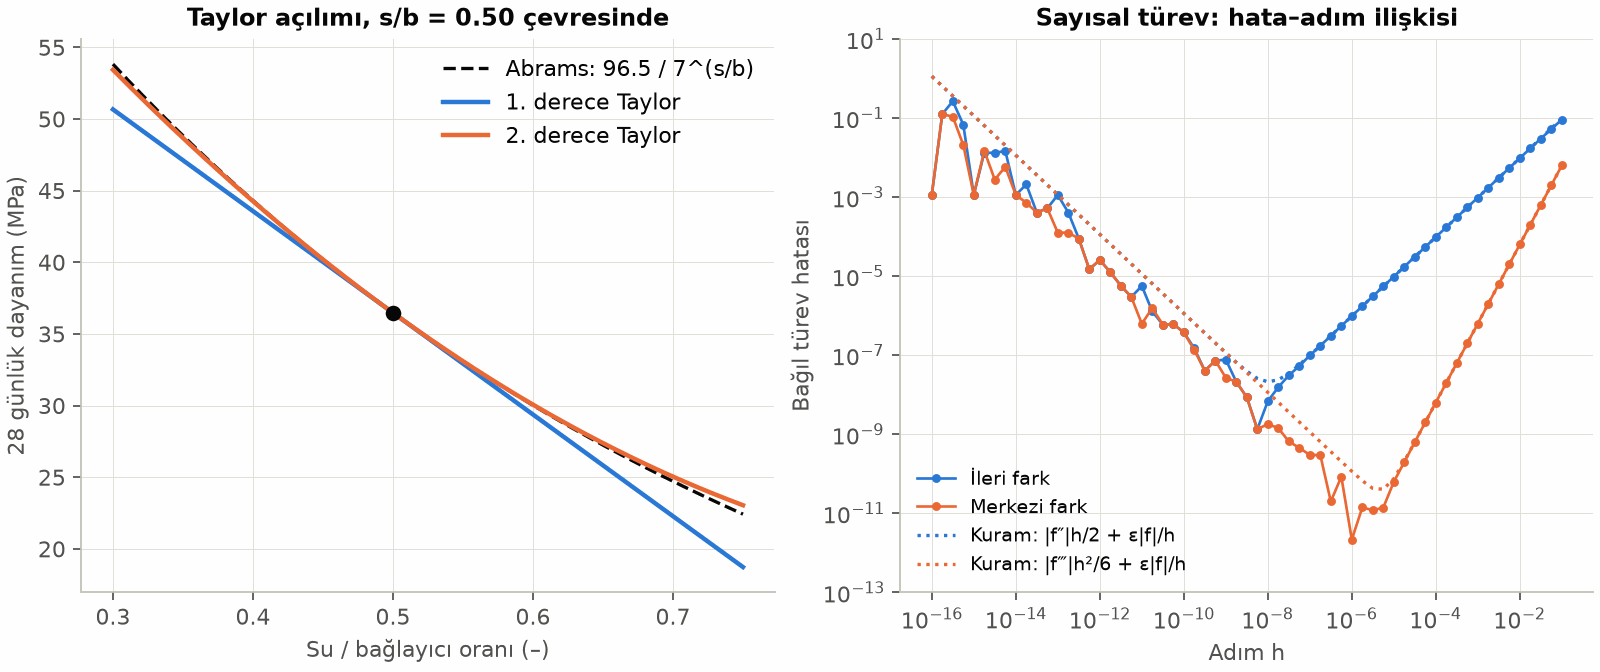
Pratik kural: merkezi farkla, parametrenin ölçeğine göre $h \approx 10^{-5}$–$10^{-6}$ seçin. Çok parametreli bir modelde gradyan kontrolü her parametre için iki fonksiyon hesabı ister; bu yüzden eğitimde değil, yalnız doğrulamada kullanılır. Karşılaştırma için bağıl hata kullanılır:
$$ \text{bağıl hata} = \frac{\lVert \vect g_{\text{analitik}} - \vect g_{\text{sayısal}} \rVert}{\lVert \vect g_{\text{analitik}} \rVert + \lVert \vect g_{\text{sayısal}} \rVert} $$Betikte tanh nöronunun gradyanı için bağıl hata $7{,}0\times10^{-11}$ çıktı. Zincirdeki $(1 - \hat y^2)$ çarpanını bilerek unuttuğumuzda hata $4{,}0\times10^{-1}$'e çıktı. Kaba bir kural olarak $10^{-7}$'nin altı güven verir, $10^{-3}$'ün üstü neredeyse kesin bir türetme ya da kodlama hatasıdır.
9. Ortalama, varyans, kovaryans ve korelasyon
$n$ gözlemli bir örneklem için temel tanımlar:
$$ \bar x = \frac1n \sum_{i=1}^n x_i $$ $$ s^2 = \frac{1}{n-1} \sum_{i=1}^n (x_i - \bar x)^2 $$ $$ s_{xy} = \frac{1}{n-1} \sum_{i=1}^n (x_i - \bar x)(y_i - \bar y) $$ $$ r_{xy} = \frac{s_{xy}}{s_x\, s_y} $$Kovaryans $s_{xy}$ birimlidir ve iki değişkenin birlikte değişme eğilimini gösterir. Korelasyon katsayısı $r_{xy}$ birimsizdir ve $-1$ ile $1$ arasında kalır. $p$ sütunlu, ortalaması çıkarılmış bir $X_c$ matrisi için bütün kovaryanslar tek bir matriste toplanır: $\Sigma = X_c^\top X_c/(n-1)$. Bu matris de bir Gram matrisidir; dolayısıyla pozitif yarı tanımlıdır.
Betikte 500 sentetik karışım ürettik: su/bağlayıcı oranı 0,35–0,65 arasında düzgün, dayanım Abrams yasası ile yüzde 7'lik log-normal bir çarpanın çarpımı, ortam sıcaklığı ise dayanımdan bağımsız. Dayanımın ortalaması 36,04 MPa; varyansı $n$ paydasıyla 43,41, $n-1$ paydasıyla 43,49 MPa². $n = 500$'de fark önemsiz, küçük örneklemde önemlidir (11. bölüm). Su/bağlayıcı ile dayanımın kovaryansı $-0{,}534$ MPa, korelasyon matrisi:
| s/b | Dayanım | Sıcaklık | |
|---|---|---|---|
| s/b | 1 | −0,92 | −0,04 |
| Dayanım | −0,92 | 1 | 0,03 |
| Sıcaklık | −0,04 | 0,03 | 1 |
Güçlü negatif ilişki beklendiği gibi; sıcaklıkla korelasyonlar sıfır değil, ama örneklem gürültüsü mertebesinde. İki uyarı:
- Korelasyon yalnız doğrusal ilişkiyi ölçer. $u$, $-1$ ile $1$ arasında düzgün dağılmışken $v = u^2$ tamamen $u$'ya bağlıdır; ama betikte korelasyonları 0,018 çıktı. Sıfıra yakın korelasyon “ilişki yok” demek değildir.
- Korelasyon nedensellik değildir. Burada nedensellik veriyi biz ürettiğimiz için biliniyor. Gerçek veride iki değişken, üçüncü bir ortak nedenden dolayı da birlikte değişebilir.
Paydalar kütüphaneye göre değişir
NumPy'ın var/std fonksiyonları ve scikit-learn'ün StandardScaler'ı $n$'ye böler; pandas'ın var/std yöntemleri ve np.cov ise $n-1$'e. İstediğiniz paydayı ddof parametresiyle açıkça seçin.
10. Normal dağılım ve merkezi limit teoremi
Normal (Gauss) dağılımın olasılık yoğunluğu
$$ p(x) = \frac{1}{\sigma\sqrt{2\pi}} \exp\!\left( -\frac{(x-\mu)^2}{2\sigma^2} \right) $$biçimindedir. Değerlerin yaklaşık yüzde 68,3'ü $\mu \pm \sigma$, yüzde 95,4'ü $\mu \pm 2\sigma$, yüzde 99,7'si $\mu \pm 3\sigma$ aralığındadır. Standart değişken $z = (x-\mu)/\sigma$ için $|z| < 1{,}96$ olasılığı yüzde 95'tir. Ders 02'deki yüzde 95 güven aralığı da bu fikre dayanır; orada gürültünün standart sapması artıklardan tahmin edildiği için 1,96 yerine t-dağılımının katsayısı kullanılır (80 ölçüm ve 78 serbestlik derecesiyle yaklaşık 1,99). Mühendisler bir başka sayıyı tanır: $\mu - 1{,}645\sigma$ alt yüzde 5'lik değerdir. Eurocode'larda malzemenin karakteristik değeri genellikle bu yüzde 5'lik alt değer olarak tanımlanır.
Normal dağılım neden bu kadar sık karşımıza çıkar? Cevap merkezi limit teoremidir: sonlu varyanslı, bağımsız ve aynı dağılımlı $k$ değişkenin ortalaması, $k$ büyüdükçe, değişkenlerin kendi dağılımı ne olursa olsun normal dağılıma yaklaşır; standart sapması $\sigma/\sqrt k$'dir. Bir ölçüm hatası birçok küçük ve bağımsız etkinin toplamıysa yaklaşık normaldir.
Betikte 0 ile 1 arasında düzgün dağılmış $k$ sayının ortalamasını 100.000 kez hesapladık. Düzgün dağılımın standart sapması $1/\sqrt{12}$ ve basıklık fazlası (excess kurtosis) $-1{,}2$'dir; $k$ sayının ortalaması için kuram bunları $1/\sqrt{12k}$ ve $-1{,}2/k$ olarak öngörür. Normal dağılımın basıklık fazlası sıfırdır.
| $k$ | Std (benzetim) | Std (kuram) | Basıklık fazlası | Kuram | $|z| < 1{,}96$ oranı |
|---|---|---|---|---|---|
| 1 | 0,2888 | 0,2887 | −1,202 | −1,200 | 1,000 |
| 2 | 0,2033 | 0,2041 | −0,590 | −0,600 | 0,961 |
| 5 | 0,1287 | 0,1291 | −0,251 | −0,240 | 0,953 |
| 30 | 0,0526 | 0,0527 | −0,048 | −0,040 | 0,951 |
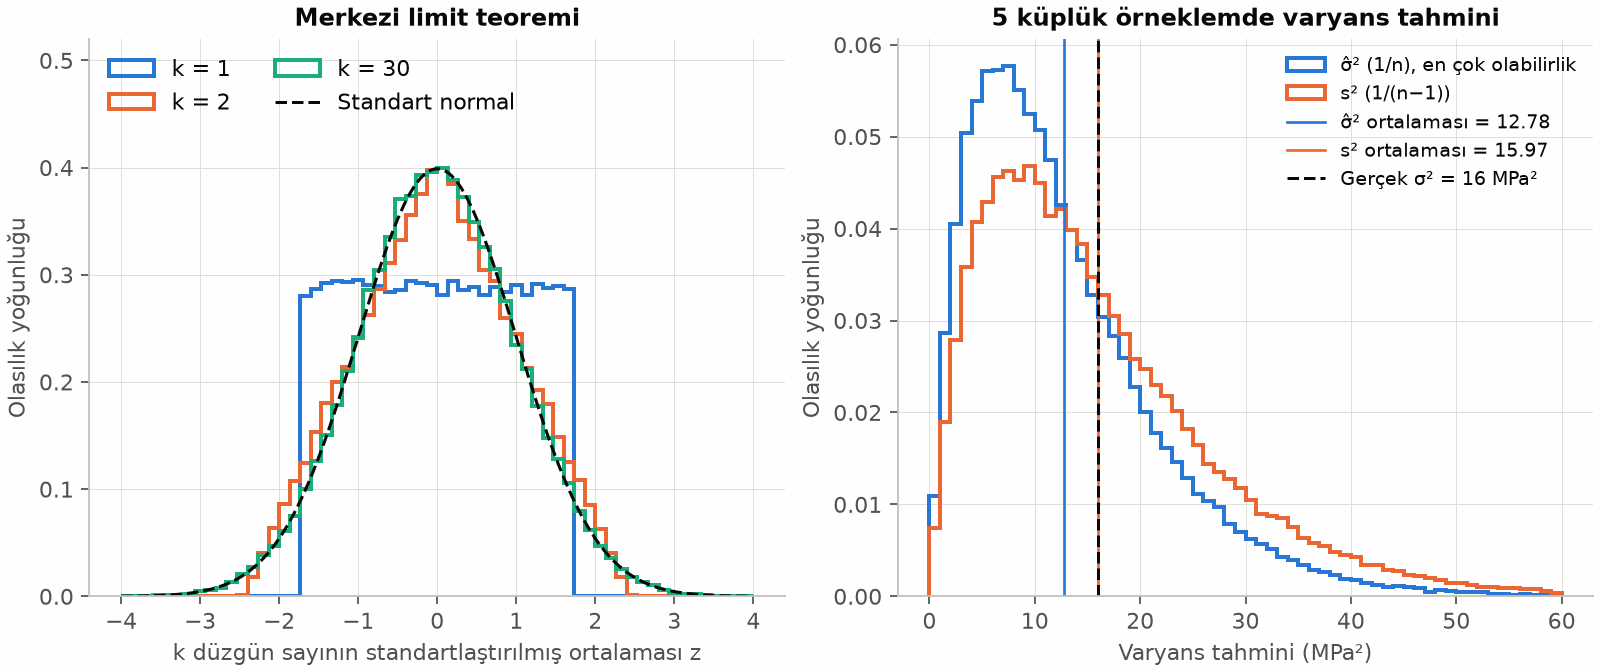
Tek bir düzgün sayının kuyruğu yoktur: bütün değerler $\pm 1{,}73$ standart sapma içinde kalır, oran 1,000. İki sayının ortalaması üçgen biçimli bir dağılımdır; beş sayıda dağılım çan eğrisine çok benzer; otuzda basıklık fazlası sıfıra iner ve $|z| < 1{,}96$ oranı 0,951 ile normal dağılımın 0,95'ine oturur (Şekil 3, sol panel).
Teorem, ortalamalar ve toplamlar hakkındadır; her büyüklüğün normal olduğunu söylemez. Bizim üretecimizde dayanım saçılması log-normaldir; malzeme dayanımlarında, yük uç değerlerinde ve hasar sürelerinde başka dağılımlar daha uygundur. Makine öğrenmesinde teoremi en sık şu üç yerde kullanırız: gürültüyü normal varsaymak (11. bölüm), mini yığın gradyanlarının ortalamasını yorumlamak (Ders 12) ve tahminlerin ortalamasını almak (torbalama, Ders 08).
11. Olabilirlik ve en çok olabilirlik tahmini
Elimizde $x_1, \dots, x_n$ verisi ve parametresi $\theta$ olan bir olasılık modeli $p(x\,|\,\theta)$ olsun. Veri sabit tutulup $\theta$'nın fonksiyonu olarak görülen ortak olasılığa olabilirlik (likelihood) denir. Gözlemler bağımsızsa çarpım biçimindedir. Çok sayıda küçük olasılığın çarpımı bilgisayarda sıfıra yuvarlanabileceği (alttan taşma, underflow) için logaritması, yani bir toplam kullanılır:
$$ \mathcal L(\theta) = \prod_{i=1}^{n} p(x_i\,|\,\theta) $$ $$ \ell(\theta) = \log \mathcal L(\theta) = \sum_{i=1}^{n} \log p(x_i\,|\,\theta) $$En çok olabilirlik tahmini (maximum likelihood estimation, MLE), gözlenen veriyi en olası kılan parametredir: $\hat\theta = \argmax_\theta\, \ell(\theta)$. Optimizasyon kütüphaneleri küçültme yaptığı için pratikte eksi log-olabilirlik küçültülür.
Normal dağılımın μ ve σ² tahminleri
Normal model için log-olabilirlik:
$$ \begin{aligned} \ell(\mu, \sigma^2) = {} & -\frac{n}{2}\log(2\pi\sigma^2) \\ & - \frac{1}{2\sigma^2}\sum_{i=1}^{n}(x_i-\mu)^2 \end{aligned} $$$\mu$'ye göre türevi sıfıra eşitleyince $\sum_i (x_i - \mu) = 0$, yani $\hat\mu = \bar x$ bulunur. $S = \sum_i (x_i - \mu)^2$ kısaltmasıyla $\sigma^2$'ye göre türev:
$$ \frac{\partial \ell}{\partial \sigma^2} = -\frac{n}{2\sigma^2} + \frac{S}{2\sigma^4} = 0 $$Buradan $\sigma^2 = S/n$ çıkar; $\mu$ yerine tahmini $\bar x$ konunca $\hat\sigma^2 = \frac1n \sum_i (x_i - \bar x)^2$ olur. Payda $n$'dir, $n-1$ değil. $\sum_i (x_i - \bar x)^2$'nin beklenen değeri $(n-1)\sigma^2$ olduğundan $\mathbb{E}[\hat\sigma^2] = \frac{n-1}{n}\sigma^2$'dir; tahmin ortalamada küçük kalır, yani yanlıdır. Ortalamayı veriden tahmin ettiğimiz için bir serbestlik derecesi harcarız. $n-1$ paydalı $s^2$ ise yansızdır.
Betikte gerçek değerleri $\mu = 38$ MPa ve $\sigma = 4$ MPa olan 10 küplük bir örneklem çektik: $\hat\mu = 36{,}35$ MPa, $\hat\sigma = 2{,}82$ MPa ve $s = 2{,}98$ MPa. On küpte ikisi de gerçek değerden uzak; küçük örneklemde tek bir tahminin saçılması, paydalar arasındaki farktan büyüktür. Yanlılık ancak tekrarlarda görünür: 5 küplük örneklemi 100.000 kez çektiğimizde $\hat\sigma^2$'nin ortalaması 12,78 MPa² oldu, yani $0{,}799\,\sigma^2$ (kuram $4/5 = 0{,}8$). $s^2$'nin ortalaması ise 15,97 MPa², gerçek değer 16'ya çok yakın (Şekil 3, sağ panel).
Gauss gürültüsü ve MSE
Şimdi regresyona dönelim. Ölçümün, modelin tahmini artı normal dağılımlı bir gürültü olduğunu varsayalım: $y_i = f(\vect x_i; \vect w) + \epsilon_i$, $\epsilon_i \sim \mathcal N(0, \sigma^2)$, gürültüler bağımsız. O zaman her $y_i$, ortalaması $f(\vect x_i; \vect w)$ olan bir normal dağılımdan gelir.
Gauss olabilirliğini en büyütmek = MSE'yi en küçültmek
Artıkları $r_i = y_i - f(\vect x_i;\vect w)$ ile gösterelim. Eksi log-olabilirlik, yukarıdaki ifadede $x_i - \mu$ yerine $r_i$ yazılarak bulunur:
$$ \begin{aligned} -\ell(\vect w, \sigma^2) &= \frac{n}{2}\log(2\pi\sigma^2) \\ &\quad + \frac{1}{2\sigma^2}\sum_{i=1}^{n} r_i^2 \end{aligned} $$Birinci terim $\vect w$'ye bağlı değildir. İkinci terimde $\vect w$ yalnız $r_i$'ler üzerinden, yani artıkların kareler toplamında görünür ve $1/(2\sigma^2)$ pozitif bir sabittir. Dolayısıyla $\sigma^2$ ne olursa olsun, $-\ell$'yi en küçük yapan $\vect w$, kareler toplamını en küçük yapan $\vect w$'dir:
$$ \begin{aligned} \hat{\vect w}_{\text{MLE}} &= \argmin_{\vect w} \sum_{i=1}^{n} r_i^2 \\ &= \argmin_{\vect w}\, \mathrm{MSE}(\vect w) \end{aligned} $$Ardından $\sigma^2$'ye göre türev, normal örneklemdekiyle aynı biçimde $\hat\sigma^2 = \mathrm{MSE}(\hat{\vect w})$ verir: gürültü varyansının en çok olabilirlik tahmini, artıkların ortalama karesidir.
Betik bu eşdeğerliği sayısal olarak da sınadı. Ders 02'dekine benzer 40 noktalı bir gerinim–gerilme verisi ($E = 200$ GPa, $b = 2$ MPa, gürültü 3 MPa) için en küçük kareler $E = 198{,}033$ GPa, $b = 3{,}276$ MPa ve $\sqrt{\mathrm{MSE}} = 3{,}076$ MPa verdi. Eksi log-olabilirliği SciPy'nin BFGS yöntemiyle $(E, b, \log\sigma)$ üzerinden küçülttüğümüzde aynı üç sayıyı bulduk.
Bu bakış, kayıp fonksiyonu seçmenin genel tarifini verir: önce gürültünün (ya da gözlemin) olasılık modelini seçin, eksi log-olabilirliği kayıp olarak kullanın. Gürültü Laplace dağılımlıysa, yani kuyrukları normalden kalınsa, eksi log-olabilirlik $\sum_i |y_i - f(\vect x_i;\vect w)|$ ile orantılıdır ve MAE'yi küçültmek doğru seçimdir. Hedef 0/1 ise Bernoulli modeli çapraz entropi kaybını verir (Ders 05).
12. Bayes teoremi: taban oranını unutmayın
Bir yapı sağlığı izleme sisteminin hasar alarmı verdiğini düşünün. Sistemin özellikleri şöyle: hasarlı bir yapıda yüzde 95 olasılıkla alarm verir (duyarlılık), sağlam bir yapıda yüzde 5 olasılıkla yanlış alarm verir. İzlenen yapıların yüzde 2'si hasarlıdır (ön olasılık). Alarm geldiğinde yapının gerçekten hasarlı olma olasılığı nedir? Sezgimiz “yüzde 95 civarı” der. Cevabı Bayes teoremi verir:
$$ P(H \mid A) = \frac{P(A \mid H)\, P(H)}{P(A)} $$ $$ \begin{aligned} P(A) = {} & P(A \mid H)\,P(H) \\ & + P(A \mid \neg H)\,P(\neg H) \end{aligned} $$Sayılarla:
$$ \begin{aligned} P(H \mid A) &= \frac{0{,}95 \cdot 0{,}02}{0{,}95 \cdot 0{,}02 + 0{,}05 \cdot 0{,}98} \\ &= 0{,}2794 \end{aligned} $$Alarm gelen yapıların yalnız yüzde 27,9'u hasarlıdır. Doğal sıklıklarla düşünmek sonucu sezgisel kılar:
| Durum | Yapı sayısı | Alarm | Alarm yok |
|---|---|---|---|
| Hasarlı (yüzde 2) | 200 | 190 | 10 |
| Sağlam (yüzde 98) | 9.800 | 490 | 9.310 |
| Toplam | 10.000 | 680 | 9.320 |
680 alarmın 190'ı doğrudur: $190/680 = 0{,}2794$. Hasar nadir olduğu için, küçük bir yanlış alarm oranı bile çok sayıda sağlam yapıya uygulanınca doğru alarmları sayıca geçer. Bu hataya taban oranı yanılgısı (base-rate fallacy) denir.
Sonsal olasılık, yeni bilgi geldikçe bir sonraki adımın ön olasılığı olur. Aynı yapıdan, hasar durumu bilindiğinde ilkinden bağımsız ikinci bir alarm gelirse olasılık 0,2794'ten 0,8805'e çıkar. “Bağımsız” varsayımı önemlidir: aynı sensörün aynı nedenle iki kez alarm vermesi yeni bilgi taşımaz.
Bu tablo, Ders 05'teki karışıklık matrisinin ta kendisidir. Alarm gelenler içindeki doğru oran, sınıflandırmada kesinlik (precision) adını alır; duyarlılık ise duyarlılık (recall) olarak kalır. Dengesiz sınıflarda kesinliğin neden düşük çıktığını şimdiden biliyorsunuz. Bayesçi düşünce kursun ileri bölümlerinde de karşımıza çıkacak: Ridge düzenlileştirmesi ağırlıklar üzerine normal bir ön dağılım koymaya karşılık gelir ve Ders 15'teki Gauss süreçleri bütünüyle Bayesçi bir modeldir.
13. Çalıştırılabilir kod
Betik yedi bölümden oluşur: vektörler, matrisler (Hilbert ve özdeğer), gradyan ve zincir kuralı, Taylor ve sayısal türev, istatistik ve merkezi limit teoremi, en çok olabilirlik ve Bayes. Sekizinci bölüm üç grafiği çizer. Kurulum için Ders 01'deki adımları izleyin.
"""Hazırlık 2 — Makine öğrenmesi için matematik.

Kursun geri kalanında kullanılan matematiği küçük sayısal deneylerle doğrular: iç çarpım,
normlar ve uzaklık; matris–vektör çarpımı, koşul sayısı (Hilbert matrisi), özdeğerler ve
kuadratik formlar; gradyan, zincir kuralı ve gradyan kontrolü; Taylor açılımı ve sayısal
türevin hata–adım ilişkisi; varyans, korelasyon, merkezi limit teoremi; en çok olabilirlik
(Gauss olabilirliği ile MSE'nin eşdeğerliği) ve Bayes teoremi.

Veri sentetiktir: bütün örnekler sabit tohumlu rastgele sayılarla ya da elle seçilmiş
değerlerle üretilir (Abrams yasası, düzlem gerilme tensörü, çekme deneyi doğrusu gibi).
Gerçek deney kaydı değildir.

Çalıştır:  python h2_matematik.py
Gerekenler: numpy, scipy, matplotlib  (Python 3.12+)
Süre:      birkaç saniye
Çıktılar:  terminale sayılar, aynı klasöre üç PNG grafiği
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from scipy import optimize, stats

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent
rng = np.random.default_rng(42)

# %% 1. Vektörler: iç çarpım, norm ve uzaklık
F = np.array([3.0, 4.0])                                    # kuvvet (kN)
e = np.array([np.cos(np.radians(30)), np.sin(np.radians(30))])  # çubuk ekseni (birim vektör)
eksenel = F @ e                                             # iç çarpım = eksen üzerindeki bileşen
aci = np.degrees(np.arccos(eksenel / (np.linalg.norm(F) * np.linalg.norm(e))))
r = np.array([1.5, -2.0, 0.5, 3.0, -1.0])                   # bir modelin artıkları (MPa)
L1, L2, Linf = np.linalg.norm(r, 1), np.linalg.norm(r), np.linalg.norm(r, np.inf)
n_r = len(r)
print("=== 1. Vektörler ===")
print(f"F = {F} kN, e = {e.round(3)} → F·e = {eksenel:.3f} kN, aradaki açı {aci:.2f}°")
print(f"r = {r} MPa: L1 = {L1:.2f}, L2 = {L2:.3f}, L∞ = {Linf:.2f}")
print(f"MAE = L1/n = {L1 / n_r:.3f}, RMSE = L2/√n = {L2 / np.sqrt(n_r):.3f}, en büyük hata = L∞ = {Linf:.3f} MPa")
assert np.isclose(L2 / np.sqrt(n_r), np.sqrt(np.mean(r**2))) and np.isclose(L1 / n_r, np.mean(np.abs(r)))
# Uzaklık ve ölçek: [çimento (kg/m³), su/bağlayıcı]
a, b, c = np.array([350.0, 0.45]), np.array([360.0, 0.60]), np.array([420.0, 0.46])
olcek = np.array([72.0, 0.12])                              # tablodaki tipik standart sapmalar
for ad, bol in [("ham birim", 1.0), ("standart sapmaya bölünmüş", olcek)]:
    dab, dac = np.linalg.norm((a - b) / bol), np.linalg.norm((a - c) / bol)
    print(f"Uzaklık ({ad}): d(a, b) = {dab:.2f}, d(a, c) = {dac:.2f} → a'ya en yakın: {'b' if dab < dac else 'c'}")

# %% 2. Matrisler: koşul sayısı ve özdeğerler
print("\n=== 2. Matrisler, koşul sayısı, özdeğerler ===")
print("Hilbert sistemi H x = b, gerçek çözüm x = [1, …, 1]:")
print("   n     κ(H)    hata (solve)  hata (inv)  artık (solve)  artık (inv)")
hilbert_tablo = []
for n in [4, 6, 8, 10, 12]:
    i = np.arange(n)
    H = 1.0 / (i[:, None] + i[None, :] + 1)                 # yayınlama ile Hilbert matrisi
    x_gercek = np.ones(n)
    b_h = H @ x_gercek
    x_solve = np.linalg.solve(H, b_h)
    x_inv = np.linalg.inv(H) @ b_h
    hata = [np.linalg.norm(x - x_gercek) / np.linalg.norm(x_gercek) for x in (x_solve, x_inv)]
    artik = [np.linalg.norm(H @ x - b_h) / np.linalg.norm(b_h) for x in (x_solve, x_inv)]
    kappa = np.linalg.cond(H)
    hilbert_tablo.append((n, kappa, *hata))
    print(f"  {n:2d}  {kappa:9.2e}  {hata[0]:10.1e}  {hata[1]:10.1e}  {artik[0]:12.1e}  {artik[1]:11.1e}")
# Monom özelliklerin Gram matrisi Hilbert matrisine yaklaşır: (1/n)Σ x^(i+j) ≈ ∫ x^(i+j) dx = 1/(i+j+1)
x_u = rng.uniform(0.0, 1.0, 100_000)
V = np.vander(x_u, 6, increasing=True)                      # sütunlar: 1, x, x², …, x⁵
G = V.T @ V / len(x_u)
i = np.arange(6)
H6 = 1.0 / (i[:, None] + i[None, :] + 1)
print(f"Özellikler 1, x, …, x⁵ (x ~ U(0, 1)): (XᵀX)/n ile H₆ en büyük bağıl fark "
      f"{np.max(np.abs(G - H6) / H6):.4f}; κ = {np.linalg.cond(G):.2e}")
A = np.array([[80.0, 30.0], [30.0, 20.0]])                  # düzlem gerilme tensörü (MPa)
lam, Q = np.linalg.eigh(A)                                  # simetrik matris: eigh
Q = Q * np.sign(Q[0])                                       # yön işaretini sabitle (keyfi)
yon = np.degrees(np.arctan2(Q[1, 1], Q[0, 1]))              # büyük özdeğerin özvektörü
print(f"A = [[80, 30], [30, 20]] MPa → özdeğerler (asal gerilmeler) {lam.round(2)} MPa, "
      f"büyük asal yön {yon:.2f}°")
B = np.array([[80.0, 30.0], [30.0, -20.0]])                 # σy = −20 MPa: belirsiz matris
lamB, QB = np.linalg.eigh(B)
QB = QB * np.sign(QB[0])
print(f"Q Λ Qᵀ = A: {np.allclose(Q @ np.diag(lam) @ Q.T, A)}, QᵀQ = I: {np.allclose(Q.T @ Q, np.eye(2))}; "
      f"B = [[80, 30], [30, −20]] → özdeğerler {lamB.round(2)}")
assert np.all(lam > 0) and lamB[0] < 0 < lamB[1]

# %% 3. Gradyan, yönlü türev, zincir kuralı ve gradyan kontrolü
nokta = np.array([2.0, 1.0])
grad_f = np.array([2 * nokta[0], 6 * nokta[1]])             # f(x, y) = x² + 3y² → ∇f = [2x, 6y]
u_grad = grad_f / np.linalg.norm(grad_f)
u_dik = np.array([-u_grad[1], u_grad[0]])
min_yon = -nokta / np.linalg.norm(nokta)                    # (2, 1)'den minimuma (0, 0) giden yön
aci_gd = np.degrees(np.arccos((-u_grad) @ min_yon))
print("\n=== 3. Gradyan ve zincir kuralı ===")
print(f"f = x² + 3y², (2, 1) noktasında ∇f = {grad_f}, |∇f| = {np.linalg.norm(grad_f):.3f}")
print(f"Yönlü türev: x yönü {grad_f @ [1, 0]:.3f}, ∇f yönü {grad_f @ u_grad:.3f}, dik yön {abs(grad_f @ u_dik):.3f}; "
      f"−∇f ile minimum yönü arası {aci_gd:.2f}°")

# Tek nöron: ŷ = tanh(X w + b), L = ortalama (ŷ − y)²
X_n = rng.normal(size=(20, 2))
y_n = np.tanh(X_n @ np.array([0.8, -0.5]) + 0.1) + rng.normal(0, 0.05, 20)


def kayip(p):
    return np.mean((np.tanh(X_n @ p[:2] + p[2]) - y_n) ** 2)


def gradyan(p, hatali=False):
    y_hat = np.tanh(X_n @ p[:2] + p[2])
    d = 2 * (y_hat - y_n) / len(y_n)                         # ∂L/∂ŷ
    if not hatali:
        d = d * (1 - y_hat**2)                               # ∂ŷ/∂z = 1 − tanh²(z): zincir kuralı
    return np.append(X_n.T @ d, d.sum())                     # ∂z/∂w = x, ∂z/∂b = 1


def sayisal_gradyan(fonk, p, h=1e-6):
    g = np.zeros_like(p)
    for k in range(len(p)):
        adim = np.zeros_like(p)
        adim[k] = h
        g[k] = (fonk(p + adim) - fonk(p - adim)) / (2 * h)  # merkezi fark
    return g


def bagil_hata(g1, g2):
    return np.linalg.norm(g1 - g2) / (np.linalg.norm(g1) + np.linalg.norm(g2))


p0 = np.array([1.0, 1.0, 0.5])
g_sayisal = sayisal_gradyan(kayip, p0)
h_dogru, h_hatali = bagil_hata(gradyan(p0), g_sayisal), bagil_hata(gradyan(p0, hatali=True), g_sayisal)
print(f"Gradyan kontrolü (tanh nöronu, h = 1e-6): bağıl hata {h_dogru:.1e}; "
      f"(1 − ŷ²) unutulursa {h_hatali:.1e}")
assert h_dogru < 1e-7 < 1e-3 < h_hatali

# %% 4. Taylor açılımı ve sayısal türevin hata–adım ilişkisi
LN7 = np.log(7.0)


def abrams(x):
    return 96.5 * 7.0 ** (-x)                                # 28 günlük dayanım (MPa), x = s/b


x0 = 0.50
f0, f1, f2, f3 = abrams(x0), -LN7 * abrams(x0), LN7**2 * abrams(x0), -(LN7**3) * abrams(x0)
print("\n=== 4. Taylor açılımı ve sayısal türev ===")
print(f"Abrams, s/b = 0.50: f = {f0:.3f}, f′ = {f1:.3f}, f″ = {f2:.3f} MPa")
for x in [0.40, 0.65]:
    t1 = f0 + f1 * (x - x0)
    t2 = t1 + 0.5 * f2 * (x - x0) ** 2
    print(f"s/b = {x:.2f}: gerçek {abrams(x):.3f}, 1. derece {t1:.3f}, 2. derece {t2:.3f} MPa")
h_dizi = np.logspace(-16, -1, 61)
hata_ileri = np.abs((abrams(x0 + h_dizi) - f0) / h_dizi - f1) / abs(f1)
hata_merkez = np.abs((abrams(x0 + h_dizi) - abrams(x0 - h_dizi)) / (2 * h_dizi) - f1) / abs(f1)
secili = [np.argmin(np.abs(np.log10(h_dizi) - k)) for k in (-2, -4, -12)]   # h = 1e-2, 1e-4, 1e-12
print("h = 1e-2, 1e-4, 1e-12 için bağıl hata: ileri " + " / ".join(f"{v:.1e}" for v in hata_ileri[secili])
      + ", merkezi " + " / ".join(f"{v:.1e}" for v in hata_merkez[secili]))
print(f"En küçük hata: ileri fark {hata_ileri.min():.1e} (h ≈ {h_dizi[hata_ileri.argmin()]:.0e}), "
      f"merkezi fark {hata_merkez.min():.1e} (h ≈ {h_dizi[hata_merkez.argmin()]:.0e})")

# %% 5. Ortalama, varyans, korelasyon ve merkezi limit teoremi
sb = rng.uniform(0.35, 0.65, 500)                           # su/bağlayıcı
dayanim = abrams(sb) * rng.lognormal(0.0, 0.07, 500)        # MPa
sicaklik = rng.uniform(5.0, 30.0, 500)                      # bu üreticide dayanımla ilgisiz (°C)
print("\n=== 5. İstatistik ve merkezi limit teoremi ===")
print(f"Dayanım: ortalama {dayanim.mean():.2f} MPa; varyans 1/n = {dayanim.var():.2f}, "
      f"1/(n−1) = {dayanim.var(ddof=1):.2f} MPa²")
R = np.corrcoef(np.vstack([sb, dayanim, sicaklik]))
print(f"cov(s/b, dayanım) = {np.cov(sb, dayanim)[0, 1]:.3f} MPa; korelasyon matrisi [s/b, dayanım, sıcaklık]:\n"
      + np.array2string(R, precision=2, suppress_small=True))
u_e = rng.uniform(-1.0, 1.0, 500)
print(f"u ~ U(−1, 1), v = u²: korelasyon {np.corrcoef(u_e, u_e**2)[0, 1]:.3f} (ilişki tam ama doğrusal değil)")
z_ornek = {}
for k in [1, 2, 5, 30]:
    ort_k = rng.uniform(0.0, 1.0, (100_000, k)).mean(axis=1)  # k düzgün sayının ortalaması
    z = (ort_k - 0.5) / np.sqrt(1 / (12 * k))
    z_ornek[k] = z
    print(f"k = {k:2d}: std {ort_k.std():.4f} (kuram {np.sqrt(1 / (12 * k)):.4f}), basıklık fazlası "
          f"{stats.kurtosis(ort_k):+.3f} (kuram {-1.2 / k:+.3f}), |z| < 1.96: {np.mean(np.abs(z) < 1.96):.3f}")

# %% 6. En çok olabilirlik
kup = rng.normal(38.0, 4.0, 10)                             # 10 küp (MPa), gerçek μ = 38, σ = 4
print("\n=== 6. En çok olabilirlik ===")
print(f"10 küp: μ̂ = x̄ = {kup.mean():.2f} MPa, σ̂ (1/n) = {kup.std():.2f}, s (1/(n−1)) = {kup.std(ddof=1):.2f} MPa")
tekrar = rng.normal(38.0, 4.0, (100_000, 5))                # her tekrarda 5 küp
v_mle, v_s2 = tekrar.var(axis=1), tekrar.var(axis=1, ddof=1)
print(f"5 küplük 100000 tekrar: σ̂² ortalaması {v_mle.mean():.2f} (= {v_mle.mean() / 16:.3f} σ²), "
      f"s² ortalaması {v_s2.mean():.2f} (σ² = 16)")
# Regresyon: Gauss gürültülü doğru için olabilirliği en büyütmek = MSE'yi en küçültmek
eps = np.sort(rng.uniform(0.1, 1.5, 40))                    # gerinim (‰)
sig = 200.0 * eps + 2.0 + rng.normal(0.0, 3.0, 40)          # gerilme (MPa); eğim GPa birimindedir
Xr = np.column_stack([eps, np.ones_like(eps)])
(E_ek, b_ek), *_ = np.linalg.lstsq(Xr, sig, rcond=None)
mse = np.mean((sig - Xr @ [E_ek, b_ek]) ** 2)


def eksi_log_olabilirlik(t):
    E, b0, log_s = t
    s2 = np.exp(2 * log_s)
    return 0.5 * len(sig) * np.log(2 * np.pi * s2) + np.sum((sig - E * eps - b0) ** 2) / (2 * s2)


sonuc = optimize.minimize(eksi_log_olabilirlik, x0=[100.0, 0.0, 0.0], method="BFGS")
E_ml, b_ml, s_ml = sonuc.x[0], sonuc.x[1], np.exp(sonuc.x[2])
print(f"En küçük kareler: E = {E_ek:.3f} GPa, b = {b_ek:.3f} MPa, √MSE = {np.sqrt(mse):.3f} MPa")
print(f"Olabilirliği en büyütme: E = {E_ml:.3f} GPa, b = {b_ml:.3f} MPa, σ̂ = {s_ml:.3f} MPa")
assert np.allclose([E_ml, b_ml, s_ml], [E_ek, b_ek, np.sqrt(mse)], rtol=1e-4, atol=1e-3)

# %% 7. Bayes teoremi: hasar alarmı ve taban oranı
on_olasilik, duyarlilik, yanlis_alarm = 0.02, 0.95, 0.05
sonsal = duyarlilik * on_olasilik / (duyarlilik * on_olasilik + yanlis_alarm * (1 - on_olasilik))
sonsal2 = duyarlilik * sonsal / (duyarlilik * sonsal + yanlis_alarm * (1 - sonsal))
N = 10_000
hasarli = on_olasilik * N
dogru_alarm, sahte_alarm = duyarlilik * hasarli, yanlis_alarm * (N - hasarli)
print("\n=== 7. Bayes: hasar alarmı ===")
print(f"{N} yapı: {hasarli:.0f} hasarlı → {dogru_alarm:.0f} doğru alarm; {N - hasarli:.0f} sağlam → "
      f"{sahte_alarm:.0f} yanlış alarm")
print(f"P(hasar | alarm) = {dogru_alarm:.0f} / {dogru_alarm + sahte_alarm:.0f} = {sonsal:.4f}; "
      f"ikinci bağımsız alarmdan sonra {sonsal2:.4f}")
assert np.isclose(sonsal, dogru_alarm / (dogru_alarm + sahte_alarm))

# %% 8. Grafikler
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
g = np.linspace(-1.5, 1.5, 301)
GX, GY = np.meshgrid(g, g)
for eksen, M, lam_m, Q_m, baslik in [(ax[0], A, lam, Q, "Pozitif tanımlı A: çanak"),
                                     (ax[1], B, lamB, QB, "Belirsiz B: eyer")]:
    Zq = M[0, 0] * GX**2 + 2 * M[0, 1] * GX * GY + M[1, 1] * GY**2   # xᵀ M x
    if np.all(lam_m > 0):
        dolu = eksen.contourf(GX, GY, Zq, levels=12, cmap="Blues")
    else:
        s_max = np.abs(Zq).max()
        dolu = eksen.contourf(GX, GY, Zq, levels=np.linspace(-s_max, s_max, 13), cmap="RdBu_r")
    eksen.contour(GX, GY, Zq, levels=dolu.levels, colors="white", linewidths=0.5)
    for k, renk in enumerate([RENK[1], RENK[0]]):           # sütun 0: küçük λ, sütun 1: büyük λ
        v = Q_m[:, k] * 1.0
        eksen.annotate("", xy=v, xytext=(0, 0), arrowprops=dict(arrowstyle="-|>", color=renk, lw=2.4))
        eksen.text(*(v * 1.12), f"λ = {lam_m[k]:.1f}", color=renk, fontsize=10, fontweight="bold",
                   ha="center", va="center", bbox=dict(boxstyle="round,pad=0.2", fc="white", ec="none", alpha=0.9))
    eksen.set(xlabel="x₁", ylabel="x₂", title=baslik, aspect="equal")
    eksen.grid(False)
    fig.colorbar(dolu, ax=eksen, label="xᵀMx (MPa)", shrink=0.9)
fig.savefig(KLASOR / "h2_matematik_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
xs = np.linspace(0.30, 0.75, 200)
ax[0].plot(xs, abrams(xs), color=MUREKKEP, ls="--", lw=1.5, label="Abrams: 96.5 / 7^(s/b)")
ax[0].plot(xs, f0 + f1 * (xs - x0), color=RENK[0], label="1. derece Taylor")
ax[0].plot(xs, f0 + f1 * (xs - x0) + 0.5 * f2 * (xs - x0) ** 2, color=RENK[1], label="2. derece Taylor")
ax[0].plot(x0, f0, "o", color=MUREKKEP, ms=6)
ax[0].set(xlabel="Su / bağlayıcı oranı (–)", ylabel="28 günlük dayanım (MPa)",
          title="Taylor açılımı, s/b = 0.50 çevresinde")
ax[0].legend(loc="upper right")
EPS = np.finfo(float).eps
ax[1].loglog(h_dizi, hata_ileri, "o-", ms=3, lw=1.2, color=RENK[0], label="İleri fark")
ax[1].loglog(h_dizi, hata_merkez, "o-", ms=3, lw=1.2, color=RENK[1], label="Merkezi fark")
ax[1].loglog(h_dizi, (abs(f2) / 2 * h_dizi + EPS * f0 / h_dizi) / abs(f1), ":", color=RENK[0], lw=1.5,
             label="Kuram: |f″|h/2 + ε|f|/h")
ax[1].loglog(h_dizi, (abs(f3) / 6 * h_dizi**2 + EPS * f0 / h_dizi) / abs(f1), ":", color=RENK[1], lw=1.5,
             label="Kuram: |f‴|h²/6 + ε|f|/h")
ax[1].set(xlabel="Adım h", ylabel="Bağıl türev hatası", title="Sayısal türev: hata–adım ilişkisi",
          ylim=(1e-13, 1e1))
ax[1].legend(loc="lower left", fontsize=8.5)
fig.savefig(KLASOR / "h2_matematik_2.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
kutu = np.linspace(-4, 4, 61)
for renk, k in zip(RENK[:3], [1, 2, 30]):
    ax[0].hist(z_ornek[k], bins=kutu, density=True, histtype="step", lw=1.8, color=renk,
               label=f"k = {k}")
zz = np.linspace(-4, 4, 200)
ax[0].plot(zz, np.exp(-zz**2 / 2) / np.sqrt(2 * np.pi), color=MUREKKEP, ls="--", lw=1.4, label="Standart normal")
ax[0].set(xlabel="k düzgün sayının standartlaştırılmış ortalaması z", ylabel="Olasılık yoğunluğu",
          title="Merkezi limit teoremi", ylim=(0, 0.52))
ax[0].legend(loc="upper left", ncol=2)
kutu2 = np.linspace(0, 60, 61)
ax[1].hist(v_mle, bins=kutu2, density=True, histtype="step", lw=1.8, color=RENK[0], label="σ̂² (1/n), en çok olabilirlik")
ax[1].hist(v_s2, bins=kutu2, density=True, histtype="step", lw=1.8, color=RENK[1], label="s² (1/(n−1))")
ax[1].axvline(v_mle.mean(), color=RENK[0], lw=1.2, label=f"σ̂² ortalaması = {v_mle.mean():.2f}")
ax[1].axvline(v_s2.mean(), color=RENK[1], lw=1.2, label=f"s² ortalaması = {v_s2.mean():.2f}")
ax[1].axvline(16.0, color=MUREKKEP, ls="--", lw=1.4, label="Gerçek σ² = 16 MPa²")
ax[1].set(xlabel="Varyans tahmini (MPa²)", ylabel="Olasılık yoğunluğu",
          title="5 küplük örneklemde varyans tahmini")
ax[1].legend(loc="upper right", fontsize=8.5)
fig.savefig(KLASOR / "h2_matematik_3.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: h2_matematik_1.png, _2.png, _3.png")=== 1. Vektörler ===
F = [3. 4.] kN, e = [0.866 0.5 ] → F·e = 4.598 kN, aradaki açı 23.13°
r = [ 1.5 -2. 0.5 3. -1. ] MPa: L1 = 8.00, L2 = 4.062, L∞ = 3.00
MAE = L1/n = 1.600, RMSE = L2/√n = 1.817, en büyük hata = L∞ = 3.000 MPa
Uzaklık (ham birim): d(a, b) = 10.00, d(a, c) = 70.00 → a'ya en yakın: b
Uzaklık (standart sapmaya bölünmüş): d(a, b) = 1.26, d(a, c) = 0.98 → a'ya en yakın: c
=== 2. Matrisler, koşul sayısı, özdeğerler ===
Hilbert sistemi H x = b, gerçek çözüm x = [1, …, 1]:
n κ(H) hata (solve) hata (inv) artık (solve) artık (inv)
4 1.55e+04 3.4e-14 1.0e-12 0.0e+00 8.2e-14
6 1.50e+07 4.1e-11 9.7e-10 1.5e-16 8.1e-12
8 1.53e+10 6.7e-08 4.8e-07 1.6e-16 2.7e-08
10 1.60e+13 1.2e-05 2.4e-03 1.6e-16 3.4e-05
12 1.62e+16 1.3e-01 2.7e+00 1.1e-16 4.6e-02
Özellikler 1, x, …, x⁵ (x ~ U(0, 1)): (XᵀX)/n ile H₆ en büyük bağıl fark 0.0016; κ = 1.49e+07
A = [[80, 30], [30, 20]] MPa → özdeğerler (asal gerilmeler) [ 7.57 92.43] MPa, büyük asal yön 22.50°
Q Λ Qᵀ = A: True, QᵀQ = I: True; B = [[80, 30], [30, −20]] → özdeğerler [-28.31 88.31]
=== 3. Gradyan ve zincir kuralı ===
f = x² + 3y², (2, 1) noktasında ∇f = [4. 6.], |∇f| = 7.211
Yönlü türev: x yönü 4.000, ∇f yönü 7.211, dik yön 0.000; −∇f ile minimum yönü arası 29.74°
Gradyan kontrolü (tanh nöronu, h = 1e-6): bağıl hata 7.0e-11; (1 − ŷ²) unutulursa 4.0e-01
=== 4. Taylor açılımı ve sayısal türev ===
Abrams, s/b = 0.50: f = 36.474, f′ = -70.974, f″ = 138.110 MPa
s/b = 0.40: gerçek 44.309, 1. derece 43.571, 2. derece 44.262 MPa
s/b = 0.65: gerçek 27.240, 1. derece 25.827, 2. derece 27.381 MPa
h = 1e-2, 1e-4, 1e-12 için bağıl hata: ileri 9.7e-03 / 9.7e-05 / 2.6e-05, merkezi 6.3e-05 / 6.3e-09 / 2.6e-05
En küçük hata: ileri fark 1.3e-09 (h ≈ 6e-09), merkezi fark 2.1e-12 (h ≈ 1e-06)
=== 5. İstatistik ve merkezi limit teoremi ===
Dayanım: ortalama 36.04 MPa; varyans 1/n = 43.41, 1/(n−1) = 43.49 MPa²
cov(s/b, dayanım) = -0.534 MPa; korelasyon matrisi [s/b, dayanım, sıcaklık]:
[[ 1. -0.92 -0.04]
[-0.92 1. 0.03]
[-0.04 0.03 1. ]]
u ~ U(−1, 1), v = u²: korelasyon 0.018 (ilişki tam ama doğrusal değil)
k = 1: std 0.2888 (kuram 0.2887), basıklık fazlası -1.202 (kuram -1.200), |z| < 1.96: 1.000
k = 2: std 0.2033 (kuram 0.2041), basıklık fazlası -0.590 (kuram -0.600), |z| < 1.96: 0.961
k = 5: std 0.1287 (kuram 0.1291), basıklık fazlası -0.251 (kuram -0.240), |z| < 1.96: 0.953
k = 30: std 0.0526 (kuram 0.0527), basıklık fazlası -0.048 (kuram -0.040), |z| < 1.96: 0.951
=== 6. En çok olabilirlik ===
10 küp: μ̂ = x̄ = 36.35 MPa, σ̂ (1/n) = 2.82, s (1/(n−1)) = 2.98 MPa
5 küplük 100000 tekrar: σ̂² ortalaması 12.78 (= 0.799 σ²), s² ortalaması 15.97 (σ² = 16)
En küçük kareler: E = 198.033 GPa, b = 3.276 MPa, √MSE = 3.076 MPa
Olabilirliği en büyütme: E = 198.033 GPa, b = 3.276 MPa, σ̂ = 3.076 MPa
=== 7. Bayes: hasar alarmı ===
10000 yapı: 200 hasarlı → 190 doğru alarm; 9800 sağlam → 490 yanlış alarm
P(hasar | alarm) = 190 / 680 = 0.2794; ikinci bağımsız alarmdan sonra 0.8805
Grafikler kaydedildi: h2_matematik_1.png, _2.png, _3.png14. Sık yapılan hatalar
- Sistemi ters matrisle çözmek.
np.linalg.solveveya en küçük kareler içinlstsqkullanın; kötü koşullu problemlerde fark büyüktür. - Koşul sayısını görmezden gelmek. Birbirine çok benzeyen ya da ölçekleri çok farklı özellikler $X^\top X$'i kötü koşullu yapar. Önce ölçekleyin, gerekirse düzenlileştirin.
- Sayısal türevde çok küçük adım seçmek. $h = 10^{-12}$ yuvarlama hatasıyla boğulur. Merkezi fark ve $h \approx 10^{-5}$–$10^{-6}$ kullanın.
- Sıfıra yakın korelasyonu “ilişki yok” diye okumak. Korelasyon yalnız doğrusal ilişkiyi ölçer; ayrıca nedensellik kanıtı değildir.
- Paydaları karıştırmak. $n$ ile $n-1$ arasındaki fark küçük örneklemde gerçektir; kütüphanenin varsayılanını bilin ve
ddofile açıkça seçin. - Taban oranını unutmak. Yüzde 95 duyarlı bir test, alarm sonrası yüzde 95 olasılık demek değildir.
15. Alıştırmalar
Alıştırma 1Kolayİzdüşüm ve normlar
(a) $\vect F = [-2,\ 5]$ kN'luk kuvvetin, yatayla 60° yapan bir çubuğun eksenindeki bileşenini ve kuvvetle çubuk arasındaki açıyı bulun. (b) Bir modelin altı küpteki artıkları $[0{,}8;\ -1{,}2;\ 2{,}5;\ -0{,}4;\ 0;\ 1{,}1]$ MPa'dır. $L_1$, $L_2$, $L_\infty$ normlarını, MAE ve RMSE'yi hesaplayın.
Çözümü göster
(a) $\vect e = [\cos 60°,\ \sin 60°]$, yani $[0{,}5;\ 0{,}866]$. $\vect F^\top \vect e = -1 + 4{,}330 = 3{,}330$ kN. $\lVert \vect F \rVert = 5{,}385$ kN olduğundan $\cos\theta = 0{,}618$ ve $\theta = 51{,}80°$.
(b) $L_1 = 6{,}0$, $L_2 = 3{,}114$, $L_\infty = 2{,}5$ MPa. MAE $= 6{,}0/6 = 1{,}0$ MPa, RMSE $= 3{,}114/\sqrt 6 = 1{,}271$ MPa, en büyük hata 2,5 MPa. RMSE'nin MAE'den büyük çıkması, 2,5 MPa'lık tek büyük artığın kareler toplamındaki ağırlığından gelir.
Alıştırma 2KolayDaha nadir hasar
12. bölümdeki alarm sistemini, hasar oranının yüzde 0,5 olduğu bir yapı stokunda kullanıyoruz. Alarm sonrası hasar olasılığı kaçtır? Ön olasılık yüzde 2 iken sonsal olasılığın en az yüzde 50 olması için yanlış alarm oranı en fazla ne olmalıdır?
Çözümü göster
Yani yüzde 8,7. Hasar dört kat nadirleşince sonsal olasılık üç kattan fazla düştü.
Yüzde 50 için doğru alarm sayısı yanlış alarm sayısına eşit olmalı: $0{,}95 \cdot 0{,}02 = f \cdot 0{,}98$, buradan $f = 0{,}0194$, yani yanlış alarm oranı en fazla yüzde 1,94. Örneğin yüzde 1'lik bir yanlış alarm oranı sonsal olasılığı 0,660'a çıkarır. Nadir olayları yakalayan sistemlerde duyarlılıktan çok yanlış alarm oranı belirleyicidir.
Alıştırma 3OrtaLaplace gürültüsü ve medyan
Aynı betondan yedi küpün dayanımları 36,1; 37,4; 35,8; 38,0; 36,9; 37,2 ve 52,0 MPa; sonuncusu hatalı bir okumadır. Gürültünün Laplace dağılımlı olduğunu varsayarak sabit bir $\mu$'nün en çok olabilirlik tahmininin medyan olduğunu gösterin. Ortalama ile medyanı, hatalı okuma dahil ve hariç karşılaştırın.
Çözümü göster
Laplace modelinde eksi log-olabilirlik, sabitler dışında $\sum_i |x_i - \mu|$'dür. Türevi (tanımlı olduğu yerlerde) $-\sum_i \mathrm{sign}(x_i - \mu)$'dür, yani $\mu$'nün altında kalan gözlem sayısı eksi üstünde kalan gözlem sayısıdır. Bu türev medyanın altında negatif (fonksiyon azalır), üstünde pozitiftir (artar); en küçük değer bu yüzden medyandadır. Gözlem sayısı tekse (burada $n = 7$) türev hiçbir yerde sıfır olmaz, medyanın tam üzerinde ise tanımsızdır; minimum yine medyandır. (Normal modelde aynı mantık $\sum_i (x_i-\mu)^2$'yi, yani ortalamayı verir.)
Yedi küpte ortalama 39,06 MPa, medyan 37,20 MPa. Hatalı okuma çıkarılınca ortalama 36,90'a, medyan 37,05 MPa'ya iner. Tek bir hatalı değer ortalamayı 2,16 MPa kaydırırken medyanı 0,15 MPa kaydırdı. MAE kaybının aykırı değerlere MSE'den daha dayanıklı olmasının nedeni budur.
Alıştırma 4OrtaSigmoid için zincir kuralı
Tek girdili, sigmoid aktivasyonlu bir nöron düşünün: $\hat y = \sigma(wx + b)$, $\sigma(z) = 1/(1+e^{-z})$ ve $L = (\hat y - y)^2$. $\partial L/\partial w$ ve $\partial L/\partial b$'yi türetin; $x = 1{,}5$, $y = 1$, $w = 0{,}4$, $b = -0{,}2$ için hesaplayıp merkezi farkla doğrulayın.
Çözümü göster
$\sigma'(z) = \sigma(z)\,(1-\sigma(z))$ olduğundan
$$ \frac{\partial L}{\partial w} = 2(\hat y - y)\,\hat y\,(1-\hat y)\,x $$ve $\partial L/\partial b$ aynı ifadenin $x$'siz hâlidir. Sayılarla $z = 0{,}4$, $\hat y = 0{,}5987$, $L = 0{,}1611$; $\partial L/\partial w = -0{,}2893$ ve $\partial L/\partial b = -0{,}1928$. $h = 10^{-6}$ ile merkezi fark da $-0{,}2893$ veriyor. Türev negatif: $w$'yi artırmak tahmini 1'e yaklaştırır ve kaybı azaltır.
Alıştırma 5OrtaPolinom özellikleri ve ölçekleme
$x \sim U(0, 1)$ olan 100.000 nokta için $1, x, \dots, x^5$ özellik matrisinin ve $X^\top X$'in koşul sayısını hesaplayın. Aynı işlemi standartlaştırılmış $z = (x - \bar x)/s_x$ ile tekrarlayın. $\kappa(X)$ ile $\kappa(X^\top X)$ arasında nasıl bir ilişki görüyorsunuz?
Çözümü göster
Ham kuvvetlerle $\kappa(X) = 3{,}87\times10^3$ ve $\kappa(X^\top X) = 1{,}49\times10^7$. Standartlaştırılmış $z$ ile $\kappa(X) = 37{,}4$ ve $\kappa(X^\top X) = 1{,}40\times10^3$. Her iki durumda $\kappa(X^\top X) = \kappa(X)^2$ ($3865^2 \approx 1{,}49\times10^7$). Standartlaştırma $X^\top X$'in koşul sayısını dört mertebe düşürdü: $[0, 1]$ aralığında $x^4$ ile $x^5$ birbirine çok benzerken, sıfır çevresinde simetrik bir $z$ için tek ve çift kuvvetler birbirinden ayrışır. Normal denklemleri kurmak koşul sayısının karesiyle çalışmak demektir; lstsq doğrudan $X$ üzerinde çalışır.
Alıştırma 6ZorEn iyi adım boyu
8. bölümdeki hata ifadelerini $h$'ye göre küçülterek ileri ve merkezi fark için en iyi adımı türetin. Abrams fonksiyonu için $x = 0{,}50$'de bu değerleri ve öngörülen en küçük bağıl hataları hesaplayın ($|f'''| = 268{,}75$ MPa); Şekil 2 ile karşılaştırın.
Çözümü göster
İleri farkta hata ifadesinin $h$'ye göre türevi $\tfrac12|f''| - \varepsilon|f|/h^2$'dir; sıfıra eşitleyince $h^* = \sqrt{2\varepsilon|f|/|f''|}$ bulunur. Merkezi farkta türev $\tfrac13|f'''|h - \varepsilon|f|/h^2$'dir ve aynı işlem $h^* = (3\varepsilon|f|/|f'''|)^{1/3}$ verir. Kabaca $h^* \sim \sqrt\varepsilon$ ve $\varepsilon^{1/3}$.
$\varepsilon = 2{,}22\times10^{-16}$, $f = 36{,}474$, $f'' = 138{,}110$ ile ileri fark için $h^* = 1{,}08\times10^{-8}$ ve öngörülen en küçük bağıl hata $2{,}1\times10^{-8}$. Merkezi fark için $h^* = 4{,}49\times10^{-6}$ ve hata $3{,}8\times10^{-11}$. Şekildeki minimumlar ($h \approx 6\times10^{-9}$ ve $10^{-6}$) aynı mertebede. Gözlenen en küçük hatalar ($1{,}3\times10^{-9}$ ve $2{,}1\times10^{-12}$) öngörüden küçük, çünkü $\varepsilon|f|/h$ bir üst sınır mertebesidir: gerçek yuvarlama hataları çoğu zaman daha küçüktür ve kısmen birbirini götürür.
Özet
- İç çarpım izdüşümdür. Artık vektörünün $L_1$ ve $L_2$ normları $n$ ve $\sqrt n$'ye bölününce MAE ve RMSE'yi, $L_\infty$ normu en büyük hatayı verir. Uzaklıklar ölçeğe duyarlıdır.
- Koşul sayısı, verideki hatanın çözüme ne kadar büyüyerek geçtiğini söyler. Sistem ters matrisle değil
solve/lstsqile çözülür. - Simetrik matrisin özdeğerleri kuadratik formun biçimini belirler: hepsi pozitifse çanak, işaretleri karışıksa eyer. Hessyen, kovaryans ve rijitlik matrisleri bu dille okunur.
- Gradyan en dik artış doğrultusudur; zincir kuralı geri yayılımın temelidir; Taylor açılımı gradyan inişinin ve Newton yönteminin neden çalıştığını açıklar. Gradyanlar merkezi farkla kontrol edilir.
- Gauss gürültüsü altında olabilirliği en büyütmek, MSE'yi en küçültmekle aynıdır; varyansın en çok olabilirlik tahmini $n$ paydalıdır ve yanlıdır. Bayes teoreminde taban oranı sonucu belirler.
Sonraki derste bu araçları ilk kez bir arada kullanacağız: bir makine öğrenmesi probleminin nasıl kurulduğunu, veriyi nasıl ayıracağımızı ve hatayı nasıl dürüstçe ölçeceğimizi göreceğiz.
Kaynaklar
- M. P. Deisenroth, A. A. Faisal, C. S. Ong — Mathematics for Machine Learning, Cambridge University Press, 2020 (doğrusal cebir, vektör analizi, olasılık).
- I. Goodfellow, Y. Bengio, A. Courville — Deep Learning, MIT Press, 2016, Bölüm 2–4: deeplearningbook.org.
- L. N. Trefethen, D. Bau — Numerical Linear Algebra, SIAM, 1997 (koşul sayısı ve kararlılık).
- C. M. Bishop — Pattern Recognition and Machine Learning, Springer, 2006, Bölüm 1–2 (olasılık, en çok olabilirlik, Bayes).