Bu derste öğrenecekleriniz
- k-NN algoritmasını sıfırdan yazmak; k'nın yanlılık–varyans dengesindeki rolünü açıklamak
- Uzaklık tabanlı yöntemlerde ölçeklemenin neden zorunlu olduğunu göstermek
- Boyut lanetini sayısal bir deneyle gözlemlemek
- En geniş pay problemini, menteşe kaybını ve destek vektörlerini açıklamak
- Çekirdek hilesini anlamak; RBF çekirdeğinin C ve γ parametrelerini çapraz doğrulamayla ayarlamak
1. Problem: sıvılaşma sınırı
Gevşek ve suya doygun kumlar, deprem sırasında boşluk suyu basıncı hızla yükseldiğinde dayanımlarının büyük kısmını kaybedebilir. Buna sıvılaşma denir. Sıvılaşma tetiklenmesi değerlendirmesinde iki büyüklük karşılaştırılır:
- CSR (çevrimsel gerilme oranı): depremin zeminde oluşturduğu ortalama çevrimsel kayma gerilmesinin düşey efektif gerilmeye oranı. Deprem “yükü” budur.
- CRR (çevrimsel direnç oranı): aynı oran cinsinden zeminin direnci; sıvılaşmayı tetiklemek için gereken CSR.
Güvenlik katsayısı $FS = \mathrm{CRR}/\mathrm{CSR}$'dir; $FS < 1$ ise sıvılaşma beklenir. CRR doğrudan ölçülmez, arazi deneylerinden ampirik ilişkilerle bulunur. Idriss ve Boulanger (2008), SPT darbe sayısına dayanan şu ilişkiyi önermiştir ($N = (N_1)_{60cs}$):
$$ \begin{aligned} \ln \mathrm{CRR} = {}& \frac{N}{14{,}1} + \Big(\frac{N}{126}\Big)^2 \\ & - \Big(\frac{N}{23{,}6}\Big)^3 + \Big(\frac{N}{25{,}4}\Big)^4 \\ & - 2{,}8 \end{aligned} $$$(N_1)_{60cs}$, enerji oranı yüzde 60'a ve efektif gerilmesi 1 atm'ye göre düzeltilmiş, ince dane etkisi için de temiz kuma eşdeğerlenmiş SPT darbe sayısıdır. İlişki $M = 7{,}5$ büyüklüğündeki bir depreme ve $\sigma'_v = 1$ atm düşey efektif gerilmeye karşılık gelir; bu yüzden CSR'yi de bu iki koşula ölçeklenmiş kabul ediyoruz. Kodun ilk satırları formülü denetler: $N$ = 10, 20 ve 30 için CRR = 0,118; 0,206 ve 0,485. Eğri önce yavaş, 30 darbenin üzerinde çok hızlı yükselir: sıkı kumlar pratikte sıvılaşmaz.
Yayımlanmış eğriler, gerçek depremlerde sıvılaşan ve sıvılaşmayan sahaların vaka geçmişlerinden (case histories) türetilir. Her vaka $((N_1)_{60cs}, \mathrm{CSR})$ düzleminde bir noktadır; eğri iki grubu ayıran sınırdır. Yani bu bir sınıflandırma problemidir. Biz gerçek bir veritabanı kullanmıyoruz; aynı yapıda sentetik vakalar ürettik:
$$ y = 1 \iff \mathrm{CSR} > \mathrm{CRR}\big((N_1)_{60cs}\big)\;\varepsilon $$$y = 1$ “sıvılaştı” demektir. $\varepsilon$ sınırdaki belirsizliği temsil eden lognormal bir saçılımdır: ortancası 1, $\ln\varepsilon$'un standart sapması 0,15. $(N_1)_{60cs}$ 5–35, CSR 0,05–0,60 aralığından düzgün dağılımla seçildi. 500 vakanın yüzde 61'i sıvılaştı; 350 vakayı eğitime, 150 vakayı teste ayırdık (tabakalı bölme).
Bu veri neyi temsil etmez?
Bu bir vaka veritabanı değildir; saçılımın biçimi ve büyüklüğü bizim varsayımımızdır. Gerçek veritabanları küçüktür, sınıfları dengesizdir, girdilerin kendisi (darbe sayısı, deprem ivmesi) belirsizdir ve vakalar farklı depremlerden gelir. Uygulamada yayımlanmış CRR ilişkileri ve onları çevreleyen düzeltme adımları kullanılır. Burada sınırı bildiğimiz için, iki yöntemin onu ne kadar iyi geri kazandığını doğrudan görebileceğiz.
2. k-en yakın komşu
k-en yakın komşu (k-NN) belki de en sezgisel sınıflandırıcıdır: yeni bir vakanın sınıfını, ona en çok benzeyen $k$ eski vakanın çoğunluğuna bakarak tahmin eder. Bir mühendisin “buna benzer sahalarda ne olmuştu?” diye sorması gibi. Ayrı bir eğitim adımı yoktur; model, eğitim verisinin kendisidir. $\mathcal N_k(\vect x)$, $\vect x$'e en yakın $k$ eğitim örneğinin kümesi olsun:
$$ \hat p(\vect x) = \frac{1}{k}\sum_{i \in \mathcal N_k(\vect x)} y_i $$$\hat p > 0{,}5$ ise “sıvılaştı” deriz. İki sınıfta $k$'yı tek seçmek oy eşitliğini önler (çift $k$'da eşitlik olursa scikit-learn ilk sınıfı, burada “sıvılaşmadı”yı seçer). “En yakın” bir uzaklık tanımı gerektirir; en yaygını Minkowski ailesidir:
$$ d_p(\vect x, \vect z) = \Big(\sum_{j=1}^{d} |x_j - z_j|^p\Big)^{1/p} $$$p = 2$ bildiğimiz Öklid uzaklığı, $p = 1$ Manhattan (şehir blokları) uzaklığıdır. Özellikler arasındaki ilişkiyi de hesaba katan Mahalanobis uzaklığı gibi seçenekler de vardır. Sıfırdan yazılmış bir k-NN birkaç satırdır:
def knn_tahmin(X_eg, y_eg, X_yeni, k):
    d2 = ((X_yeni[:, None, :] - X_eg[None, :, :]) ** 2).sum(axis=2)   # (m, n) kare uzaklık
    komsu = np.argsort(d2, axis=1)[:, :k]                              # en yakın k komşu
    return (y_eg[komsu].mean(axis=1) > 0.5).astype(int)
Yayınlama (broadcasting) ile her yeni nokta ile her eğitim noktası arasındaki kare uzaklık tek satırda hesaplanır; karekök almaya gerek yoktur, çünkü sıralamayı değiştirmez. Bu fonksiyon, standartlaştırılmış veride 150 test vakasının hepsinde scikit-learn'ün KNeighborsClassifier sınıfıyla aynı tahmini veriyor.
$k$: yanlılık–varyans düğmesi
$k = 1$ iken model her eğitim noktasını ezberler: eğitim doğruluğu 1'dir ve sınır her gürültülü noktanın çevresinde kıvrılır. $k$ büyüdükçe tahmin daha geniş bir komşuluğun ortalaması olur; sınır yumuşar ama gerçek sınırın kıvrımlarını da düzleştirmeye başlar. Yani küçük $k$ yüksek varyans, büyük $k$ yüksek yanlılık demektir. Ders 03'teki polinom derecesine benzer bir düğmedir, yalnız yönü terstir: karmaşıklık $k$ küçüldükçe artar.
Tahminin maliyeti
k-NN'de eğitim bedavadır, bedeli tahminde ödenir. Her yeni nokta için bütün eğitim noktalarına uzaklık hesaplanır; bu da $n$ eğitim örneği ve $d$ özellik için $O(n\,d)$ işlem demektir. Bütün eğitim kümesi bellekte tutulmalıdır. scikit-learn düşük boyutta KD-ağacı ya da top ağacı (ball tree) gibi arama yapılarıyla bu maliyeti düşürür (algorithm="auto"), ama boyut arttıkça bu yapıların avantajı kaybolur.
Ne kadar iyi olabilir?
Cover ve Hart (1967), örnek sayısı sonsuza giderken 1-NN sınıflandırıcısının hata oranının, olabilecek en düşük hatanın (Bayes hatası) en fazla iki katı olduğunu gösterdi. Bu sonuç, bu kadar basit bir yöntemin neden hâlâ güçlü bir referans olduğunu açıklar. Ama “sonsuz veri” koşulu önemlidir; birazdan göreceğimiz gibi boyut arttıkça gereken veri miktarı patlar.
Kendiniz deneyin
Aşağıdaki denemede iki özellikli küçük veri kümeleri tarayıcıda üretilir. Dolu daireler eğitim, içi boş daireler test noktalarıdır; arka plan rengi modelin sınıf olasılığını, koyu çizgi $p = 0{,}5$ karar sınırını gösterir. Okuma kutusu eğitim ve test doğruluğunu birlikte verir. Şunları deneyin:
- Halkalar veri kümesinde k-en yakın komşu ile $k = 1$ seçin. Eğitim doğruluğu %100'e çıkar; test doğruluğuyla karşılaştırın. Sonra $k$'yı adım adım 30'a kadar büyütüp sınırın yumuşamasını izleyin.
- Gürültü kaydırıcısını artırın ve Yeni veri ile birkaç farklı örneklem üretin. Hangi $k$ değerlerinde test doğruluğu örneklemden örnekleme daha az oynuyor?
- Modeli Lojistik regresyon yapın ve XOR verisinde polinom özellik derecesini 1'den 2'ye çıkarın. Ders 05'teki özellik mühendisliği burada da doğrusal bir modele eğri bir sınır kazandırır.
Bu etkileşimli deneme için tarayıcıda JavaScript açık olmalıdır.
3. Uzaklık ölçeğe bağlıdır: ölçekleme zorunludur
Uzaklık, özelliklerin birimlerine doğrudan bağlıdır. Eğitim kümesinde $(N_1)_{60cs}$'nin standart sapması 8,46 darbe, CSR'ninki 0,164'tür. Ham birimlerde iki vaka arasındaki kare uzaklığın yüzde 99,96'sı darbe sayısı farkından geliyor; CSR neredeyse hiç sayılmıyor. Model, deprem yükünü görmeden yalnızca benzer darbe sayısına sahip vakaların çoğunluğuna bakıyor. Sonuç: $k = 15$ için test doğruluğu ham birimlerde 0,793, standartlaştırılmış özelliklerle 0,920.
Standartlaştırma her özellikten ortalamasını çıkarıp standart sapmasına böler: $z = (x - \bar x)/s$. Böylece iki özellik eşit söz hakkı kazanır. Ortalama ve standart sapma yalnızca eğitim verisinden hesaplanmalıdır; scikit-learn'de bunun en güvenli yolu ölçekleyiciyi modelle birlikte bir Pipeline içine koymaktır. Böylece çapraz doğrulamada her kat kendi ölçekleyicisini kendi eğitim kısmından öğrenir.
Standartlaştırma bir varsayımdır
Standartlaştırma, iki özelliğin bir standart sapmalık farkını eşit önemde sayar. Bu makul bir varsayılandır, “doğru” ölçek değildir. Fiziksel bilgi varsa ölçeği ona göre seçmek daha iyi olabilir; örneğin bir darbe farkının CSR cinsinden ne kadar önemli olduğunu sınırın eğimi söyler. Alıştırma 2, ölçeğin hangi noktanın “en yakın” sayılacağını nasıl değiştirdiğini gösteriyor.
4. Boyut laneti
k-NN'in bütün fikri “yakın noktalar benzerdir” varsayımına dayanır. Boyut sayısı arttıkça bu varsayım sessizce çöker. Kodda birim hiperküpe 500 rastgele nokta ve 50 sorgu noktası koyup, her sorgu için en yakın uzaklığın en uzak uzaklığa oranını hesapladık:
| Boyut $d$ | 1 | 2 | 10 | 100 | 1000 |
|---|---|---|---|---|---|
| En yakın / en uzak | 0,001 | 0,024 | 0,287 | 0,713 | 0,898 |
Bin boyutta en yakın komşu, en uzak komşunun neredeyse yüzde 90'ı kadar uzaktadır. Bütün noktalar aşağı yukarı aynı uzaklıktaysa “en yakın komşu” kavramı anlamını yitirir. Aynı olgunun bir başka yüzü hacimdir: verinin yüzde 1'ini içeren alt küpün kenarı $0{,}01^{1/d}$'dir. Bu kenar $d = 2$'de 0,10, $d = 10$'da 0,63, $d = 100$'de 0,95'tir. On boyutta “yerel” bir komşuluk, her eksenin yüzde 63'ünü kaplar; artık yerel değildir.
Pratik sonuç: uzaklık tabanlı yöntemlerde ilgisiz özellik eklemek zararlıdır. Her ilgisiz özellik uzaklığa gürültü katar ve gerçek sinyali taşıyan özelliklerin payını azaltır. Alıştırma 6'da sıvılaşma verisine anlamsız özellikler ekleyip bunu ölçeceksiniz. Özellik seçimi ve boyut indirgeme (Ders 10) bu yüzden önemlidir.
5. Destek vektör makineleri: en geniş pay
İkinci yöntem bambaşka bir sorudan çıkar. Sınıfları $y_i \in \{-1, +1\}$ ile kodlayalım ve doğrusal bir karar fonksiyonu düşünelim: $f(\vect x) = \vect w^\top\vect x + b$; $f > 0$ ise $+1$ deriz. Veri doğrusal olarak ayrılabiliyorsa onu ayıran sonsuz sayıda doğru vardır. Hangisi en iyisidir? Destek vektör makinesinin (SVM) cevabı: iki sınıfın en yakın noktalarına olan uzaklığı, yani payı (margin) en büyük olan. Geniş bir pay, yeni noktalardaki küçük sapmalara karşı tampon demektir.
Sert pay problemi ve ikili (dual) biçim
Bir $\vect x_i$ noktasının $\vect w^\top\vect x + b = 0$ hiperdüzlemine uzaklığı $|\vect w^\top\vect x_i + b|/\lVert\vect w\rVert$'dir. $(\vect w, b)$'yi bir sabitle çarpmak hiperdüzlemi değiştirmediği için, en yakın noktalarda $|\vect w^\top\vect x_i + b| = 1$ olacak biçimde ölçekleyebiliriz. O zaman sınıra en yakın noktaların uzaklığı $1/\lVert\vect w\rVert$, iki sınıf arasındaki boşluğun genişliği $2/\lVert\vect w\rVert$ olur. Payı en büyüklemek $\lVert\vect w\rVert$'yi en küçüklemek demektir:
$$ \min_{\vect w,\,b}\ \tfrac12\lVert\vect w\rVert^2 $$Kısıt: her $i$ için $y_i(\vect w^\top\vect x_i + b) \ge 1$, yani her nokta doğru tarafta ve sınıra en az 1 birim “uzakta”. Bu dışbükey bir karesel programdır. Lagrange çarpanları $\alpha_i \ge 0$ ile türev alınca iki koşul çıkar:
$$ \vect w = \sum_{i=1}^{n} \alpha_i\, y_i\,\vect x_i $$ve $\sum_i \alpha_i y_i = 0$. Bunları yerine koyunca ikili (dual) problem elde edilir:
$$ \begin{aligned} \max_{\boldsymbol\alpha}\ & \sum_{i}\alpha_i \\ & - \frac12\sum_{i}\sum_{j}\alpha_i\alpha_j\, y_i y_j\,\vect x_i^\top\vect x_j \end{aligned} $$Kısıtlar $\alpha_i \ge 0$ ve $\sum_i \alpha_i y_i = 0$'dır. Optimumda $\alpha_i$'si sıfırdan büyük olabilen noktalar yalnızca payın tam üzerindekilerdir (tümleyen gevşeklik koşulu). Bu noktalara destek vektörleri denir: sınırı yalnızca onlar belirler; diğer noktaları silseniz çözüm değişmez.
Yumuşak pay, $C$ ve menteşe kaybı
Gerçek veri, bizim sıvılaşma verimiz gibi, kusursuz ayrılmaz. Her noktaya bir gevşeklik payı $\xi_i \ge 0$ verilir ve kısıt $y_i f(\vect x_i) \ge 1 - \xi_i$ olarak gevşetilir. Amaç, geniş pay ile ihlallerin toplamı arasında bir dengedir:
$$ \min_{\vect w,\,b}\ \tfrac12\lVert\vect w\rVert^2 + C\sum_{i=1}^{n}\xi_i $$Optimumda her gevşeklik, kendi kısıtının izin verdiği en küçük değeri alır:
$$ \xi_i = \max\big(0,\ 1 - y_i f(\vect x_i)\big) $$Bu ifadeye menteşe kaybı (hinge loss) denir. Yani yumuşak paylı SVM, menteşe kaybı artı L2 düzenlileştirmesidir. $C$ büyükse ihlaller pahalıdır ve model eğitim verisine sıkı uyar; $C$ küçükse geniş bir pay uğruna bazı ihlallere göz yumulur. İkili problemde değişen tek şey çarpanlara bir üst sınır gelmesidir: kısıtlar $0 \le \alpha_i \le C$ ve $\sum_i \alpha_i y_i = 0$ olur.
Lojistik regresyonla karşılaştırmak öğreticidir. $y\,f(\vect x)$ çarpımına fonksiyonel pay diyelim: pozitifse nokta doğru taraftadır ve büyüdükçe sınırdan uzaklaşır. İki yöntem de fonksiyonel payın bir fonksiyonunu en küçükleyen doğrusal sınıflandırıcıdır. Lojistik kayıp, fonksiyonel pay cinsinden şöyle yazılır:
$$ \ln\big(1 + e^{-y_i f(\vect x_i)}\big) $$Lojistik kayıp hiçbir zaman tam sıfır olmaz; her nokta sınıra biraz etki eder. Menteşe kaybı ise $y f \ge 1$ olan noktalar için tam sıfırdır: güvenle doğru sınıflandırılmış noktalar çözümü hiç etkilemez. Destek vektörlerinin seyrekliği buradan gelir.
6. Çekirdek hilesi
İkili problemde veri yalnızca iç çarpımlar $\vect x_i^\top\vect x_j$ olarak görünür; tahmin de öyle: $f(\vect x) = \sum_i \alpha_i y_i\,\vect x_i^\top\vect x + b$. İç çarpımın yerine pozitif yarı tanımlı (Mercer koşulunu sağlayan) bir çekirdek (kernel) fonksiyonu $k(\vect x, \vect x')$ koyarsak, veriyi açıkça hesaplamadığımız bir özellik uzayına taşımış ve orada doğrusal bir SVM kurmuş oluruz. Buna çekirdek hilesi denir. Karar fonksiyonu şu biçimi alır:
$$ f(\vect x) = \sum_{i \in \mathrm{DV}} \alpha_i y_i\; k(\vect x_i, \vect x) + b $$Toplam yalnızca destek vektörleri (DV) üzerindendir. En yaygın çekirdek RBF (Gauss) çekirdeğidir:
$$ k(\vect x, \vect x') = \exp\big(-\gamma\,\lVert\vect x - \vect x'\rVert^2\big) $$RBF çekirdeğinin karşılık geldiği özellik uzayı sonsuz boyutludur, ama hesapta yalnızca iki nokta arasındaki uzaklık görünür. $\gamma$, her destek vektörünün etki yarıçapını belirler: büyük $\gamma$ dar tepeler ve kıvrıntılı sınırlar, küçük $\gamma$ geniş tepeler ve neredeyse doğrusal sınırlar demektir. Bu yüzden RBF çekirdekli SVM de bir uzaklık yöntemidir ve ölçekleme burada da zorunludur. scikit-learn'ün varsayılanı gamma="scale", $\gamma = 1/(d \cdot \mathrm{Var}(X))$ değerini kullanır; standartlaştırılmış iki özellikte bu 0,5 eder.
Kodda en iyi modelin karar fonksiyonunu NumPy ile yeniden kurduk. Model bir boru hattı olduğu için önce içindeki SVC'yi (svm = svm_boru[-1]) ve ölçekleyiciyi alıyoruz. scikit-learn, $\alpha_i y_i$ çarpımlarını dual_coef_, destek vektörlerini support_vectors_, $b$'yi intercept_ içinde saklar:
alfa_y = svm.dual_coef_[0]                     # αᵢ·yᵢ (yalnız destek vektörleri için)
Zb_te = svm_boru[0].transform(X_te)          # boru hattının ölçekleyicisiyle ölçeklenmiş test verisi
K_te = np.exp(-g_iyi * ((Zb_te[:, None, :] - svm.support_vectors_[None, :, :]) ** 2).sum(axis=2))
f_elle = K_te @ alfa_y + svm.intercept_[0]     # f(x) = Σ αᵢyᵢ k(xᵢ, x) + b
Elle hesaplanan $f$ ile decision_function arasındaki en büyük fark $1{,}2\times10^{-14}$; yani SVM'in tahmini gerçekten de destek vektörleri üzerinden ağırlıklı bir çekirdek toplamıdır. $\alpha_i$'si $C$'den küçük olan destek vektörlerinde $y_i f(\vect x_i)$ değeri 1,000–1,001 aralığında çıkıyor: bu noktalar tam olarak pay çizgisinin üzerinde duruyor.
SVM olasılık vermez
decision_function bir olasılık değil, sınıra işaretli bir “uzaklıktır”. Olasılık gerekiyorsa (örneğin Ders 05'teki maliyete göre eşik seçimi için) çıktının kalibre edilmesi gerekir. scikit-learn 1.9'da SVC(probability=True) seçeneği kullanımdan kaldırılma sürecindedir; önerilen yol CalibratedClassifierCV(SVC(), ensemble=False)'dur.
Aynı fikir regresyona da uyarlanır: destek vektör regresyonu (SVR), yarı genişliği $\epsilon$ olan ($\pm\epsilon$) bir tüpün içinde kalan hataları hiç cezalandırmaz ve tüpün dışına taşan noktalar destek vektörü olur. Hesap maliyeti açısından çekirdekli SVM, eğitimde örnek sayısının karesiyle küpü arasında büyüyen bir maliyete sahiptir; on binlerce örneğin üzerinde LinearSVC ya da çekirdek yaklaşımları (sklearn.kernel_approximation) tercih edilir. Tahminde ise yalnızca destek vektörleri kullanılır.
7. Çalıştırılabilir kod
Kod altı bölümden oluşur: veri üretimi, sıfırdan k-NN ve ölçekleme deneyi, $k$ için doğrulama eğrisi, boyut laneti deneyi, SVM için ızgara araması ve karar fonksiyonunun elle kurulması, test kümesinde karşılaştırma. Son bölüm üç grafiği çizer. Kurulum için Ders 01'deki adımları izleyin.
"""Ders 06 — k-en yakın komşu ve destek vektör makineleri.

Kumlu zeminde sıvılaşma tetiklenmesini iki özellikten sınıflandırıyoruz: temiz kuma eşdeğer
düzeltilmiş SPT darbe sayısı (N1)60cs ve deprem yükü oranı CSR (M = 7.5 ve σ'v = 1 atm koşullarına
ölçekli).

Veri sentetiktir; gerçek bir vaka geçmişi veritabanı değildir. Sınır, Idriss ve Boulanger (2008)
SPT tabanlı ilişkisinden gelir:
    CRR = exp(N/14.1 + (N/126)² − (N/23.6)³ + (N/25.4)⁴ − 2.8),   N = (N1)60cs
Bir "vaka" CSR > CRR·ε ise sıvılaşmış sayılır; ε, ortancası 1 ve logaritmik standart sapması
0.15 olan lognormal bir saçılımdır (eğitim amaçlı varsayım). Mühendislikte yayımlanmış CRR
eğrileri kullanılır; buradaki modeller yöntemleri öğrenmek içindir.

Çalıştır:  python d06_knn_svm.py
Gerekenler: numpy, scikit-learn, matplotlib (Pillow onunla gelir)  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre üç PNG grafiği
"""
import io
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D
from PIL import Image
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV, StratifiedKFold, train_test_split, validation_curve
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent


def kaydet(fig, ad):
    """PNG'yi 256 renkli paletle kaydeder: düz renkli grafikte fark görünmez, dosya yaklaşık 3 kat küçülür."""
    tampon = io.BytesIO()
    fig.savefig(tampon, format="png", dpi=160)
    Image.open(tampon).convert("RGB").quantize(256, dither=Image.Dither.NONE).save(KLASOR / ad, optimize=True)
    plt.close(fig)


def crr(N):
    """Idriss–Boulanger (2008) SPT tabanlı CRR (M = 7.5, σ'v = 1 atm); N = (N1)60cs."""
    return np.exp(N / 14.1 + (N / 126) ** 2 - (N / 23.6) ** 3 + (N / 25.4) ** 4 - 2.8)


# %% 1. Veri: sentetik vaka geçmişleri
rng = np.random.default_rng(42)
n = 500
N1 = rng.uniform(5, 35, n)                     # (N1)60cs, darbe/30 cm
CSR = rng.uniform(0.05, 0.60, n)               # deprem yükü oranı
eps = rng.lognormal(0.0, 0.15, n)              # sınırdaki saçılım (varsayım)
y = (CSR > crr(N1) * eps).astype(int)          # 1 = sıvılaştı, 0 = sıvılaşmadı
X = np.column_stack([N1, CSR])
X_eg, X_te, y_eg, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)
olcek = StandardScaler().fit(X_eg)             # ortalama ve std yalnız eğitim verisinden
Z_eg, Z_te = olcek.transform(X_eg), olcek.transform(X_te)
print("=== 1. Veri (sentetik vaka geçmişleri) ===")
print(f"Örnek: {n} (eğitim {len(y_eg)}, test {len(y_te)}), sıvılaştı oranı: {y.mean():.3f}")
print("CRR kontrolü: " + ", ".join(f"N={v} → {crr(v):.3f}" for v in (10, 20, 30)))
print(f"Eğitim kümesi: ortalama ({olcek.mean_[0]:.2f}, {olcek.mean_[1]:.3f}), "
      f"std ((N1)60cs = {olcek.scale_[0]:.2f}, CSR = {olcek.scale_[1]:.3f})")


# %% 2. k-NN: sıfırdan ve scikit-learn; ölçeklemenin etkisi
def knn_tahmin(X_eg, y_eg, X_yeni, k):
    """Öklid uzaklığına göre en yakın k komşunun çoğunluk oyu (ikili sınıf, tek k)."""
    d2 = ((X_yeni[:, None, :] - X_eg[None, :, :]) ** 2).sum(axis=2)   # (m, n) kare uzaklık
    komsu = np.argsort(d2, axis=1)[:, :k]                              # en yakın k komşu
    return (y_eg[komsu].mean(axis=1) > 0.5).astype(int)


K = 15
t_sifirdan = knn_tahmin(Z_eg, y_eg, Z_te, K)
knn_s = KNeighborsClassifier(n_neighbors=K).fit(Z_eg, y_eg)
knn_ham = KNeighborsClassifier(n_neighbors=K).fit(X_eg, y_eg)
fark2 = (X_eg[:, None, :] - X_eg[None, :, :]) ** 2                    # özellik başına kare farklar
pay_N = fark2[..., 0].sum() / fark2.sum()
print(f"\n=== 2. k-NN (k = {K}) ===")
print(f"Sıfırdan k-NN ile scikit-learn aynı tahmin: {np.sum(t_sifirdan == knn_s.predict(Z_te))}/{len(y_te)}")
print(f"Ham birimler   : test doğruluğu {knn_ham.score(X_te, y_te):.3f} "
      f"(kare uzaklıkta (N1)60cs payı %{100 * pay_N:.2f})")
print(f"Standartlaştırılmış: test doğruluğu {knn_s.score(Z_te, y_te):.3f}")
assert np.array_equal(t_sifirdan, knn_s.predict(Z_te))

# %% 3. k seçimi: doğrulama eğrisi (5 katlı çapraz doğrulama)
kfold = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
k_listesi = np.array([1, 3, 5, 9, 15, 21, 31, 45, 61, 91, 121, 181])
boru = make_pipeline(StandardScaler(), KNeighborsClassifier())
egt_skor, cv_skor = validation_curve(boru, X_eg, y_eg, param_name="kneighborsclassifier__n_neighbors",
                                     param_range=k_listesi, cv=kfold)
egt_ort, cv_ort = egt_skor.mean(axis=1), cv_skor.mean(axis=1)
# Eşitlikte daha büyük k (daha düzgün sınır, daha basit model) seçilir
k_iyi = int(k_listesi[np.isclose(cv_ort, cv_ort.max())].max())
knn_iyi = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=k_iyi)).fit(X_eg, y_eg)
print("\n=== 3. k seçimi (5 katlı CV, standartlaştırılmış) ===")
print("   k   eğitim     CV")
for k, a, b in zip(k_listesi, egt_ort, cv_ort):
    if k in (1, 3, 5, 15, 31, 61, 121, 181) or k == k_iyi:
        print(f"{k:4d}   {a:.3f}   {b:.3f}" + ("   ← seçilen" if k == k_iyi else ""))
uc_k = {k: make_pipeline(StandardScaler(), KNeighborsClassifier(k)).fit(X_eg, y_eg).score(X_te, y_te)
        for k in (1, 181)}
print(f"Seçilen k = {k_iyi}: test doğruluğu {knn_iyi.score(X_te, y_te):.3f}; karşılaştırma için test: "
      + ", ".join(f"k = {k} → {d:.3f}" for k, d in uc_k.items()))

# %% 4. Boyut laneti: yüksek boyutta en yakın ve en uzak komşu birbirine yaklaşır
boyutlar = [1, 2, 5, 10, 20, 50, 100, 200, 500, 1000]
oranlar = []
for d in boyutlar:
    P = rng.uniform(size=(500, d))             # birim hiperküpte 500 nokta
    Q = rng.uniform(size=(50, d))              # 50 sorgu noktası
    D = np.sqrt(np.maximum((Q**2).sum(1)[:, None] + (P**2).sum(1)[None, :] - 2 * Q @ P.T, 0))
    oranlar.append(np.mean(D.min(axis=1) / D.max(axis=1)))
print("\n=== 4. Boyut laneti (500 düzgün nokta, 50 sorgu) ===")
print("En yakın / en uzak uzaklık oranı: " +
      ", ".join(f"d={d}: {r:.3f}" for d, r in zip(boyutlar, oranlar) if d in (1, 2, 10, 100, 1000)))
print("Verinin %1'ini içeren alt küpün kenarı: " +
      ", ".join(f"d={d}: {0.01 ** (1 / d):.2f}" for d in (1, 2, 10, 100)))

# %% 5. SVM (RBF çekirdek): ızgara araması, destek vektörleri, karar fonksiyonu
C_list = np.logspace(-1, 3, 9)
g_list = np.logspace(-2, 2, 9)
# Ölçekleyici boru hattının içinde: her CV katında yalnız o katın eğitim kısmından öğrenilir
arama = GridSearchCV(make_pipeline(StandardScaler(), SVC(kernel="rbf")),
                     {"svc__C": C_list, "svc__gamma": g_list}, cv=kfold).fit(X_eg, y_eg)
svm_boru = arama.best_estimator_               # bütün eğitim verisiyle yeniden eğitilmiş en iyi boru hattı
svm = svm_boru[-1]                             # içindeki SVC
C_iyi, g_iyi = arama.best_params_["svc__C"], arama.best_params_["svc__gamma"]
izgara_cv = arama.cv_results_["mean_test_score"].reshape(len(C_list), len(g_list))  # satır: C
alfa_y = svm.dual_coef_[0]                     # αᵢ·yᵢ (yalnız destek vektörleri için)
Zb_te = svm_boru[0].transform(X_te)          # boru hattının ölçekleyicisiyle ölçeklenmiş test verisi
K_te = np.exp(-g_iyi * ((Zb_te[:, None, :] - svm.support_vectors_[None, :, :]) ** 2).sum(axis=2))
f_elle = K_te @ alfa_y + svm.intercept_[0]     # f(x) = Σ αᵢyᵢ k(xᵢ, x) + b
serbest = np.abs(alfa_y) < C_iyi - 1e-8        # 0 < α < C: tam pay üzerindeki noktalar
y_pm = np.where(y_eg[svm.support_] == 1, 1, -1)
marj = y_pm * svm.decision_function(svm.support_vectors_)
asiri = SVC(kernel="rbf", C=1000, gamma=100).fit(Z_eg, y_eg)
az = SVC(kernel="rbf", C=0.1, gamma=100).fit(Z_eg, y_eg)    # ızgaranın az uyum köşesi
print("\n=== 5. SVM (RBF çekirdek) ===")
print(f"Izgara araması ({len(C_list)} × {len(g_list)} aday, 5 katlı CV): C = {C_iyi:.3g}, γ = {g_iyi:.3g}, "
      f"CV doğruluğu {arama.best_score_:.3f}")
koseler = ((0, 0), (0, -1), (-1, 0), (-1, -1))
print("Izgaranın köşeleri (CV): " + ", ".join(
    f"C={C_list[a]:g}/γ={g_list[b]:g}: {izgara_cv[a, b]:.3f}" for a, b in koseler))
esit = np.argwhere(np.isclose(izgara_cv, izgara_cv.max()))       # en iyiyle aynı CV doğruluğu
print("CV'si en iyiye eşit: " + ", ".join(f"C={C_list[a]:.3g}/γ={g_list[b]:.3g}" for a, b in esit))
print(f"Test doğruluğu: {svm_boru.score(X_te, y_te):.3f}")
print(f"Destek vektörü: {len(svm.support_)} / {len(y_eg)} "
      f"(payın tam üzerinde: {serbest.sum()}, α = C sınırında: {(~serbest).sum()})")
print(f"Karar fonksiyonu elle, Σ αᵢyᵢ k(xᵢ, x) + b: sklearn ile en büyük fark "
      f"{np.abs(f_elle - svm_boru.decision_function(X_te)).max():.1e}")
print(f"Pay üzerindeki destek vektörlerinde yᵢ f(xᵢ): {marj[serbest].min():.3f} – {marj[serbest].max():.3f}")
for ad, m in [("Aşırı esnek SVM (C = 1000, γ = 100)", asiri), ("Az uyumlu SVM  (C = 0.1, γ = 100) ", az)]:
    print(f"{ad}: eğitim {m.score(Z_eg, y_eg):.3f}, test {m.score(Z_te, y_te):.3f}, "
          f"destek vektörü {len(m.support_)}")
assert np.allclose(f_elle, svm_boru.decision_function(X_te), atol=1e-8)

# %% 6. Test kümesinde karşılaştırma
dogrusal = make_pipeline(StandardScaler(), LogisticRegression()).fit(X_eg, y_eg)
egri_dogruluk = np.mean((X_te[:, 1] > crr(X_te[:, 0])).astype(int) == y_te)
print("\n=== 6. Test kümesinde karşılaştırma (150 vaka) ===")
for ad, dg in [("CRR eğrisinin kendisi (CSR > CRR)", egri_dogruluk),
               ("Lojistik regresyon (doğrusal)", dogrusal.score(X_te, y_te)),
               (f"k-NN (k = {k_iyi})", knn_iyi.score(X_te, y_te)),
               (f"SVM (RBF, C = {C_iyi:.3g}, γ = {g_iyi:.3g})", svm_boru.score(X_te, y_te))]:
    print(f"{ad:34s}: {dg:.3f}")

# %% 7. Grafikler
NN, CC = np.meshgrid(np.linspace(5, 35, 200), np.linspace(0.05, 0.60, 200))
izgara = np.column_stack([NN.ravel(), CC.ravel()])
nn = np.linspace(5, 35, 300)


def veri_ve_egri(a, baslik):
    a.scatter(X_eg[y_eg == 0, 0], X_eg[y_eg == 0, 1], s=12, facecolors="none", edgecolors=SOLUK, lw=0.8)
    a.scatter(X_eg[y_eg == 1, 0], X_eg[y_eg == 1, 1], s=12, marker="x", color=SOLUK, lw=0.8)
    a.plot(nn, crr(nn), color=MUREKKEP, ls="--", lw=1.4)
    a.set(xlim=(5, 35), ylim=(0.05, 0.6), title=baslik)


# Şekil 1: k-NN karar sınırları
fig, ax = plt.subplots(2, 2, figsize=(10, 7.5), layout="constrained", sharex=True, sharey=True)
modeller = [(make_pipeline(StandardScaler(), KNeighborsClassifier(1)), "k = 1 (standartlaştırılmış)"),
            (knn_iyi, f"k = {k_iyi} (CV ile seçilen)"),
            (make_pipeline(StandardScaler(), KNeighborsClassifier(181)), "k = 181 (aşırı düzgün)"),
            (KNeighborsClassifier(k_iyi), f"k = {k_iyi}, ölçeklemeden (ham birimler)")]
for a, (m, baslik) in zip(ax.ravel(), modeller):
    m.fit(X_eg, y_eg)
    p = m.predict_proba(izgara)[:, 1].reshape(NN.shape)
    a.contourf(NN, CC, p, levels=[0.5, 1.01], colors=[RENK[0]], alpha=0.10)
    a.contour(NN, CC, p, levels=[0.5], colors=[RENK[0]], linewidths=1.8)
    veri_ve_egri(a, f"{baslik}: test {m.score(X_te, y_te):.3f}")
for a in ax[1]:
    a.set_xlabel("(N1)60cs (darbe/30 cm)")
for a in ax[:, 0]:
    a.set_ylabel("CSR (M = 7.5, σ′v = 1 atm)")
tutamak = [Line2D([], [], marker="x", ls="none", color=SOLUK, label="Sıvılaştı (eğitim)"),
           Line2D([], [], marker="o", ls="none", mfc="none", mec=SOLUK, label="Sıvılaşmadı (eğitim)"),
           Line2D([], [], color=RENK[0], label="k-NN sınırı (p = 0.5)"),
           Line2D([], [], color=MUREKKEP, ls="--", lw=1.4, label="CRR eğrisi (Idriss–Boulanger)")]
fig.legend(handles=tutamak, loc="outside lower center", ncol=4, fontsize=9)
kaydet(fig, "d06_knn_svm_1.png")

# Şekil 2: doğrulama eğrisi ve boyut laneti
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
ax[0].semilogx(k_listesi, egt_ort, "-o", ms=4, color=RENK[0], label="Eğitim doğruluğu")
ax[0].semilogx(k_listesi, cv_ort, "-o", ms=4, color=RENK[1], label="5 katlı CV doğruluğu")
ax[0].axvline(k_iyi, color=MUREKKEP, ls="--", lw=1.2, label=f"Seçilen k = {k_iyi}")
ax[0].set(xlabel="Komşu sayısı k (log ölçek)", ylabel="Doğruluk", title="k: yanlılık–varyans düğmesi")
ax[0].legend(loc="lower left", fontsize=9)
ax[1].semilogx(boyutlar, oranlar, "-o", ms=4, color=RENK[0], label="Ortalama oran (50 sorgu)")
ax[1].axhline(1.0, color=IKINCIL, ls=":", lw=1.2, label="Tüm uzaklıklar eşit")
ax[1].set(xlabel="Boyut sayısı d (log ölçek)", ylabel="En yakın / en uzak uzaklık", ylim=(0, 1.05),
          title="Boyut laneti: uzaklıklar birbirine yaklaşır")
ax[1].legend(loc="lower right", fontsize=9)
kaydet(fig, "d06_knn_svm_2.png")

# Şekil 3: C–γ ızgarasında CV doğruluğu ve en iyi SVM'in sınırı
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained")
im = ax[0].imshow(izgara_cv, origin="lower", cmap="Blues", aspect="auto")
def etiket(v):
    return f"{v:.0f}" if v >= 100 else f"{v:.2g}"


ax[0].set_xticks(range(len(g_list)), [etiket(g) for g in g_list])
ax[0].set_yticks(range(len(C_list)), [etiket(c) for c in C_list])
i, j = np.unravel_index(np.argmax(izgara_cv), izgara_cv.shape)
ax[0].plot(j, i, marker="*", ms=14, color=RENK[1], ls="none")
ax[0].set(xlabel="γ (standartlaştırılmış özellikler)", ylabel="C",
          title="5 katlı CV doğruluğu (★ en iyi)")
ax[0].grid(False)
fig.colorbar(im, ax=ax[0], label="Doğruluk")
f_iz = svm_boru.decision_function(izgara).reshape(NN.shape)
ax[1].contourf(NN, CC, f_iz, levels=[0, f_iz.max() + 1], colors=[RENK[0]], alpha=0.10)
ax[1].contour(NN, CC, f_iz, levels=[0], colors=[RENK[0]], linewidths=1.8)
ax[1].contour(NN, CC, f_iz, levels=[-1, 1], colors=[RENK[0]], linewidths=1.0, linestyles=":")
veri_ve_egri(ax[1], f"SVM: C = {C_iyi:.3g}, γ = {g_iyi:.3g}")
sv = X_eg[svm.support_]
ax[1].scatter(sv[:, 0], sv[:, 1], s=40, facecolors="none", edgecolors=RENK[1], lw=1.0)
ax[1].set(xlabel="(N1)60cs (darbe/30 cm)", ylabel="CSR (M = 7.5, σ′v = 1 atm)")
tutamak = [Line2D([], [], color=RENK[0], label="Karar sınırı f = 0"),
           Line2D([], [], color=RENK[0], lw=1.0, ls=":", label="Pay f = ±1"),
           Line2D([], [], marker="o", ls="none", mfc="none", mec=RENK[1], label="Destek vektörü"),
           Line2D([], [], color=MUREKKEP, ls="--", lw=1.4, label="CRR eğrisi")]
ax[1].legend(handles=tutamak, loc="upper center", bbox_to_anchor=(0.5, -0.17), ncol=2, fontsize=8)
kaydet(fig, "d06_knn_svm_3.png")
print("\nGrafikler kaydedildi: d06_knn_svm_1.png, _2.png, _3.png")=== 1. Veri (sentetik vaka geçmişleri) ===
Örnek: 500 (eğitim 350, test 150), sıvılaştı oranı: 0.610
CRR kontrolü: N=10 → 0.118, N=20 → 0.206, N=30 → 0.485
Eğitim kümesi: ortalama (19.89, 0.328), std ((N1)60cs = 8.46, CSR = 0.164)
=== 2. k-NN (k = 15) ===
Sıfırdan k-NN ile scikit-learn aynı tahmin: 150/150
Ham birimler : test doğruluğu 0.793 (kare uzaklıkta (N1)60cs payı %99.96)
Standartlaştırılmış: test doğruluğu 0.920
=== 3. k seçimi (5 katlı CV, standartlaştırılmış) ===
k eğitim CV
1 1.000 0.943
3 0.971 0.954
5 0.968 0.951
15 0.951 0.954 ← seçilen
31 0.934 0.929
61 0.921 0.917
121 0.879 0.880
181 0.852 0.860
Seçilen k = 15: test doğruluğu 0.920; karşılaştırma için test: k = 1 → 0.940, k = 181 → 0.840
=== 4. Boyut laneti (500 düzgün nokta, 50 sorgu) ===
En yakın / en uzak uzaklık oranı: d=1: 0.001, d=2: 0.024, d=10: 0.287, d=100: 0.713, d=1000: 0.898
Verinin %1'ini içeren alt küpün kenarı: d=1: 0.01, d=2: 0.10, d=10: 0.63, d=100: 0.95
=== 5. SVM (RBF çekirdek) ===
Izgara araması (9 × 9 aday, 5 katlı CV): C = 1, γ = 0.316, CV doğruluğu 0.963
Izgaranın köşeleri (CV): C=0.1/γ=0.01: 0.611, C=0.1/γ=100: 0.611, C=1000/γ=0.01: 0.951, C=1000/γ=100: 0.880
CV'si en iyiye eşit: C=1/γ=0.316, C=10/γ=0.1, C=31.6/γ=0.0316, C=316/γ=0.01, C=316/γ=1
Test doğruluğu: 0.953
Destek vektörü: 84 / 350 (payın tam üzerinde: 5, α = C sınırında: 79)
Karar fonksiyonu elle, Σ αᵢyᵢ k(xᵢ, x) + b: sklearn ile en büyük fark 1.2e-14
Pay üzerindeki destek vektörlerinde yᵢ f(xᵢ): 1.000 – 1.001
Aşırı esnek SVM (C = 1000, γ = 100): eğitim 1.000, test 0.893, destek vektörü 322
Az uyumlu SVM (C = 0.1, γ = 100) : eğitim 0.611, test 0.607, destek vektörü 335
=== 6. Test kümesinde karşılaştırma (150 vaka) ===
CRR eğrisinin kendisi (CSR > CRR) : 0.973
Lojistik regresyon (doğrusal) : 0.873
k-NN (k = 15) : 0.920
SVM (RBF, C = 1, γ = 0.316) : 0.953
Grafikler kaydedildi: d06_knn_svm_1.png, _2.png, _3.png8. Sonuçları yorumlayın
k-NN: komşu sayısı ve ölçek
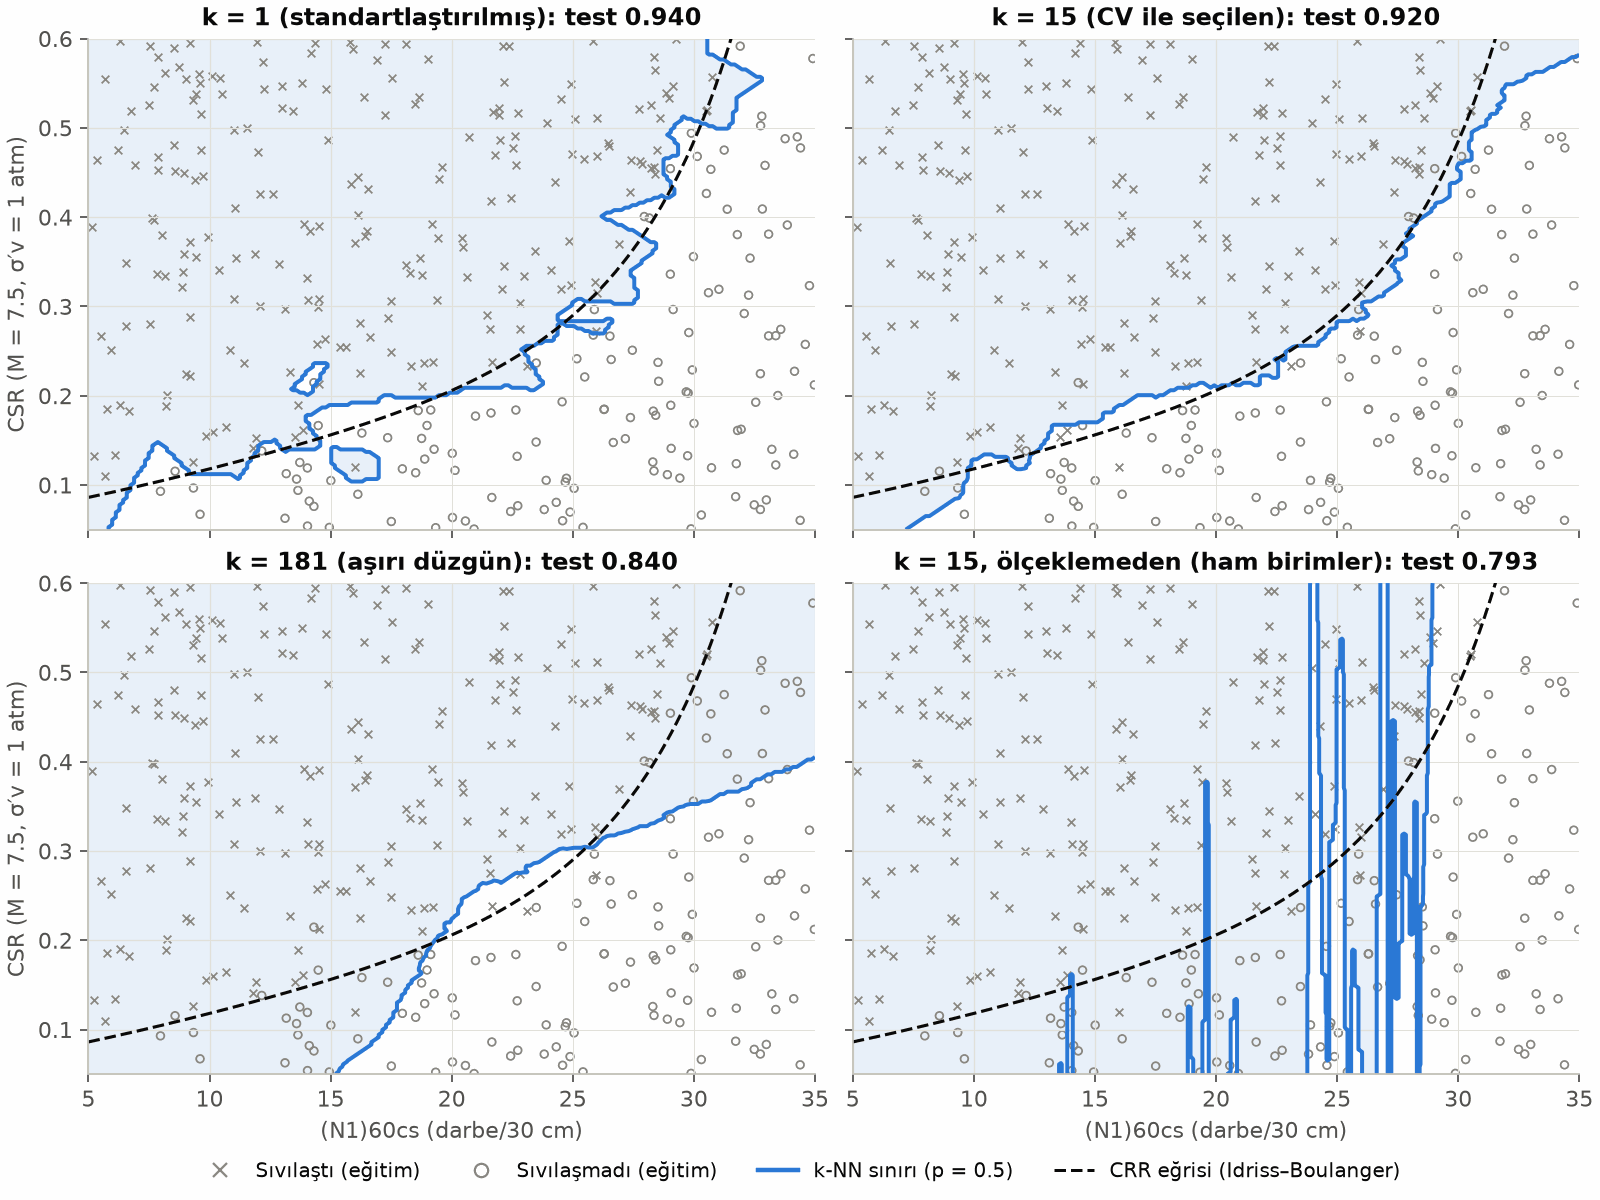
Dört panel bu dersin ilk yarısını özetliyor. $k = 1$ sınırı, gürültülü tek tek vakaların çevresinde adacıklar ve girintiler çiziyor. $k = 15$ sınırı CRR eğrisini yakından izliyor. $k = 181$ ise eğitim verisinin yarısından fazlasını “komşu” sayıyor: sınır eğrinin hızla yükseldiği yüksek darbe bölgesinde basıklaşıyor, düşük darbe ve düşük CSR bölgesinde de sıvılaşmayan vakaları yanlış tarafta bırakıyor. Ölçeklemeden kurulan modelde ise sınır, CSR'yi hiç görmeyen dikey şeritlere dönüşmüş; test doğruluğu 0,793.
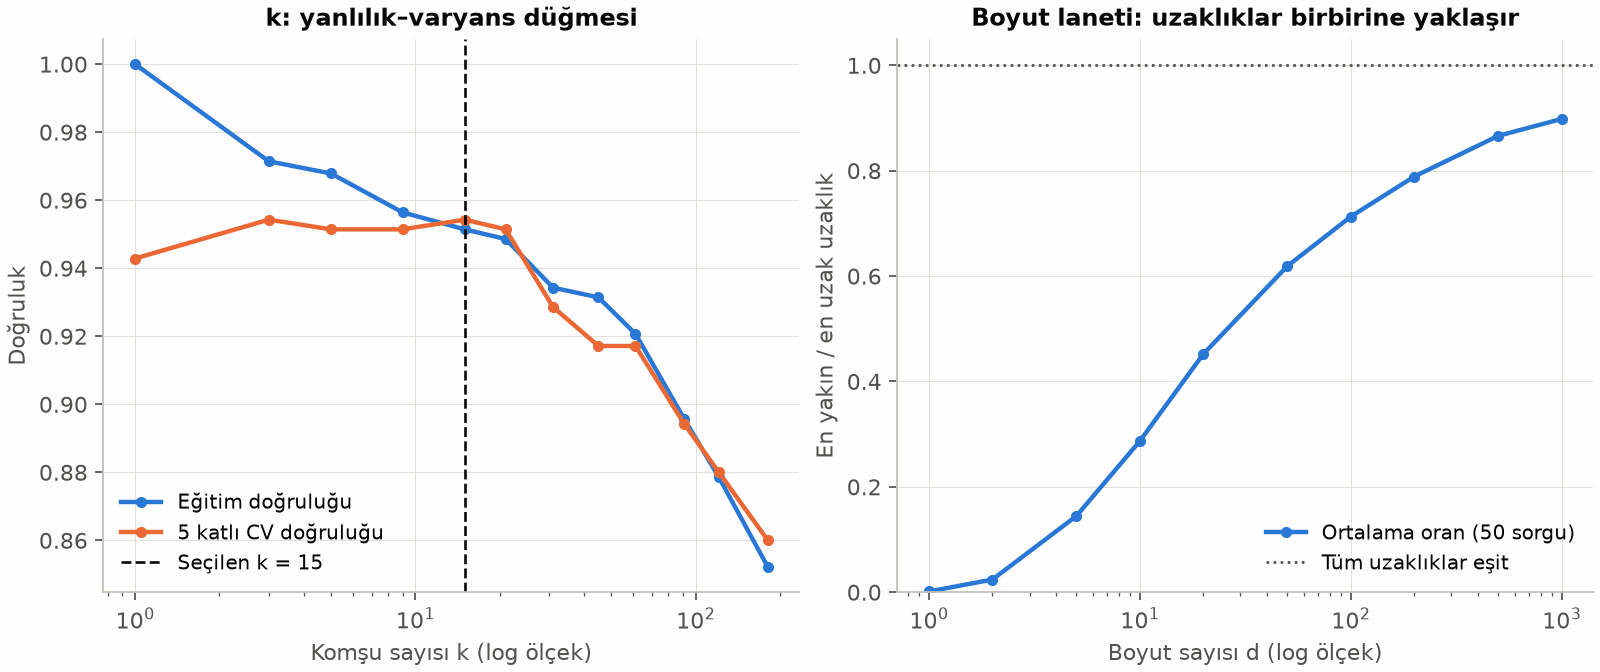
Doğrulama eğrisi, sayısal tabloyu görselleştiriyor. $k = 1$'de eğitim doğruluğu 1,000 iken çapraz doğrulama doğruluğu 0,943; aradaki fark ezberin bedelidir. Çapraz doğrulama doğruluğu $k = 3$ ve $k = 15$'te aynı en yüksek değeri (0,954) alıyor. Bu iki değer 350 vakada aynı sayıda doğru tahmine karşılık geliyor; aradaki 3–21 bölgesinde farklar tek tek vakalardan ibaret. Eşitlikte daha düzgün sınır veren, yani daha basit olan modeli, $k = 15$'i seçtik. $k = 181$'de çapraz doğrulama doğruluğu 0,860'a iniyor; burada sorun artık yanlılıktır.
Test kümesinde ise $k = 1$ (0,940), seçilen $k = 15$'ten (0,920) daha iyi görünüyor. Bu bir çelişki değil, örnekleme gürültüsüdür: fark 3 vaka. 150 vakalık bir test kümesinde doğruluğun standart hatası yaklaşık $\sqrt{0{,}93 \cdot 0{,}07/150} \approx 0{,}02$'dir. $k$'yı test kümesine bakarak seçseydik bu gürültüye uyum sağlamış olurduk; test kümesi yalnızca son ölçüm içindir (Ders 03).
SVM: $C$ ve $\gamma$
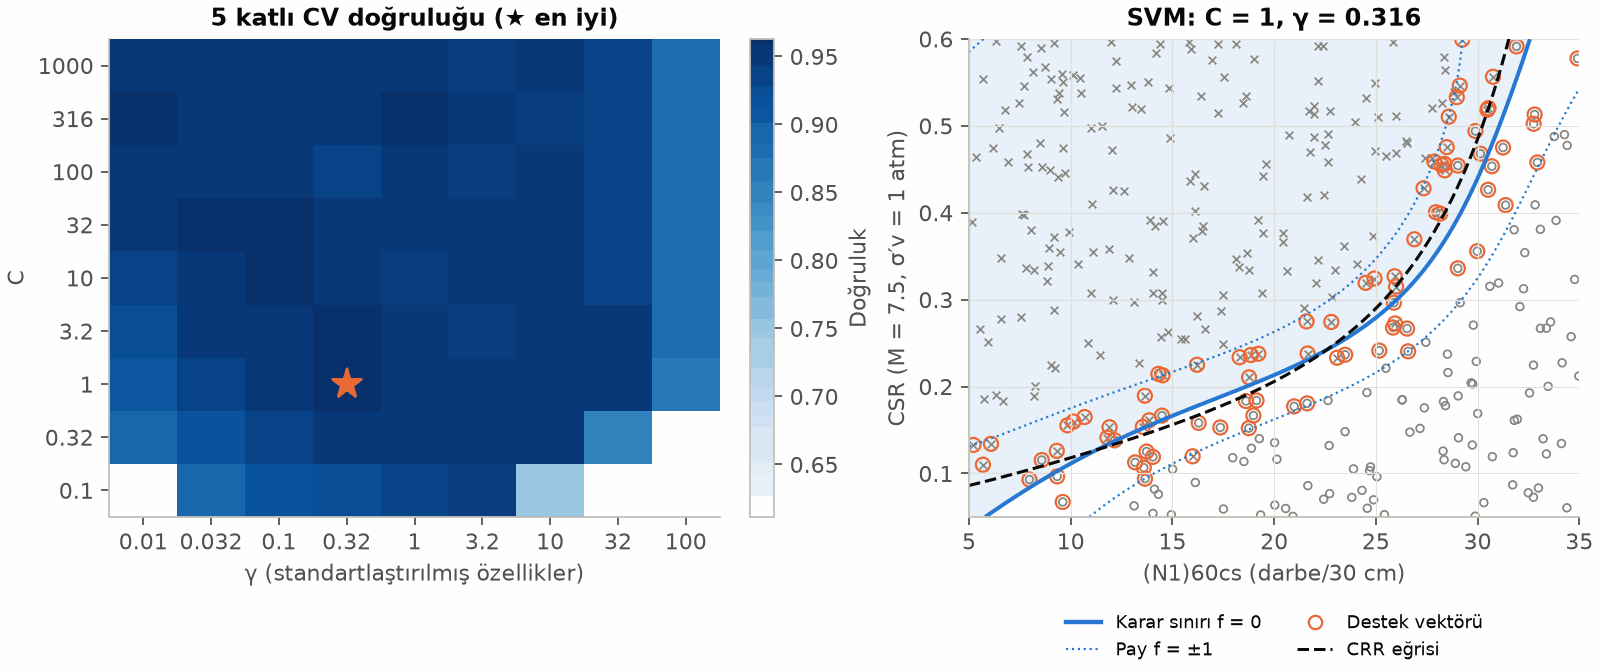
Izgara araması $C$ için 0,1–1000, $\gamma$ için 0,01–100 aralığında, logaritmik aralıklı 9 × 9 = 81 aday denedi. Ölçekleyici, 3. bölümdeki uyarıya uygun olarak boru hattının içinde; her katta yalnız o katın eğitim kısmından öğreniliyor. En iyi çapraz doğrulama doğruluğu 0,963 ve bu değeri beş aday paylaşıyor: ($C = 1$, $\gamma = 0{,}316$), ($C = 10$, $\gamma = 0{,}1$), ($C = 31{,}6$, $\gamma = 0{,}0316$), ($C = 316$, $\gamma = 0{,}01$) ve ($C = 316$, $\gamma = 1$). İlk dördü haritada bir köşegen üzerinde: $C$ büyüdükçe en iyi $\gamma$ küçülüyor. Büyük $C$'nin getirdiği esnekliği küçük $\gamma$'nın getirdiği düzgünlük dengeliyor; iki hiperparametre birbirini telafi ettiği için birlikte aranmalıdır. Beşincisi bu köşegenin dışında; yüksek doğruluk bölgesi geniş ve düz, farklar tek tek vakalardan ibaret. Eşitlikte GridSearchCV ilk adayı, yani en küçük $C$'yi seçti; bu modelin test doğruluğu 0,953.
Isı haritasının köşeleri uç durumları gösteriyor. $C = 0{,}1$ satırının iki ucunda ($\gamma = 0{,}01$ ve $\gamma = 100$) doğruluk 0,611'dir: bu, her vakaya çoğunluk sınıfını, yani “sıvılaştı” diyen modelin doğruluğudur. Çok küçük $\gamma$'da çekirdek o kadar geniştir ki model neredeyse sabit bir fonksiyona dönüşür. Çok büyük $\gamma$'da ise o kadar dardır ki her yeni nokta bütün destek vektörlerinden “uzak” kalır ve $f(\vect x) \approx b$ olur. Küçük $C$'de ihlaller ucuzdur, yani düzenlileştirme güçlüdür; model iki durumda da bu tembel çözümü kabul eder. Ezber tarafında ise $C = 1000$, $\gamma = 100$ köşesi 0,880'de kalıyor: sınır, tek tek noktaların çevresinde kıvrılıyor.
En iyi model 350 eğitim vakasından 84'ünü destek vektörü olarak kullanıyor. Bunların yalnızca 5'i tam pay çizgisinin üzerinde; 79'unun $\alpha_i$'si üst sınır $C$'ye dayanmış. Bunlar pay içine girmiş ya da yanlış tarafta kalmış vakalardır; gürültülü veride bu beklenen bir durumdur. Sağdaki grafikte de destek vektörlerinin hepsi sınırın çevresindeki şeritte toplanıyor; sınırdan uzaktaki vakalar modele hiçbir şey katmıyor.
Aşırı esnek bir SVM ($C = 1000$, $\gamma = 100$) eğitim verisini kusursuz ezberliyor (eğitim doğruluğu 1,000), ama test doğruluğu 0,893'e düşüyor; 350 vakanın 322'si destek vektörü. Çok sayıda destek vektörü ise tek başına aşırı uyum işareti değildir: az uyum köşesindeki model ($C = 0{,}1$, $\gamma = 100$) daha da fazlasını, 335 destek vektörü kullanıyor, ama eğitim doğruluğu yalnızca 0,611 (test 0,607). Aşırı uyumun işareti eğitim ile doğrulama başarısı arasındaki açıktır: aşırı esnek modelde eğitim doğruluğu 1,000, çapraz doğrulama doğruluğu 0,880; az uyumlu modelde ikisi de 0,611.
Eğriyle karşılaştırma
| Sınıflandırıcı | Test doğruluğu |
|---|---|
| CRR eğrisinin kendisi (CSR > CRR) | 0,973 |
| Lojistik regresyon (doğrusal sınır) | 0,873 |
| k-NN ($k = 15$, standartlaştırılmış) | 0,920 |
| SVM (RBF, $C = 1$, $\gamma = 0{,}316$) | 0,953 |
İlk satır bir referanstır: veriyi üreten gürültüsüz sınırın kendisi. Saçılım yüzünden o bile kusursuz değil, ama ortalamada hiçbir model ondan iyi olamaz. Doğrusal lojistik regresyon (0,873) eğri sınırı izleyemiyor; Ders 05'te gördüğümüz gibi doğru özelliklerle bu açığı kapatabilirdi. k-NN (0,920) ve SVM (0,953) hiçbir formül bilmeden eğriye yaklaşıyor. SVM'in sınırı daha düzgün ve sonucu biraz daha iyi; ama aradaki fark testte 5 vaka (150'de), çapraz doğrulamada 3 vaka (350'de; 0,954'e karşı 0,963), yani örnekleme gürültüsü mertebesinde. Şekil 3'te SVM sınırı orta bölgede CRR eğrisini yakından izliyor; alanın kenarlarına, yani en düşük ve en yüksek darbe sayılarına doğru ondan ayrılıyor.
Neden yine de yayımlanmış eğriyi kullanıyoruz?
Yayımlanmış CRR ilişkileri yalnızca veriye uydurulmuş sınırlar değildir. Arkalarında efektif gerilme ve büyüklük düzeltmeleri, laboratuvar deneyleri ve mekanik akıl yürütme vardır; uzmanlarca tartışılmış ve sınanmıştır. Veriden öğrenilen bir sınır ise yalnızca verinin bulunduğu bölgede anlamlıdır: $(N_1)_{60cs} > 35$ için modelimizin söyleyecek hiçbir şeyi yoktur. Buradaki modeller yöntemleri öğrenmek içindir; bir sahanın sıvılaşma değerlendirmesi yayımlanmış yöntemlerle yapılır.
9. Sık yapılan hatalar
- Ölçeklemeden k-NN ya da SVM kullanmak. Büyük sayısal aralıklı özellik uzaklığa hükmeder. Bizim örneğimizde test doğruluğu 0,920'den 0,793'e düştü.
- Ölçekleyiciyi bütün veriye uydurmak. Test verisinin ortalaması ve standart sapması modele sızar. Ölçekleyiciyi modelle birlikte bir
Pipelineiçine koyun. - $C$ ve $\gamma$'yı ayrı ayrı ya da doğrusal bir ızgarada aramak. İkisi birbirini telafi eder; logaritmik aralıklı bir ızgarada birlikte arayın.
- Hiperparametreyi test kümesine bakarak seçmek. $k = 1$ testte daha iyi göründü; seçimi çapraz doğrulamayla yaptığımız için bu gürültüye kanmadık.
- SVM'in karar fonksiyonunu olasılık sanmak. Olasılık gerekiyorsa kalibrasyon yapın.
- Gereksiz özellik eklemek. Uzaklık tabanlı yöntemler ilgisiz özelliklerden çok etkilenir (Alıştırma 6).
10. Alıştırmalar
Alıştırma 1KolayCRR'yi elle hesaplayın
$(N_1)_{60cs} = 15$ olan bir kum tabakası için CRR'yi hesaplayın. Bu tabakada CSR = 0,20 ise güvenlik katsayısı nedir? Veriyi üreten saçılım modeline ($\ln\varepsilon$'un standart sapması 0,15) göre bu vakanın sıvılaşma olasılığı nedir?
Çözümü göster
$\ln \mathrm{CRR}$'deki terimler: $15/14{,}1 = 1{,}0638$; $(15/126)^2 = 0{,}0142$; $(15/23{,}6)^3 = 0{,}2568$; $(15/25{,}4)^4 = 0{,}1216$. Toplamları:
$$ \begin{aligned} \ln\mathrm{CRR} &= 1{,}0638 + 0{,}0142 - 0{,}2568 \\ &\quad + 0{,}1216 - 2{,}8 = -1{,}8571 \end{aligned} $$Dolayısıyla $\mathrm{CRR} = e^{-1{,}8571} = 0{,}156$. Güvenlik katsayısı $FS = 0{,}156/0{,}20 = 0{,}78$, yani 1'den küçük: sıvılaşma beklenir.
Sentetik modelde sıvılaşma $\varepsilon < \mathrm{CSR}/\mathrm{CRR}$ olduğunda olur ($F_N$: standart normal dağılım fonksiyonu):
$$ \begin{aligned} P &= F_N\big(\ln(0{,}20/0{,}1561)/0{,}15\big) \\ &= F_N(1{,}651) \approx 0{,}95 \end{aligned} $$$FS = 0{,}78$ olan bir vaka bu varsayımla yüzde 5 olasılıkla sıvılaşmaz; bu belirsizlik, sınıflar arasındaki örtüşmenin kaynağıdır.
Alıştırma 2KolayÖlçek komşuyu değiştirir
Sorgu vakası $Q = (20;\ 0{,}25)$, eğitimde iki vaka var: $A = (20{,}5;\ 0{,}10)$ sıvılaşmadı, $B = (17;\ 0{,}24)$ sıvılaştı (ilk sayı $(N_1)_{60cs}$, ikincisi CSR). Ham birimlerde ve kodun çıktısındaki standart sapmalarla (8,46 ve 0,164) standartlaştırılmış birimlerde $Q$'ya hangi vaka daha yakındır? 1-NN her durumda ne tahmin eder? CRR eğrisine göre doğru cevap nedir?
Çözümü göster
Ham birimlerde $d(Q, A) = \sqrt{0{,}5^2 + 0{,}15^2}$ $= 0{,}522$ ve $d(Q, B) = \sqrt{3^2 + 0{,}01^2} = 3{,}000$; en yakın vaka $A$, tahmin “sıvılaşmaz”.
Standartlaştırılmış birimlerde $A$ için farklar $0{,}5/8{,}46 = 0{,}059$ ve $0{,}15/0{,}164 = 0{,}915$; $B$ için $3/8{,}46 = 0{,}355$ ve $0{,}01/0{,}164 = 0{,}061$ olur. Uzaklıklar $d(Q, A) = 0{,}917$ ve $d(Q, B) = 0{,}360$; en yakın vaka $B$, tahmin “sıvılaşır”.
Eğriye göre $\mathrm{CRR}(20) = 0{,}206 < 0{,}25$, yani $FS = 0{,}82$: doğru cevap “sıvılaşır”. Ham birimlerde $A$ yakın görünür çünkü CSR'deki 0,15'lik büyük fark, darbe sayısındaki yarım darbelik farkın yanında sayısal olarak küçük kalır. Oysa CSR'deki bu fark, vakayı sınırın öbür tarafına taşıyacak kadar büyüktür.
Alıştırma 3OrtaUzaklık ve ağırlık seçimi
$k = 15$ için KNeighborsClassifier'a (a) weights="distance" (yakın komşunun oyu daha ağır), (b) p=1 (Manhattan uzaklığı), (c) ikisini birden verin. 5 katlı çapraz doğrulama ve test doğruluklarını varsayılan ayarla karşılaştırın. Farklar anlamlı mı?
Çözümü göster
Varsayılan: CV 0,954, test 0,920. (a) CV 0,957, test 0,927. (b) CV 0,954, test 0,927. (c) CV 0,954, test 0,933. Çapraz doğrulamada farklar en fazla 1 vaka (1/350 ≈ 0,003), testte en fazla 2 vakadır (2/150 ≈ 0,013). Bu farklar örnekleme gürültüsünün içindedir. Bu problemde uzaklık türü ve oylama biçimi ikincil kalıyor; ölçekleme ve $k$ çok daha önemli.
Alıştırma 4OrtaMenteşe kaybı ve destek vektörleri
Dört eğitim noktasının fonksiyonel payları $y_i f(\vect x_i)$ = 2,0; 1,0; 0,4 ve −0,5. Her biri için menteşe kaybını ve lojistik kaybı ($\ln(1 + e^{-yf})$) hesaplayın. Hangileri destek vektörü olabilir, hangisi yanlış sınıflandırılmıştır?
Çözümü göster
Menteşe kaybı $\max(0, 1 - yf)$: 0; 0; 0,6; 1,5. Lojistik kayıp: 0,127; 0,313; 0,513; 0,974.
$yf = 2{,}0$ olan nokta payın dışında, güvenle doğru tarafta: menteşe kaybı sıfır, $\alpha = 0$, çözümü etkilemez. $yf = 1{,}0$ tam pay çizgisinde; destek vektörü olabilir ($0 \le \alpha \le C$). $yf = 0{,}4$ payın içinde, $yf = -0{,}5$ ise sınırın yanlış tarafında (yanlış sınıflandırılmış); bu ikisi destek vektörüdür ve $\alpha = C$'dir. Lojistik kayıp ise dört noktada da sıfırdan büyüktür: lojistik regresyonda her nokta sınırı biraz çeker.
Alıştırma 5OrtaÇekirdek, gizli bir iç çarpımdır
İki boyutta $k(\vect x, \vect z) = (1 + \vect x^\top\vect z)^2$ polinom çekirdeği, şu özellik dönüşümünün iç çarpımına eşittir:
$$ \begin{aligned} \phi(\vect x) = \big[\,&1,\ \sqrt2\,x_1,\ \sqrt2\,x_2, \\ &x_1^2,\ \sqrt2\,x_1x_2,\ x_2^2\,\big] \end{aligned} $$Bunu $\vect x = (1, 2)$ ve $\vect z = (3, -1)$ için sayısal olarak doğrulayın.
Çözümü göster
Çekirdek: $\vect x^\top\vect z = 3 - 2 = 1$, $(1 + 1)^2 = 4$. Dönüşüm: $\phi(\vect x)$ = [1; 1,414; 2,828; 1; 2,828; 4] ve $\phi(\vect z)$ = [1; 4,243; −1,414; 9; −4,243; 1]. İç çarpım: $1 + 6 - 4 + 9 - 12 + 4 = 4$. İkisi aynı.
Çekirdek altı boyutlu dönüşümü hiç hesaplamadan aynı sonucu iki boyutlu iç çarpımla verdi. Derece ve boyut arttıkça açık dönüşümün boyutu hızla büyür; RBF çekirdeğinde ise sonsuzdur. Çekirdek hilesinin değeri buradadır.
Alıştırma 6ZorAnlamsız özellikler eklemek
Eğitim ve test verisine, sıvılaşmayla hiçbir ilgisi olmayan 2, 8 ve 20 tane düzgün dağılımlı rastgele sütun ekleyin (örneğin np.random.default_rng(7) ile). Her durumda standartlaştırılmış k-NN ($k = 15$), gamma="scale" ile SVM ($C = 1$) ve $\gamma = 0{,}316$'da sabit tutulan SVM için 5 katlı CV ve test doğruluğunu hesaplayın. Ne gözlüyorsunuz?
Çözümü göster
CV doğrulukları (gürültü sütunu 0 / 2 / 8 / 20): k-NN 0,954 / 0,909 / 0,869 / 0,777; SVM (gamma="scale") 0,957 / 0,934 / 0,897 / 0,900; SVM (sabit $\gamma = 0{,}316$) 0,963 / 0,937 / 0,840 / 0,611. Test doğrulukları: k-NN 0,920 / 0,873 / 0,793 / 0,793; SVM (gamma="scale") 0,953 / 0,907 / 0,873 / 0,833.
Gerçek bilgi taşıyan iki sütun değişmediği hâlde her model kötüleşiyor: ilgisiz boyutlar uzaklığa gürültü ekliyor. k-NN en hızlı bozuluyor. gamma="scale", $\gamma$'yı boyut sayısına göre küçülttüğü için ($1/d$) SVM'i daha dayanıklı kılıyor. $\gamma$'yı iki boyutta bulunan değerde sabit tutmak ise 22 boyutta felakete yol açıyor: uzaklıklar büyüdüğü için bütün çekirdek değerleri sıfıra yaklaşıyor ve model çoğunluk sınıfını tahmin eden bir modele (0,611) dönüşüyor. Ders: hiperparametreler veriyle birlikte değişir; özellik kümesi değişince yeniden arayın.
Özet
- k-NN tahmini en yakın $k$ komşunun oyuyla yapar; eğitim yoktur, maliyet tahmindedir. $k$ bir yanlılık–varyans düğmesidir ve çapraz doğrulamayla seçilir.
- Uzaklık tabanlı yöntemlerde ölçekleme zorunludur: ham birimlerde uzaklığın yüzde 99,96'sını darbe sayısı belirledi ve test doğruluğu 0,920'den 0,793'e düştü.
- Boyut arttıkça en yakın ve en uzak komşu uzaklıkları birbirine yaklaşır; ilgisiz özellikler k-NN'i hızla bozar.
- SVM, en geniş payı arar; yumuşak pay, menteşe kaybı artı L2 düzenlileştirmesidir. Çözümü yalnızca destek vektörleri belirler ve çekirdek hilesi doğrusal olmayan sınırlar çizmesini sağlar.
- RBF çekirdeğinde $C$ ve $\gamma$ birbirini telafi eder; birlikte, logaritmik bir ızgarada aranmalıdır.
Sonraki derste uzaklıkla hiç ilgilenmeyen, veriyi eksenlere paralel sorularla bölen bir yöntemi göreceğiz: karar ağaçları. Ölçekleme gerektirmezler ve okunabilir kurallar üretirler; ama kendi zayıflıkları vardır.
Kaynaklar
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 2.5 (boyut laneti), 12 (destek vektör makineleri) ve 13 (en yakın komşu yöntemleri).
- T. M. Cover, P. E. Hart (1967). Nearest neighbor pattern classification. IEEE Transactions on Information Theory, 13(1), 21–27.
- C. Cortes, V. Vapnik (1995). Support-vector networks. Machine Learning, 20(3), 273–297.
- I. M. Idriss, R. W. Boulanger (2008). Soil Liquefaction During Earthquakes. EERI monografı (dersteki CRR ilişkisinin kaynağı).
- scikit-learn belgeleri: Nearest Neighbors ve Support Vector Machines.