Bu derste öğrenecekleriniz
- Makine öğrenmesinin ne zaman uygun, ne zaman gereksiz olduğunu ayırt etmek
- Öğrenme türlerini ve bir projenin adımlarını mühendislik örnekleriyle tanımak
- Eğitim, doğrulama ve test verisinin rolünü; rastgele, zamana göre ve gruplu bölmeyi açıklamak
- Aşırı uyumu ve veri sızıntısını tanımak; tahmin anı kavramını kullanmak
- MAE, RMSE ve R²'yi hesaplamak ve her modeli bir referans modelle karşılaştırmak
- Python ortamını kurup kursun betiklerini çalıştırmak
1. Makine öğrenmesi nedir?
Klasik mühendislik hesabında kuralı biz yazarız: momenti mukavemet momentine böler, gerilmeyi buluruz. Makine öğrenmesinde ise kuralı vermeyiz; girdileri ve onlara karşılık gelen çıktıları içeren örnekler veririz. Algoritma, bu örneklerden girdiyi çıktıya bağlayan bir fonksiyon $\hat f$ öğrenir ve onu daha önce görmediği girdilere uygular.
Beton dayanımı iyi bir örnektir. Abrams 1918'de su/çimento oranıyla dayanım arasındaki ilişkiyi deneylerden çıkardı; bugün de dayanımın büyük kısmını bu oranla açıklarız. Ama günümüz karışımlarında cüruf, uçucu kül, katkı maddeleri, farklı çimento tipleri ve farklı yaşlar vardır. Değişken sayısı artınca ilişkinin biçimini elle bulmak zorlaşır. Elinizde binlerce küp deneyi varsa, makine öğrenmesi bu ilişkiyi sizin yerinize, veriden kurmanın sistematik bir yoludur.
Kısaca: veri kümesi $\{(\vect x_i, y_i)\}_{i=1}^{n}$ verildiğinde, aynı kaynaktan gelecek yeni bir $\vect x$ için $\hat f(\vect x) \approx y$ olacak bir $\hat f$ aramak. “Yeni” sözcüğü işin özüdür: eğitim örneklerini ezberlemek kolaydır, asıl soru modelin görmediği örneklerde ne yaptığıdır. Bu dersin büyük kısmı, bunu dürüstçe nasıl ölçeceğimizle ilgili.
Ne zaman makine öğrenmesi kullanmamalı?
Güvenilir bir fiziksel formül ya da yönetmelik kontrolü varsa onu kullanın. Bir kirişin eğilme gerilmesi, bir kolonun burkulma kontrolü ya da bir bağlantının taşıma kapasitesi için veriden model eğitmek hem gereksizdir hem de daha az güvenilirdir. Makine öğrenmesi yönetmelik hesabının yerine geçmez. Şu durumlarda ise gerçekten işe yarar:
- Pahalı hesaplar: binlerce kez tekrarlanması gereken bir sonlu eleman analizinin yerine hızlı bir vekil model (surrogate) koymak (Proje 3, Proje 5).
- Bilinmeyen ya da çok değişkenli ilişkiler: karışım tasarımından dayanım, CPT ölçümlerinden zemin sınıfı.
- Algılama görevleri: görüntüden çatlak tespiti gibi kuralını yazmanın neredeyse imkânsız olduğu işler (Ders 13).
Her durumda modelin yalnız eğitildiği veri aralığında anlamlı olduğunu ve sonucunun mühendislik muhakemesiyle denetlenmesi gerektiğini unutmayın.
2. Öğrenme türleri
Elimizdeki verinin türüne ve istediğimiz cevaba göre öğrenme problemleri birkaç gruba ayrılır. Kursun büyük kısmı denetimli öğrenme (supervised learning) ile ilgilidir: her örneğin doğru cevabı (etiketi) bilinir.
| Tür | Veri | Mühendislik örneği | Kursta |
|---|---|---|---|
| Denetimli: regresyon | $\vect x$ ve sayısal $y$ | beton dayanımı, kiriş sehimi, yapı tepkisi | Ders 02–04, 07–08, 12, 14–16 |
| Denetimli: sınıflandırma | $\vect x$ ve sınıf etiketi | burkulur / burkulmaz, çatlak var / yok | Ders 05–06, 13 |
| Denetimsiz: kümeleme | yalnız $\vect x$ | CPT verisinden zemin tabakaları | Ders 09 |
| Denetimsiz: boyut indirgeme | yalnız $\vect x$ | titreşim ölçümlerinden mod şekilleri | Ders 10 |
Denetimsiz öğrenmede (unsupervised learning) etiket yoktur; amaç verinin içindeki yapıyı, grupları ya da az sayıda değişkenle özetlenebilecek yönleri bulmaktır. Pekiştirmeli öğrenmede (reinforcement learning) ise sabit bir veri kümesi yoktur: bir ajan bir ortamda eylemler seçer, her eylemin sonucunda bir ödül ya da ceza alır ve zamanla toplam ödülü en büyük yapan davranışı öğrenir. Aktif titreşim kontrolü veya bina enerji yönetimi bu türe örnektir; çok sayıda deneme ve genellikle bir benzetim ortamı gerektirdiği için bu kursun kapsamı dışında kalıyor. Son olarak kendi kendine denetimli öğrenmede (self-supervised learning) etiketler verinin kendisinden üretilir; örneğin bir sinyalin ya da metnin gizlenen parçasını tahmin etmek, büyük dil ve görüntü modellerinin temelidir.
3. Bir projenin adımları
Algoritma seçimi, bir makine öğrenmesi projesinin çoğu zaman en kolay adımıdır ve sanıldığından geç gelir. Sıra şöyledir:
- Problemi ve tahmin anını tanımlayın. Neyi, kimin için, hangi anda tahmin ediyoruz? O anda hangi bilgiler elde olacak? Hangi hata kabul edilebilir: 1 MPa mı, 5 MPa mı? Ölçütü baştan seçin.
- Veriyi toplayın ve inceleyin. Kaynak, birimler, eksik değerler, aykırı değerler, ölçüm yöntemi. Grafik çizmeden model kurmayın.
- Bir referans (baseline) kurun. Akla gelen en basit tahmin: eğitim ortalaması, zaman serisinde son bilinen değer ya da bilinen bir mühendislik formülü.
- Modeli eğitin. Parametreler yalnız eğitim verisinden öğrenilir.
- Doğrulayın. Model türünü, özellikleri ve hiperparametreleri doğrulama verisiyle ya da çapraz doğrulamayla seçin (Ders 03).
- Son testi bir kez yapın. Bütün kararlar bittikten sonra, hiç dokunulmamış test verisinde ölçün ve referansla birlikte raporlayın.
- Kullanıma alın ve izleyin. Yeni bir çimento tipi, başka bir santral, farklı bir iklim veriyi değiştirir. Modelin geçerlilik aralığını yazın, tahmin hatalarını izleyin, gerekirse yeniden eğitin (Ders 17).
Birinci adımdaki tahmin anı kavramı, bu dersin en önemli fikirlerinden biridir; veri sızıntısını anlamanın anahtarı odur (7. bölüm).
4. Özellik, hedef, X ve y
Tahmin etmek istediğimiz büyüklük hedeftir (target): burada küpün basınç dayanımı. Tahmin için kullandığımız girdiler özelliklerdir (feature): çimento, cüruf, uçucu kül, su ve süperakışkanlaştırıcı miktarları (kg/m³) ile numunenin yaşı (gün). Kodda özellik matrisi X, hedef dizisi y olarak adlandırılır. Bir satır bir gözlemi, bir sütun bir özelliği temsil eder; şekiller (n, p) ve (n,)'dir (Hazırlık 1).
Sayısal bir değeri tahmin etmek regresyondur; “hasarlı / sağlam” gibi bir sınıfı tahmin etmek sınıflandırmadır. Model, parametreleri $\theta$ olan bir fonksiyondur: $\hat y = f(\vect x; \theta)$. Parametreler (doğrusal modelin katsayıları gibi) eğitimde veriden öğrenilir. Hiperparametreler ise (bir ağacın derinliği, düzenlileştirme katsayısı gibi) eğitimden önce bizim seçtiğimiz ayarlardır ve doğrulama verisiyle belirlenir.
Model verideki ilişkileri öğrenir; nedensellik kanıtlamaz. Su miktarıyla dayanım arasında güçlü bir ilişki bulmak, tek başına suyun dayanımı nasıl etkilediğini göstermez. Bu örnekte nedenselliği malzeme biliminden biliyoruz; ama veride birlikte değişen iki büyüklük her zaman neden–sonuç ilişkisinde değildir.
5. Veri rolleri: eğitim, doğrulama ve test
Modeli eğittiğimiz veriyle değerlendirirsek, ezberleyen bir model de mükemmel görünür. Bu yüzden veri üç role ayrılır:
| Rol | Ne için kullanılır? | Ne zaman bakılır? |
|---|---|---|
| Eğitim | Modelin parametrelerini (katsayıları, ağaçları, ağırlıkları) öğrenmek | Her eğitimde |
| Doğrulama | Seçim yapmak: model türü, polinom derecesi, ağaç sayısı, özellikler | Seçim yapılırken, defalarca |
| Test | Bütün kararlar bittikten sonra son ve tarafsız değerlendirme | Bir kez, en sonda |
Test skoruna bakarak modeli sürekli değiştirmek, test verisini de seçim verisine dönüştürür ve raporlanan hata iyimser olur. Veri azsa ayrı bir doğrulama kümesi yerine eğitim verisi üzerinde çapraz doğrulama yapılır; bunu Ders 03'te göreceğiz. Bu derste hiperparametre seçmediğimiz için yalnız eğitim ve test kullanıyoruz.
Veri nasıl bölünür?
- Rastgele bölme. Örnekler birbirinden bağımsızsa (her satır ayrı bir karışım) veriyi karıştırıp ayırmak yeterlidir. Betikte
train_test_split(..., test_size=0.25, random_state=42)ile 300 eğitim, 100 test satırı ayırdık. - Zamana göre bölme. Zaman serisinde geçmişle eğitip gelecekle sınayın. Karıştırırsanız model “yarını” görerek “bugünü” tahmin eder; gerçek kullanımda bu bilgi yoktur (Proje 2).
- Gruplu bölme. Örnekler gruplar hâlinde birbirine bağlıysa (aynı karışımdan alınan üç küp, aynı yapının farklı katlarındaki sensörler) bir grubun bütün örnekleri aynı tarafta kalmalıdır. Aksi hâlde model, test örneğinin “kardeşini” eğitimde görmüş olur. Alıştırma 5'te bunun etkisini sayıyla göreceksiniz.
6. Aşırı uyum ve az uyum
Aşırı uyum (overfitting), modelin eğitim verisindeki gürültüyü de öğrenip yeni örneklerde kötüleşmesidir; belirtisi, eğitim hatasının test hatasından çok küçük olmasıdır. Az uyum (underfitting) ise modelin ilişkiyi yakalayamayacak kadar basit olmasıdır; hem eğitim hem test hatası yüksektir.
Betikte iki uç örnek var. Derinliği sınırsız bir karar ağacı, her eğitim örneğini kendi yaprağına koyabilir: eğitim hatası tam sıfır (MAE = 0,00 MPa, R² = 1,000), ama test MAE'si 5,90 MPa ve doğrusal modelin 4,34 MPa'sından kötü. Doğrusal regresyonda ise eğitim ve test hataları birbirine yakın (4,05 ve 4,34 MPa); bu model ezberlemiyor, ama yaşın doğrusal olmayan etkisini de yakalayamıyor (11. bölümde artıklarda göreceğiz). Yani hafif bir az uyum içinde. Eğitim ve test ayrımı aşırı uyumu engellemez; onu ölçmemizi sağlar. Model karmaşıklığını ayarlamayı Ders 03'te, düzenlileştirmeyi Ders 04'te göreceğiz.
7. Veri sızıntısı
Veri sızıntısı (data leakage), tahmin anında elde olmayacak bir bilginin eğitime ya da değerlendirmeye karışmasıdır. Sonuç her zaman aynıdır: test skoru gerçekte olduğundan iyi görünür, model kullanıma alınınca beklenen başarıyı göstermez. Üç yaygın biçimi vardır.
Hedef sızıntısı
Bir özellik hedeften türetilmişse ya da hedefle aynı anda veya ondan sonra ölçülüyorsa model, cevabı soru içinde bulur. Betikte bunu bilerek yaptık: özelliklere küpün kırılma yükünü ekledik. Kırılma yükü, 150 mm'lik küp yüzeyi (22.500 mm²) ile dayanımın çarpımıdır; ölçü ve okuma sapmasını temsil etmek için yüzde 2'lik bir gürültü ekledik. Dayanımla korelasyonu 0,9967. Doğrusal model bu özellikle test kümesinde MAE = 0,57 MPa ve R² = 0,994'e ulaşıyor.
Bu sonuç neden değersiz? Çünkü dayanımı tahmin etmek istediğimiz an, karışım tasarlanırken ya da beton dökülürken, küp henüz kırılmamıştır. Kırılma yükü elimizde olduğunda dayanım da elimizdedir; model hiçbir şey öğretmez. Sonucun gerçek olamayacağını sayılardan da görebiliriz. Üreteç, dayanımı yüzde 7'lik bir ölçüm saçılmasıyla bozuyor; karışım ile dayanım arasındaki gerçek ilişkiyi tam olarak bilen bir model bile bu saçılmayı öngöremez. Betik bu gürültü tabanını test kümesi için MAE ≈ 2,06 MPa olarak hesaplıyor. Sızıntılı modelin 0,57 MPa'lık hatası bu tabanın çok altında; bu ancak model ölçüm gürültüsünün kendisini, yani hedefi gördüğünde mümkündür.
Fazla iyi sonuç bir alarmdır
Bir model, ölçümün kendi tekrarlanabilirliğinden daha küçük hata veriyorsa ya da beklenmedik biçimde tek bir özellik bütün işi yapıyorsa, önce sızıntıyı arayın. Her özellik için şunu sorun: “Tahmin anında bu değer elimde olacak mı?”
Aynı özellik, tahmin anına göre meşru da olabilir. 7 günlük dayanım, 28 günlük dayanımı karışım tasarımı sırasında tahmin etmek için bir sızıntıdır; ama tahmini 7. günde yapıyorsanız son derece değerli ve meşru bir özelliktir. Sızıntı, verinin değil, soru ile verinin bir özelliğidir.
Ön işlem sızıntısı
Ölçekleyiciyi, eksik değer doldurucuyu ya da özellik seçimini bütün veri üzerinde öğrenip sonra veriyi bölmek, test kümesinin istatistiklerini eğitime taşır. Doğru sıra önce bölmek, sonra ön işlemleri yalnız eğitim verisinde öğrenip test verisine aynen uygulamaktır. scikit-learn'ün Pipeline nesnesi bunu kendiliğinden yapar:
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge

model = make_pipeline(StandardScaler(), Ridge(alpha=1.0))
model.fit(X_egitim, y_egitim)        # ölçekleyici yalnız eğitim verisinden öğrenir
tahmin = model.predict(X_test)       # test verisine aynı ortalama ve sapma uygulanır
Ölçeklemede bu hatanın etkisi çoğu zaman küçüktür; özellik seçimi veya hedefe dayalı kodlama gibi işlemlerde ise sonuçları tamamen yanıltabilir. Kural, etkinin büyüklüğünden bağımsızdır.
Bölme sızıntısı
Zaman serisini karıştırarak bölmek ya da aynı gruba ait örnekleri eğitim ve teste dağıtmak da sızıntıdır (5. bölüm). Bu tür sızıntı, kodda hiçbir hata olmadan oluşur; yalnız verinin nasıl toplandığını bilen biri fark edebilir.
8. Başarıyı ölçmek: MAE, RMSE, R² ve referans model
Regresyonda en sık kullanılan üç ölçüt, $n$ test örneği ve $\hat y_i$ tahminleri için şöyledir:
$$ \mathrm{MAE} = \frac{1}{n}\sum_{i=1}^{n} |y_i - \hat y_i| $$ $$ \mathrm{RMSE} = \sqrt{\frac{1}{n}\sum_{i=1}^{n} (y_i - \hat y_i)^2} $$ $$ R^2 = 1 - \frac{\sum_i (y_i - \hat y_i)^2}{\sum_i (y_i - \bar y)^2} $$- MAE (ortalama mutlak hata) hedefle aynı birimdedir (burada MPa) ve doğrudan yorumlanır: “tahminler ortalamada 4 MPa şaşıyor”.
- RMSE (karekök ortalama kare hata) da aynı birimdedir, ama büyük hataları kareleri yüzünden daha çok cezalandırır. Her zaman $\mathrm{RMSE} \ge \mathrm{MAE}$'dir; ikisi arasındaki fark büyüdükçe hatalar arasında birkaç büyük sapma var demektir.
- R² (belirlilik katsayısı) modelin kare hatasını, her örnek için test ortalamasını tahmin eden bir modelinkiyle karşılaştırır. 1 kusursuzdur; 0, ortalamadan iyi olmamak demektir; negatif de olabilir. Bir “doğruluk yüzdesi” değildir.
def mae(y, y_tahmin):
    return np.mean(np.abs(y - y_tahmin))

def rmse(y, y_tahmin):
    return np.sqrt(np.mean((y - y_tahmin) ** 2))

def r2(y, y_tahmin):
    return 1 - np.sum((y - y_tahmin) ** 2) / np.sum((y - np.mean(y)) ** 2)
Betik, bu üç fonksiyonun scikit-learn'ün mean_absolute_error, root_mean_squared_error ve r2_score fonksiyonlarıyla aynı sonucu verdiğini doğruluyor. Ölçütleri hesaplayan fonksiyonun başında bir şekil kontrolü de var; Hazırlık 1'deki (n,) − (n, 1) hatasını hatırlayın.
Her zaman bir referans raporlayın
Tek başına “MAE = 4,34 MPa” iyi mi kötü mü? Bunu ancak bir karşılaştırma söyler. En basit referans, her numune için eğitim verisinin ortalamasını tahmin etmektir: burada 37,82 MPa. Bu referansın test MAE'si 8,24 MPa, R²'si $-0{,}009$. R²'nin biraz negatif çıkması doğaldır: R² test ortalamasına göre hesaplanır, referans ise eğitim ortalamasını kullanır. Zaman serisinde referans, son bilinen değerdir; bir mühendislik probleminde ise bilinen bir formül (örneğin yalnız su/bağlayıcı oranına dayanan Abrams yasası) çok daha güçlü bir referanstır. Model referansı geçemiyorsa bunu olduğu gibi raporlayın.
9. Çalışma ortamını kurun
Kursun betikleri bilgisayarınızda, Python 3.12 ile çalışır. Paketlerin sürümleri requirements.txt (Hazırlık, Başlangıç ve Orta seviye) ve requirements-derin.txt (PyTorch kullanan İleri seviye dersleri) dosyalarında sabitlenmiştir. Kurs bu sürümlerle sınandı; daha yeni sürümlerde de büyük olasılıkla çalışır, ama sayıların son basamakları farklı çıkabilir. İlk kurulum paketleri internetten indirir; betikler daha sonra internete bağlanmaz ve dış veri indirmez, verilerini kendileri üretir.
- Python 3.12'yi kurun: Windows ve macOS için python.org'daki yükleyici, Linux'ta dağıtımınızın paket yöneticisi. Kontrol:
python --version(macOS/Linux'tapython3 --version). - Boş bir klasör oluşturun ve iki requirements dosyasını ve derslerin “Python kodunu indir” düğmesiyle indirdiğiniz betikleri bu klasöre koyun.
- Terminali bu klasörde açın ve aşağıdaki komutlarla bir sanal ortam (
venv) kurun. Sanal ortam, kursun paketlerini bilgisayarınızdaki diğer Python projelerinden ayırır.
Windows (PowerShell veya komut istemi)
py -3.12 -m venv .venv
.venv\Scripts\python -m pip install --upgrade pip
.venv\Scripts\python -m pip install -r requirements.txt
.venv\Scripts\python d01_ilk_model.py
macOS / Linux
python3.12 -m venv .venv
.venv/bin/python -m pip install --upgrade pip
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python d01_ilk_model.py
Komutlar sanal ortamın Python'unu doğrudan yolu ile çağırır; böylece ortamı “etkinleştirmeniz” gerekmez. Etkinleştirmek isterseniz Windows'ta .venv\Scripts\activate (PowerShell'in betik çalıştırma ilkesi bunu engellerse yukarıdaki tam yollu komutları kullanın), macOS/Linux'ta source .venv/bin/activate yazın; ardından yalnız python d01_ilk_model.py yeterlidir. Başka bir betiği çalıştırmak için son satırdaki dosya adını değiştirin. Her betik sayıları terminale yazar ve grafiklerini PNG olarak aynı klasöre kaydeder.
İleri seviye: PyTorch
PyTorch kullanan derslerde (Ders 12–14, Ders 16 ve Proje 5) ek paketler gerekir. Aynı ortamda python -m pip install -r requirements-derin.txt komutunu çalıştırın; dosya önce temel listeyi, sonra PyTorch'u kurar. Linux'ta PyPI'daki varsayılan PyTorch paketi GPU (CUDA) kitaplıklarını da indirdiği için çok büyüktür. Kurstaki bütün betikler işlemcide (CPU) çalışacak biçimde yazıldı; yalnız CPU sürümünü kurmak için önce şu komutu, sonra requirements-derin.txt'yi çalıştırın:
.venv/bin/python -m pip install torch==2.14.1 --index-url https://download.pytorch.org/whl/cpu
.venv/bin/python -m pip install -r requirements-derin.txtVS Code ile hücre hücre çalıştırmak
Betiklerdeki # %% satırları kodu hücrelere böler. VS Code'da Python ve Jupyter eklentileri kuruluysa her hücrenin üstünde “Run Cell” bağlantısı görünür; hücre etkileşimli bir pencerede çalışır ve değişkenler bellekte kalır. Böylece betiği bölüm bölüm çalıştırıp ara sonuçlara bakabilirsiniz. Önce sağ alttaki yorumlayıcı seçiminden .venv ortamını seçin. Spyder da aynı # %% işaretlerini tanır.
10. İlk model: çalıştırılabilir kod
Betik baştan sona küçük bir iş akışıdır: 400 karışımlık sentetik veriyi üretir, yüzde 75'ini eğitime, yüzde 25'ini teste ayırır; referans modeli, doğrusal regresyonu ve sınırsız bir karar ağacını değerlendirir; son olarak kırılma yükü özelliğiyle sızıntıyı gösterir. Veri, kursun ortak beton_verisi fonksiyonuyla üretilir: Abrams yasası ve yaşa bağlı dayanım artışı katsayısı üzerine yüzde 7'lik log-normal saçılma. Gerçek deney verisi değildir. Betik birkaç saniyede biter.
"""Ders 01 — Makine öğrenmesine giriş: ilk model.

Beton karışımından basınç dayanımını tahmin eden küçük ama eksiksiz bir iş akışı:
veriyi eğitim ve test olarak ayırmak, referans (baseline) model kurmak, doğrusal regresyon
eğitmek, MAE / RMSE / R² ölçütlerini sıfırdan hesaplamak, ezberleyen bir modeli görmek ve
hedef sızıntısının (target leakage) ne kadar parlak ama değersiz bir sonuç verdiğini göstermek.

Veri sentetiktir: kursun ortak beton_verisi fonksiyonu Abrams yasası ve yaş katsayısıyla
400 karışım üretir. "Kırılma yükü" özelliği, sızıntıyı göstermek için dayanımdan türetilir.
Gerçek deney verisi değildir.

Çalıştır:  python d01_ilk_model.py
Gerekenler: numpy, pandas, scikit-learn, matplotlib  (Python 3.12+)
Çıktılar:  terminale sayılar, aynı klasöre iki PNG grafiği
"""
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")  # pencere açmadan dosyaya çiz
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score, root_mean_squared_error
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor

# --- Grafik stili (kurs genelinde aynı) ---
RENK = ["#2a78d6", "#eb6834", "#1baf7a", "#eda100", "#e87ba4", "#008300", "#6250d6", "#e34948"]
MUREKKEP, IKINCIL, SOLUK = "#0b0b0b", "#52514e", "#898781"
plt.rcParams.update({
    "figure.facecolor": "white", "axes.facecolor": "white", "savefig.facecolor": "white",
    "axes.edgecolor": "#c3c2b7", "axes.labelcolor": IKINCIL, "axes.titlecolor": MUREKKEP,
    "axes.titlesize": 11, "axes.titleweight": "bold", "axes.labelsize": 10,
    "xtick.color": IKINCIL, "ytick.color": IKINCIL, "font.size": 10,
    "axes.grid": True, "grid.color": "#e1e0d9", "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.prop_cycle": plt.cycler(color=RENK), "lines.linewidth": 2, "legend.frameon": False,
})
KLASOR = Path(__file__).resolve().parent


def beton_verisi(n, rng, eksik_oran=0.0):
    """Sentetik beton karışımı verisi (eğitim amaçlı; gerçek deney verisi değildir).

    Dayanım, Abrams yasası (f = 96,5 / 7^(s/b) MPa) ve EN 1992-1-1'deki yaş katsayısı
    β_cc(t) = exp(s·(1 − √(28/t))) ile üretilir; s/b oranında cüruf ve uçucu kül, EN 206'daki
    k-değeri kavramına benzer biçimde 0,6 ve 0,4 etkinlikle bağlayıcıya katılır.
    """
    cimento = rng.uniform(250, 500, n)                                   # kg/m³
    curuf = np.where(rng.random(n) < 0.4, rng.uniform(20, 200, n), 0.0)  # kg/m³
    ucucu_kul = np.where(rng.random(n) < 0.3, rng.uniform(20, 150, n), 0.0)
    su = rng.uniform(150, 210, n)                                        # kg/m³
    super_akiskan = np.where(rng.random(n) < 0.6, rng.uniform(2, 12, n), 0.0)
    iri_agrega = rng.uniform(850, 1100, n)
    ince_agrega = rng.uniform(650, 900, n)
    yas_gun = rng.choice([3, 7, 14, 28, 56, 90], n, p=[.12, .2, .13, .3, .13, .12])
    tipler = np.array(["CEM I 42,5 R", "CEM II/A-LL 42,5 N", "CEM III/A 32,5 N"])
    tip_no = rng.choice(3, n, p=[.45, .35, .20])
    s_katsayi = np.array([0.20, 0.25, 0.38])[tip_no]      # EN 1992-1-1, Bağıntı 3.2: R, N, S sınıfı
    sinif_carpani = np.array([1.00, 0.97, 0.88])[tip_no]  # varsayım: dayanım sınıfı etkisi
    kalip_no = rng.integers(1, 21, n)                    # ilgisiz özellik
    ortam_sicakligi = rng.uniform(5, 30, n)              # ilgisiz özellik (bu üreticide)

    sb = su / (cimento + 0.6 * curuf + 0.4 * ucucu_kul)  # su / etkin bağlayıcı
    f28 = 96.5 / 7.0 ** sb * sinif_carpani + 0.25 * super_akiskan
    beta = np.exp(s_katsayi * (1 - np.sqrt(28 / yas_gun)))
    dayanim = f28 * beta * rng.lognormal(0.0, 0.07, n)

    df = pd.DataFrame({
        "cimento": cimento, "curuf": curuf, "ucucu_kul": ucucu_kul, "su": su,
        "super_akiskan": super_akiskan, "iri_agrega": iri_agrega, "ince_agrega": ince_agrega,
        "yas_gun": yas_gun, "cimento_tipi": tipler[tip_no], "kalip_no": kalip_no,
        "ortam_sicakligi": ortam_sicakligi, "dayanim_mpa": dayanim,
    })
    if eksik_oran > 0:
        df.loc[rng.random(n) < eksik_oran, "super_akiskan"] = np.nan
    return df


# --- Hata ölçütleri, sıfırdan (bütün bölümlerde kullanılır) ---
def mae(y, y_tahmin):
    return np.mean(np.abs(y - y_tahmin))


def rmse(y, y_tahmin):
    return np.sqrt(np.mean((y - y_tahmin) ** 2))


def r2(y, y_tahmin):
    return 1 - np.sum((y - y_tahmin) ** 2) / np.sum((y - np.mean(y)) ** 2)


def olc(y, y_tahmin):
    assert y.shape == y_tahmin.shape, "şekiller farklı: yayınlama hatası olabilir"
    return mae(y, y_tahmin), rmse(y, y_tahmin), r2(y, y_tahmin)


def yaz(ad, y, y_tahmin):
    m, r, d = olc(y, y_tahmin)
    print(f"{ad}: MAE = {m:.2f} MPa, RMSE = {r:.2f} MPa, R² = {d:.3f}")
    return m, r, d


# %% 1. Veri: özellikler (X), hedef (y) ve eğitim/test ayrımı
rng = np.random.default_rng(42)
df = beton_verisi(400, rng)
OZELLIKLER = ["cimento", "curuf", "ucucu_kul", "su", "super_akiskan", "yas_gun"]
X = df[OZELLIKLER].to_numpy()          # (400, 6): karışım bileşenleri (kg/m³) ve yaş (gün)
y = df["dayanim_mpa"].to_numpy()       # (400,): küp basınç dayanımı (MPa)
X_egitim, X_test, y_egitim, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
print("=== 1. Veri ===")
print(f"{len(df)} karışım (sentetik), {X.shape[1]} özellik: {', '.join(OZELLIKLER)}")
print(f"Eğitim: {len(y_egitim)} satır, test: {len(y_test)} satır; "
      f"dayanım aralığı {y.min():.1f}–{y.max():.1f} MPa")
assert X.shape == (400, 6) and y.shape == (400,)


# %% 2. Referans model: her numune için eğitim ortalaması
ortalama = y_egitim.mean()
ref_test = np.full_like(y_test, ortalama)
print("\n=== 2. Referans model: eğitim ortalaması ===")
print(f"Her numune için tahmin: {ortalama:.2f} MPa")
ref_olcut = yaz("Test", y_test, ref_test)

# %% 3. Doğrusal regresyon
model = LinearRegression().fit(X_egitim, y_egitim)
tahmin_egitim = model.predict(X_egitim)
tahmin_test = model.predict(X_test)
print("\n=== 3. Doğrusal regresyon ===")
lr_egitim = yaz("Eğitim", y_egitim, tahmin_egitim)
lr_test = yaz("Test  ", y_test, tahmin_test)
ayni = np.allclose(lr_test, [mean_absolute_error(y_test, tahmin_test),
                             root_mean_squared_error(y_test, tahmin_test), r2_score(y_test, tahmin_test)])
print(f"Sıfırdan yazılan ölçütler scikit-learn ile aynı: {ayni}")
print("Katsayılar: " + ", ".join(f"{ad} {k:+.3f}" for ad, k in zip(OZELLIKLER, model.coef_)))
# Artıkların yaşa göre ortalaması: gruplar arasında sistematik fark varsa model biçimi bir şeyi kaçırıyor
yas_test = X_test[:, OZELLIKLER.index("yas_gun")]
artik_yas = {int(g): (y_test - tahmin_test)[yas_test == g].mean() for g in np.unique(yas_test)}
print("Yaşa göre ortalama artık y − ŷ (test): "
      + ", ".join(f"{g} g {a:+.1f}" for g, a in artik_yas.items()) + " MPa")
assert ayni and lr_test[0] < ref_olcut[0]

# %% 4. Ezberleyen model: derinliği sınırsız karar ağacı
agac = DecisionTreeRegressor(random_state=42).fit(X_egitim, y_egitim)
print("\n=== 4. Ezberleyen model: derinliği sınırsız karar ağacı ===")
agac_egitim = yaz("Eğitim", y_egitim, agac.predict(X_egitim))
agac_test = yaz("Test  ", y_test, agac.predict(X_test))

# %% 5. Hedef sızıntısı: dayanımdan türetilmiş bir "özellik"
# Kırılma yükü (kN) = dayanım × 150 mm küp yüzeyi (22 500 mm²); ölçü ve okuma sapması yüzde 2
yuk = df["dayanim_mpa"].to_numpy() * 150 * 150 / 1000 * rng.normal(1.0, 0.02, len(df))
X_sizinti = np.column_stack([X, yuk])
Xs_egitim, Xs_test, ys_egitim, ys_test = train_test_split(X_sizinti, y, test_size=0.25, random_state=42)
assert np.array_equal(ys_test, y_test)          # aynı satırlar: karşılaştırma adil
model_s = LinearRegression().fit(Xs_egitim, ys_egitim)
tahmin_s = model_s.predict(Xs_test)
print("\n=== 5. Hedef sızıntısı: kırılma yükü özelliği ===")
print(f"Kırılma yükü ile dayanımın korelasyonu: {np.corrcoef(yuk, y)[0, 1]:.4f}")
sizinti_test = yaz("Test", y_test, tahmin_s)
# Gürültü tabanı: üreteç dayanımı yüzde 7'lik log-normal saçılmayla bozar. Gerçek ilişkiyi tam bilen bir model
# bile bu saçılmayı öngöremez; normal dağılımlı hatada MAE ≈ σ·√(2/π) olduğundan:
taban = 0.07 * np.sqrt(2 / np.pi) * y_test.mean()
print(f"Gürültü tabanı (yüzde 7 saçılma): MAE ≈ {taban:.2f} MPa; dürüst bir model bunun altına inemez")
print("Kırılma yükü, dayanımla aynı deneyde ölçülür; tahmin anında (deneyden önce) bilinmez.")
assert sizinti_test[2] > 0.98 and sizinti_test[0] < taban < lr_test[0]

# %% 6. Grafikler
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2), layout="constrained", sharex=True, sharey=True)
sinir = [10, 70]
for eksen, tah, baslik, renk in [(ax[0], tahmin_test, "Dürüst model: karışım + yaş", RENK[0]),
                                 (ax[1], tahmin_s, "Sızıntılı model: + kırılma yükü", RENK[1])]:
    eksen.plot(sinir, sinir, color=MUREKKEP, ls="--", lw=1.2, label="Kusursuz tahmin (y = ŷ)")
    eksen.axhline(ortalama, color=MUREKKEP, ls=":", lw=1.2, label=f"Referans: ortalama {ortalama:.1f} MPa")
    m, r, d = olc(y_test, tah)
    eksen.scatter(y_test, tah, s=18, color=renk, label=f"Test (MAE = {m:.2f} MPa, R² = {d:.3f})")
    eksen.set(xlabel="Ölçülen dayanım (MPa)", title=baslik, xlim=sinir, ylim=sinir)
    eksen.legend(loc="upper left")
ax[0].set_ylabel("Tahmin edilen dayanım (MPa)")
fig.savefig(KLASOR / "d01_ilk_model_1.png", dpi=160)
plt.close(fig)

fig, ax = plt.subplots(figsize=(9, 4.8), layout="constrained")
adlar = ["Referans\n(ortalama)", "Doğrusal\nregresyon", "Sınırsız\nkarar ağacı", "Doğrusal +\nkırılma yükü\n(sızıntı)"]
egitim_mae = [mae(y_egitim, np.full_like(y_egitim, ortalama)), lr_egitim[0], agac_egitim[0],
              mae(ys_egitim, model_s.predict(Xs_egitim))]
test_mae = [ref_olcut[0], lr_test[0], agac_test[0], sizinti_test[0]]
konum = np.arange(len(adlar))
ax.bar(konum - 0.18, egitim_mae, width=0.36, color=RENK[0], label="Eğitim")
ax.bar(konum + 0.18, test_mae, width=0.36, color=RENK[1], label="Test")
for k, (e, t) in enumerate(zip(egitim_mae, test_mae)):
    ax.text(k - 0.18, e + 0.15, f"{e:.2f}", ha="center", va="bottom", fontsize=9, color=IKINCIL)
    ax.text(k + 0.18, t + 0.15, f"{t:.2f}", ha="center", va="bottom", fontsize=9, color=IKINCIL)
ax.set_xticks(konum, adlar)
ax.axhline(taban, color=MUREKKEP, ls=":", lw=1.2, label=f"Gürültü tabanı ≈ {taban:.2f} MPa")
ax.set(ylabel="MAE (MPa)", title="Eğitim ve test hatası: referans, ezber ve sızıntı")
ax.set_axisbelow(True)
ax.legend(loc="upper right")
fig.savefig(KLASOR / "d01_ilk_model_2.png", dpi=160)
plt.close(fig)
print("\nGrafikler kaydedildi: d01_ilk_model_1.png, d01_ilk_model_2.png")=== 1. Veri ===
400 karışım (sentetik), 6 özellik: cimento, curuf, ucucu_kul, su, super_akiskan, yas_gun
Eğitim: 300 satır, test: 100 satır; dayanım aralığı 12.3–66.3 MPa
=== 2. Referans model: eğitim ortalaması ===
Her numune için tahmin: 37.82 MPa
Test: MAE = 8.24 MPa, RMSE = 10.22 MPa, R² = -0.009
=== 3. Doğrusal regresyon ===
Eğitim: MAE = 4.05 MPa, RMSE = 5.19 MPa, R² = 0.724
Test : MAE = 4.34 MPa, RMSE = 5.66 MPa, R² = 0.690
Sıfırdan yazılan ölçütler scikit-learn ile aynı: True
Katsayılar: cimento +0.074, curuf +0.043, ucucu_kul +0.036, su -0.179, super_akiskan +0.208, yas_gun +0.197
Yaşa göre ortalama artık y − ŷ (test): 3 g -9.3, 7 g -1.4, 14 g +1.5, 28 g +3.4, 56 g +1.9, 90 g -6.5 MPa
=== 4. Ezberleyen model: derinliği sınırsız karar ağacı ===
Eğitim: MAE = 0.00 MPa, RMSE = 0.00 MPa, R² = 1.000
Test : MAE = 5.90 MPa, RMSE = 7.58 MPa, R² = 0.446
=== 5. Hedef sızıntısı: kırılma yükü özelliği ===
Kırılma yükü ile dayanımın korelasyonu: 0.9967
Test: MAE = 0.57 MPa, RMSE = 0.76 MPa, R² = 0.994
Gürültü tabanı (yüzde 7 saçılma): MAE ≈ 2.06 MPa; dürüst bir model bunun altına inemez
Kırılma yükü, dayanımla aynı deneyde ölçülür; tahmin anında (deneyden önce) bilinmez.
Grafikler kaydedildi: d01_ilk_model_1.png, d01_ilk_model_2.png11. Sonuçları yorumlayın
| Model | MAE (MPa) | RMSE (MPa) | R² |
|---|---|---|---|
| Referans: eğitim ortalaması | 8,24 | 10,22 | −0,009 |
| Doğrusal regresyon | 4,34 | 5,66 | 0,690 |
| Sınırsız karar ağacı | 5,90 | 7,58 | 0,446 |
| Doğrusal + kırılma yükü (sızıntı) | 0,57 | 0,76 | 0,994 |
Doğrusal regresyon referansın hatasını yaklaşık yarıya indiriyor: MAE 8,24'ten 4,34 MPa'ya. Bu, dürüst bir modelin ilk sonucudur ve tablodaki en iyi kullanılabilir modeldir. Katsayıların işaretleri de mühendislik bilgisiyle uyumlu: su için $-0{,}179$ MPa/(kg/m³), çimento için $+0{,}074$ MPa/(kg/m³), yaş için $+0{,}197$ MPa/gün. Katsayıların büyüklükleri birimlere bağlı olduğundan doğrudan karşılaştırılamaz.
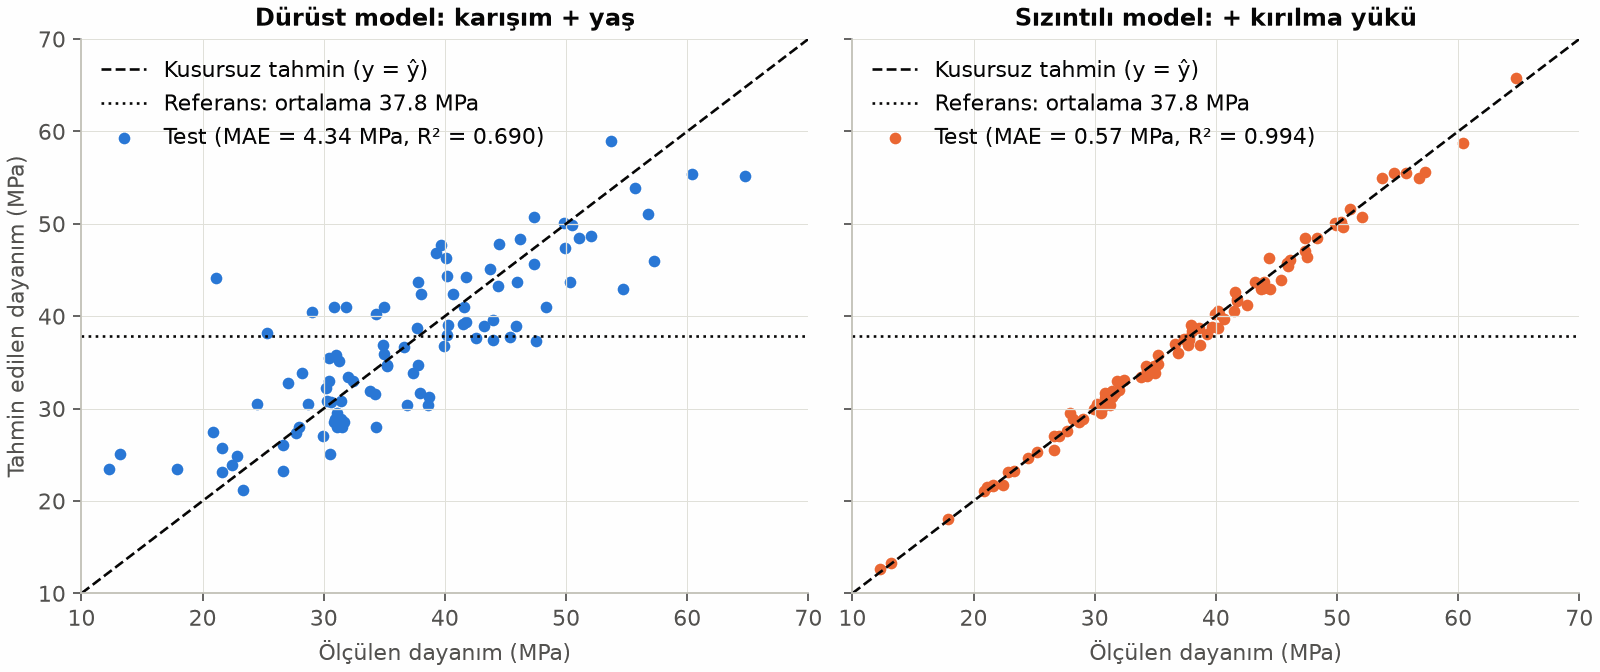
Sol paneldeki bulut köşegenden biraz daha yatık görünüyor: düşük dayanımlar fazla, yüksekler az tahmin ediliyor. Bu tek başına bir kusur işareti değildir. R²'si 1'den küçük her model tahminlerini ortalamaya doğru çeker; tahminin ölçüme göre eğimi kabaca R² kadardır. Modelin ilişkiyi gerçekten kaçırdığını artıklar gösterir. Test artıklarını, yani $y - \hat y$ farklarını, numune yaşına göre gruplayıp ortalamalarını aldığımızda sistematik bir desen çıkıyor: 3 günlük küplerde $-9{,}3$, 7 günlükte $-1{,}4$, 14 günlükte $+1{,}5$, 28 günlükte $+3{,}4$, 56 günlükte $+1{,}9$ ve 90 günlükte $-6{,}5$ MPa. Model en erken ve en geç yaşlarda dayanımı fazla, aradaki yaşlarda az tahmin ediyor.
Bunun sebebi model biçimidir. Dayanım yaşla doğrusal değil, hızı azalarak artar; tek bir düz yaş terimi bu eğriyi izleyemez ve iki uçta eğrinin üstünde, ortada altında kalır. Artıklarda desen varsa modelin kaçırdığı bir yapı vardır; aynı kuralı Ders 02'de de göreceğiz. Alıştırma 4'te tek bir dönüşümle bunu ne kadar düzeltebileceğinizi göreceksiniz; anlamlı özellikler kurmayı Ders 04'te sistemli olarak ele alacağız.
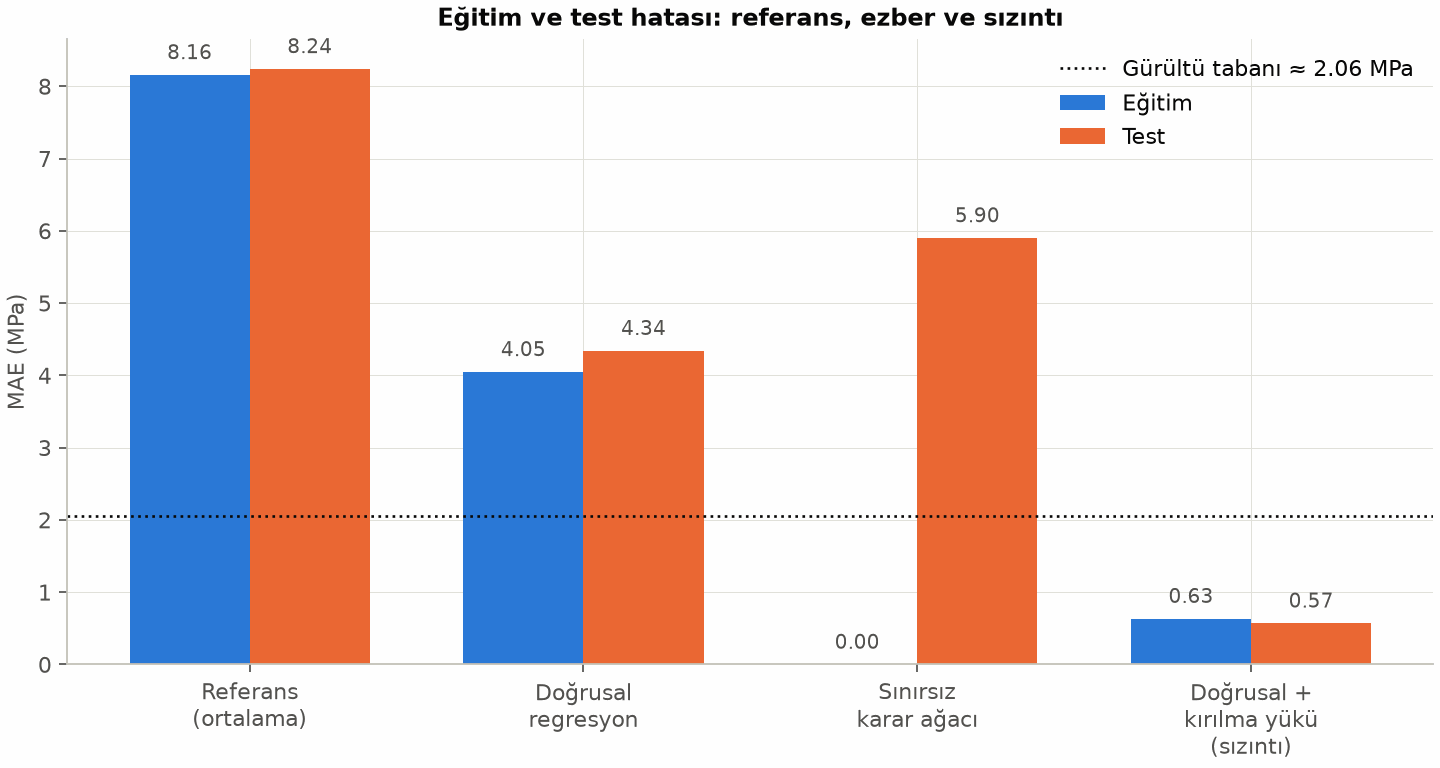
İkinci şekil, bu dersin iki uyarısını yan yana koyuyor. Sınırsız ağaçta eğitim ile test arasındaki uçurum aşırı uyumdur; eğitim hatasına bakan biri bu modeli en iyi sanardı. Sızıntılı modelde ise iki hata da düşük ve birbirine yakın; yani eğitim–test karşılaştırması sızıntıyı yakalamaz, çünkü sızan bilgi test verisinde de vardır. Sızıntıyı ancak “bu özellik tahmin anında elimde olacak mı?” sorusu ve gürültü tabanı gibi bir akıl yürütme yakalar.
12. Sık yapılan hatalar
- Modeli eğitim verisiyle değerlendirmek. Sınırsız ağaç eğitimde kusursuzdu; testte doğrusal modelden kötü çıktı.
- Referans raporlamamak. “R² = 0,69” tek başına bir şey söylemez; referansın MAE'si 8,24, modelinki 4,34 MPa demek söyler.
- Test verisine bakarak ayar yapmak. Test kümesi seçim aracına dönüşür ve sonuç iyimser olur. Seçimleri doğrulama verisiyle ya da çapraz doğrulamayla yapın.
- Tahmin anında olmayacak özellik kullanmak. Kırılma yükü, sonradan ölçülen her büyüklük, hedeften türetilen her değişken.
- Ön işlemi bölmeden önce bütün veriye uydurmak. Ölçekleyiciyi, doldurucuyu ve özellik seçimini bir
Pipelineiçine koyun. - Bağlı örnekleri rastgele bölmek. Aynı karışımın küpleri, aynı yapının ölçümleri ve zaman serileri gruplu ya da zamana göre bölünür.
13. Alıştırmalar
Alıştırma 1KolayÖlçütleri elle hesaplayın
Üç küpün ölçülen dayanımları 30, 35 ve 40 MPa; bir modelin tahminleri 32, 33 ve 41 MPa. MAE, RMSE ve R²'yi hesaplayın.
Çözümü göster
Hatalar $-2$, $2$ ve $-1$ MPa. MAE $= (2+2+1)/3 = 1{,}667$ MPa. RMSE $= \sqrt{(4+4+1)/3} = \sqrt3$, yani 1,732 MPa. Ölçümlerin ortalaması 35 MPa, ortalamadan sapmaların kareler toplamı $25 + 0 + 25 = 50$; böylece $R^2 = 1 - 9/50 = 0{,}82$. Betikteki mae, rmse ve r2 fonksiyonları aynı sonuçları verir.
Alıştırma 2KolayHangisi sızıntı?
28 günlük dayanımı, karışım tasarlanırken tahmin eden bir model kuruyorsunuz. Şu özelliklerden hangileri kullanılabilir, hangileri sızıntıdır? (a) su miktarı, (b) 7 günlük küp dayanımı, (c) 28 günlük deneyde ölçülen kırılma yükü, (d) küpün döküldüğü kalıbın numarası.
Çözümü göster
(a) Kullanılabilir: tasarım anında bilinir. (b) Bu soru için sızıntıdır: karışım tasarlanırken 7 günlük sonuç yoktur. Ama tahmin 7. günde yapılacak olsaydı meşru ve çok değerli bir özellik olurdu; sızıntıyı tahmin anı belirler. (c) Sızıntıdır: dayanımın kendisi bu yükten hesaplanır. (d) Sızıntı değildir, ama büyük olasılıkla ilgisizdir; model ona rastlantısal bir anlam yükleyebilir. Kursun beton verisinde kalıp numarası bilerek eklenmiş ilgisiz bir özelliktir.
Alıştırma 3OrtaTest skoruna göre ayar yapmak
Test skoru beklediğinizden düşük çıktı. Modelin ayarlarını test sonucuna bakarak değiştirip yeniden test etmenin sakıncası nedir? Doğru yol ne olmalı?
Çözümü göster
Her ayarlama turunda test verisine göre seçim yapmış olursunuz; test kümesi böylece seçim verisine dönüşür. Çok sayıda deneme arasından testte en iyi görüneni seçmek, rastlantısal olarak o test örneklerine iyi uyanı seçmektir; raporlanan hata gerçek hatadan iyimser olur. Ayarları doğrulama verisiyle ya da eğitim verisi üzerinde çapraz doğrulamayla belirleyin. Test verisine artık “bakıldıysa”, son değerlendirme için hiç kullanılmamış yeni bir test kümesi ayırın ve bunu raporunuzda belirtin.
Alıştırma 4OrtaYaş için daha iyi bir özellik
Betikte yas_gun sütunu yerine np.log(yas_gun) kullanın (aynı bölme, aynı model). Test MAE'si, RMSE'si ve R²'si nasıl değişir? Neden?
Çözümü göster
X2 = X.copy()
X2[:, -1] = np.log(X2[:, -1])          # son sütun: yaş → ln(yaş)
X2_egitim, X2_test, _, _ = train_test_split(X2, y, test_size=0.25, random_state=42)
model2 = LinearRegression().fit(X2_egitim, y_egitim)
Test sonuçları MAE = 3,31 MPa, RMSE = 4,34 MPa, R² = 0,818 olur (önce 4,34, 5,66 ve 0,690 idi). Dayanım yaşla doğrusal değil, azalan hızla artar: 3. günden 7. güne artış, 56. günden 90. güne artıştan çok büyüktür. Logaritma bu eğriyi neredeyse doğruya çevirir; doğrusal model bu yeni özellikle ilişkiyi çok daha iyi temsil eder. ln(yaş) katsayısı 6,057 MPa çıkar; yaşın iki katına çıkması, diğer her şey sabitken yaklaşık $6{,}057 \cdot \ln 2 = 4{,}20$ MPa artış demektir. Model değişmedi, yalnız özellik değişti: özellik mühendisliğinin gücü budur.
Alıştırma 5ZorAynı karışımın üç küpü
Gerçek deneylerde aynı karışımdan genellikle üç küp alınır. Bunu taklit edin: beton_verisi(150, rng) ile 150 karışım üretin, her satırı üç kez tekrarlayın ve her küpün dayanımını yüzde 3'lük ek bir log-normal saçılmayla bozun. Sınırsız karar ağacını önce rastgele bölmeyle, sonra karışım numarasına göre gruplu bölmeyle (GroupShuffleSplit) değerlendirin. Aynısını doğrusal regresyon için yapın.
Çözümü göster
from sklearn.model_selection import GroupShuffleSplit
rng = np.random.default_rng(42)
d = beton_verisi(150, rng)
k = d.loc[d.index.repeat(3)].reset_index().rename(columns={"index": "karisim_no"})
k["dayanim_mpa"] *= rng.lognormal(0.0, 0.03, len(k))
Xk, yk, gk = k[OZELLIKLER].to_numpy(), k["dayanim_mpa"].to_numpy(), k["karisim_no"].to_numpy()
egt, tst = next(GroupShuffleSplit(n_splits=1, test_size=0.25, random_state=42).split(Xk, yk, gk))
agac = DecisionTreeRegressor(random_state=42)
Xa, Xb, ya, yb = train_test_split(Xk, yk, test_size=0.25, random_state=42)    # rastgele bölme
mae(yb, agac.fit(Xa, ya).predict(Xb))                                          # 1.51
mae(yk[tst], agac.fit(Xk[egt], yk[egt]).predict(Xk[tst]))                      # 6.56  (gruplu)
Sınırsız ağacın test MAE'si rastgele bölmeyle 1,51 MPa, gruplu bölmeyle 6,56 MPa çıkar. Rastgele bölmede test satırlarının yüzde 92'sinin bir “kardeşi” eğitimdedir; ağaç onu ezberlemiştir ve yalnız küpler arasındaki küçük saçılmayı hata olarak görürsünüz. Gruplu bölme ise modelin yeni bir karışımla karşılaştığı gerçek kullanımı taklit eder. Doğrusal regresyonda iki sonuç yakındır (3,66 ve 3,38 MPa), çünkü bu model tek tek örnekleri ezberleyemez.
Ders: rastgele bölme, iyimser ama yanlış bir sonuç verdi ve en çok ezberleyebilen modeli ödüllendirdi. Gruplu çapraz doğrulamayı Ders 03'te ayrıntılı göreceğiz.
Özet
- Makine öğrenmesi örneklerden bir girdi–çıktı ilişkisi öğrenir; güvenilir bir formül ya da yönetmelik kontrolü varsa onun yerine geçmez.
- Eğitim verisi parametreleri, doğrulama verisi seçimleri, test verisi son değerlendirmeyi yapar. Bölme biçimi verinin yapısına uymalıdır: rastgele, zamana göre ya da gruplu.
- Aşırı uyum, eğitim ile test hatası arasındaki uçurumdur. Veri sızıntısı ise eğitim–test karşılaştırmasıyla görünmez; “tahmin anında bu bilgi elimde olacak mı?” sorusuyla yakalanır.
- MAE ve RMSE hedefle aynı birimdedir, R² bir oran ve negatif olabilir. Her sonuç bir referans modelle birlikte raporlanır.
Sonraki derste en temel modeli, doğrusal regresyonu içinden tanıyacağız: Ders 02'de bir çekme deneyinden elastisite modülünü önce kapalı çözümle, sonra sıfırdan yazdığımız gradyan inişiyle bulacağız.
Kaynaklar
- scikit-learn — Common pitfalls and recommended practices (veri sızıntısı ve
Pipeline). - G. James, D. Witten, T. Hastie, R. Tibshirani — An Introduction to Statistical Learning, Bölüm 2 (istatistiksel öğrenmenin temel kavramları).
- T. Hastie, R. Tibshirani, J. Friedman — The Elements of Statistical Learning, 2. baskı, Bölüm 7 (model değerlendirme ve seçimi).
- S. Kaufman, S. Rosset, C. Perlich, O. Stitelman — “Leakage in Data Mining: Formulation, Detection, and Avoidance”, ACM Transactions on Knowledge Discovery from Data, 2012.